韩国这次是真杀进来了!直接砸下 4.7 万亿韩元(约 35 亿美元),准备给国家级 Frontier AI 项目单独安排 1 万张英伟达下一代 Vera Rubin 架构战卡,再加上整个 AI 生态规划的 2.9 万张 B200 等效算力。最绝的是韩国官方的表态,直白得甚至有点扎心:追美国不现实。
韩国这次在人工智能领域下了重注。2026年10月,韩国科学技术信息通信部公布新一轮技术发展方案,准备投入4.7万亿韩元,约合35亿美元,打造本国先进人工智能模型。更值得关注的是,韩国不再单纯强调追赶美国,而是把中国领先的开放模型列为重要参照。这意味着韩国已经开始重新计算全球人工智能竞争中的投入成本和发展机会。
事情要从9月8日说起。韩国科学技术信息通信部当时透露,计划为前沿人工智能研发设立专项资金,4.7万亿韩元被纳入2027年度预算规划。这不是普通的软件研发补贴,而是涉及先进计算设备、模型训练、技术人才和产业应用的国家级工程。韩国希望通过集中资金,改变本土企业各自投入、资源分散的局面。
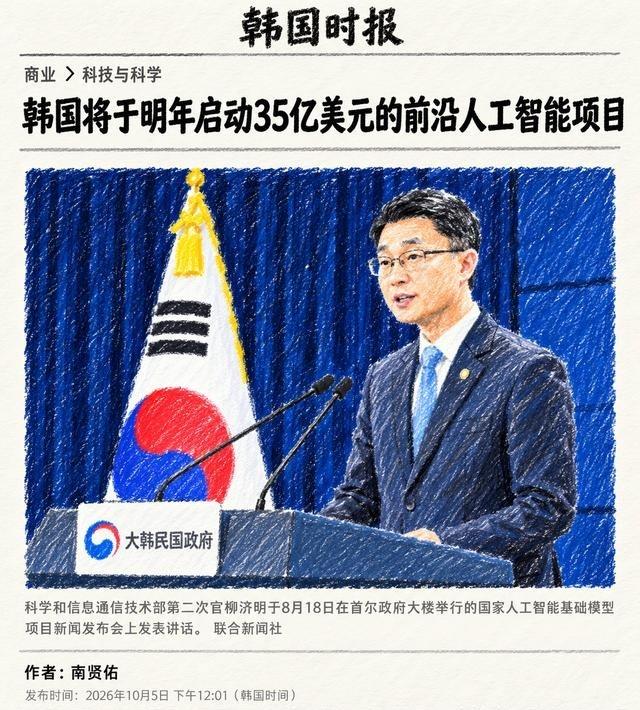
到了10月2日,韩国科学技术信息通信部第二次官柳济明进一步解释了政策方向。原有的自主基础模型计划不会取消,而是分成两条发展路线。一条集中资源攻关国际先进水平的大模型,另一条继续推动人工智能进入制造、通信、公共服务等领域。10月5日,韩国媒体披露了更具体的安排,整个计划的技术路径逐渐清晰。
最引人注目的,就是英伟达新一代计算芯片。韩国正在考虑为Frontier AI研发单独配置约1万张Vera Rubin架构GPU。这套技术面向复杂推理、大规模模型训练和高强度计算任务,相比上一代产品,重点提升计算效率、内存带宽以及设备之间的数据传输能力。韩国选择这一代设备,显然希望减少未来硬件升级带来的时间损失。据披露,4.7万亿韩元中,3.9万亿韩元用于采购这批GPU,8000亿韩元用于购买AI训练数据,250亿韩元用于引进20名海外优秀研究者。
除了这批高端芯片,韩国还准备向现有自主模型项目及其他人工智能开发主体提供约2.9万张B200实体GPU。两项配置目前仍处于规划和讨论阶段,具体分配方式尚未确定。韩国为何如此重视计算设备?因为训练先进模型,早已不是几台服务器能够完成的工作。参数规模、训练数据和推理任务不断扩大,对芯片性能、网络连接以及供电系统都提出了更高要求。国家集中采购,正是为了降低这些门槛。
但拥有显卡不等于拥有先进模型。训练过程中还需要高质量数据、算法团队、稳定的软件系统以及大量实验。韩国此次强调政府与民间资本共同投入,目的就是让资金、设备和人才形成长期协作,而不是把预算全部花在采购硬件上。
韩国原有的自主基础模型项目也在继续推进。按照10月公布的安排,第三阶段评估将于2027年2月进行,从三支候选团队中选出两支。入选者仍可获得计算资源支持,但不代表自动取得新设立的Frontier AI项目资格。新项目的参与范围还将扩大,韩国准备允许大型企业、中小企业、初创团队以及不同机构组成的联合体参与竞争。待2027年度预算经过国会审议后,相关部门计划启动公开遴选,争取2027年2月确定实施主体,并于3月启动项目。
真正让外界关注的,是韩国官员对国际竞争形势的判断。柳济明在记者会上承认,美国头部人工智能企业拥有庞大的资本实力,韩国要达到同等投入水平并不现实。因此,韩国准备把中国领先开放模型的能力作为重要追赶目标。按照他的解释,如果政府投入约5万亿韩元,再获得相应规模的民间投资,韩国就有机会向这一目标靠近。
韩国自身也并非没有优势。三星电子和SK海力士在存储芯片领域具有深厚积累,高带宽存储器更是先进人工智能设备的重要组成部分。韩国拥有半导体制造基础,也有通信、汽车、电子和工业自动化等应用市场。问题在于,硬件产业优势能否顺利转化为模型研发能力,两者之间仍需要大量软件人才和持续投入。
不过,韩国人工智能模型的实际水平仍需客观看待。LG的K-EXAONE 2.0和SK电讯的A.X K2虽然参数规模不小,但在全球通用基准测试中,平均分仍明显低于中国同代开源模型。更值得注意的是,韩国政府此前主办的国家级人工智能竞赛中,部分入围团队的代码被指出与中国开源模型高度相似。这说明,从“追赶目标”到“真正实现”,韩国还有相当长的路要走。
截至2026年10月10日,韩国公布的是明确的投资方向和设备配置设想,尚不是全部芯片已经交付、模型已经完成的成绩单。真正值得关注的,是韩国对竞争现实的重新认识:美国拥有巨大的资本优势,中国先进模型已经具备强劲竞争力,韩国则试图利用自身半导体基础寻找突破口。接下来,决定这场投入价值的,不是采购了多少张显卡,而是能否真正训练出具有国际竞争力的人工智能模型。