此前让 Claude Opus 5.5 和 GPT-6 Astra 下棋,两边思考深度都开到 max,opus 国际象棋 3 比 1、象棋 4 比 0 胜出,但两边都下得挺臭。
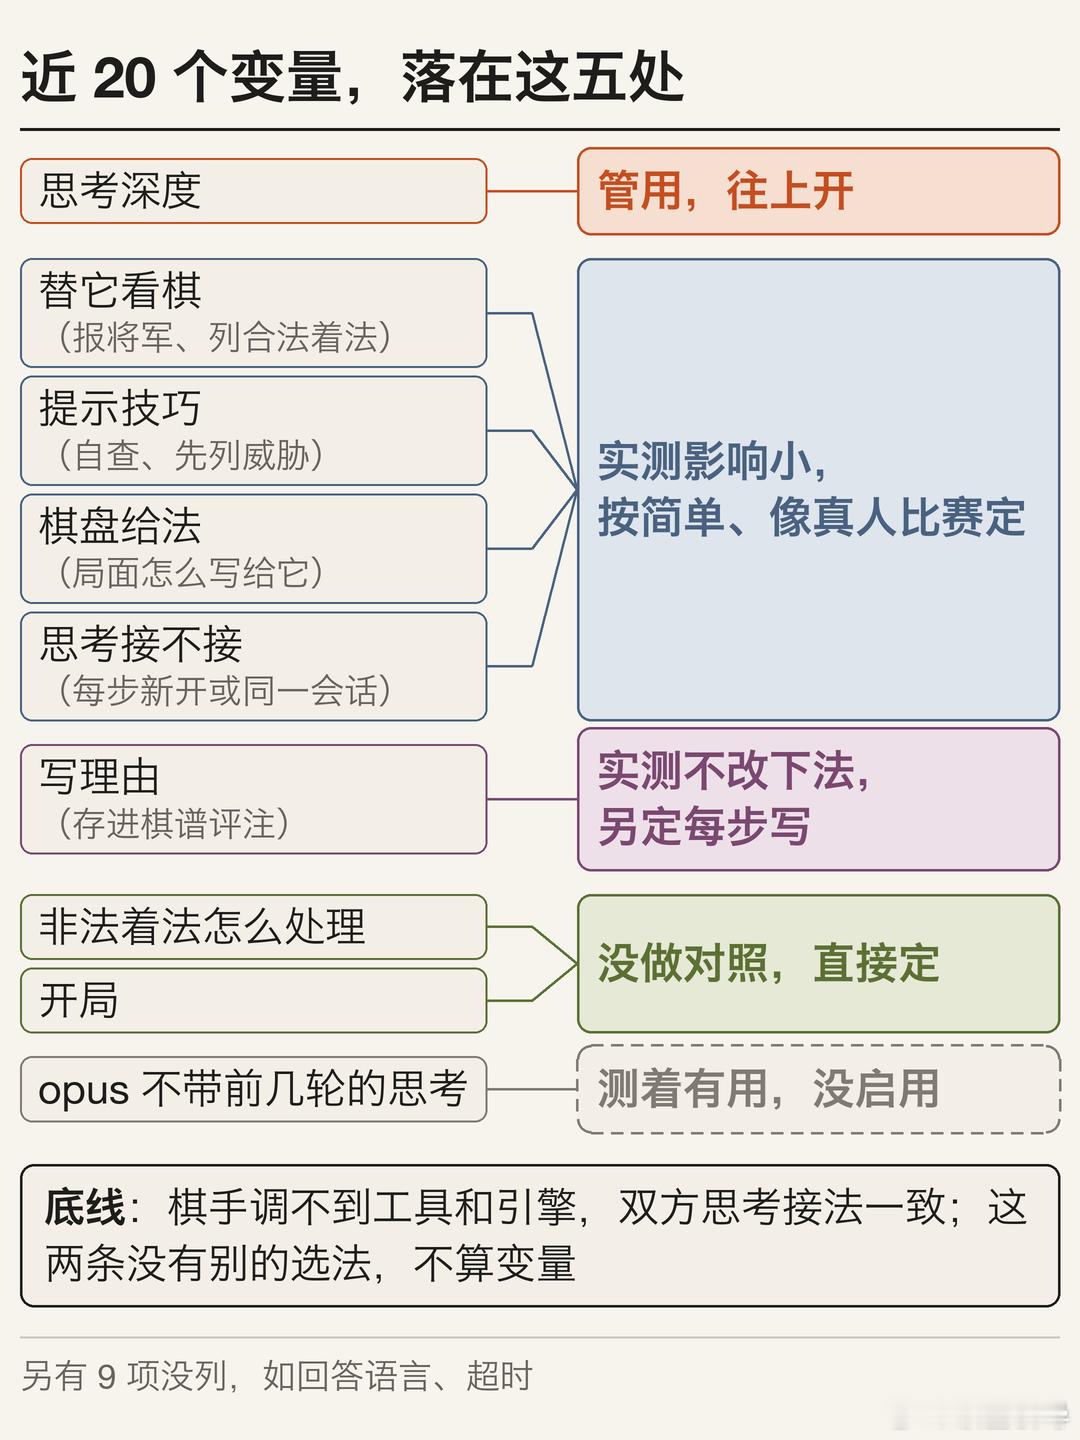
对弈环境是我和 agent 事先把近 20 个变量过了一遍定下的,多数实测过,毕竟环境搭得不对,测的就不全是模型的棋力。最管用的是思考深度;其余测过的影响都小。最终按最简单、最像真人比赛的方式定。
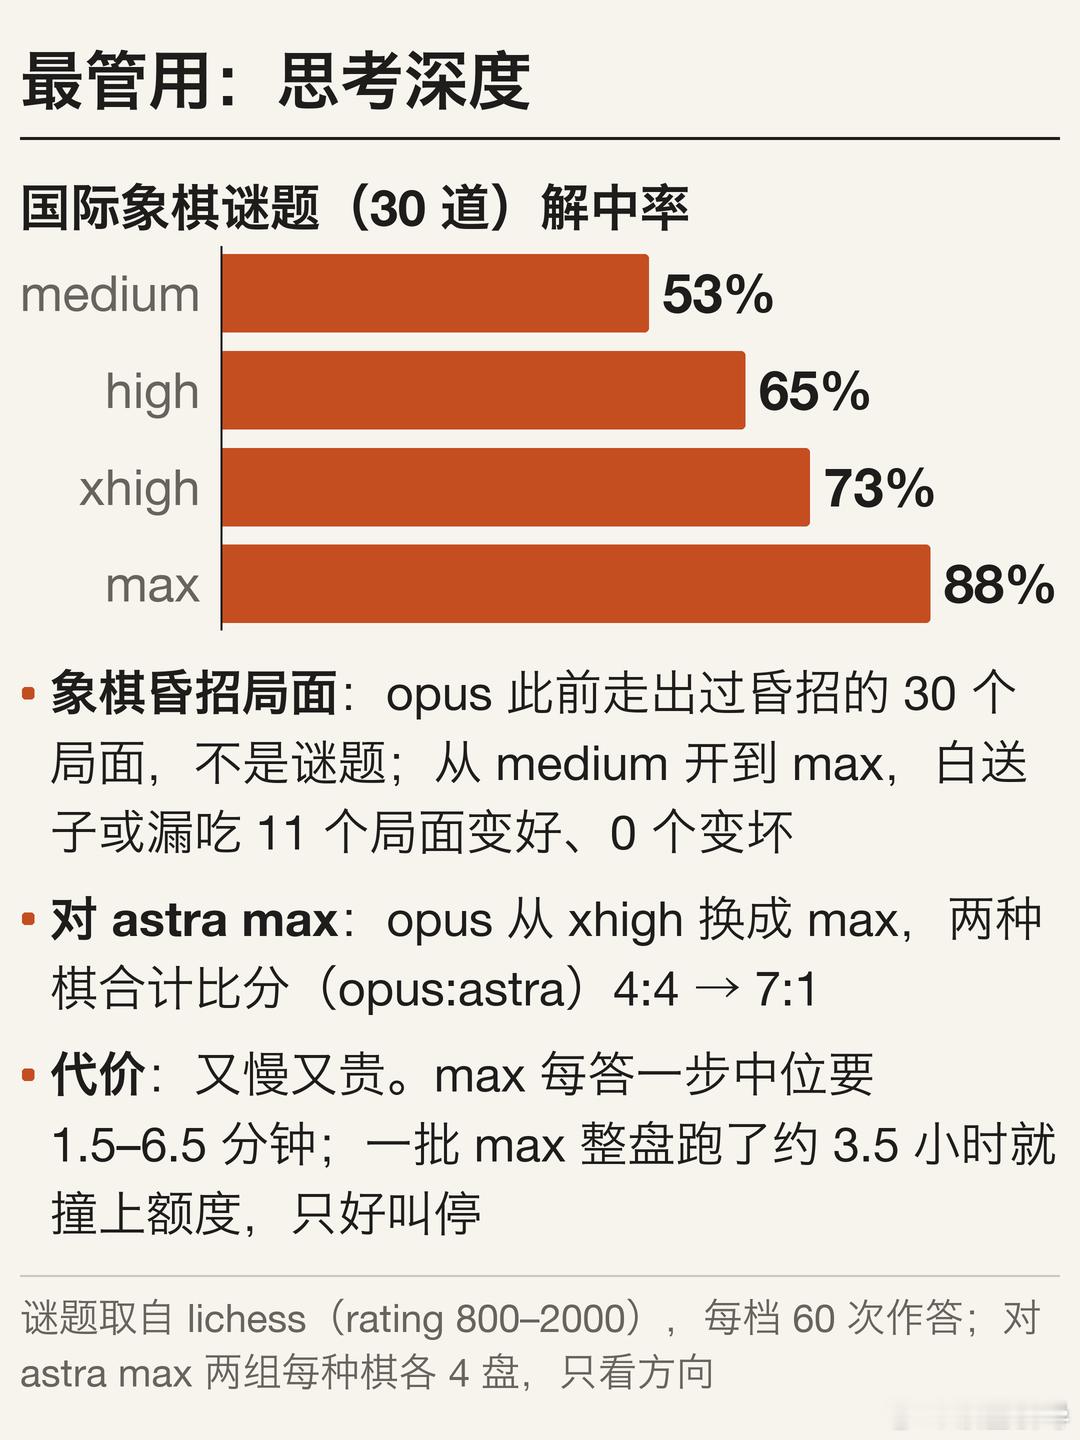
拿国际象棋谜题考 opus,思考深度从 medium 开到 max,解中率从 53% 升到 88%。
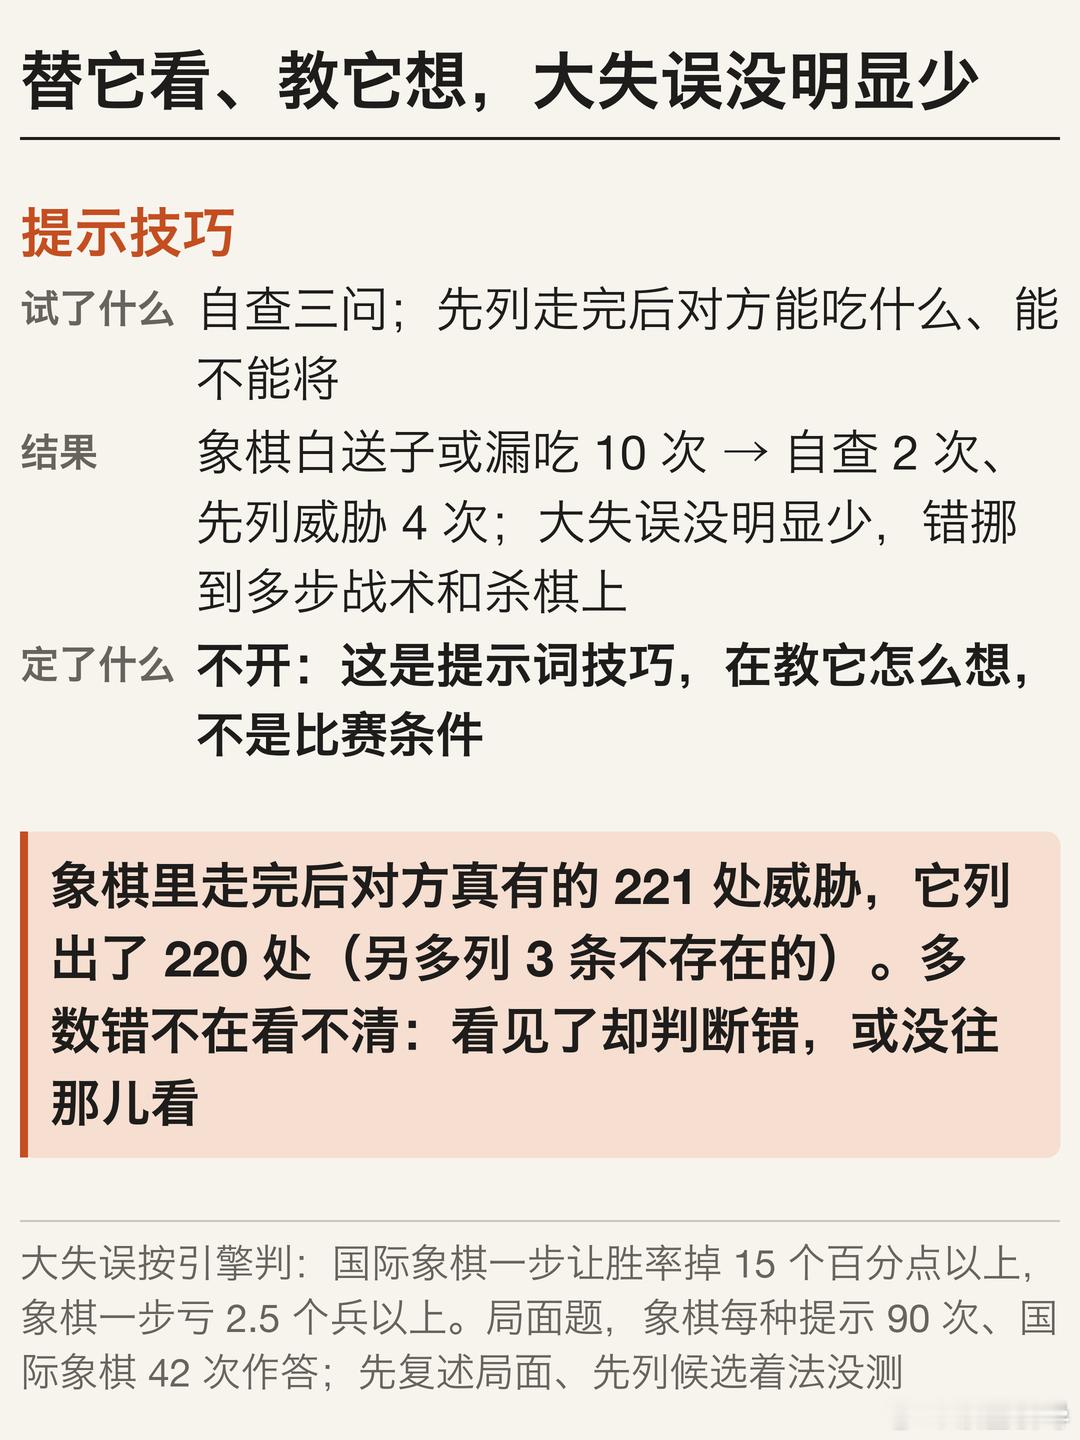
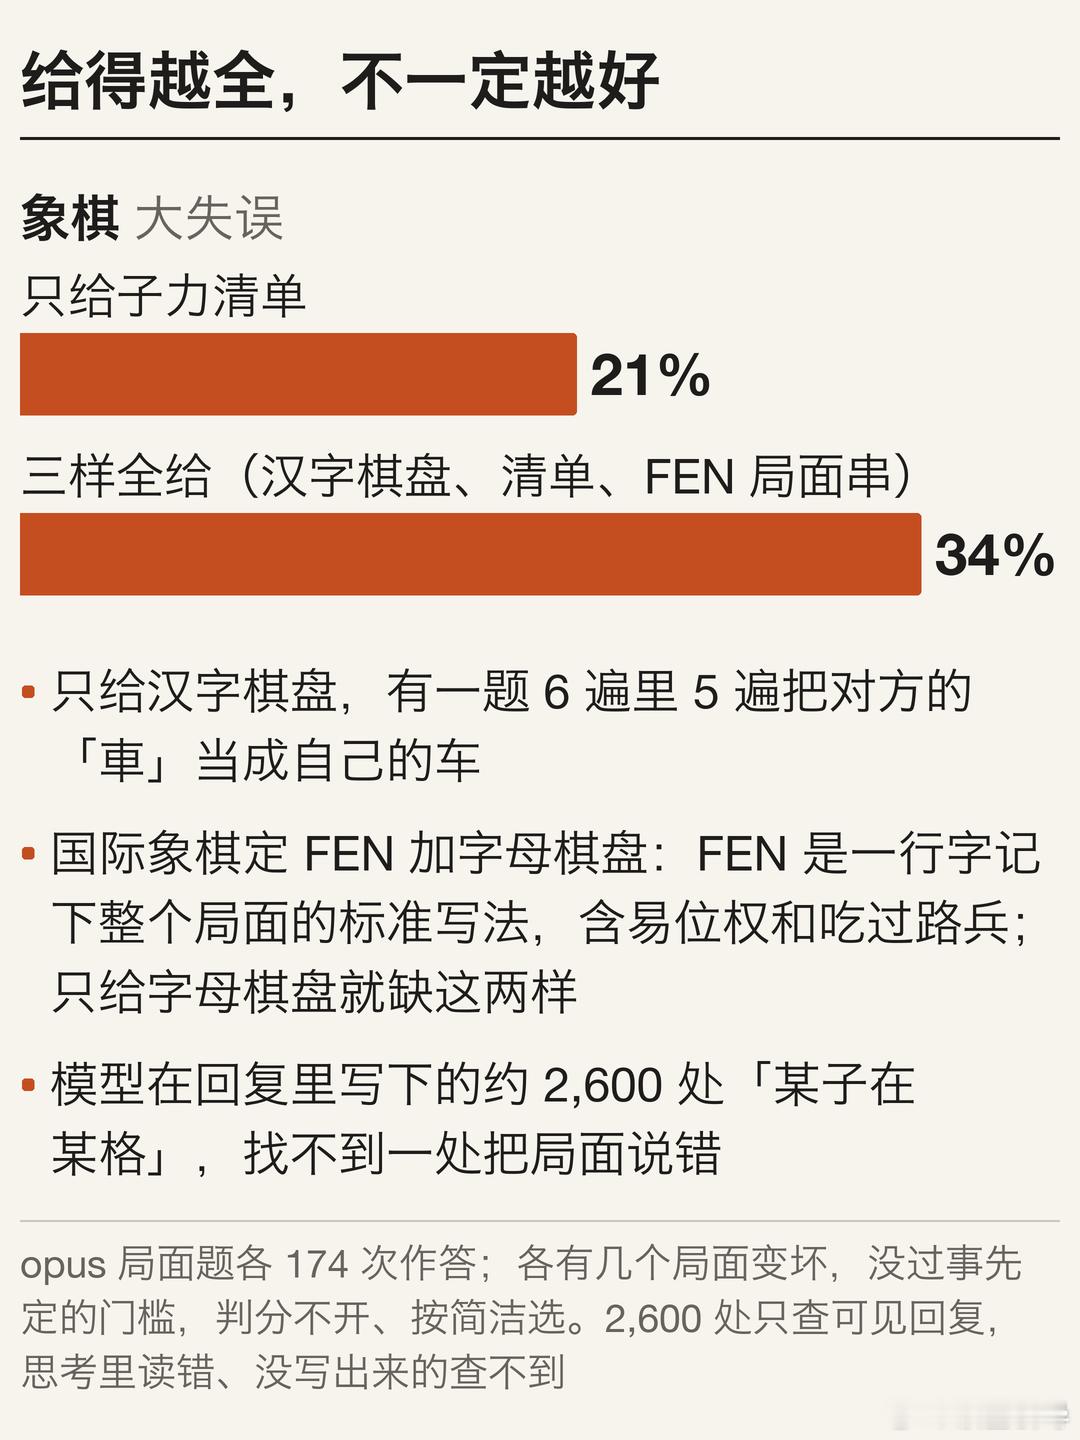
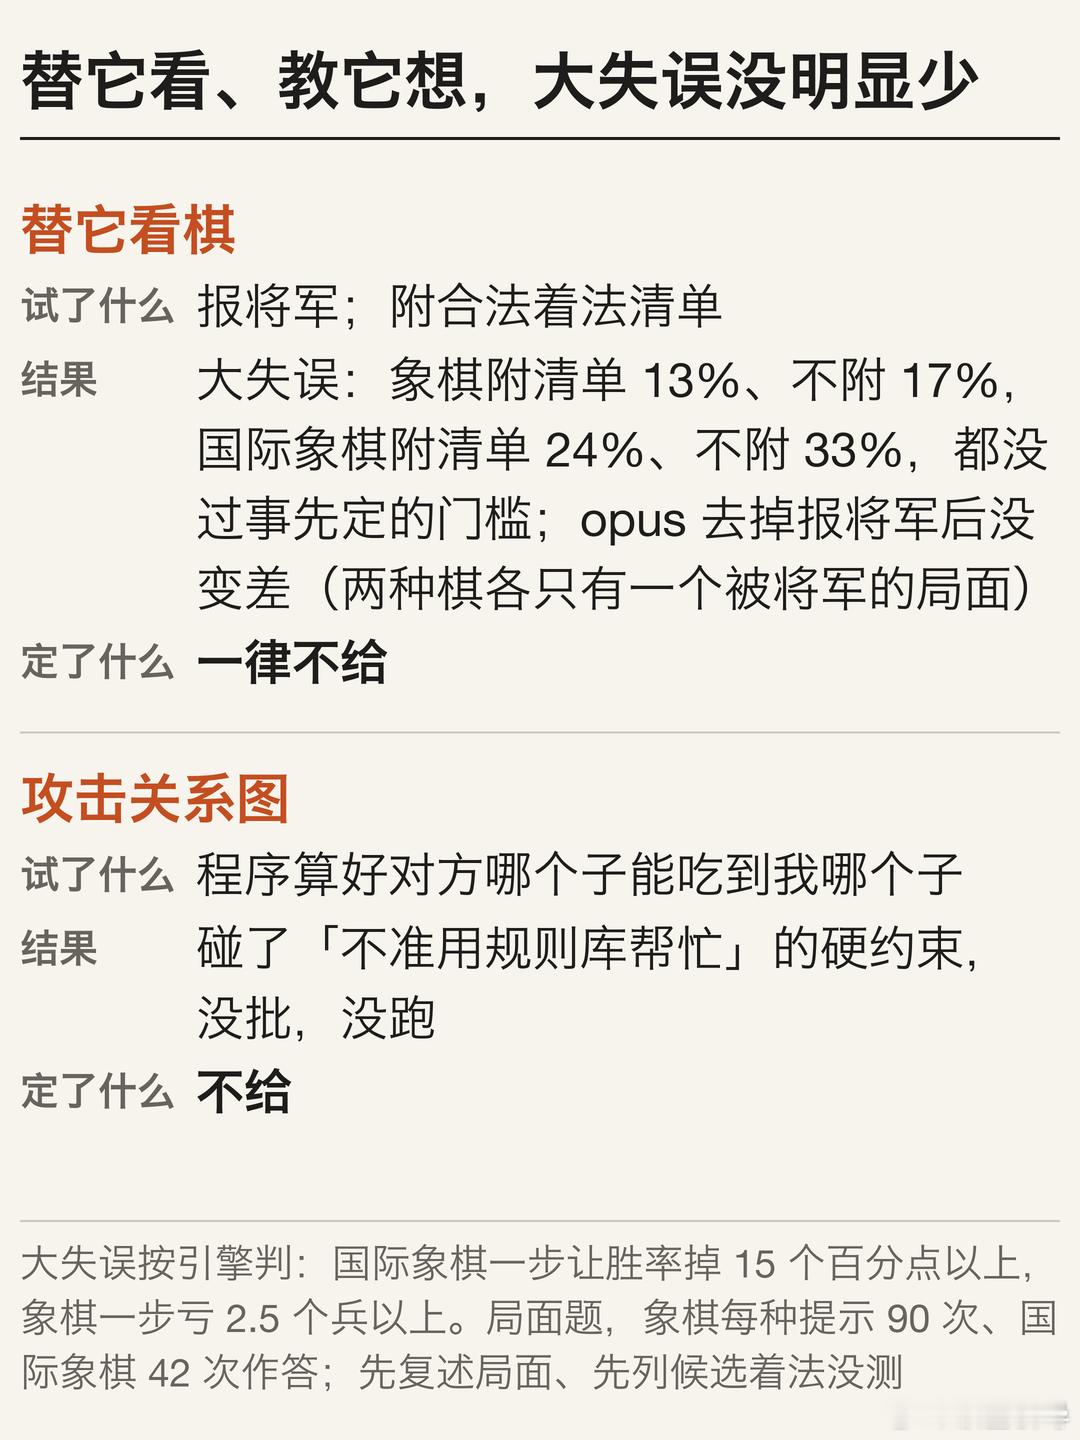
替它看棋(报将军、列合法着法)、教它怎么想(先自查、先列威胁),对大失误都没明显用处,多数错不在看不清棋盘。让它先列走完后对方能吃什么,象棋里对方真有的 221 处威胁它列出了 220 处。也就是说看见了,臭棋照走。所以两样都不给:真人比赛没人替你看棋,也没人教你怎么想。
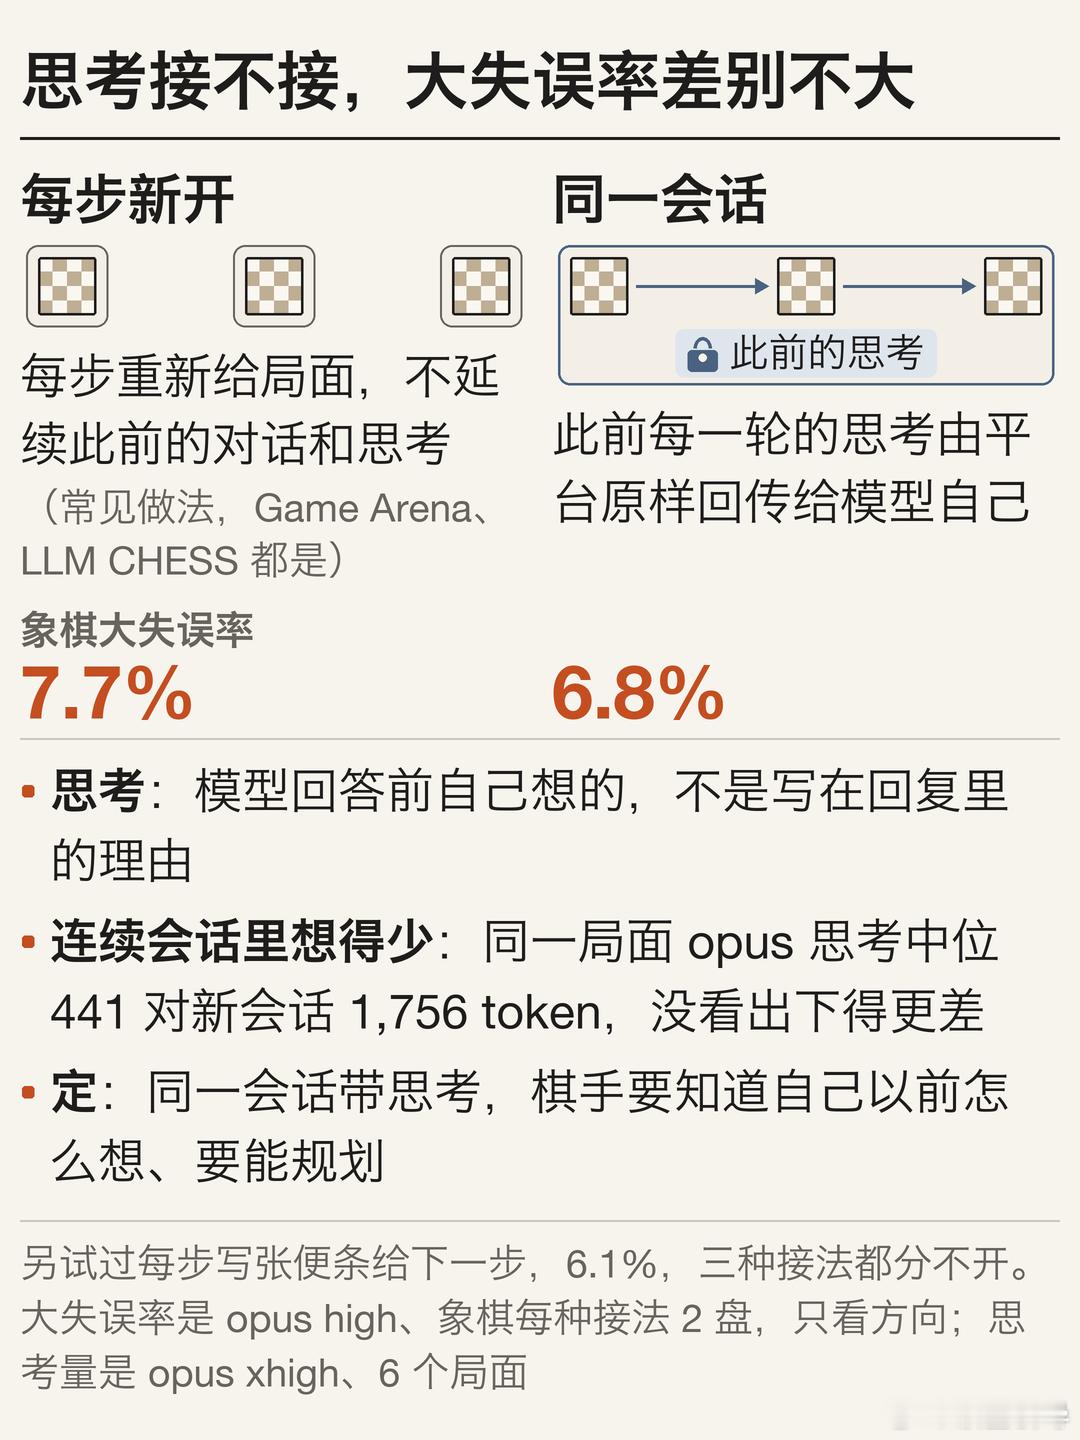
思考接不接也对比过。常见做法是每步新开会话、重新给局面;另一种是同一会话连续下,平台把模型此前的思考回传给它自己。两种接法整盘的大失误率差别不大(盘少,只看方向),接法不是下得臭的主因。我们选了同一会话带思考:棋手得知道自己之前怎么琢磨的,才谈得上规划。
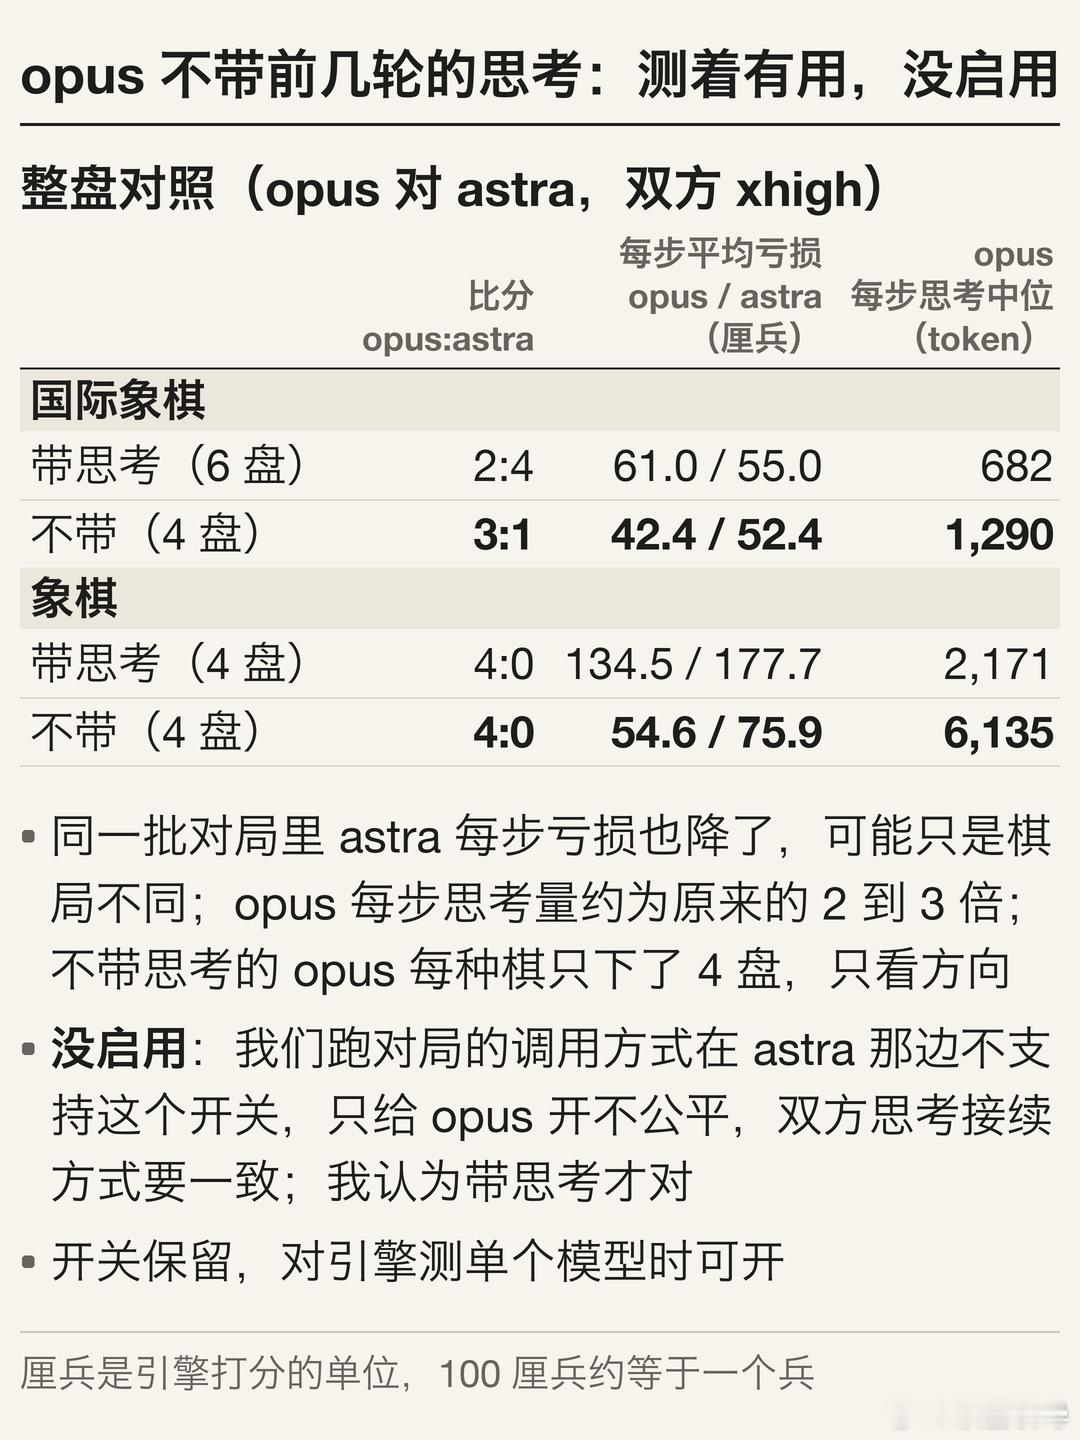
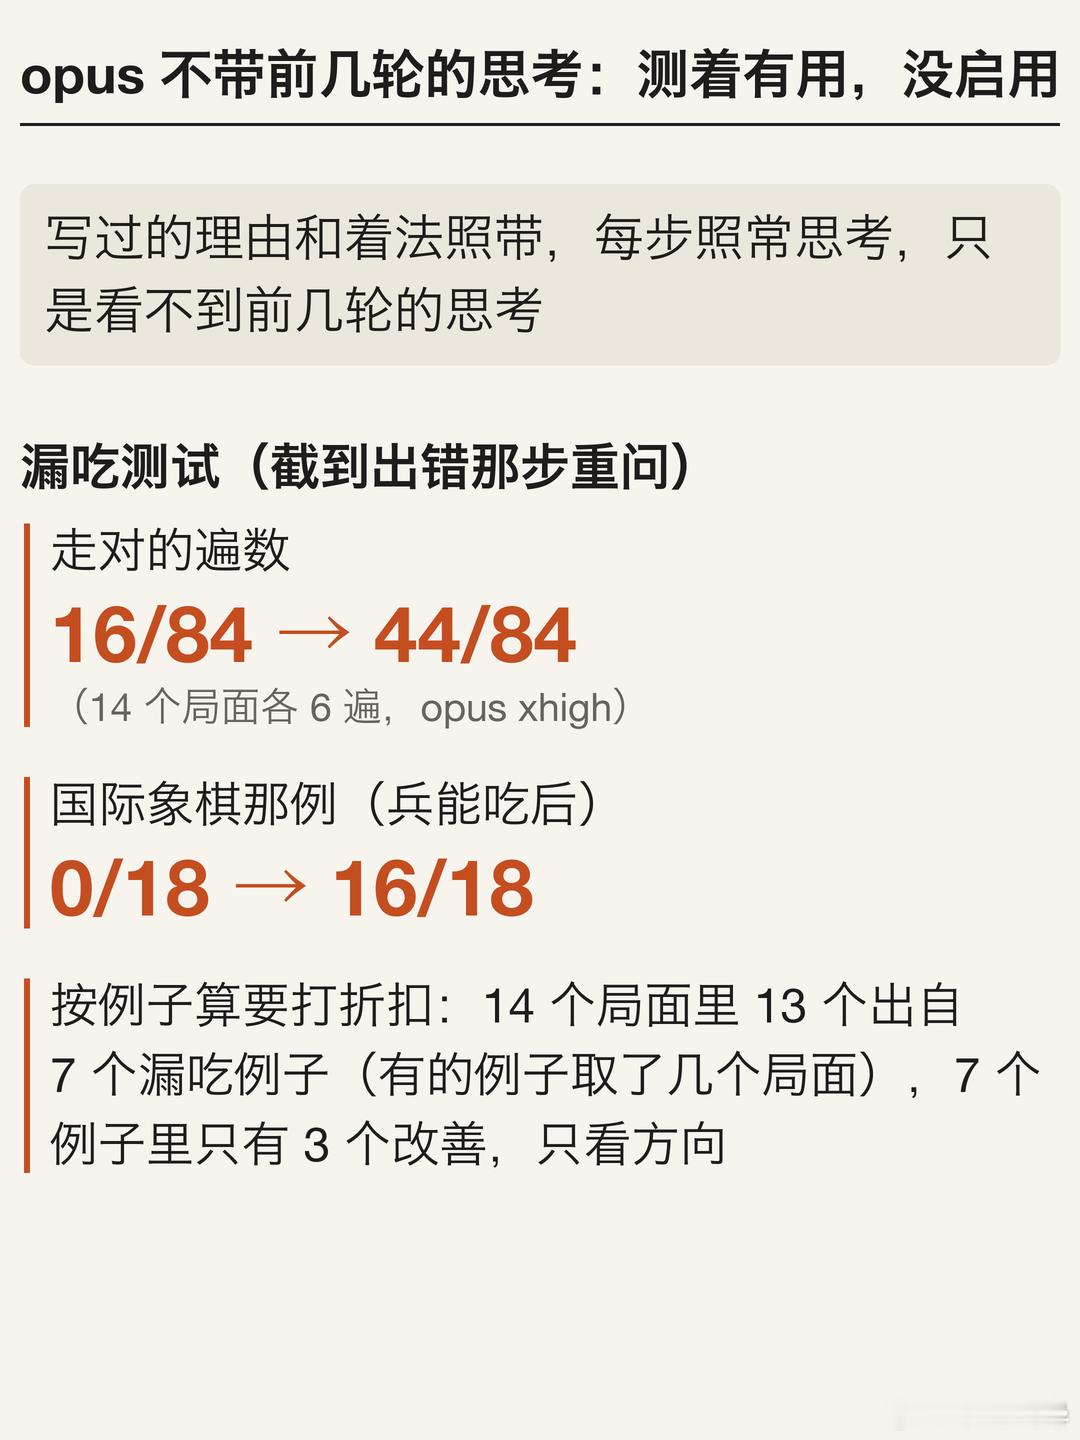
另有个方案测着有用:opus 续下时理由和着法照带,只去掉前几轮的思考。起因是 opus 常连着几步不吃白送的子。我们把对局截到出错那步让它重走,只有这招明显起作用。放回整盘里比,opus 每步亏得更少,但思考量也涨了,好处可能来自多想;同批 astra 也亏得更少,可能只是棋局不同,只能看方向。这招最后没启用:我们调 astra 的方式不支持这个开关,只给 opus 开不公平;我也认为带思考才对。
每步还要它在回复里先写理由,实测不改下法,用处是查错:约一半昏招的理由里有一句错的棋面判断。
收敛下来,就是把模型当真人棋手:每步只告诉它轮到谁、对方上一步和当前局面,不报将军、不列合法着法;每方一段会话,默认带着此前的思考;每步先写理由;思考深度常规 xhigh,巅峰对决开到 max。两条底线:棋手调不到工具和引擎;双方思考接法一致。对局时每一步由程序发局面、判合法、记棋谱,agent 负责写程序、开盘、盯额度。
最后三张是 claude -p、codex exec、OpenRouter chat API 的关键配置。
agent国际象棋