国产大模型确实到了该爆发的节点,这不是情绪,是几股力量同时推着往前走。
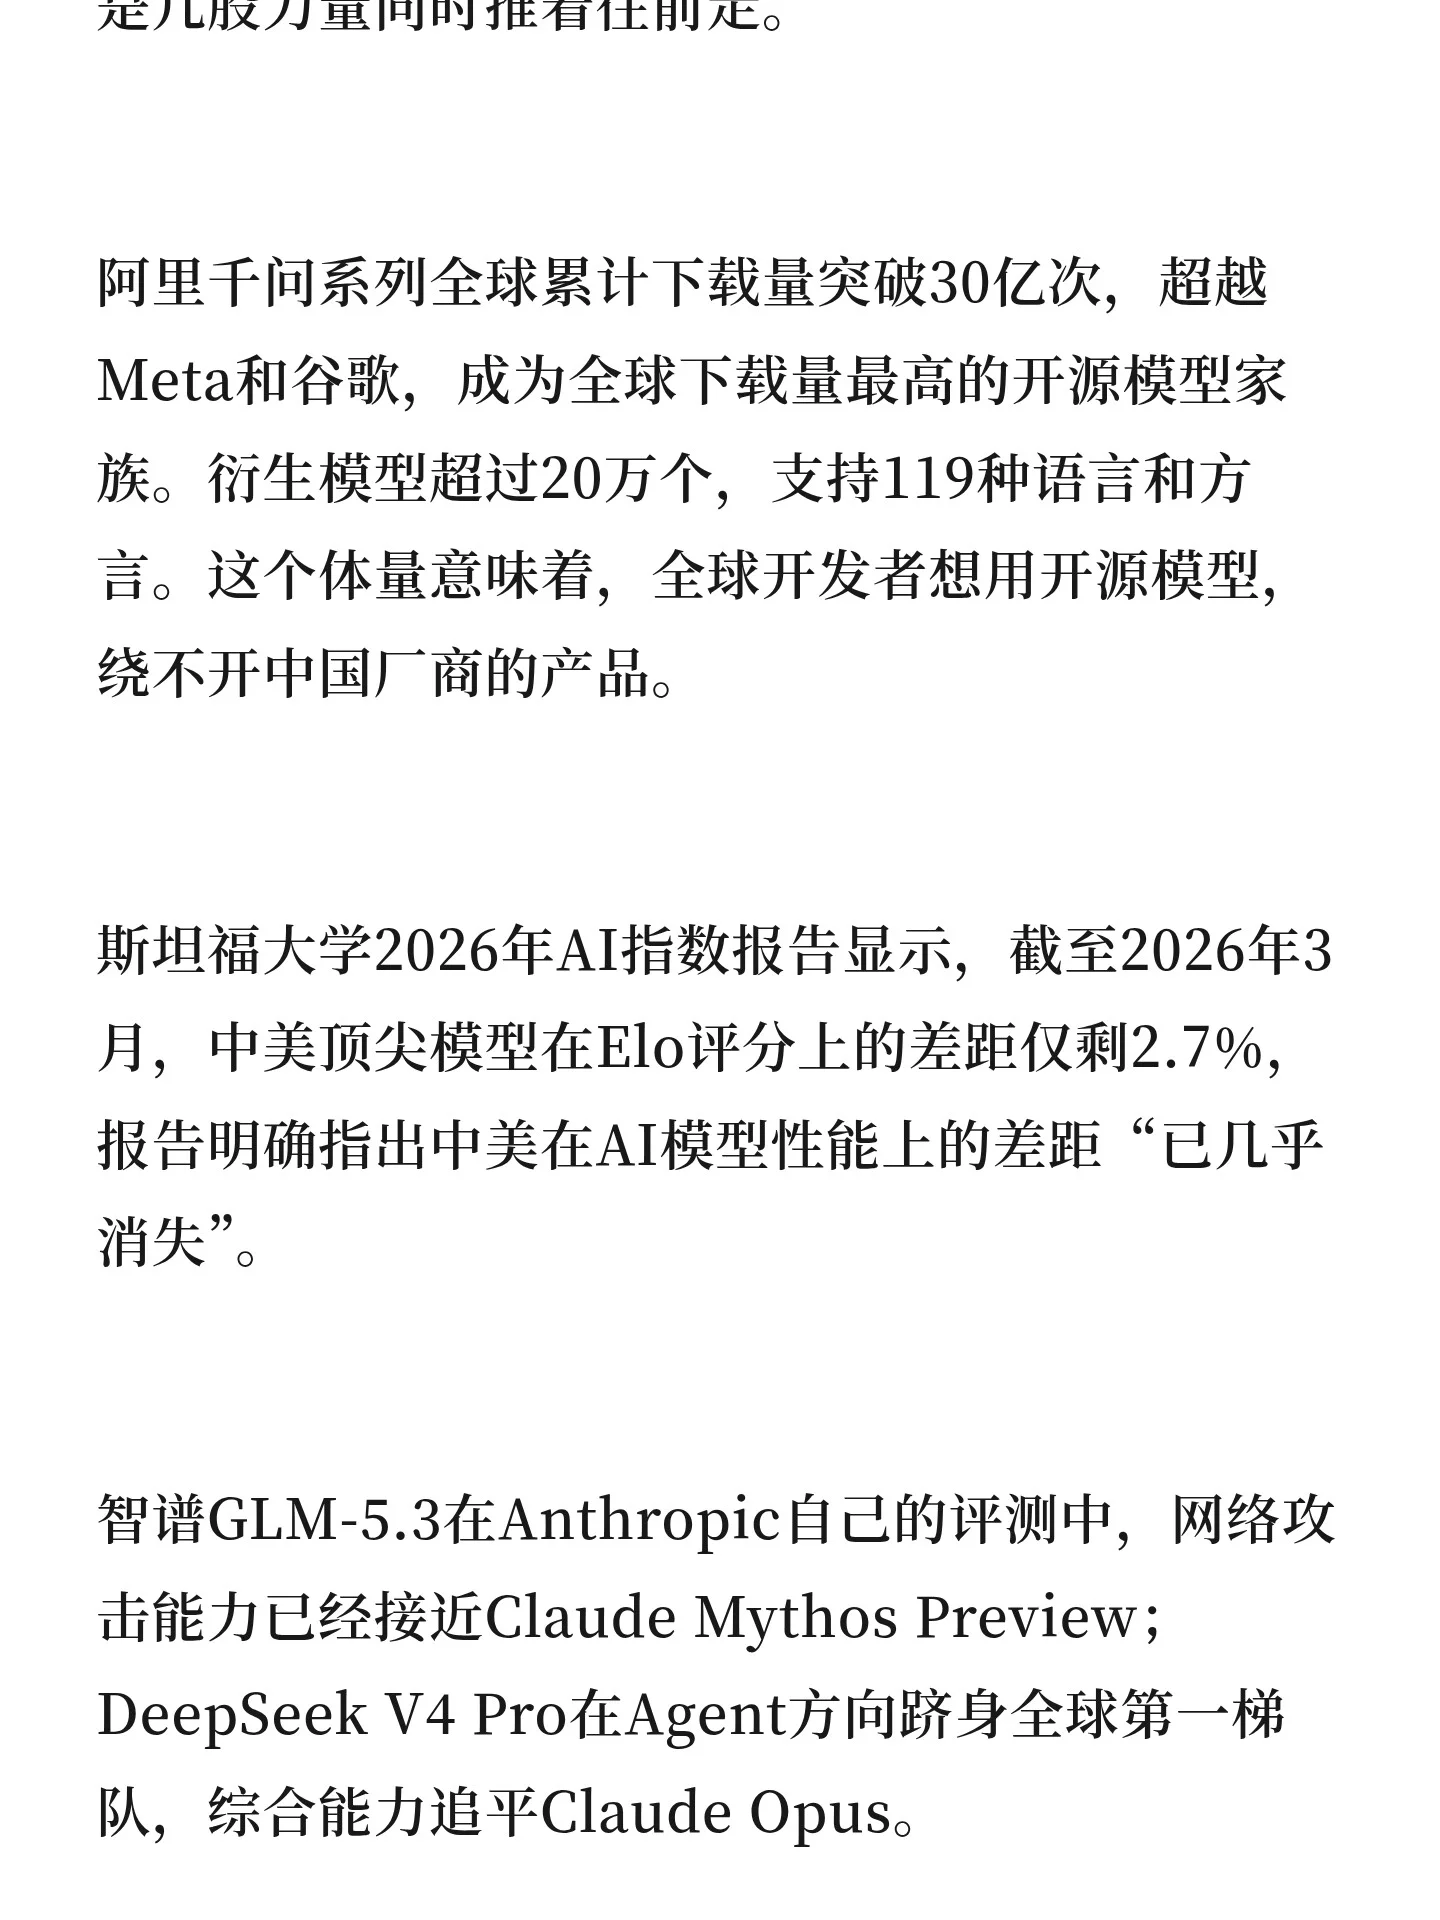
阿里千问系列全球累计下载量突破30亿次,超越Meta和谷歌,成为全球下载量最高的开源模型家族。衍生模型超过20万个,支持119种语言和方言。这个体量意味着,全球开发者想用开源模型,绕不开中国厂商的产品。
斯坦福大学2026年AI指数报告显示,截至2026年3月,中美顶尖模型在Elo评分上的差距仅剩2.7%,报告明确指出中美在AI模型性能上的差距“已几乎消失”。
智谱GLM-5.3在Anthropic自己的评测中,网络攻击能力已经接近Claude Mythos Preview;DeepSeek V4 Pro在Agent方向跻身全球第一梯队,综合能力追平Claude Opus。
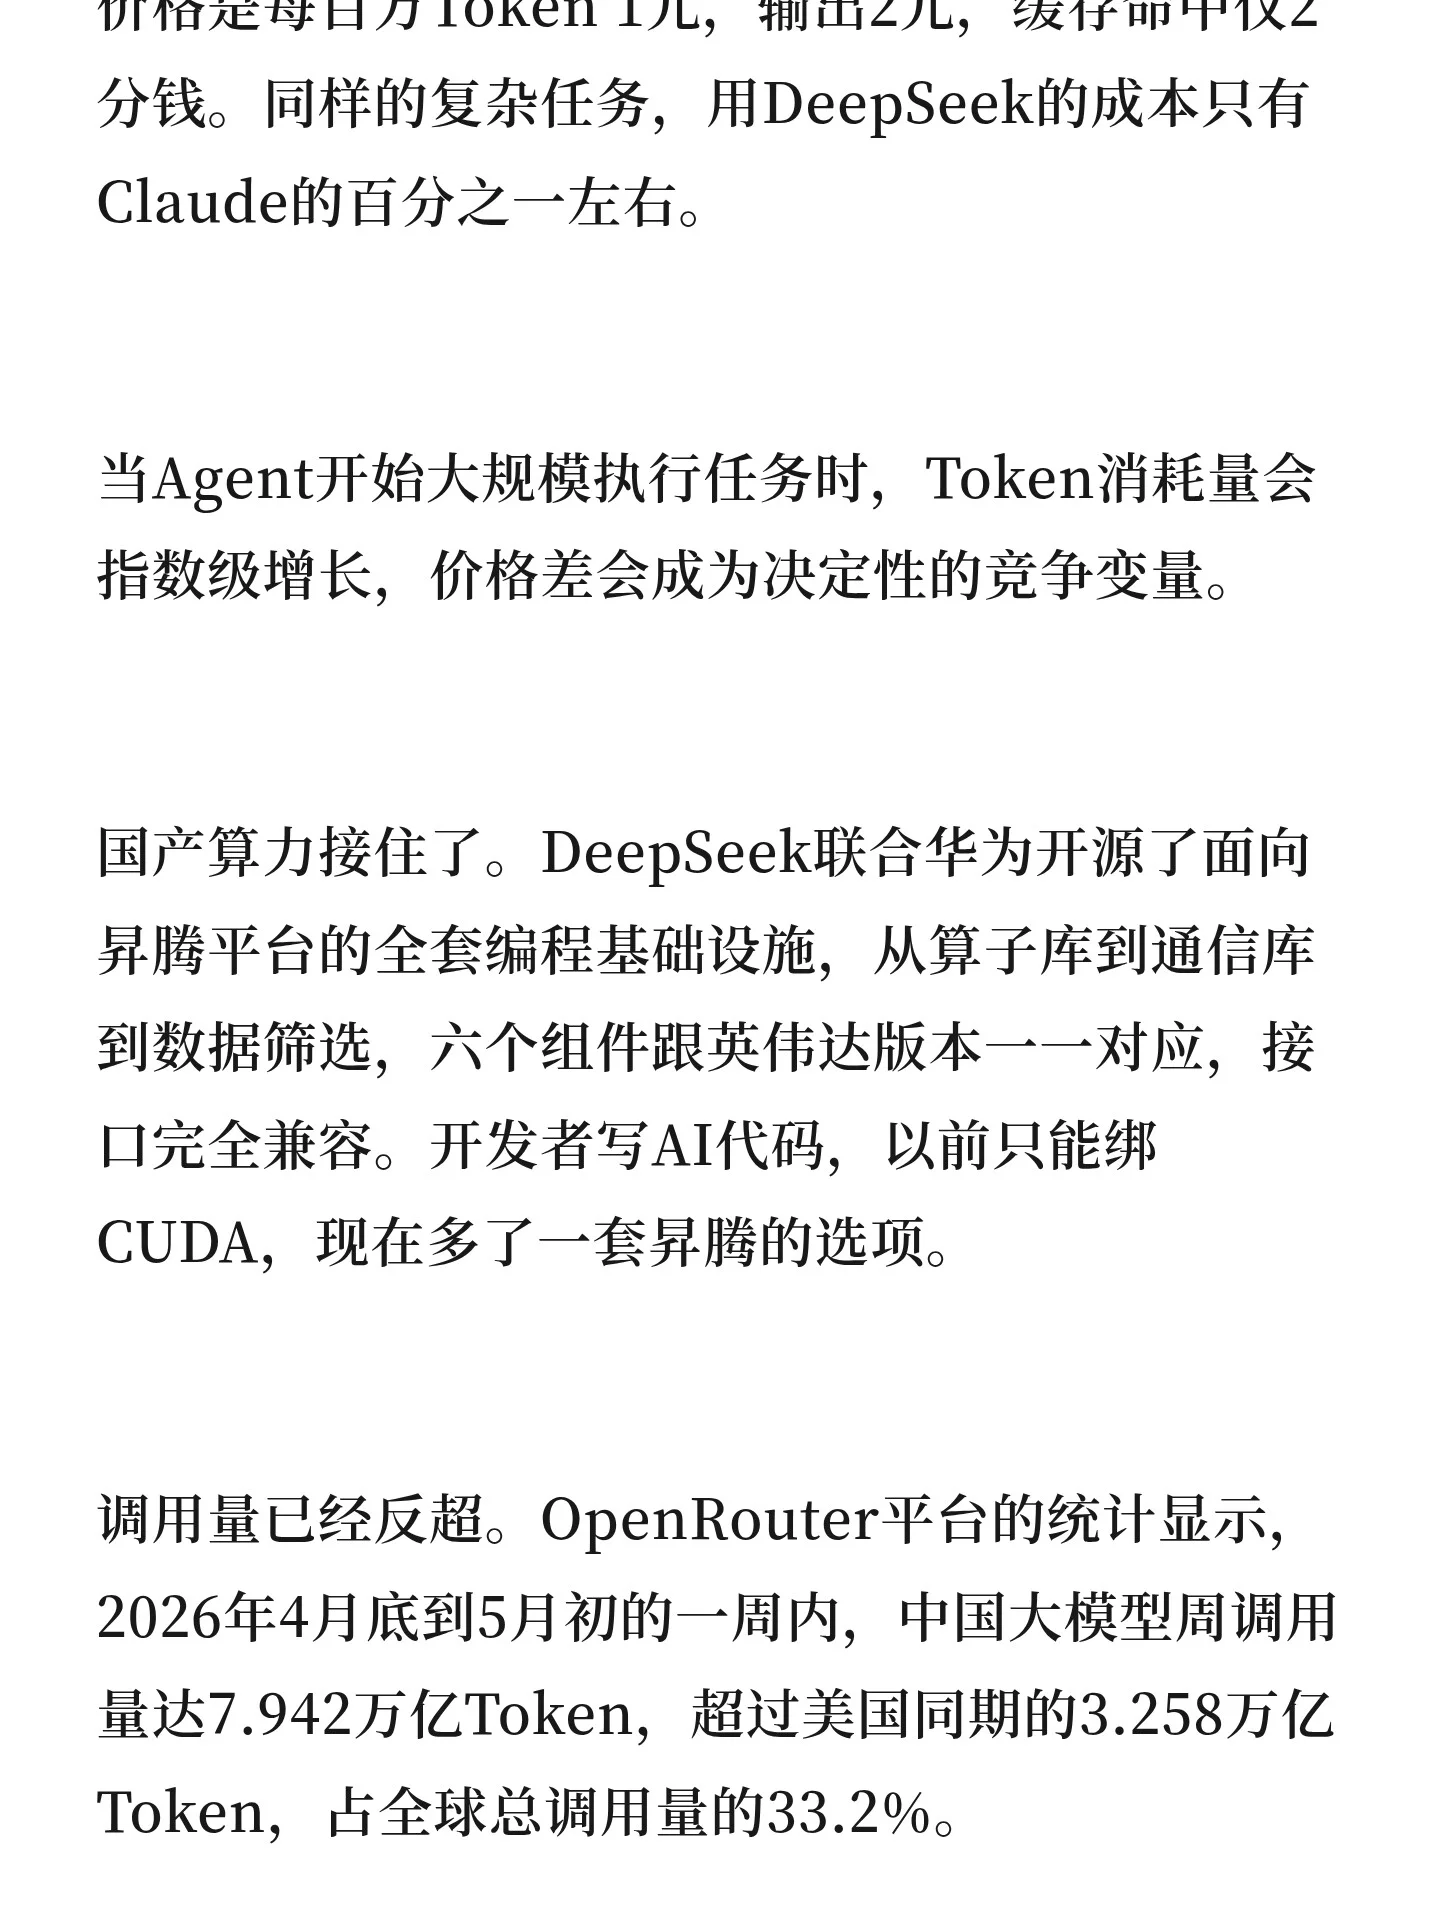
成本优势是杀手锏。DeepSeek V4 Flash的输入价格是每百万Token 1元,输出2元,缓存命中仅2分钱。同样的复杂任务,用DeepSeek的成本只有Claude的百分之一左右。
当Agent开始大规模执行任务时,Token消耗量会指数级增长,价格差会成为决定性的竞争变量。
国产算力接住了。DeepSeek联合华为开源了面向昇腾平台的全套编程基础设施,从算子库到通信库到数据筛选,六个组件跟英伟达版本一一对应,接口完全兼容。开发者写AI代码,以前只能绑CUDA,现在多了一套昇腾的选项。
调用量已经反超。OpenRouter平台的统计显示,2026年4月底到5月初的一周内,中国大模型周调用量达7.942万亿Token,超过美国同期的3.258万亿Token,占全球总调用量的33.2%。
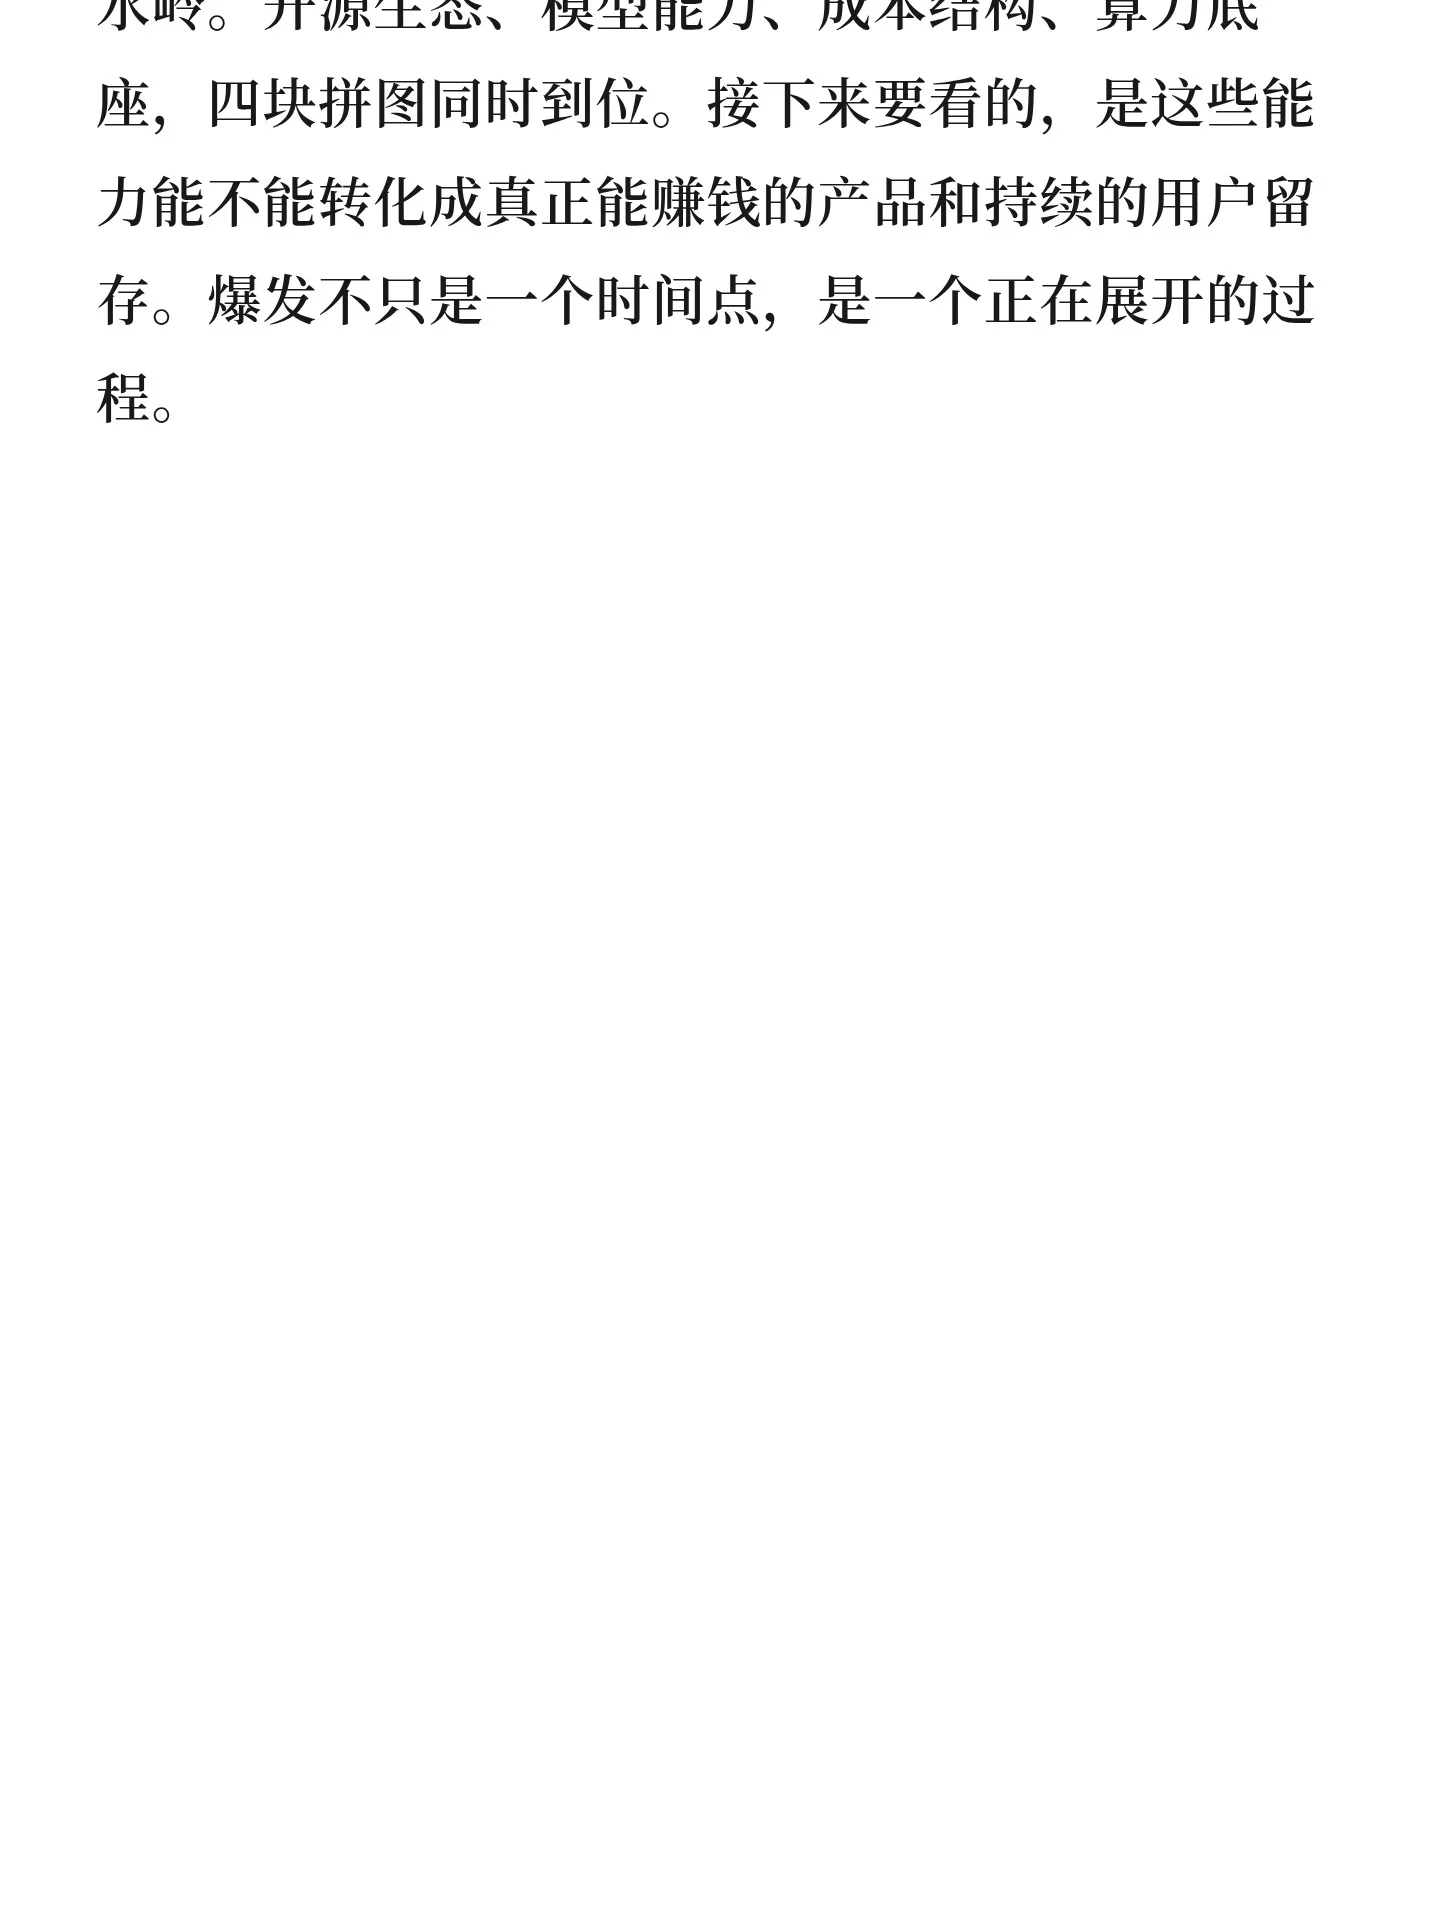
国产大模型过去两年一直在追赶,2026年是一个分水岭。开源生态、模型能力、成本结构、算力底座,四块拼图同时到位。接下来要看的,是这些能力能不能转化成真正能赚钱的产品和持续的用户留存。爆发不只是一个时间点,是一个正在展开的过程。
#人工智能 #小红书科技AMA #科技 #热点 #互联网大厂 #大模型 #ai