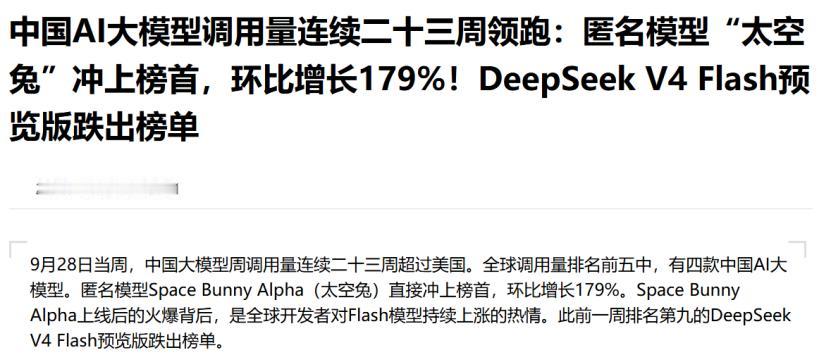
中国AI调用量连续23周领先,算力竞争开始拼精打细算了📝
看到中国大模型调用量连续23周超过美国,我突然觉得,中科曙光今年开始反复强调Token效率,确实有点意思。
最新数据显示,中国AI大模型周调用量达到57.46万亿Token,全球前五的模型里有四款来自中国。更有意思的是,现在开发者越来越喜欢响应快、成本低的Flash模型。
这说明AI正在发生一个变化:以前大家比模型有多聪明,现在还要比谁用得起、跑得快。
这让我想到当年的移动互联网。智能手机刚出来时,大家拼硬件配置,等用户规模上亿之后,流量成本、运行效率、用户体验就成了关键。
AI可能正在走类似的路。
中科曙光今年推出的ParaCache,就是想办法减少大模型推理中的重复计算,把已经算过的内容尽可能复用,提高Token处理效率。
这事听着没有发布新芯片那么热闹,但如果未来每天都有海量AI请求,哪怕每次少消耗一点计算资源,长期积累下来也很可观。
当然,缓存效果取决于实际业务场景,不能把测试数据直接当成普遍效果。
但方向确实值得琢磨。当国产大模型开始靠规模化调用打开市场,背后的算力系统也得跟着提高效率。
以前大家忙着把算力建起来,未来恐怕更要研究怎么把算力用好。曙光在这方面的布局,值得持续关注。
中科曙光 国产大模型 Token效率 ParaCache