AI Eval(下)|Chatbot上线后怎么Monitor
通过Offline Eval不代表Chatbot在真实环境中就能稳定表现,还需要持续进行Production Monitoring。
01|Monitor哪些Metrics?
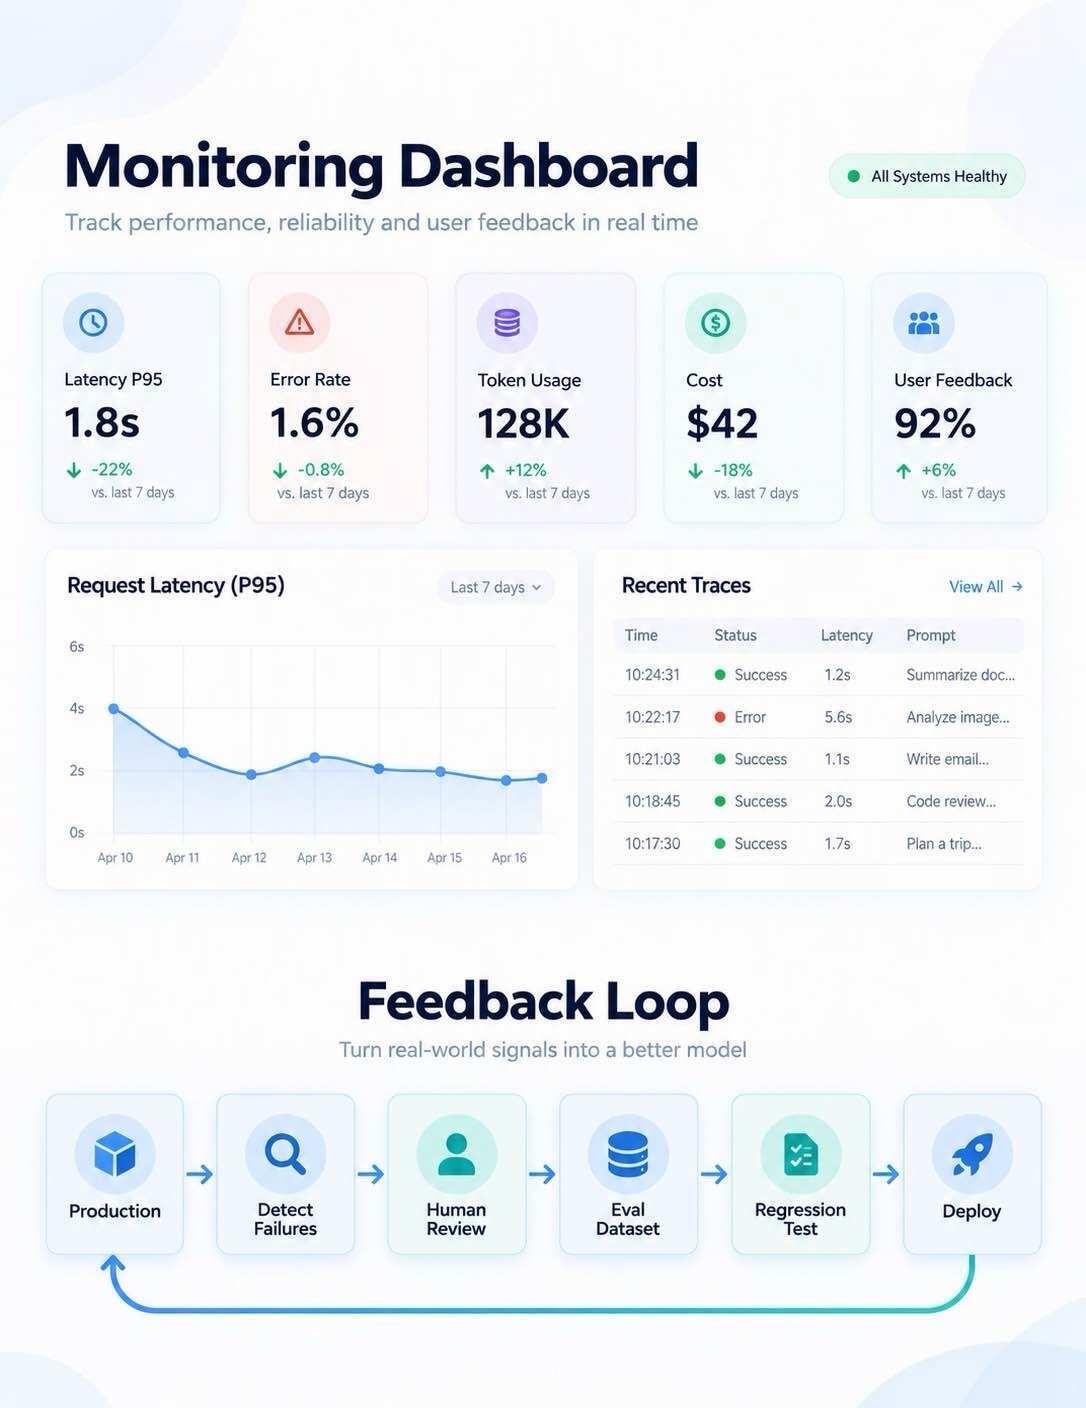
-System Metrics:Latency(P95/P99)、Error Rate、Token Usage、Cost,关注系统稳定性。
-Quality Metrics:Faithfulness、Answer Relevancy、Tool Call Success Rate,关注回答质量。
-User Metrics:User Feedback、Task Completion Rate,关注用户体验与完成情况
02|Tracing:怎么定位问题?
通过Tracing记录Retrieval、Model Call、Tool Call等步骤,定位Failure发生在哪一环。例如RAG回答错误,可能是检索失败,也可能是LLM没有正确利用Context。
03|Online Evaluation
真实环境通常没有Ground Truth,可以抽样Production Traces,通过LLM-as-a-Judge、Rule-based Evaluator或Human Review评估质量,同时注意Judge Bias。
04|建立Feedback Loop
Production Traces → Detect Failures → Human Review → Eval Dataset → Regression Testing → Deploy
把线上Failure Cases加入Offline Eval Dataset,让后续Prompt、Model或RAG更新能够针对真实问题进行回归测试。
05|常见工具
LangSmith:Tracing、Online Eval、Monitoring
Arize Phoenix:开源LLM Observability、Tracing、Evaluation
Offline Eval决定能不能上线,Online Monitoring帮助判断上线后是否持续可靠,而Feedback Loop让系统越来越好。
@HOWTO薯
AI新手村 AI新手村 我这行的AI路 AI搞学习howto AI评估 AI学习 LLM