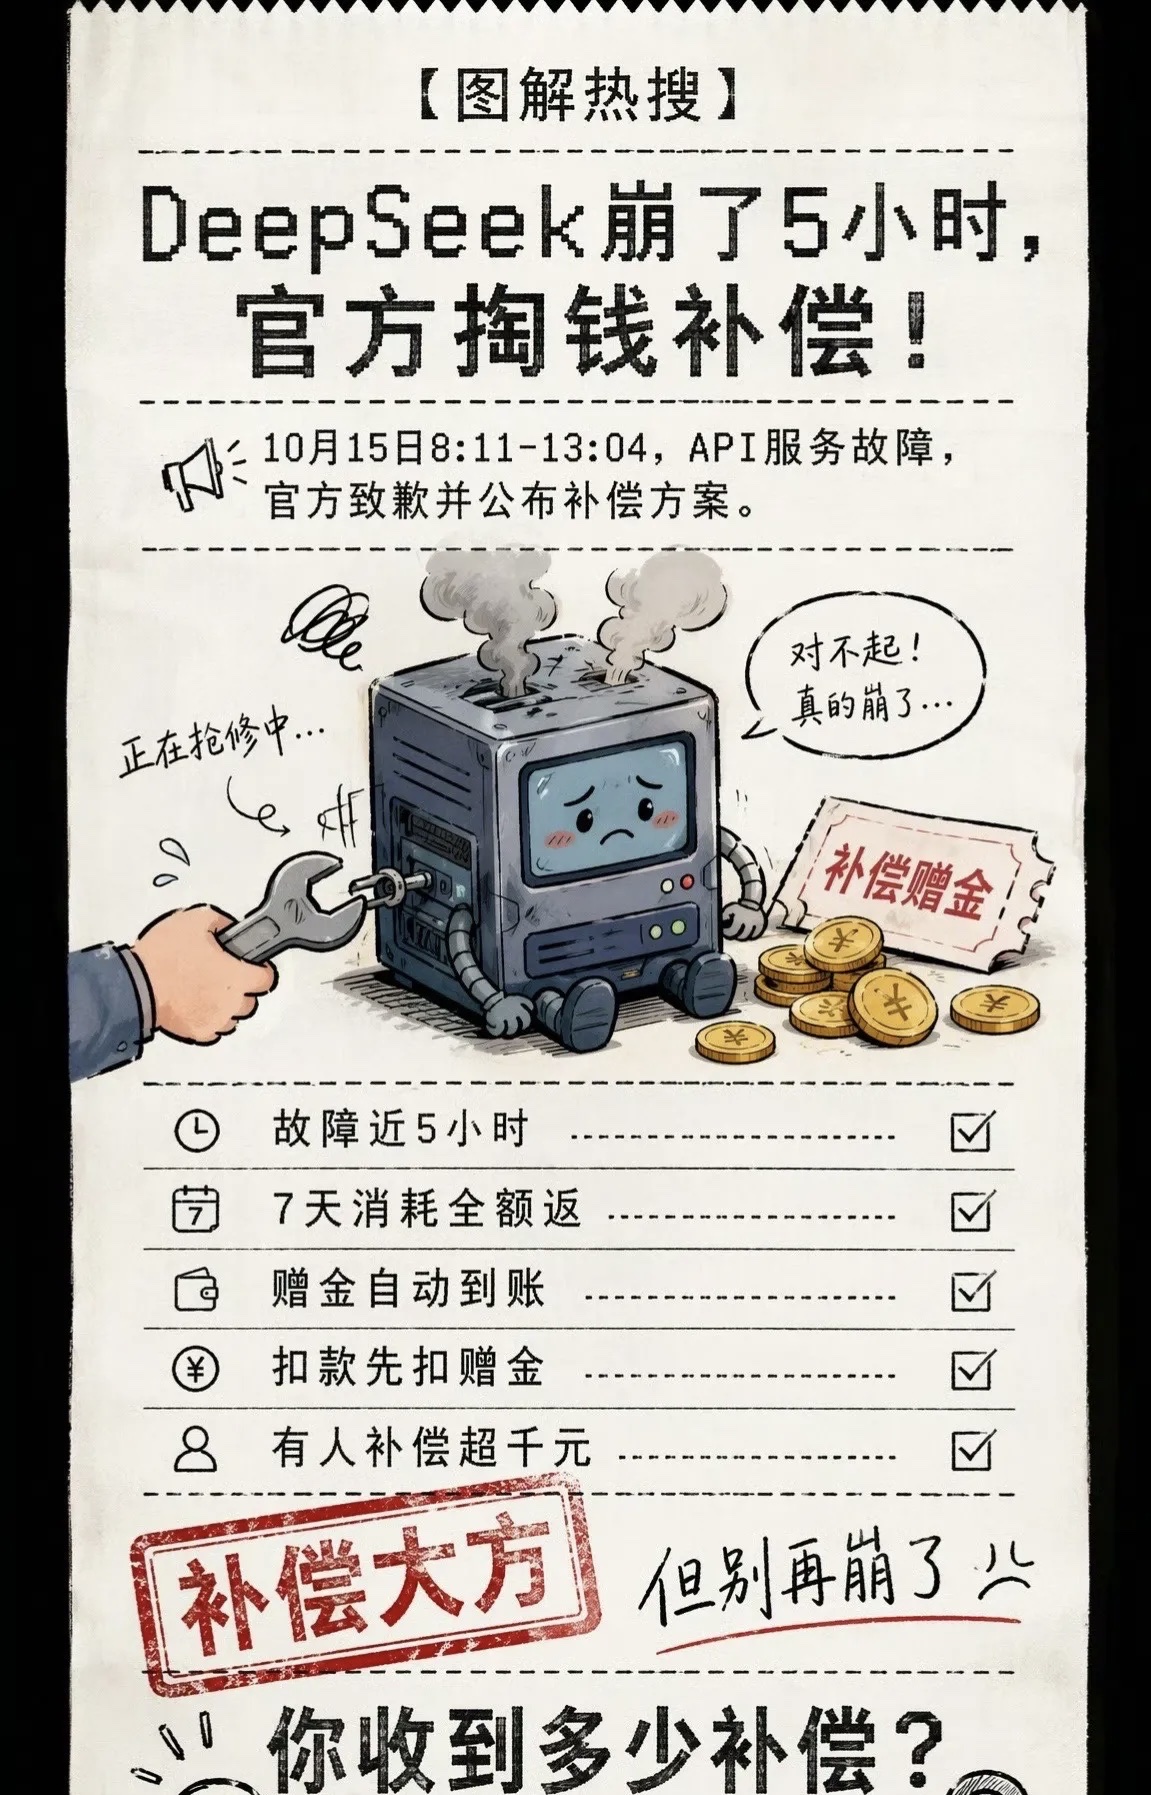
10月15日早上8点刚过,不少打工人点开DeepSeek,屏幕却弹出“服务器暂时不可用”。从网页端到App,再到开发者依赖的API,几乎全线熄火。故障从8:11开始,到13:04才恢复,整整近5小时,正好撞上国内上午办公高峰。DeepSeek崩了很快冲上热搜,有人调侃:“AI员工旷工半天,人类员工干瞪眼。”
这并非孤例。今年以来,DeepSeek状态页已多次出现“服务不可用”“性能下降”等记录。模型火得太快、调用量猛涨,算力供需错位,让原本藏在后台的工程压力被推到台前。智能体时代,AI不再是玩具——代码分析、内容生成、数据流转都挂在API上,一旦停摆,企业业务链也会跟着“卡帧”。
真正让舆论反转的,是当晚的补偿通知。DeepSeek没有发一张象征性代金券,而是按账号把10月8日至14日的API消耗金额,以赠金形式全额返还,自动到账,后续扣费优先走赠金账户。轻量用户退回几块钱,重度开发者晒出几百、上千元额度,“按实际花费赔”比“统一发券”更有体感。
横向看,这事挺少见。传统云厂宕机多按SLA赔代金券、有上限、还要工单申请;海外部分大模型服务甚至合同里根本不写宕机补偿。DeepSeek这波相当于说:你过去一周在我这儿花多少,我就还你多少,不扯皮、不限额、不催过期。
但钱能平账,信任不能只靠退款。官方在通知里承诺“全面梳理并剥离单点依赖”,却没公开具体故障根因。对企业用户来说,赔回一周账单,赔不回中断时丢掉的客户询盘、跑一半的智能体任务、重跑成本的工程师时间。
所以这件事的意义不止“大模型公司终于学会赔钱”。它把一句话摆到行业面前:当AI变成水电,服务稳定性就是基础设施的及格线。下次用户要的不再是“崩了退我钱”,而是“最好别再崩”。