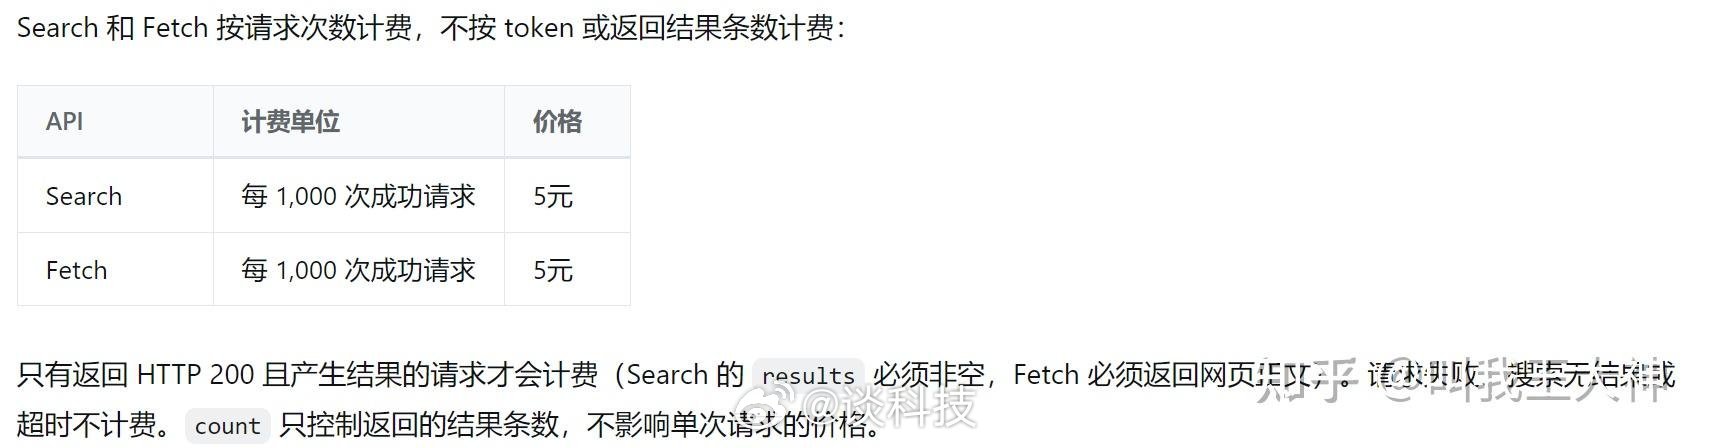
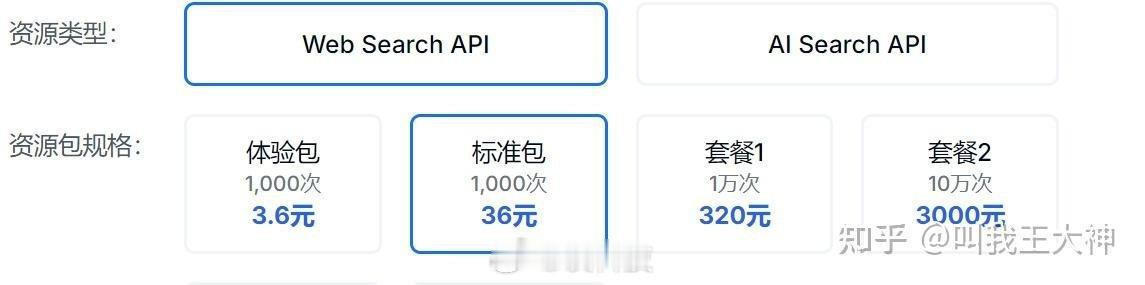
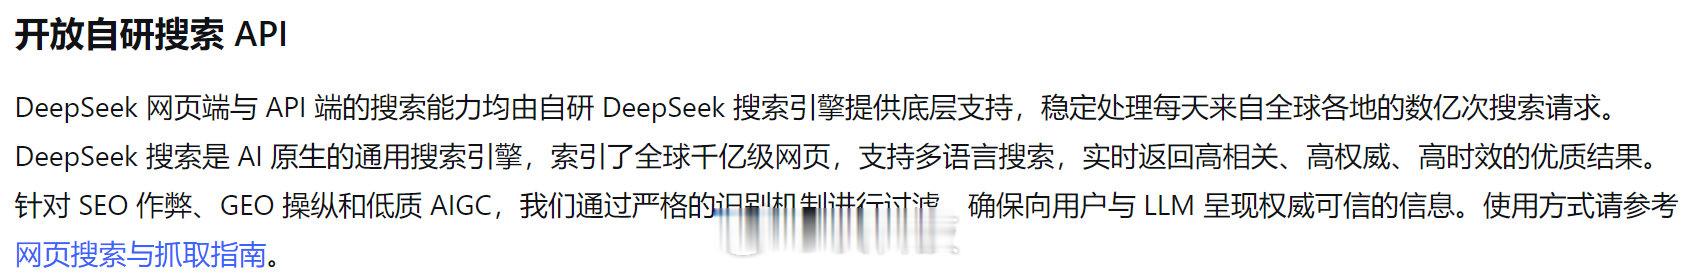
模型圈子天天比谁的分数高,真正做产品的人盯的是另一件事:这次把 search 和 fetch 两个接口开放了。 这两个词听着像术语,拆开很简单。search 是给模型一个能查的入口,你丢一句话过去,它返回一批网页和摘要;fetch 是把某个网址的正文抓回来,再喂给模型读。一个负责“知道去哪找”,一个负责“把东西读进来”。少了其中任何一环,整个流程就断了。 为什么值得说?搜索 API 一直是按调用次数收费的生意,真正用量一上来,账单能比模型本身还贵。自己搭一套更难:反爬、清洗、去重、建索引、压低延迟,每一项都需要长期投入人力维护。小团队做应用,光这一层就能把预算吃掉大半。 所以开放这两个接口的实际意义,是把“能上网的模型”从演示推进到成本算得过来的产品。做知识库问答、做资料汇总、做比价、做舆情整理,以前卡在取数这一步,现在至少能先把业务逻辑跑通。 有几件事得先想清楚。返回条数和限流规则决定你的成本模型怎么设计;抓回来的正文质量参差不齐,噪声很多,得自己做过滤和摘要,别指望原样塞进去就能用;缓存也要做,同一类查询反复发起,既费钱又慢。