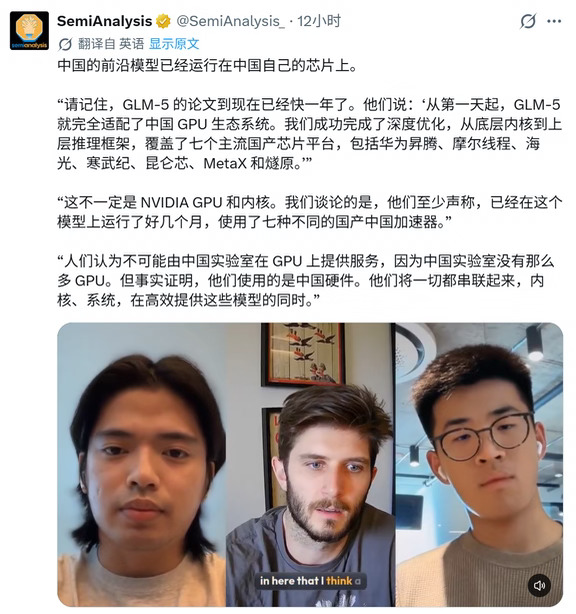
中国AI公司没有那么多英伟达显卡,怎么撑得住越来越多的用户?
10月14日,半导体研究机构SemiAnalysis的一期播客聊到了这个问题。他们提起一条容易被忽略的信息:模型背后的芯片,未必来自英伟达。
🇨🇳 七家国产芯片
节目中,主持人翻出智谱GLM-5的技术报告:从发布第一天起,模型就完成了对七家国产芯片平台的适配,包括华为昇腾、摩尔线程、海光、寒武纪、昆仑芯、沐曦和燧原。
适配覆盖底层算子到上层推理框架。换句话说,芯片之外,让模型运行起来的那套软件,也得一起打通。
💻 匿名测试的幕后
更有意思的细节,来自后续发布的GLM-5.3-Flash。
正式亮相前,智谱把它化名为Ox Alpha,放到OpenRouter和OpenCode上接受真实用户测试。
智谱在8月26日的发布文章中披露:这些测试流量,全部由国产AI芯片承接。用户在前台提问、写代码,后台运行的是国产硬件。
🔧 AI给自己修路
随后,智谱进一步公开了这套系统的搭建过程。
按照公司的说法,GLM-5.3-Flash的生产推理运行在一个超过10万颗国产AI加速器的集群上。
但芯片堆起来,模型不会自动跑好:单颗芯片的内存和带宽有限,底层算子支持不完整,还要应付长文本和多模态请求。
工程师找来的帮手,恰好也是AI。
由GLM-5.3驱动的基础设施智能体,参与编写和优化底层算子、排查错误、定位性能瓶颈。
模型参与优化基础设施,这套基础设施再来运行模型。
智谱称,团队用了不到两周,从初步适配推进到具备生产服务能力,同一硬件上的端到端吞吐量提升约3倍。
📌 进展与边界
这也是这次讨论值得关注的地方:国产芯片开始拿出承接真实流量、优化大规模服务的具体案例。
不过,完成七家平台适配,不代表七家都已规模部署;用国产芯片提供推理服务,也不等于训练全程使用国产芯片。上述集群规模与性能提升,目前仍是智谱披露的数据。
过去谈中国AI的算力,常常先问“还能买到多少英伟达”。现在,这个问题后面需要再加一句:已有的国产芯片,究竟被用到了什么程度?
#国产芯片 #智谱 #GLM #英伟达#摩尔线程 #海光 #华为昇腾 #沐曦 #燧原 #昆仑芯