字节扒出DeepSeekV4Pro翻车之谜 DeepSeek V4 Pro,一款把梁圣干成牢梁,还下架又上架,秽土转生了一波的神奇模型。一直以来我们都不知道 V4 Pro 到底哪儿出问题了,直到隔壁字节的 Seed 团队挖出来了一些线索,说是模型的上下文压缩出问题了。。。
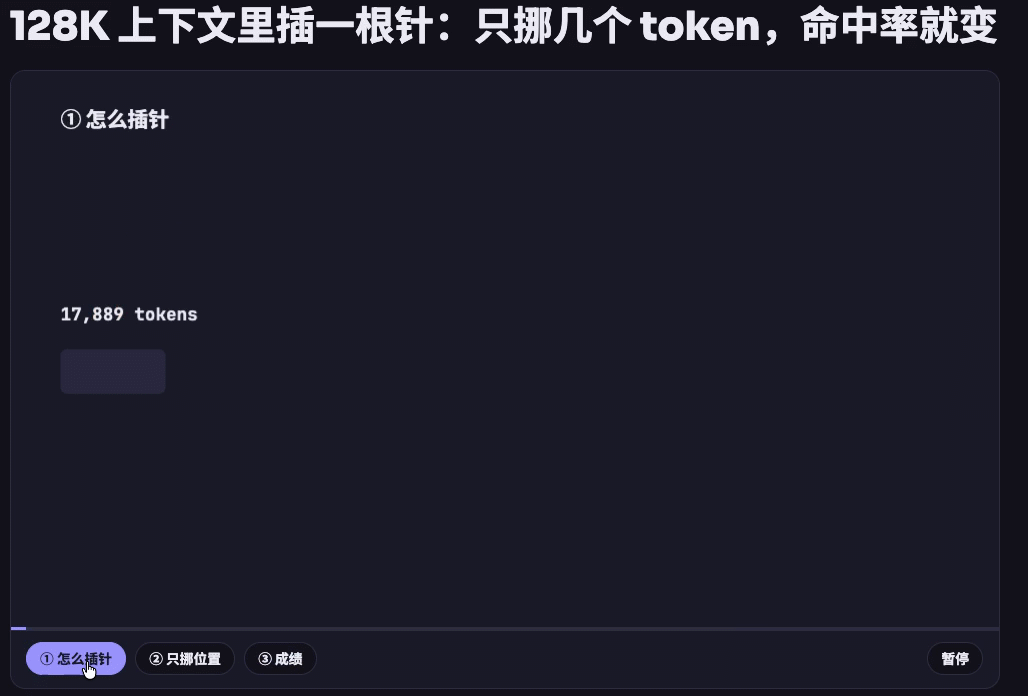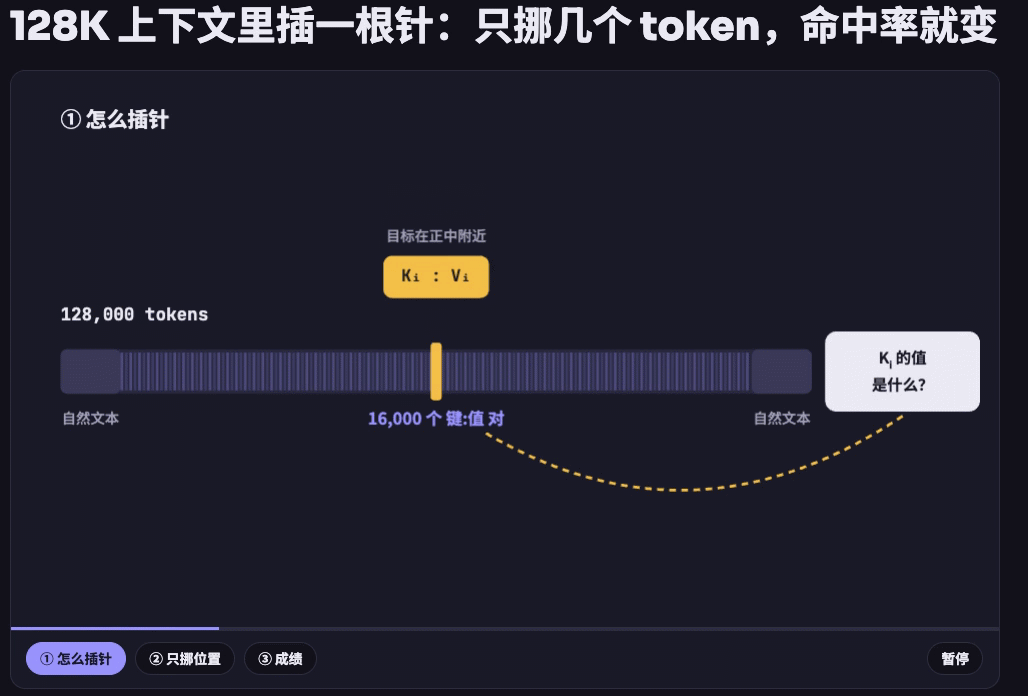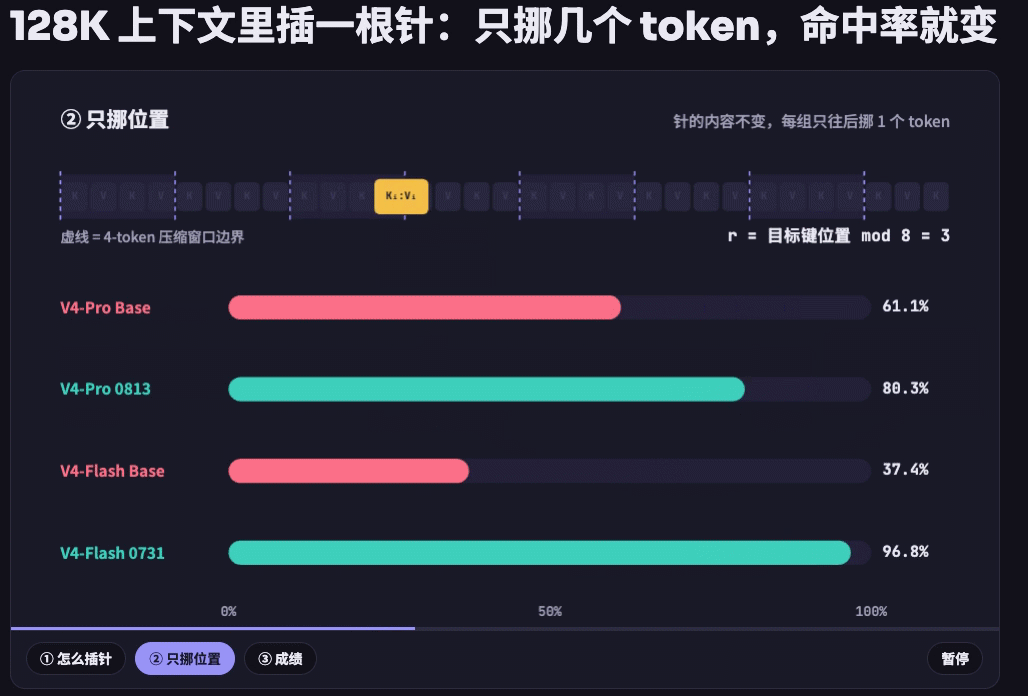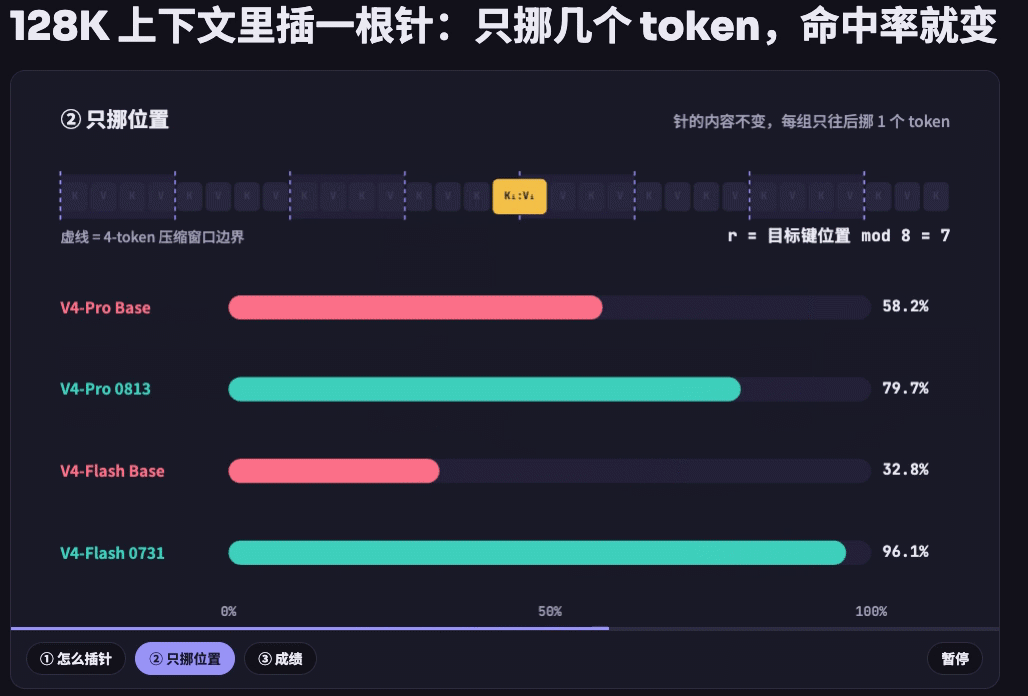
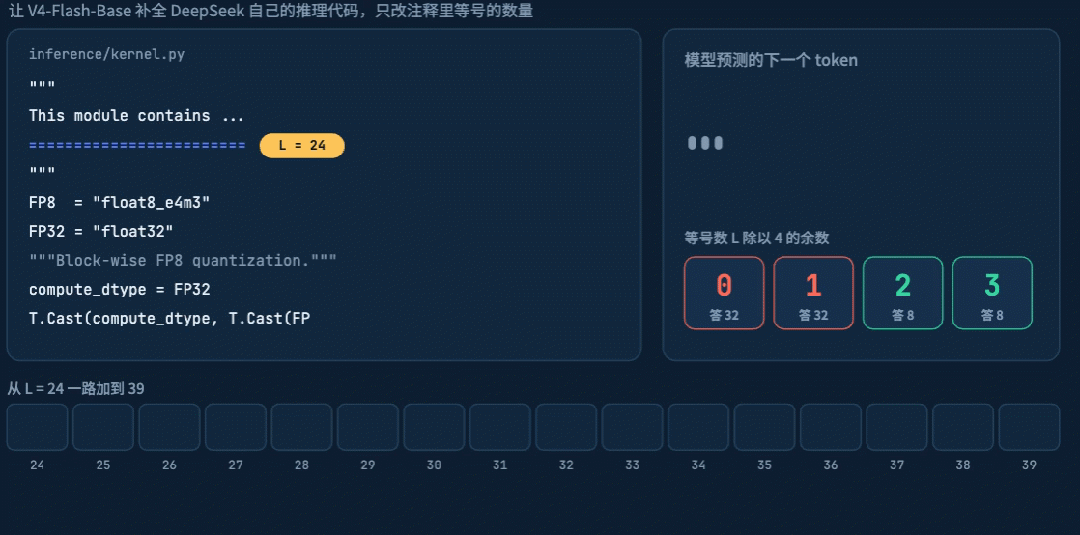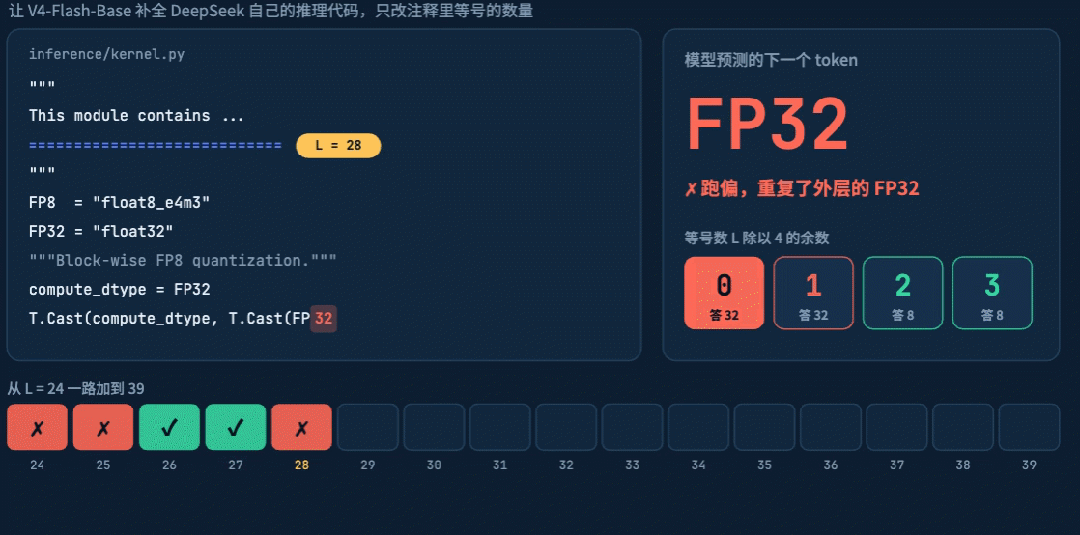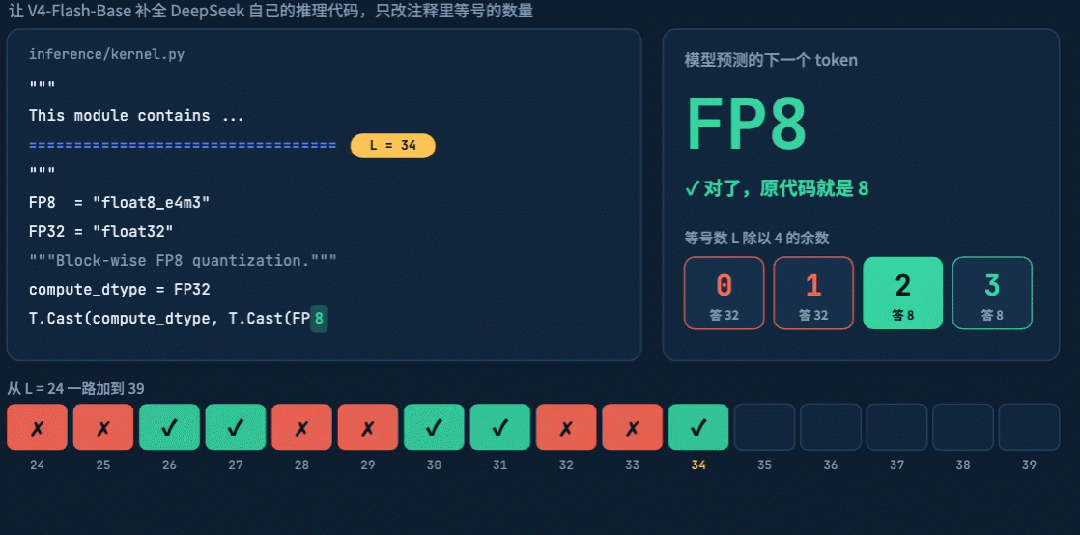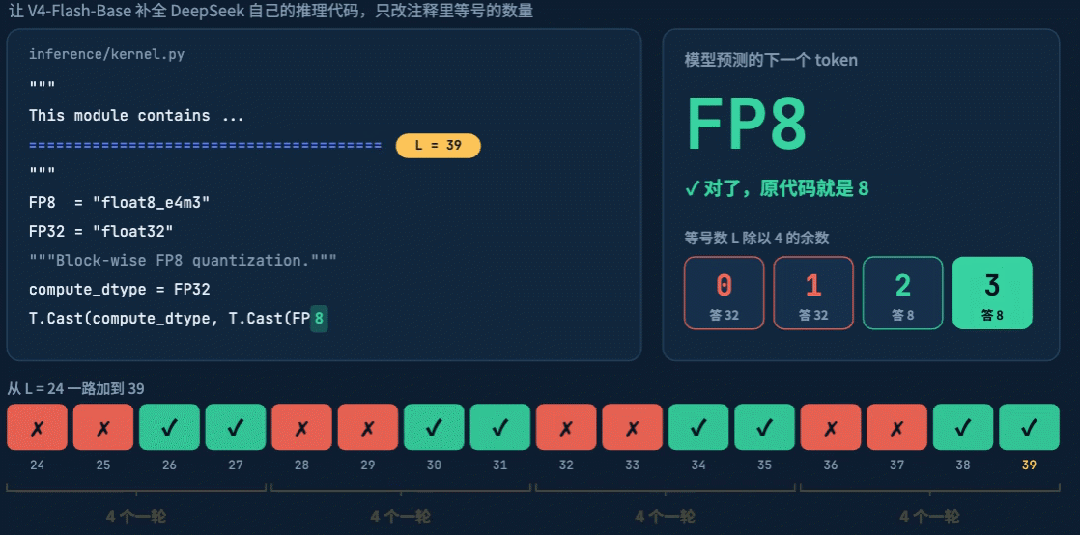
具体来说,V4 Pro 患上了某种有规律的选择性失忆。论文里,研究人员拿 DeepSeek 自己的推理代码做了个实验,让 V4 补全一段代码。结果发现,只要往前面的注释里加几个无关紧要的等号,上下文变长点,模型就会在正确和错误答案中间反复横跳。而且每隔4个 Token,就会重复一轮。按照专业的说法,这叫相位敏感性。
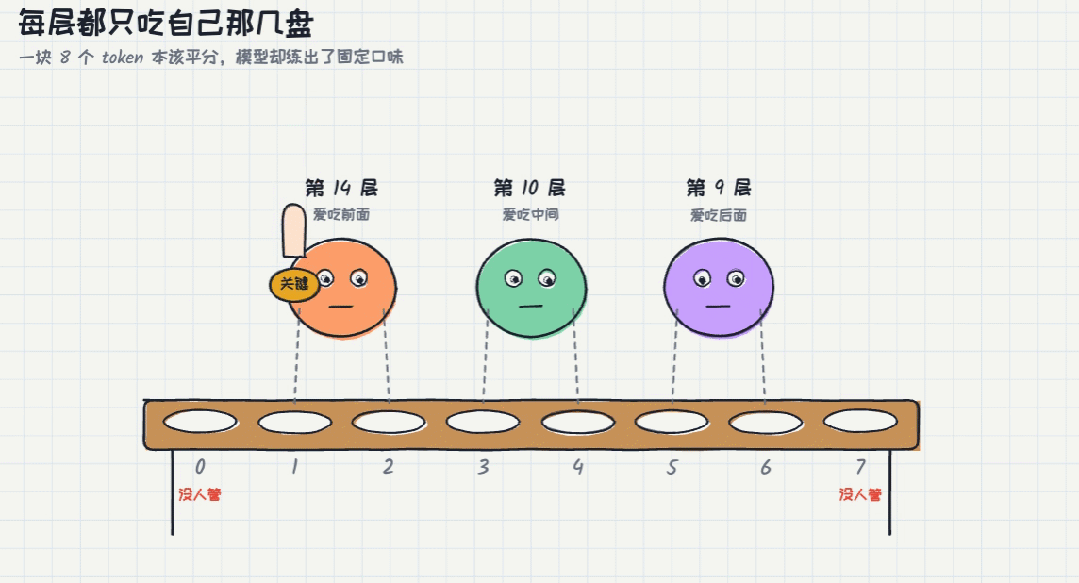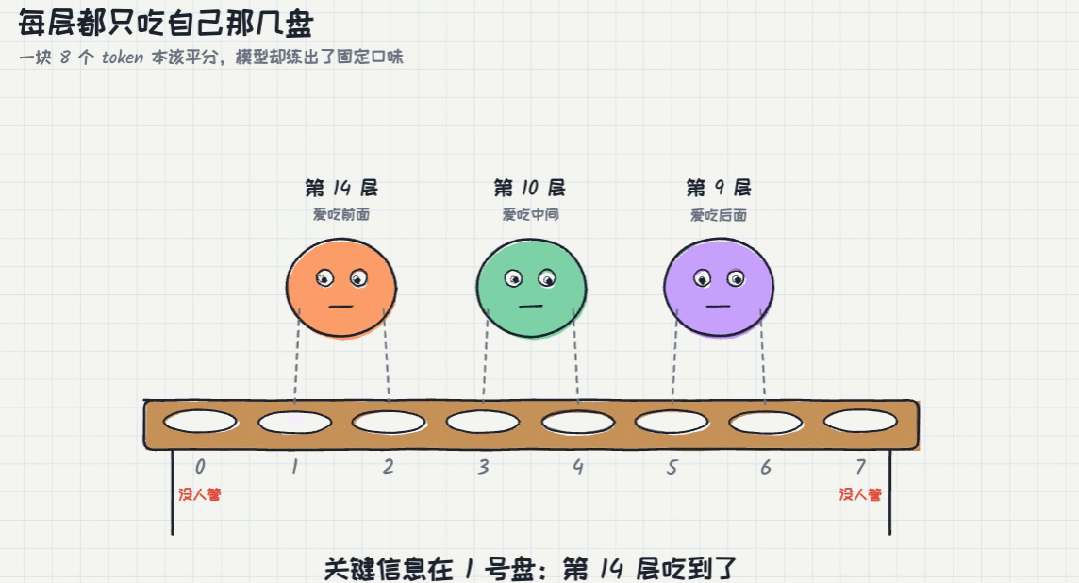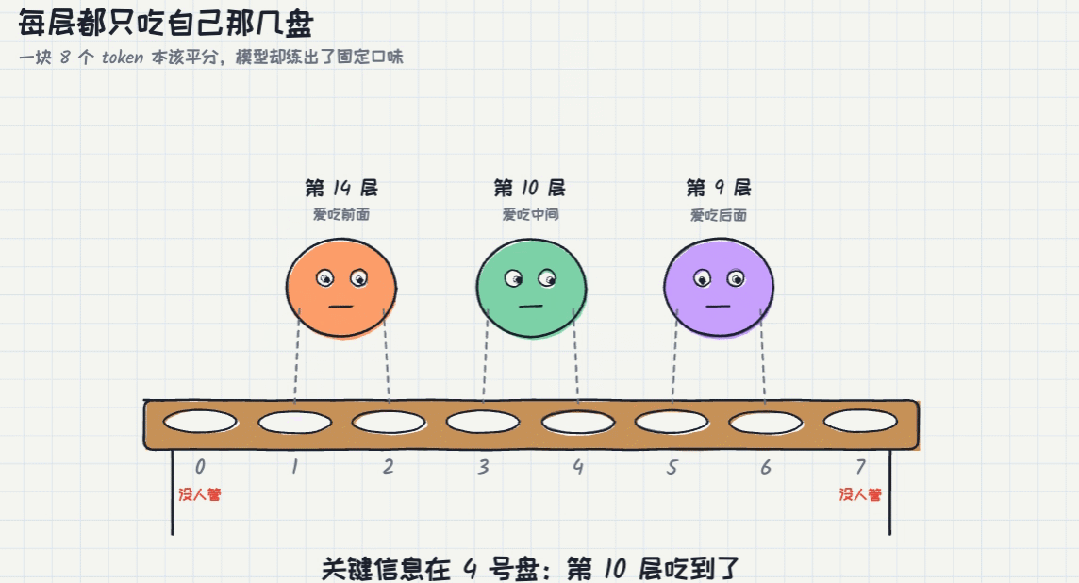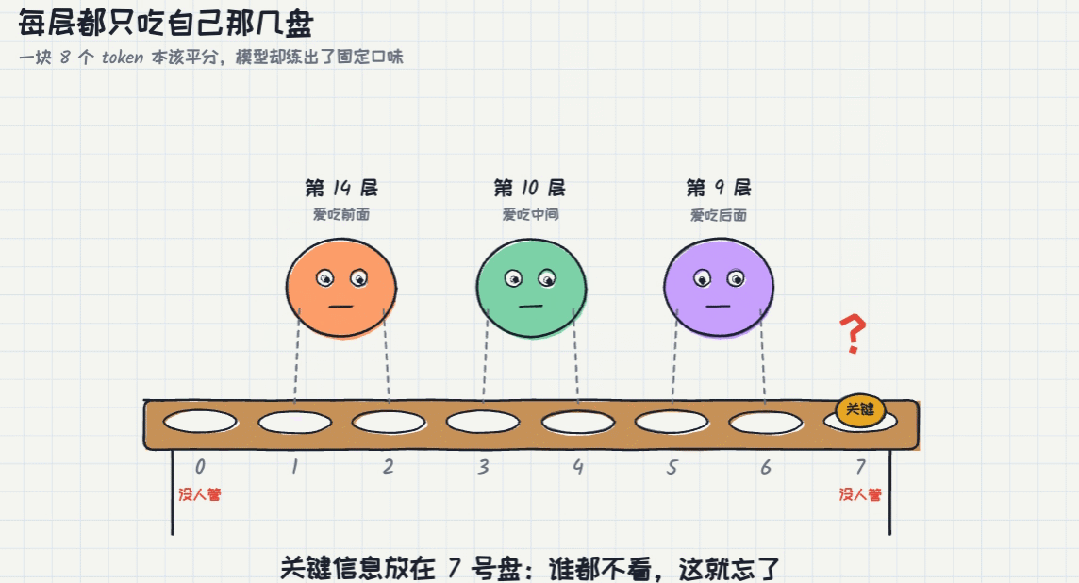
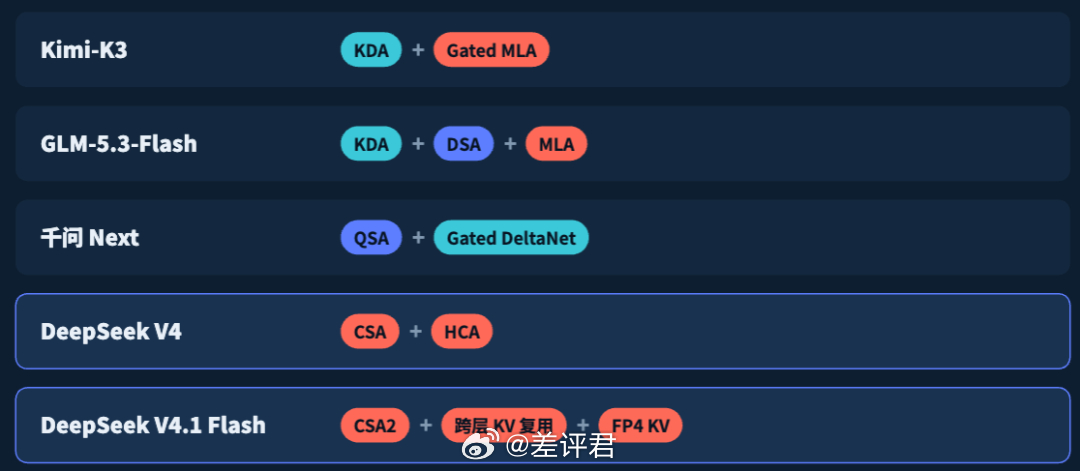
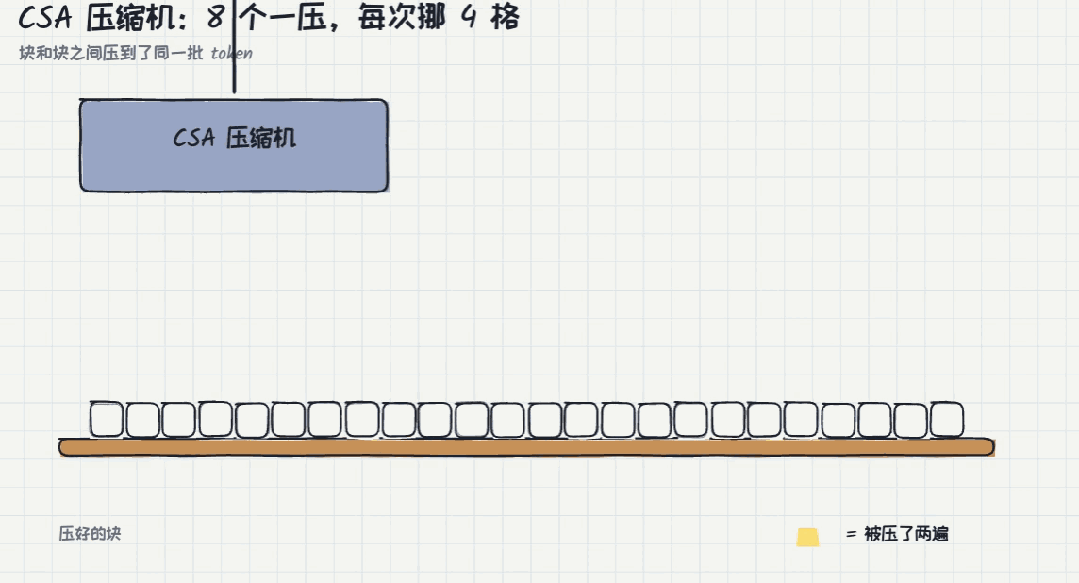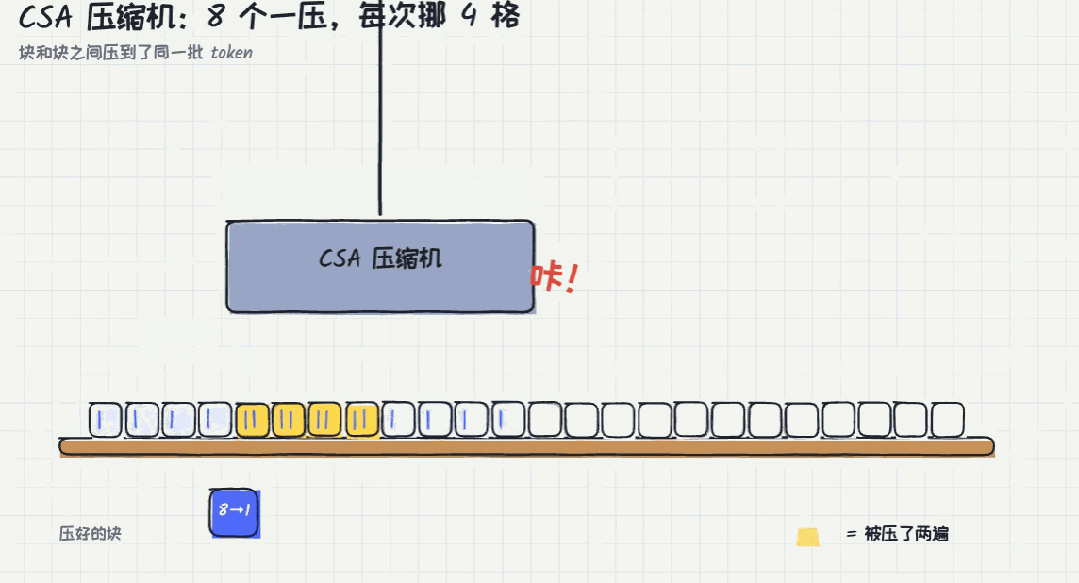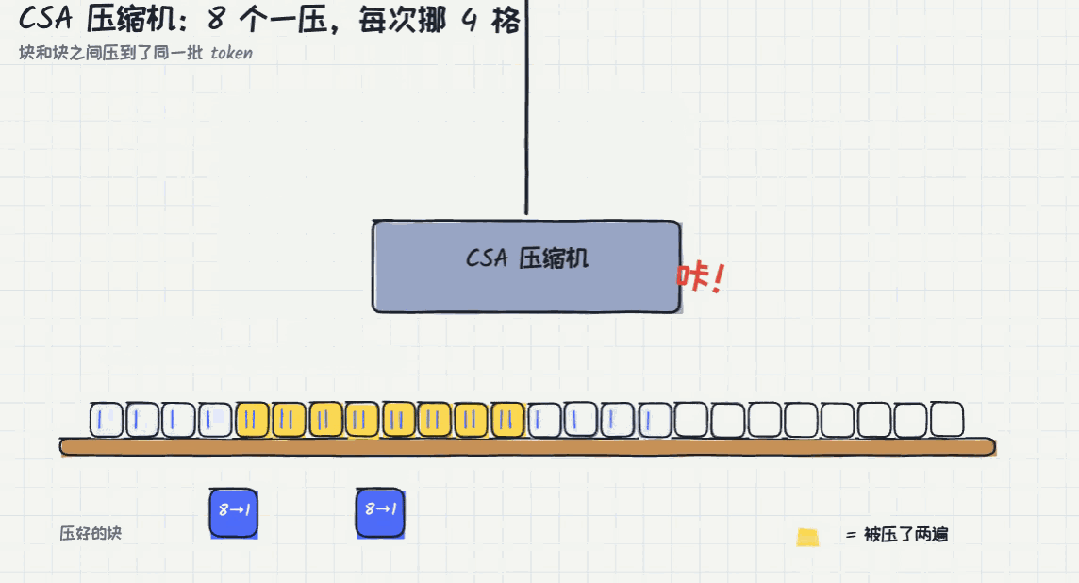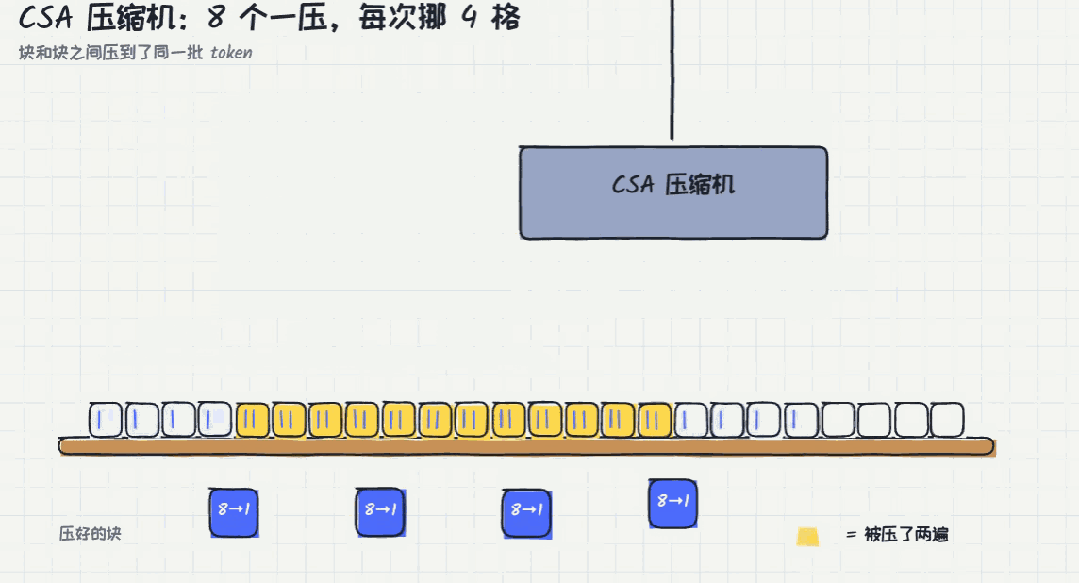
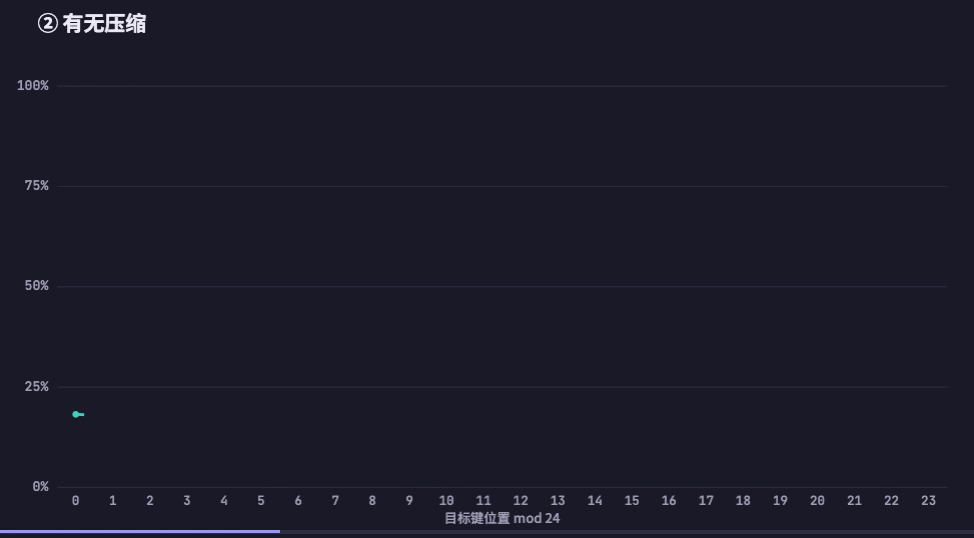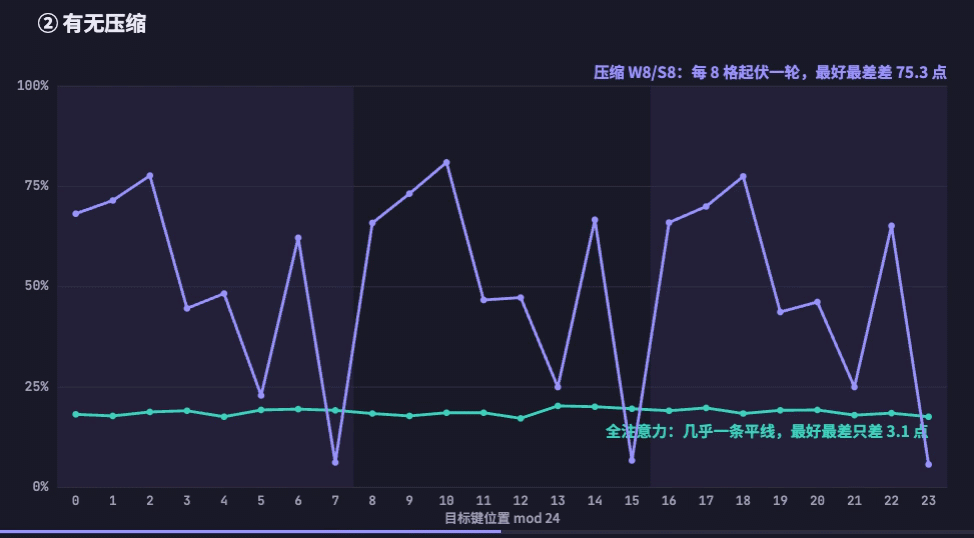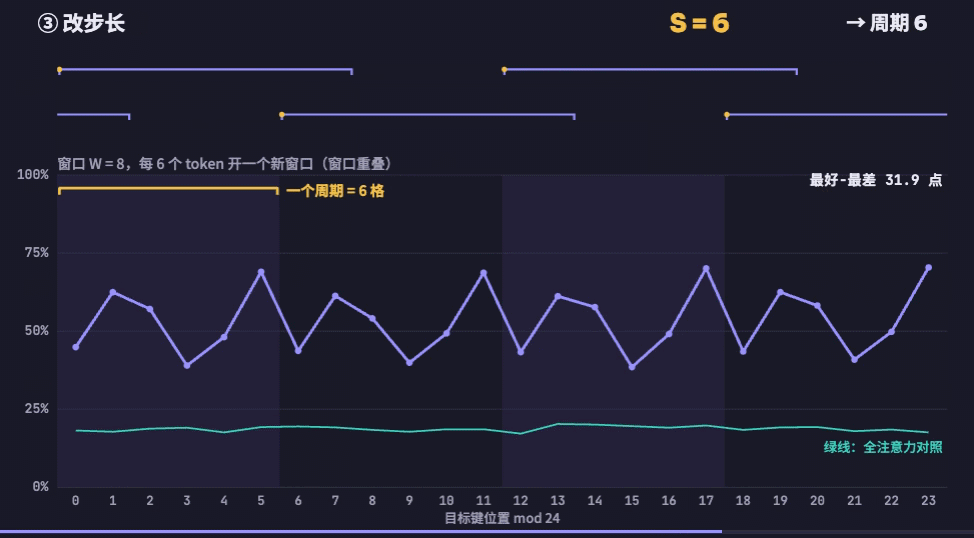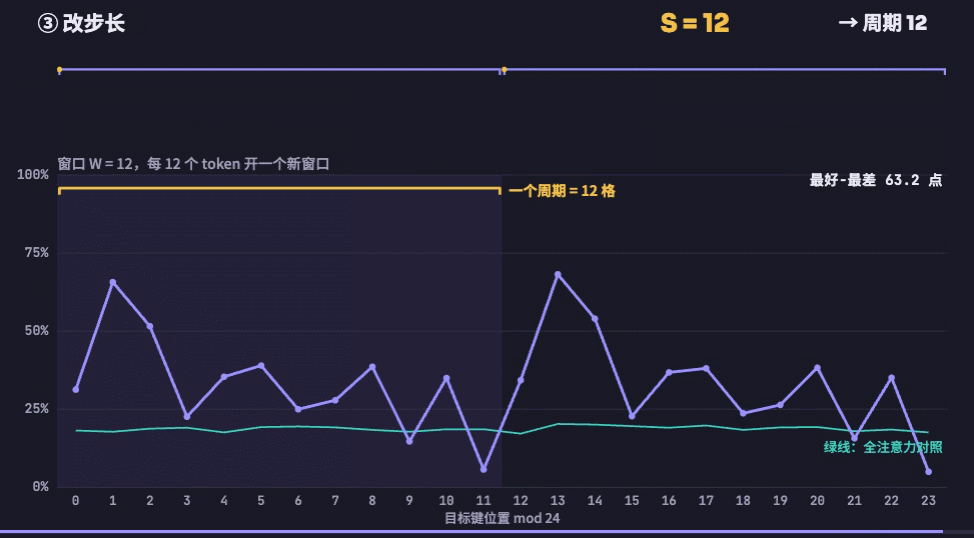
这是因为为了维持量大管饱的超高性价比,DeepSeek 给 V4 系列模型上了一套 CSA+HCA 的组合压缩方案。因为这俩是分块压缩的,逻辑相当简单粗暴。比如 CSA,就是每8个 Token 压成一个块儿,每隔4个 Token 压一次,块与块之间有重合部分。这不就对上了~
研究员们继续用不同的压缩策略,从头训练了一批模型。结果发现,不用这种分块策略的,基本稳成了一条线,但只要加入分块算法,周期性就会凸显出来。这基本就确定问题出在压缩策略上了。
其实大伙儿都是压缩组合,该怎么压这事儿,都是摸着石头过河,而 DeepSeek 一直是其中最激进的那批。所以MLA 是 DeepSeek V2 搞出来的,DSA 是 V3.2 推出的,QSA 也是按着 DSA 的思路改进的。
DeepSeek 一直选择风险大的打法,只不过这次翻了个大的。而这个坑之所以能这么扒出来,因为 DeepSeek 把模型权重和技术方案公开了。开源的意义也在此,能让人找到它背后的规律。牢梁给大伙儿趟出来的坑,倒也算没白趟。。。差评说AI