国内超一半算力在造爽剧跨界破圈热点共创头部热点创作计划
一、这句话从哪来的
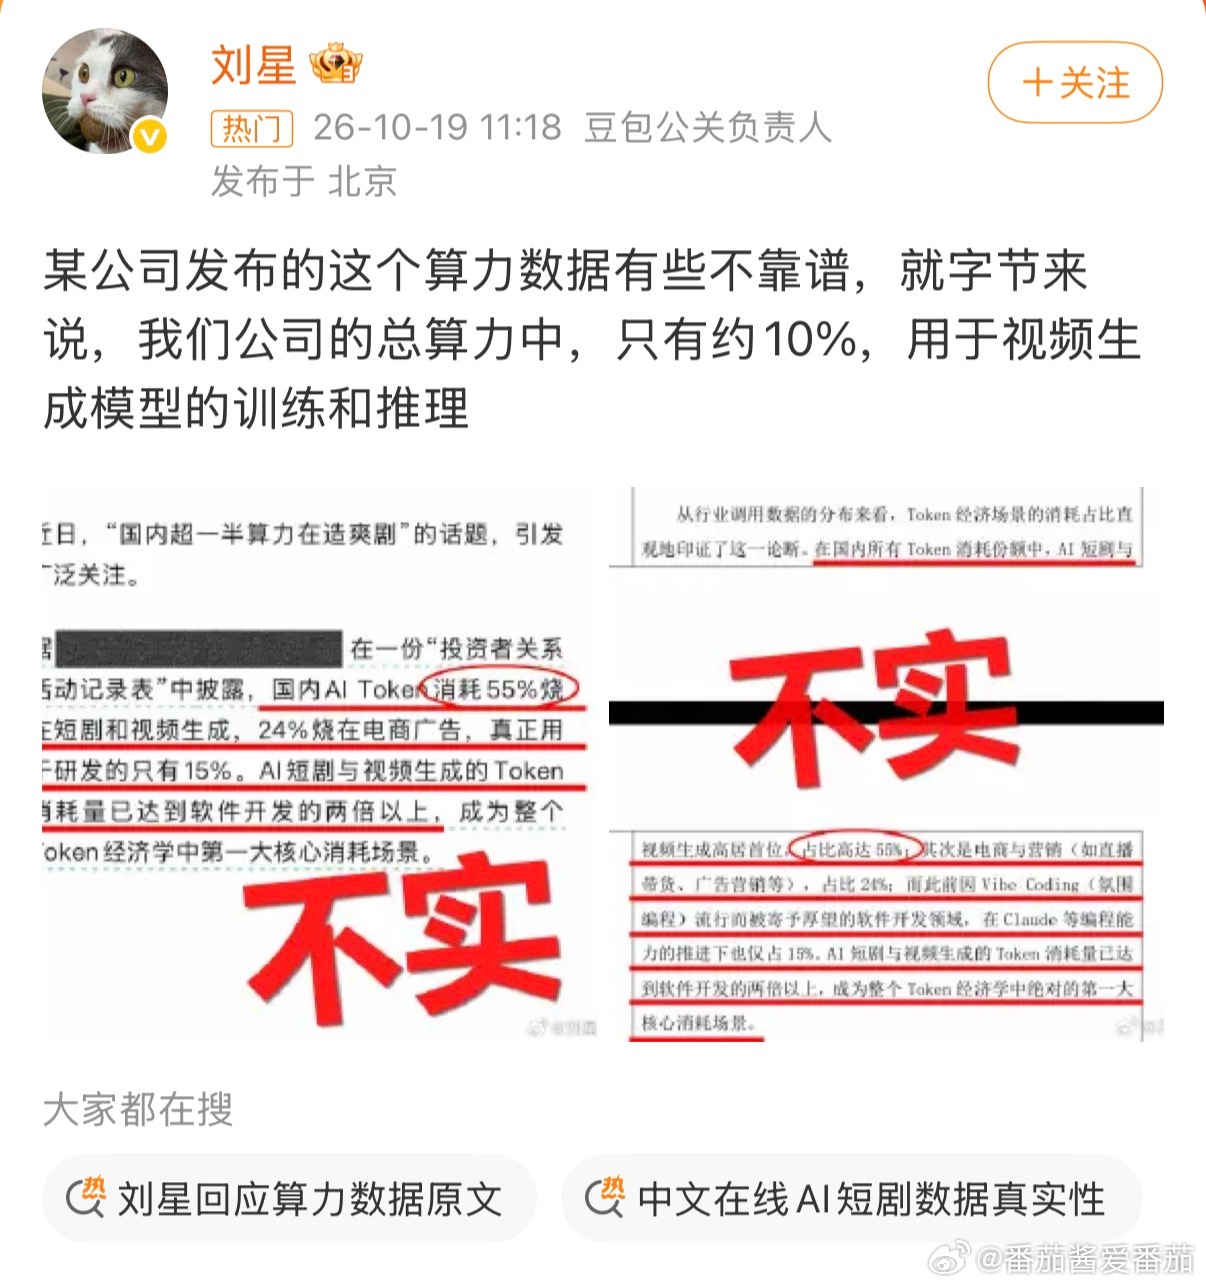
源头是中文在线一份投资者关系活动记录表,10月16日被文章《一半算力在造爽剧,98.7%都回不了本》带火。
原话口径是:
• AI短剧+视频生成:占国内AI Token消耗 55%
• 电商/广告营销:24%
• 软件开发/研发类:15%
传播过程里被改了三处:
• “短剧+视频生成” → 简化成“爽剧”
• “Token消耗占比” → 偷换成“算力占比”
• “软件开发” → 扩写成“研发”
热搜标题就是第三步出来的产物。
二、Token ≠ 算力,这是核心误区
这两个不是一回事:
• Token:模型处理文本/视频的计量单位,跑一次调用产生多少词元
• 算力:实际GPU卡时、FLOPS、集群占用
同样1万Token:
• 跑一段代码补全 → 很轻
• 跑一段1080p视频生成 → 重得多
• 跑大模型预训练 → 又是另一个量级
所以“短剧占55% Token”≠“短剧占55% GPU”。
豆包刘星回应的原话:
就字节来说,我们公司的总算力中,只有约10%,用于视频生成模型的训练和推理。
两边其实不在同一个擂台:
• 中文在线:全行业Token调用结构
• 字节:自家总算力资源配置
拿行业Token占比套单一公司头上,本身就不严谨。国内超一半算力在造爽剧