刚看到一个很有想象力的 AI 开源项目,居然有人在尝试给 Transformer 增加记忆模块,让 LLM 拥有原生的记忆能力。
研究了他们的论文和构想,虽然还有很多不成熟的地方,但我几乎可以确定,这是最近三个月以来,我见过的最令人兴奋的一篇 AI 论文了。
现在 Personal Agent 非常火。想必大家都已经看到了,记忆已经成为 AI 应用非常重要的一项能力。
但记忆这事,其实没那么容易做好。
无论是 ChatGPT、OpenClaw,还是其他 AI 产品,大家可以看看,它们实现记忆的方式五花八门,而且都有各自的局限。和我们人类的记忆方式相比,还有很大的差距。
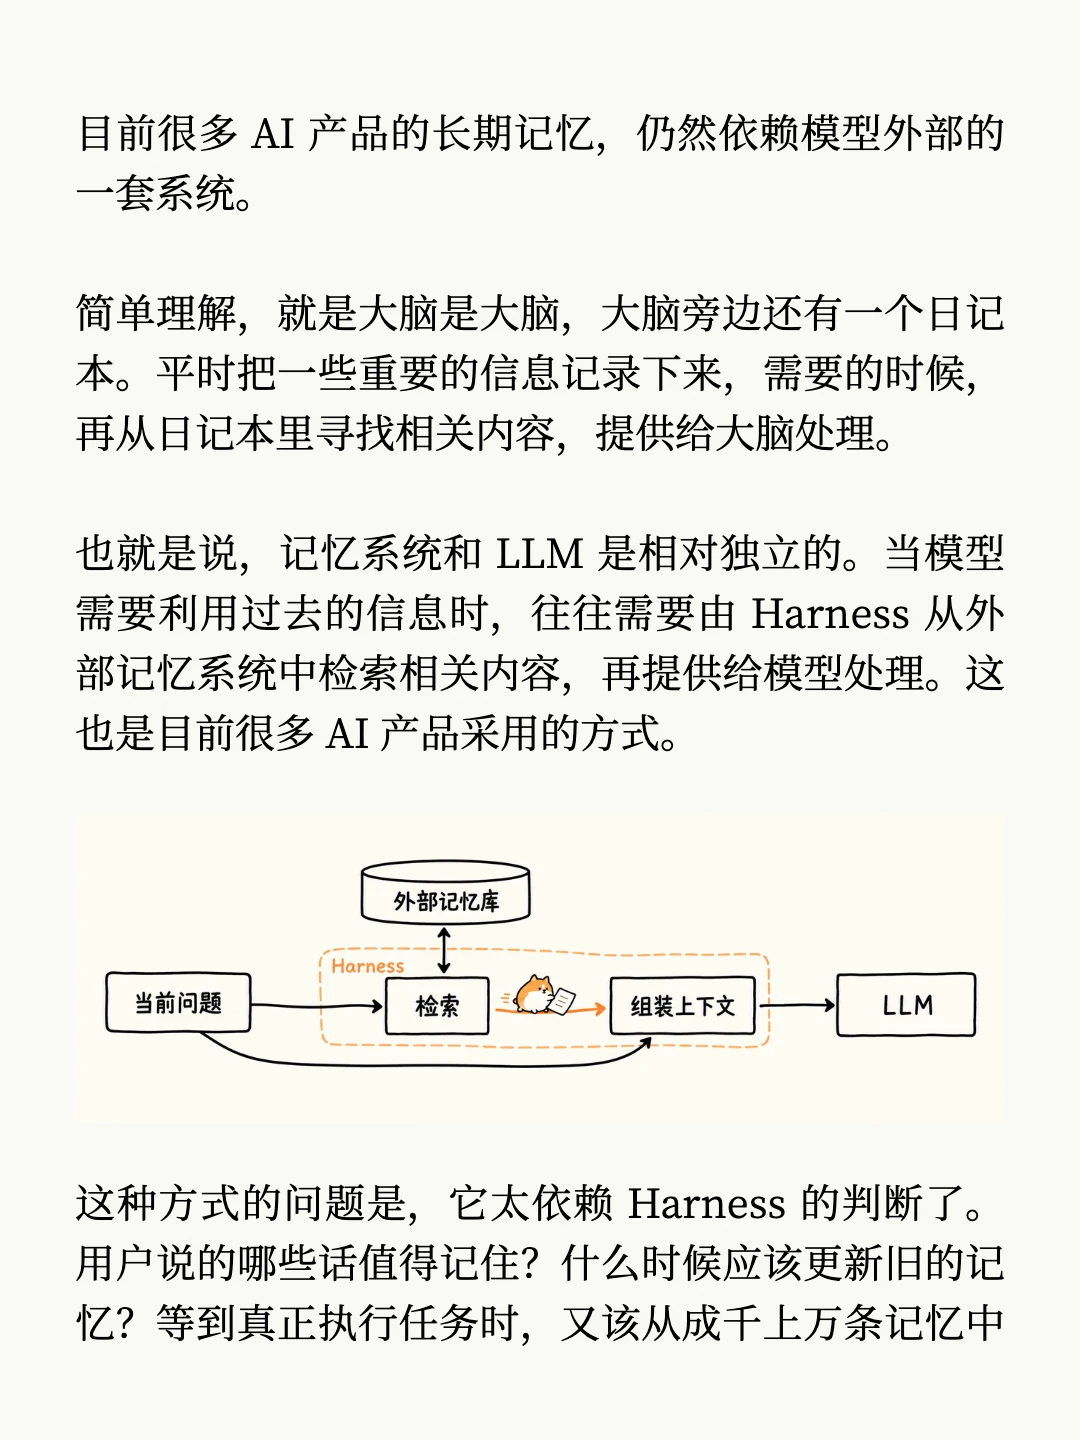
目前很多 AI 产品的长期记忆,仍然依赖模型外部的一套系统。
简单理解,就是大脑是大脑,大脑旁边还有一个日记本。平时把一些重要的信息记录下来,需要的时候,再从日记本里寻找相关内容,提供给大脑处理。
也就是说,记忆系统和 LLM 是相对独立的。当模型需要利用过去的信息时,往往需要由 Harness 从外部记忆系统中检索相关内容,再提供给模型处理。
这也是目前很多 AI 产品采用的方式。
这种方式的问题是,它太依赖 Harness 的判断了。
用户说的哪些话值得记住?什么时候应该更新旧的记忆?等到真正执行任务时,又该从成千上万条记忆中找出哪些信息?
这些事情,目前主要还是依靠模型和 Harness 中的一套机制来判断。
但这玩意到现在也没有特别可靠的办法,任何一个环节出了问题,都可能导致 AI 明明和你聊过很多次,却还是记不住你的需求。
而且,有些信息在当时看起来并不重要,过几个月才发现很有价值。比如你曾经跟 AI 抱怨过几次红眼航班太累,但从来没有明确说过,以后不要帮我订红眼航班。
如果当时没有把这个偏好提炼出来,等下次帮你订票的时候,AI 就可能完全想不起来。
更重要的是,这套机制很难让模型真正积累经验。过去发生过什么,可以通过检索找回来。
但过去的经历应该怎样影响接下来的判断和行动,还需要模型每次重新理解。
这也是 MemT 1.0 想解决的问题。
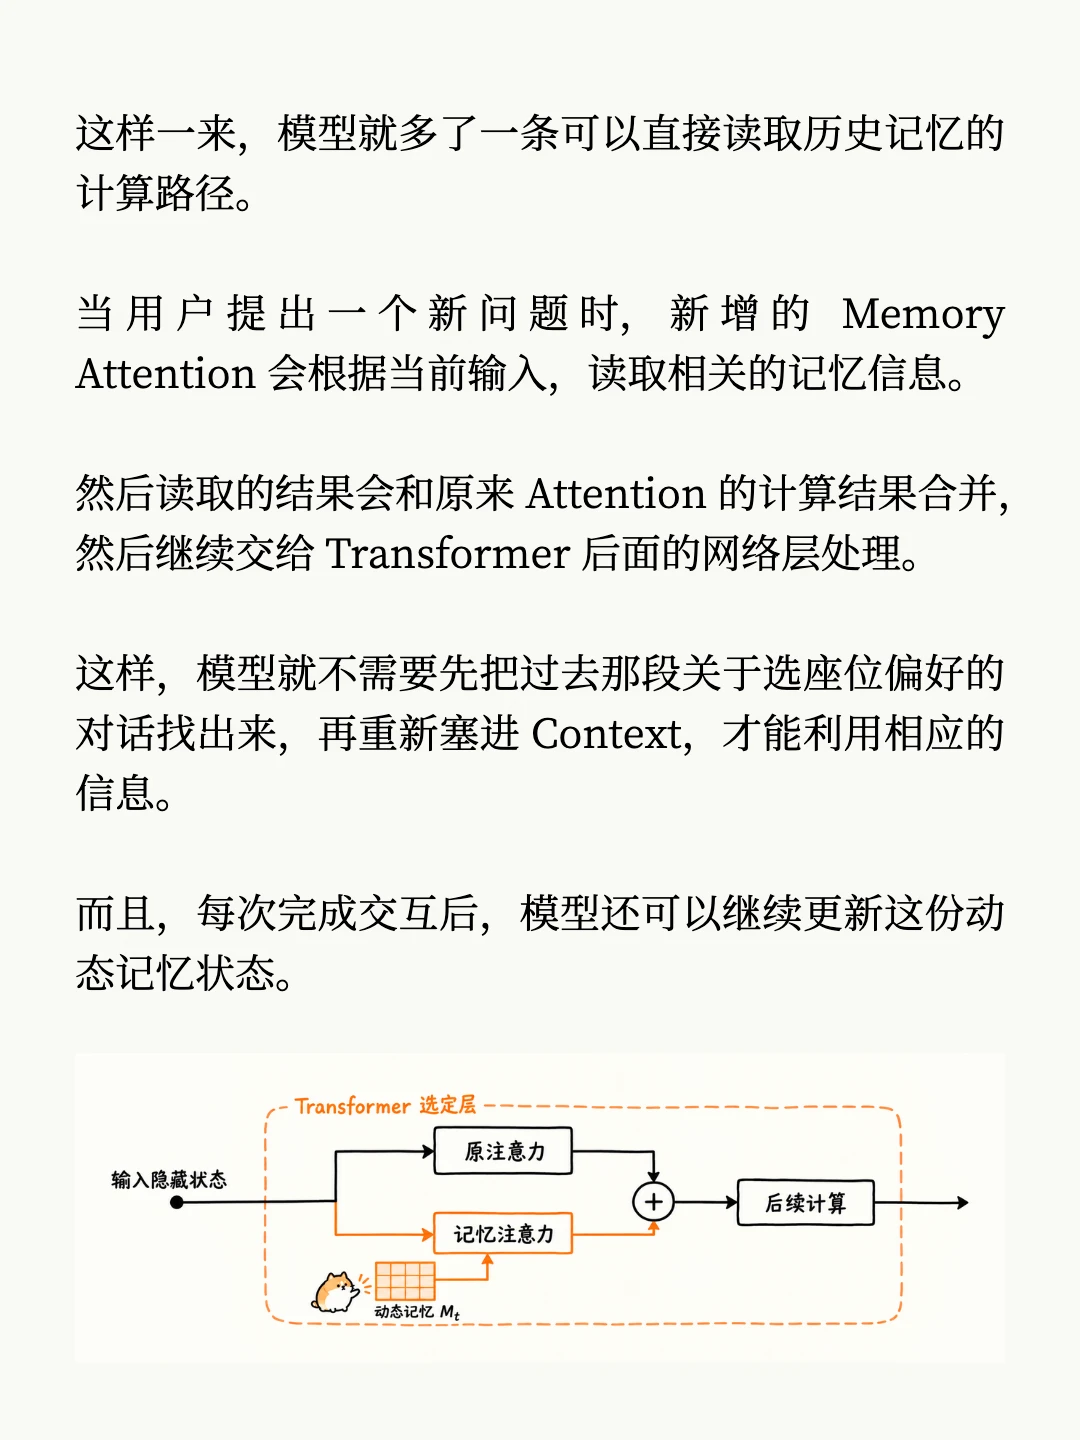
他们尝试直接把记忆能力融入大模型的内部架构。让模型在每次交互之后,都能够更新自己的记忆状态。
#ai #LLM #PersonalAgent #RSI #Harness #记忆张量 #MemT #记忆原生