这是这段时间,我听到的关于人形机器人和具身智能最深刻的判断了。
过去一提到怎么提升具身智能模型的能力,大家惯常的说法,就是拿 LLM 来对比。说具身智能这个行业,还是缺少高质量的数据。
只要积累足够多的高质量数据,Scaling Law 就能继续发挥作用,机器人的操作能力自然会提升。
说实话,我之前也是这么想的。
但听了蚂蚁灵波首席数据科学家黄用韬的演讲之后,我发现,这个逻辑其实存在一些问题。
当然,高质量数据肯定很重要。但问题是,具身智能的数据质量,远远没有我们想象得那么简单。
因为直到现在,整个行业还没有形成一套公认的方法,能够清楚地判断,究竟什么样的数据才算好数据。
举个例子。
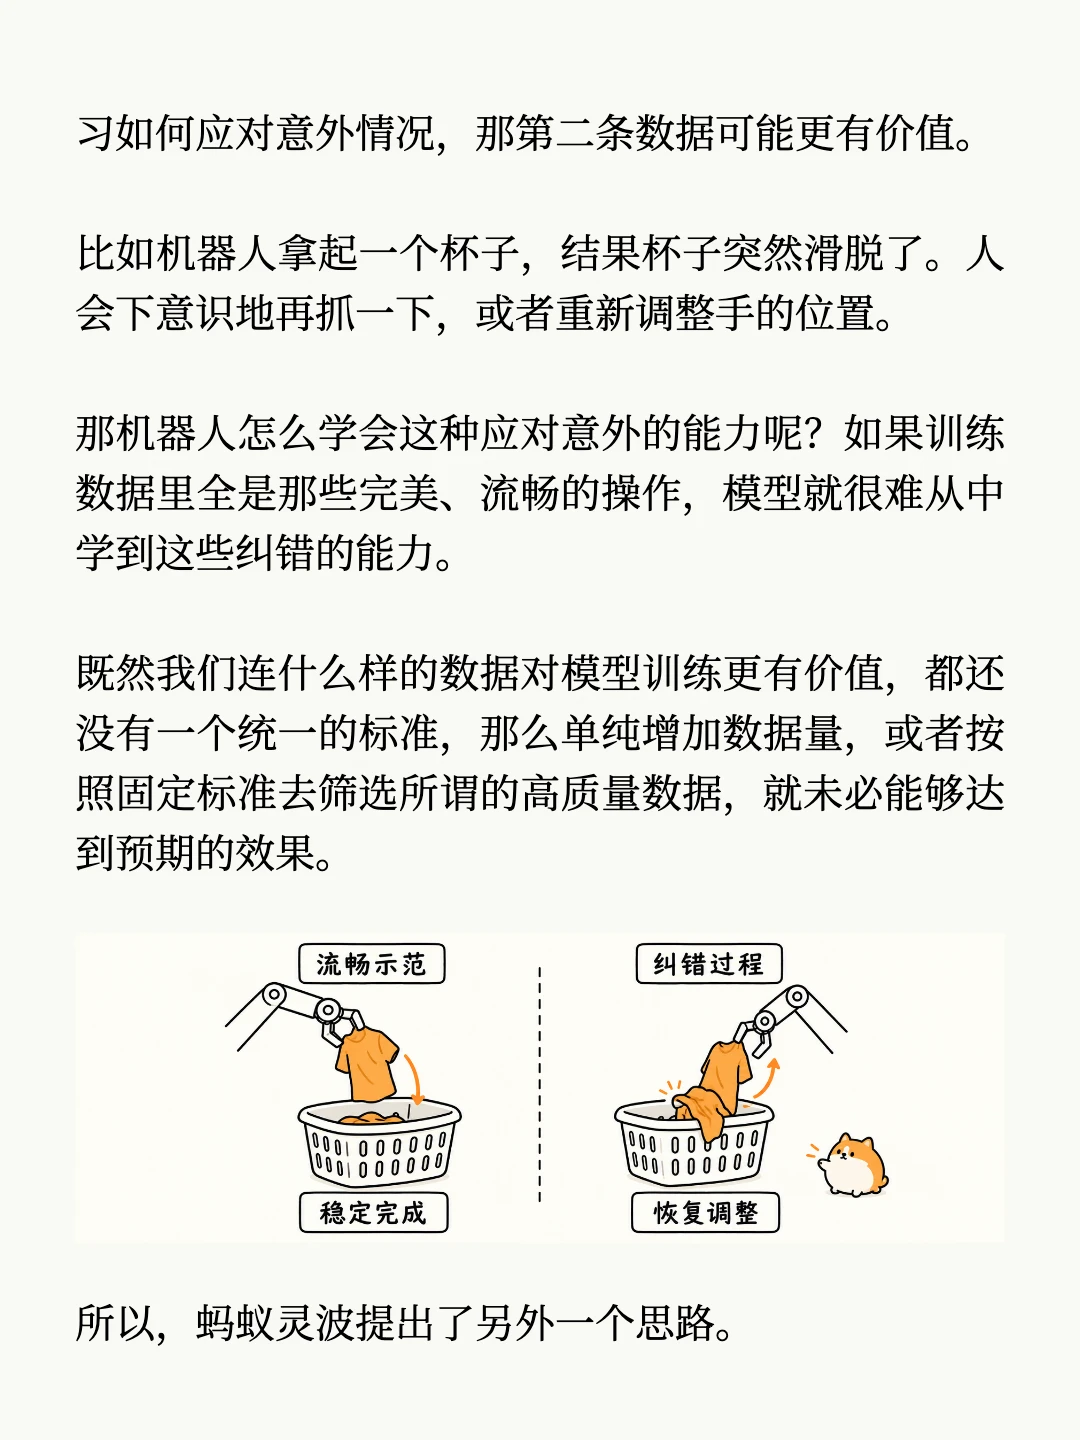
假设机器人把一件衣服放进洗衣篮,整个过程非常流畅,动作稳定,几乎没有多余的调整。
另外一次,机器人没能顺利把衣服放进去,衣服挂在了篮子边缘,它折腾了半天,重新调整动作,才终于放进去。
按照我们惯常的理解,第一条肯定是好数据,第二条是差数据。
毕竟,机器人的动作越流畅,成功率越高,也就说明它的操作水平越好。
但其实未必。
如果我们希望模型学习如何快速、稳定地完成动作,那第一条数据确实更有价值。
但如果我们希望模型学习如何应对意外情况,那第二条数据可能更有价值。
比如机器人拿起一个杯子,结果杯子突然滑脱了。人会下意识地再抓一下,或者重新调整手的位置。
那机器人怎么学会这种应对意外的能力呢?如果训练数据里全是那些完美、流畅的操作,模型就很难从中学到这些纠错的能力。
既然我们连什么样的数据对模型训练更有价值,都还没有一个统一的标准,那么单纯增加数据量,或者按照固定标准去筛选所谓的高质量数据,就未必能够达到预期的效果。
所以,蚂蚁灵波提出了另外一个思路。
如果想让具身智能的 Scaling Law 持续发挥作用,除了积累高质量数据,还有一个基础问题必须重视:我们究竟应该怎么管理和使用这些数据?
目前很多机器人数据集的管理方式,仍然是围绕 Episode 展开的。
Episode 可以简单理解为一次任务的执行过程。比如机器人接到指令,把一件衣服放进篮子里。
从开始执行到任务结束,整个过程就可以记录成一个 Episode。里面可能包含摄像头拍摄的视频、机械臂的关节数据、机器人动作以及时间戳等信息。