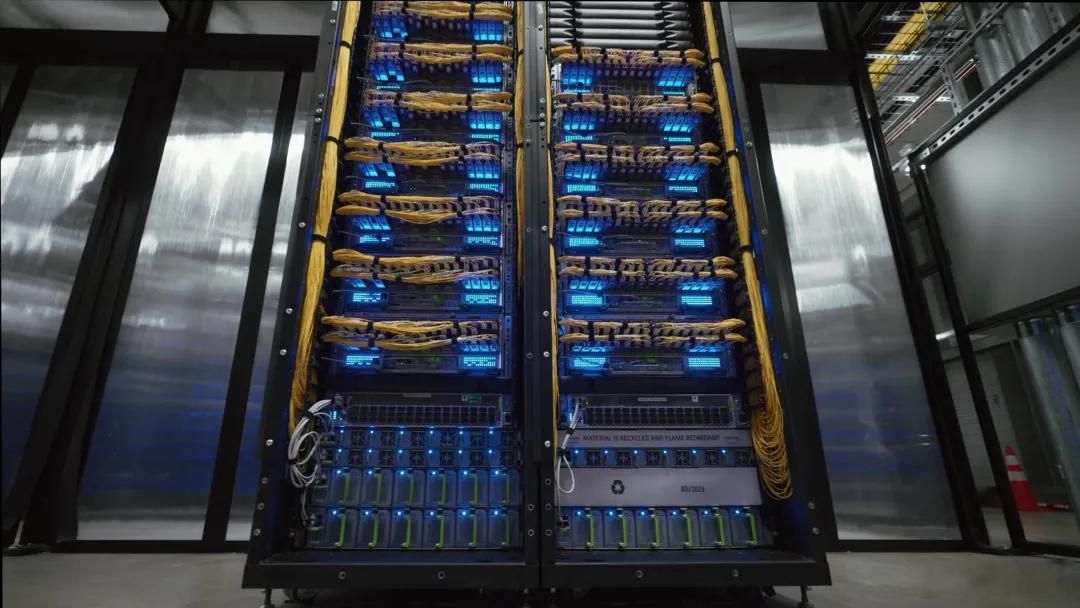
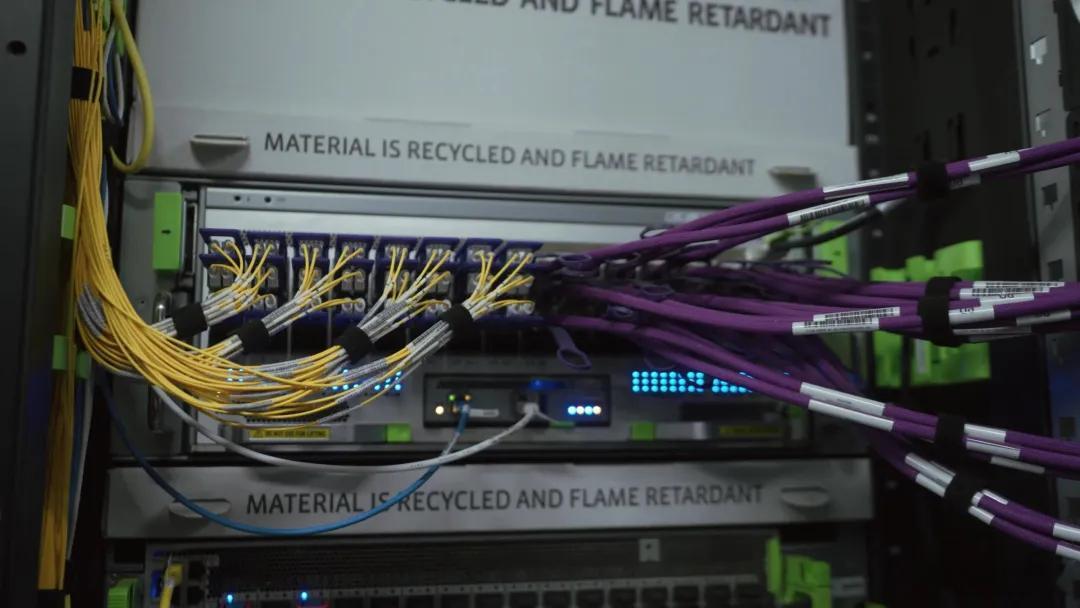
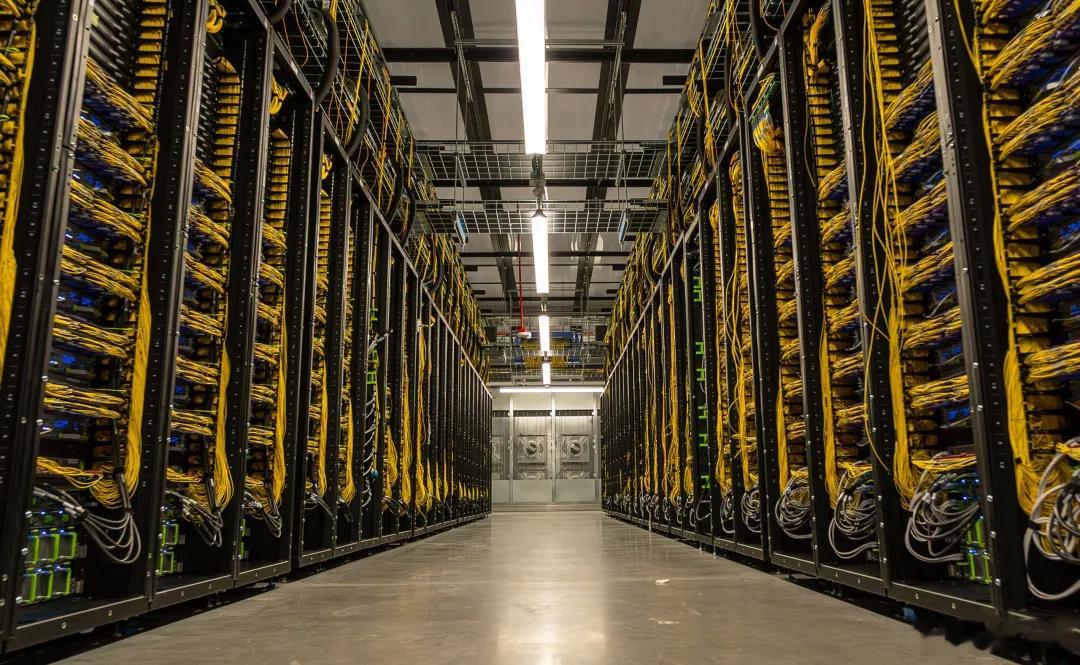
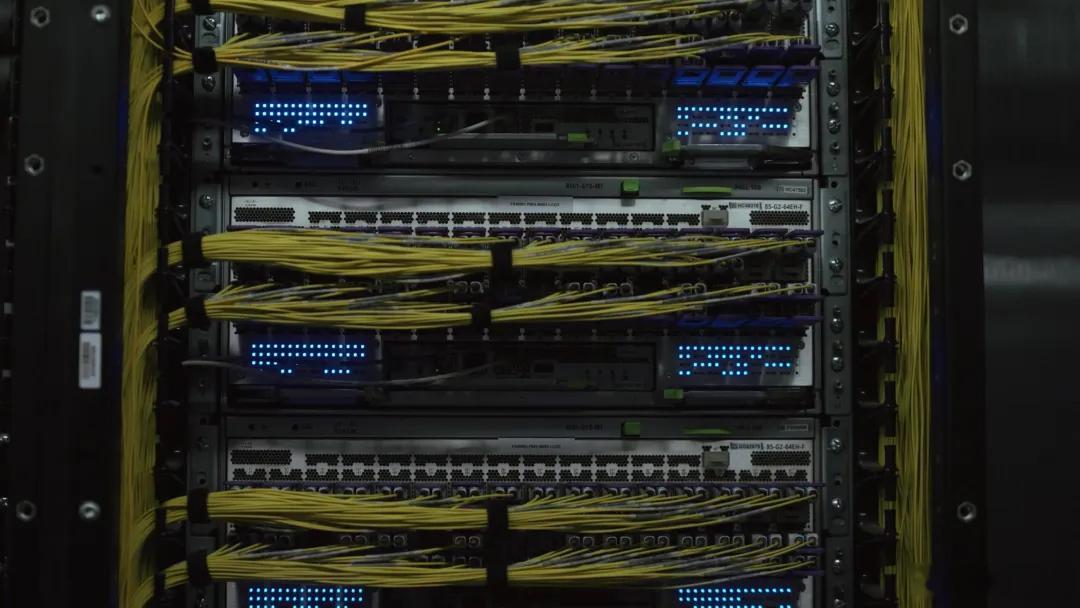
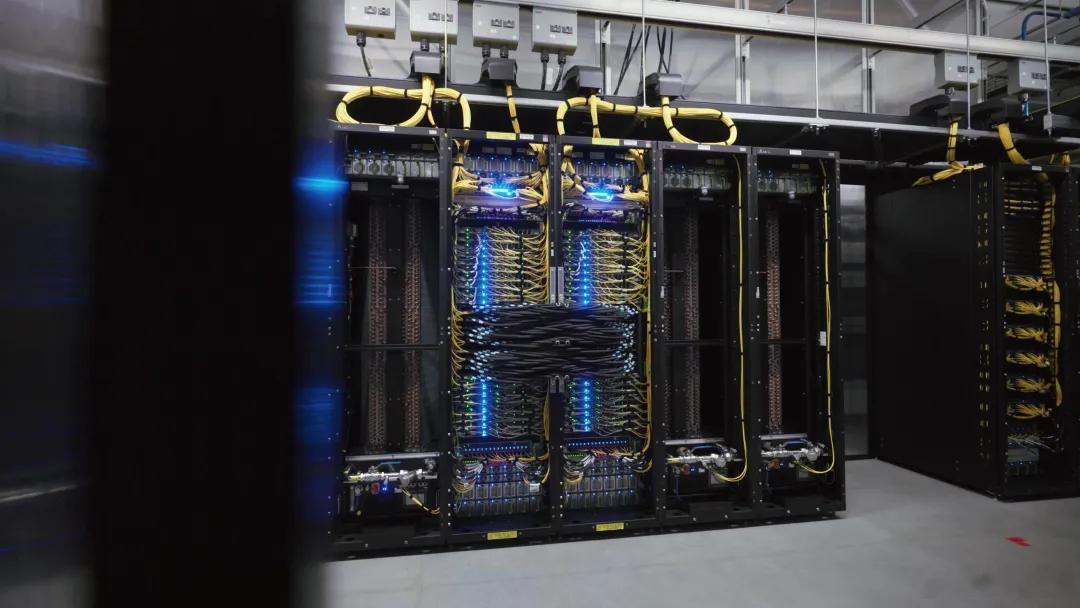
美国Meta公司Prometheus(普罗米修斯)数据中心,该站点正朝着约100万块GPU的规模扩展。100万块GPU同时工作,这个复杂程度可想而知。硬件堆砌只是最基础的部分——真正的技术难关,在于如何让这100万块“娇气”的芯片24小时不间断地协同工作。
传统服务器像是一个个独立的小房间,每间房住8块GPU,彼此用网线连接。但现代AI模型太大,8块GPU根本不够用,数据传输的“网线”反而成了瓶颈。最新的解决方案叫做NVL72架构,相当于把72块GPU装进一个“超级大脑”。这些GPU不再通过外部网线,而是通过一种叫做NVLink的“高速神经束”直接相连,带宽达到130TB/s——相当于每秒能传完3万部高清电影。在这个架构里,72块GPU就像一块巨大的芯片一样协同工作。
目前Meta这个集群里正跑着两代“超级大脑”:
第一代叫Catalina,使用GB200芯片,每块GPU配备192GB高速显存(HBM3e),两个机架组成一组,功耗高达120千瓦(相当于120台家用空调同时制热)。每块GPU还搭配了一颗Grace CPU和两块ConnectX-7 400G网卡,确保数据进出顺畅。
第二代叫Clemente,升级到GB300芯片,显存增至288GB,性能提升10%,而且72块GPU能塞进一个机架。它采用了更新的ConnectX-8 SuperNIC网卡,原生支持800G高速网络。
明年还将接入第三代San Miguel,使用更新的Vera Rubin芯片,单架功耗将突破170千瓦,显存带宽和计算能力将再翻一倍。
但把这么多芯片绑在一起也有副作用:一旦其中一块坏了,影响的不是8块,而是整个72块的“超级大脑”。这就像把鸡蛋放在同一个篮子里,篮子越大,摔一次的损失越惨重。
在每个72块的“超级大脑”里,实际上只有64块GPU承担计算任务,剩下8块作为“替补队员”随时待命。一旦某块GPU出现故障,替补立即顶上,训练任务从最近的“存档点”继续,而不需要停机维修。
这种设计叫做“64/72切片策略”,虽然看起来浪费了11%的算力,但实际上大幅减少了停机时间。从Prometheus的实践可以看出,未来的AI竞争不只是芯片数量的比拼,更是系统工程能力的较量。当GPU数量达到百万级,真正的技术壁垒在于:如何设计一个能自我诊断、自我修复、且不会把电网拖垮的庞大系统。
这100万块GPU背后,藏着的是一整套精密的工程哲学——不是如何让机器跑得更快,而是如何让它永不停歇。