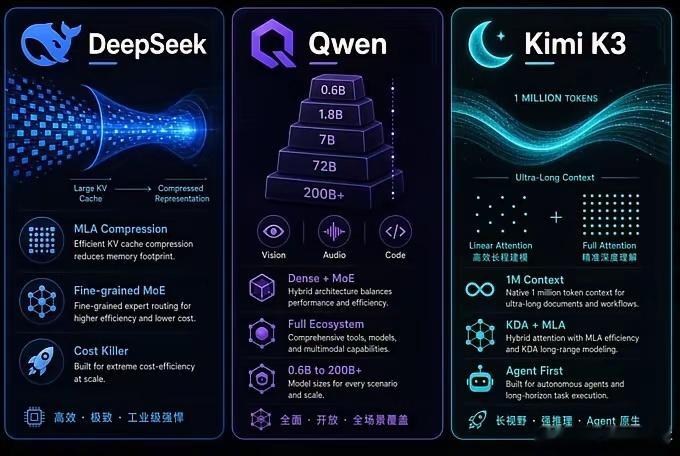
三大国模,架构路线已经彻底分叉了DeepSeek: 走的是 "极致压缩" 路线MLA 把 KV Cache 压到极限,再叠细粒度 MoE,训练成本直接碾压同行,主打一个 "又强又便宜"。说白了就是省钱省内存,把每一分算力都抠到骨子里,开源圈白嫖党的最爱。Qwen:全家桶策略Dense+MoE 双线并行,GQA 混合注意力,尺寸从 0.6B 一路铺到数百 B,多模态生态也最完整。别的家是押一条路,它直接把自己做成超市,想要啥尺寸都有货。Kimi:长上下文狂魔2.8T 总参数只激活 104B,KDA 线性注意力 + Gated MLA 混着来,原生 1M 上下文,明摆着就是给 Agent 和超长任务设计的。同样是 MoE,三种完全不同的取舍 —— 省钱、铺量、拉长。这不是内卷,是各走各的路,你更看好哪家的打法?