会说话、有表情、能打手势,智元让机器人聊天更自然了
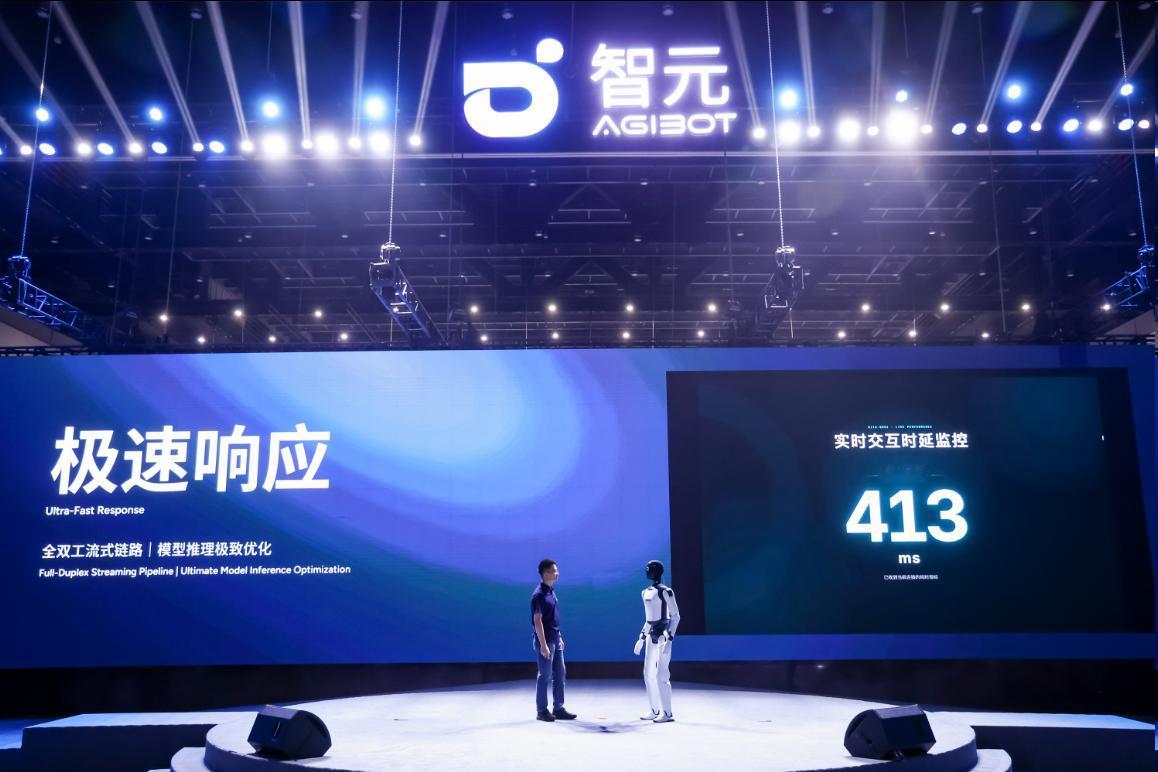
和机器人聊天是什么体验?如果它不仅能听懂你说的话,还能快速接话,配合表情和动作回应,是不是就更像和真人交流了?
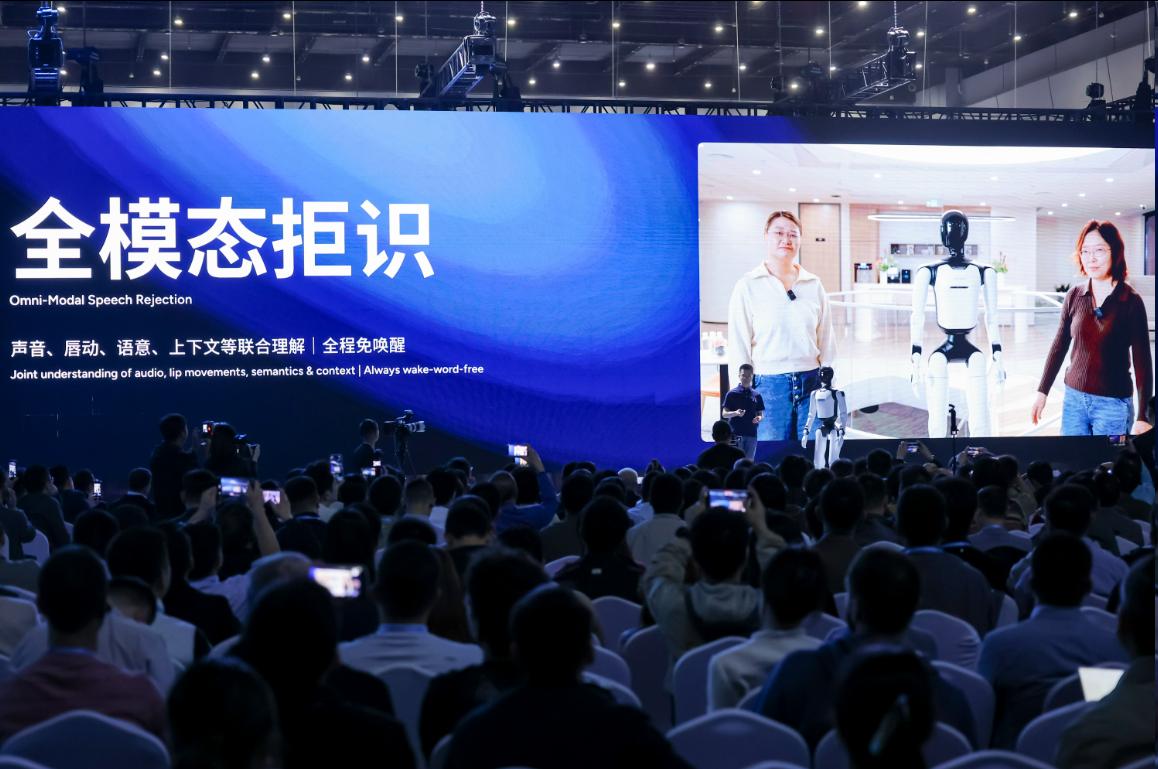
10月29日,2026智元创新日上,智元合伙人、联席总裁熊彦发布了全新交互大模型WITA-OMNI,官方称其为行业首个具身全模态端到端交互大模型。
这次最大的变化,就是机器人不再只是简单地听指令、回答问题,而是能把“听、看、想、说、做”更好地结合起来。
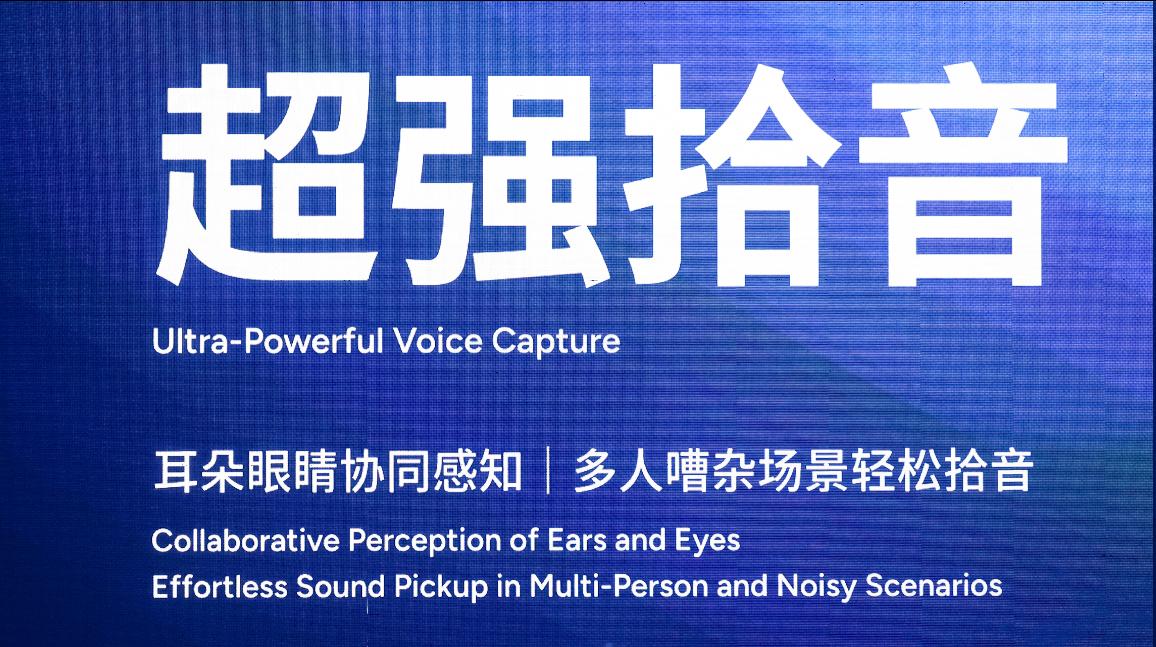
WITA-OMNI将语音、视觉、文字等信息的理解,与说话、表情、动作的生成整合进同一个模型,让机器人能够“边听、边想、边说”,还能配合动作进行回应。
而且,它采用快慢双模设计,简单问题快速回答,复杂问题深入思考。支持超过100种语言和29种方言,搭配智能面屏,还能把一些交互信息直观地展示出来。
技术实力也有支撑。截至发布当天,WITA-OMNI在全模态理解、视频时序定位、空间理解推理和音频理解推理四项专业评测榜单中均拿下第一名。
更值得关注的是,这套模型已经面向首批友好客户启动部署。按照智元的计划,今年12月完成国内全面部署,2027年1月海外版本在欧洲首发,3月面向海外区域全面上线。
对机器人来说,会说话只是第一步。真正走进商场、乐园等实际场景,还要能听懂不同的人、理解周围环境,并自然地作出回应。
从简单的一问一答,到能听、能看、能说、能配合动作,机器人与人的交流正在变得越来越自然。
智元 智元创新日