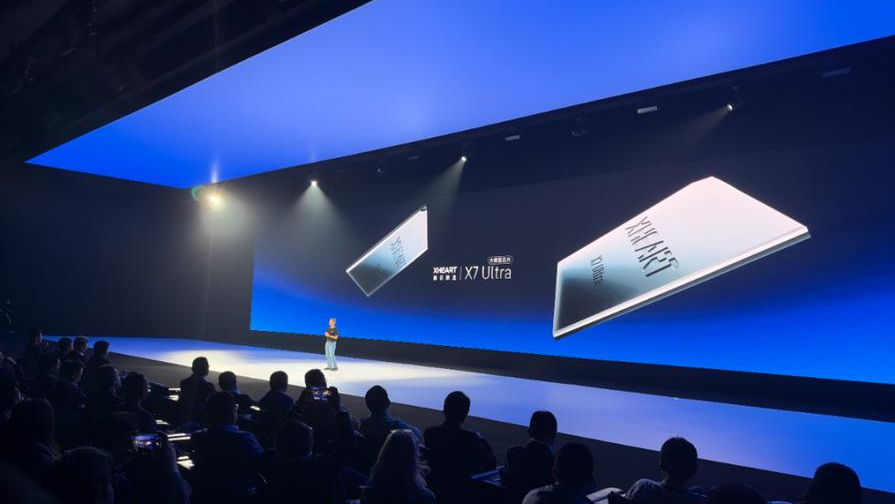
700 TOPS的算力报出来,台下还算平静。等98.7%的NPU利用率、80%的内存带宽降幅、翻倍的能效一放,行业里不少人坐不住了。
10月29日,新芯航途在苏州发布X7 Ultra。账面数字唬人,实测数字才要命。
这枚芯片真正的分量,不在算力标得有多高,而在它换了套造芯片的思路。
过去做智驾,基本是先弄颗芯片出来,再让算法模型去迁就硬件那点家底。
这次新芯航途反着来,提出“大模型定义芯片”,先看跑在车上的大模型到底缺什么,再照着需求倒推架构。
说白了,是把“芯片迁就模型”变成了“模型倒逼芯片”。
现在的端到端智驾大模型,极度吃吞吐、吃精细调度。
这类大模型最怕的不是算力不够,而是数据在芯片里进出不畅,卡在“内存墙”上干着急,算力标得再高也白搭。
专为大模型设计的超大核NPU加硬件并行度,打的就是这个七寸。
更硬核的是,它做到了按需供电、把每一分家底榨干。
除了供电,芯片本身也是硬货。X7 Ultra是国内首发量产的Armv9车规级CPU,配上AI工具链重构和深度异构计算,把车端能部署的模型参数量拉高了10倍。
过去只配待在云端机房里的百亿参数大模型,如今被塞进车规芯片,还能以接近满载的效率转起来。
不光是大模型,传感器这块也跟上了。连激光雷达处理带宽都干到每秒2000万点,传感器预处理稳定性提升了一倍。
这一步对普通车主的意义,比账面数字大得多。
大模型真正上了车,智驾不再是一堆写死的规则,而是能看、能想、能自己拿主意。
复杂路口、雨天、加塞这些老场景,车自己会盘算怎么开。
更要紧的是,芯片把每一分算力都榨干,车厂就不用再为用不上的性能买单,省下的散热、电源、成本,最终会反映到车价上。
智驾才有机会从高端车型的卖点,慢慢变成普通人开车都能用得起的配置。
可说回芯片本身,这几年行业里迷信“算力数字”的风气,大伙儿多少都见识过。
某些国外老牌厂商当年靠堆TOPS讲故事,几百上千的峰值算力挂在PPT上,真上车一测,实际利用率惨不忍睹,银子都烧在散热和电费上。
国产芯片这些年一路追赶,多少也沾过比数字的劲儿。
可到了端到端大模型的关口,这套路玩不转了,真跑起来,比的是芯片能榨出多少效率。
这场发布会还剧透了几个实打实的进展,这套芯片量产8个月,出货超过20万颗,不是PPT产品。
连Momenta这样的一线智驾伙伴也下场站台,把“大模型定义芯片”当成行业核心洞察来推。
下一代X9的目标也摆上台面:3000 TOPS大算力、700GB/s的内存带宽,奔着2027年去。
这个信号比X7本身更值得琢磨,国产智驾芯片已经从“能不能造出来”,跨进了“能不能按真实效率跑起来”的新赛段。
芯片开始拿实际利用率说话,那些还靠堆参数讲故事、靠名义算力撑门面的玩家,日子怕是不太好过。
再往大了说,这条路走通,也不光是一两家企业的兴衰,更牵着一根自主可控的弦。
智能汽车的核心芯片要是老靠进口,等于把命门交到别人手里。
从Armv9车规CPU到整套工具链都攥在自己手里,往后哪怕真有风吹草动,国产车这条路也能照走不误。
说到底,车轮跑在路上,认的是“有效算力”,不是PPT里的“名义算力”。
中国智驾这条赛道,从追着别人的数字跑,到开始定自己的规矩,这一脚,踩得踏实。