一家靠AI爽剧吃饭的上市公司,在投资者记录里甩了句话:中国一半以上算力,都喂给了AI短剧和视频生成。
美国那边呢,老老实实拿一半算力写代码搞研发。
这话传得挺玄乎,听得人心里发毛,可它打根上就不靠谱。源头不是统计局,也不是信通院,就是一家自己重仓AI短剧的公司。
最关键的是,当事人自己出来辟谣了。
10月19号,豆包公关负责人刘星公开回应,说字节的总算力里,只有约10%用于视频生成模型的训练和推理,跟那个55%差了五倍还多。
这已经不是观点之争,是数字对不对得上的问题。
数字对不上,是因为口径被偷换了。
这里还有一个容易被忽略的大坑:算力分两种,训练算力和推理算力。
训练是砸大钱一次性把大模型练出来,消耗极高;推理是普通人输一句话、生成一段短剧这种实时调用,单次要低得多。
一些带节奏的文章,偷偷拿短剧推理算力的局部峰值,去跟全国包含训练、科研、工业的总算力做对比,两个压根不是一套统计盘子。
这么偷换口径,出来的数字自然吓人。那流传的美国算力数据,也得查查是不是同一套口径魔术。
翻了一通公开报告,也没找到“美国58%算力写代码”的权威出处。一个55%、一个58%,俩都是找不着家的数字,愣是被包装成中美算力的“体检报告”。
这不叫分析,这叫编故事。那真实的国产算力,到底在忙活些啥?事不少。
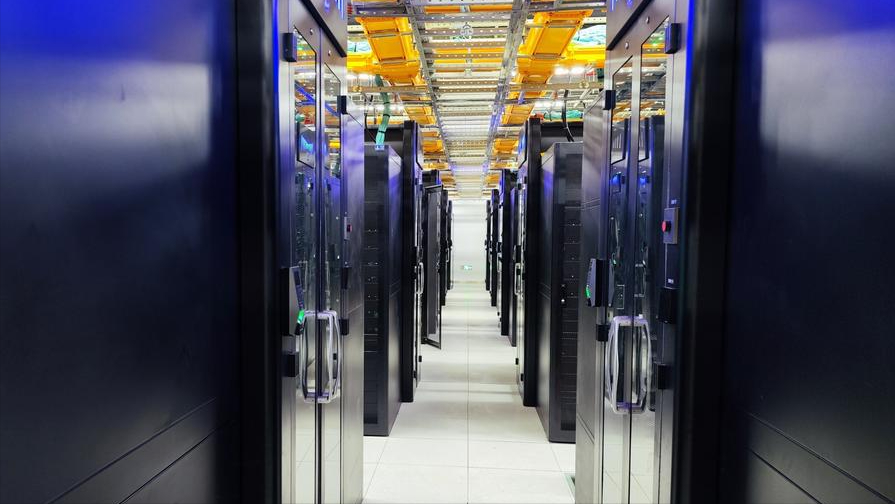
看大盘,国家数据局的数字是实打实的:到今年6月底,全国智算总规模冲到240万PFLOPS,半年涨了50.9%;到7月底,又爬到245万。
工信部那边口径更猛,说6月底智能算力规模同比涨了177%。这几个数字摆在那,短剧那点水面上的浪花,根本盖不住底下的盘子。
很多人还有一个误区,把公有云对外出租的算力,直接等同于全国所有算力。
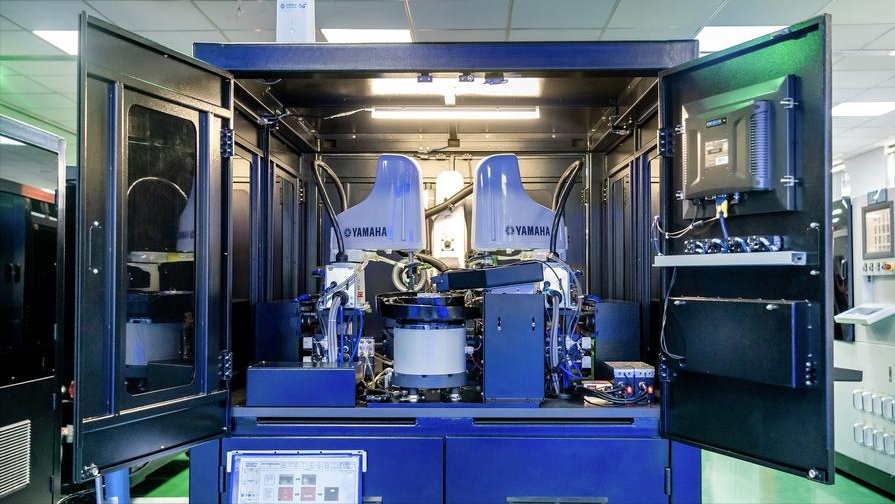
国内大量算力是企业自建的私有智算集群,车企、半导体工厂、生物医药实验室,自己掏钱搭算力,根本不对外接单,自然不会出现在短剧服务商的调用统计里。
这些藏在公有云之外的算力,才是工业科研场景的主力军。
这些自建算力,实实在在落地在哪些看得见的项目上?
制造业规上企业AI应用普及率已经超过30%,领航工厂70%以上的业务场景被AI吃进去;AI跑进“人造太阳”的研发全链条,空间站用上了大模型,新药临床前周期被硬生生压缩。
这是整个工业加科研体系,正拿算力当底盘往前推。
再看海外的现实情况,海外TikTok、一众AI视频工具、AI图像生成平台,同样在持续消耗北美云厂商的推理算力,只是很少有人单独拎出来统计、做成爆款文案到处传。
那些喊着美国算力全都用来写代码的人,刻意把海外内容生成的算力消耗隐去不提。
只挑对自己观点有利的一部分来讲,这样的对比没什么公平可言。
不公平的背后,是想让你接受一套标准。这套话术真正想灌输的,是一套评判标准:算力花在“大众看得见”的地方,就是堕落;花在“少数人看得懂”的地方,才算正经。
可美国走的是投融资驱动、企业软件先跑通的路,中国走的是场景驱动、制造加消费双线反哺的路,两条路是两种打法,不是两个道德等级。
很多人还低估了短剧这类高并发推理场景带来的技术红利,AI短剧需要低成本、低延迟、大并发的生成能力,厂商为了压成本,会逼着模型做轻量化、蒸馏、推理加速。
这套打磨出来的优化方案,之后可以平移到质检、巡检、数字孪生这些工业场景里面。
消费端的海量场景,不只是花钱消耗算力,它本身就是一个持续迭代模型的试验场。
就算AI短剧真占了不少token,也不觉得是坏事。它把模型扔进了真实市场里,赚来的钱反哺研发,等于用消费场景养硬科技,这是白花花的真金白银买出来的生产力。
OpenRouter上,国产模型的头部流量占比已经过半,编程这类场景的消耗更是一路往上蹿,这本身就是个明证。
所以别被带偏了,往后再碰到有人拿AI爽剧渲染算力焦虑,不妨静下心问他三句话:这份数据出自哪里,统计口径是怎么划定的,有没有纳入算力整体大盘。
问完这三句,大半的焦虑自己就散了。
算力花在短剧上,不是堕落,是拿消费场景养模型。
模型赚了钱,回头再喂研发、喂工业,这个循环转起来,比纠结“算力花在哪类应用上”有用得多。
真要担心算力,该担心的是这个循环断没断,不是短剧拍了几部。