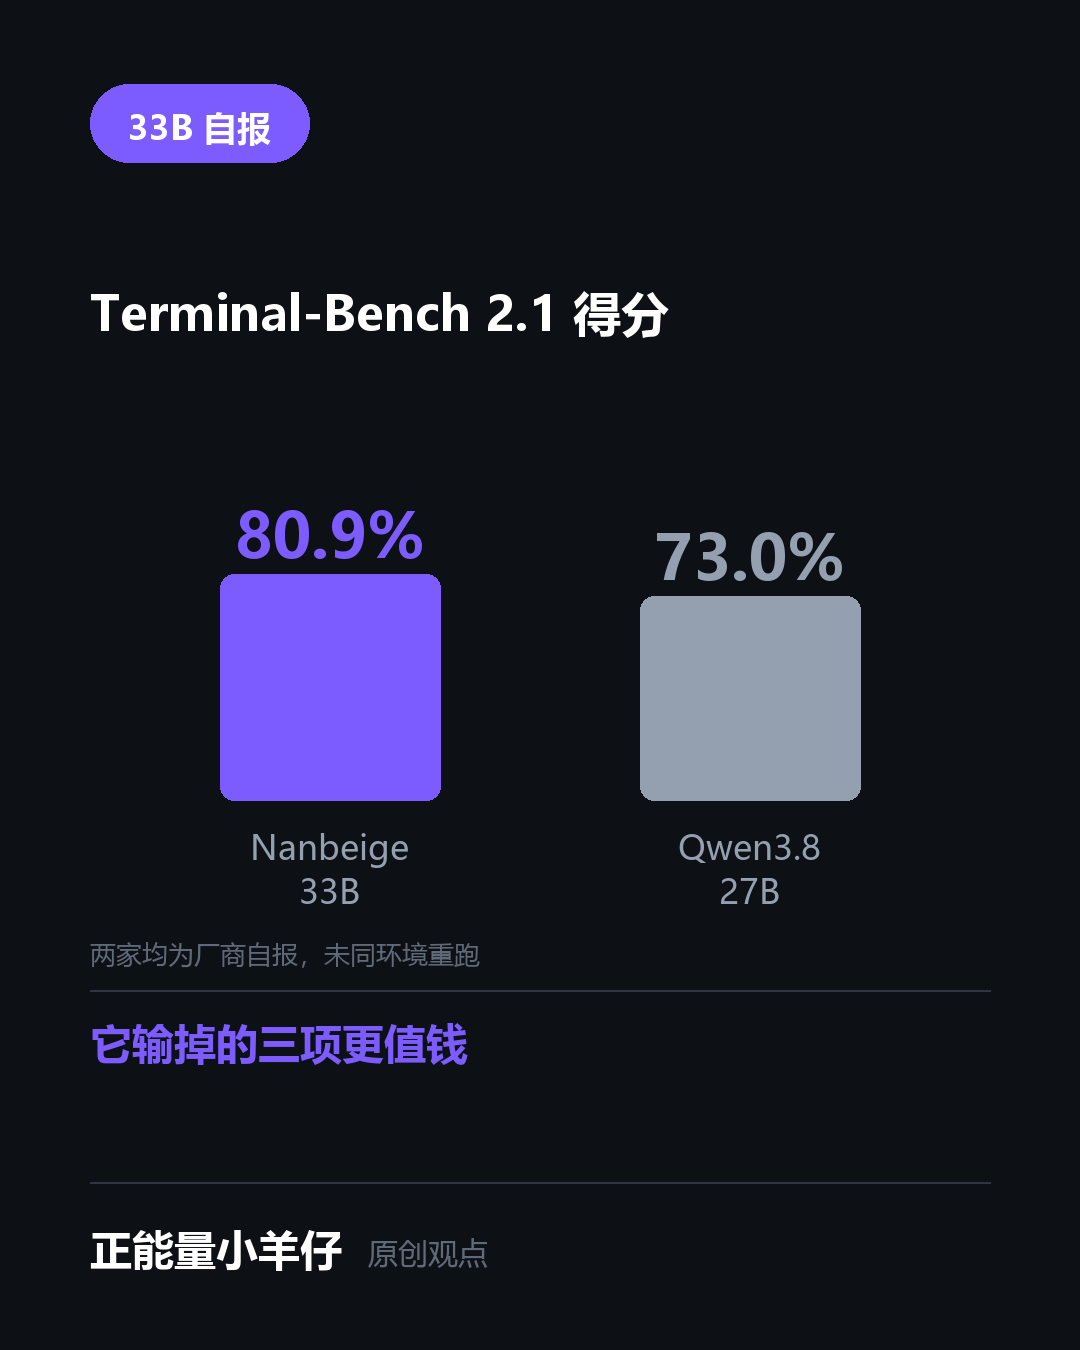
一份模型成绩单里,最诚实的部分是它自己输掉的那三项。11 月 1 日前后,南贝壳团队放出 Nanbeige4.3-33B:33.1B 参数、Apache-2.0 许可、上下文最长 524288 个 token。它给自己的定位是「教师模型」,把 Agent 能力蒸馏进更小的模型。自报表里 Terminal-Bench 2.1 拿 80.9 分,Qwen3.8-27B 是 73.0;同一张表上也写着:SWE-Bench Pro 60.3 输给 Qwen 的 61.7,GDPval 84.8 输给 86.4,GPQA 89.5 输给 Gemma4-31B 的 91.3。
33B 这个尺寸的意义在跑得动。它塞得进单机或少卡环境,适合当老师把小模型教出来,成本比调用前沿模型低一个量级。
但那张表不能当证据用。表里 Qwen 的三个数字和 Qwen 自家模型卡完全一致,属于直接引用的公布值,两家都没交代同环境重跑;评测框架、温度、提示词也都没写。Qwen 的模型卡自己提醒过,跨卡片比较要谨慎。榜单这件事已经变了性质:第三方独立评测跟不上发布节奏,多数排名实际是厂商自报数的拼接,读者看到的「第几」,取决于谁把对手的数字抄得准。
所以我更愿意看它输掉的地方。SWE-Bench Pro 和 GDPval 落后,说明在真实仓库级修复和通用工作产出上,27B 的对手仍然更稳;GPQA 落后,说明硬科学推理没占到便宜。一家公司肯把这些数字印在自己表里,比多标两个第一更可信。
还有个参数表不会写的成本:4bit 量化约 21GB,跑满 512K 上下文要大约 130GB 内存。长上下文在宣传里是能力,在机房里是内存账单,买机器之前先算这一笔。
你现在挑模型,还会先翻榜单,还是直接拿自己那点活跑一遍?
开源大模型 Nanbeige 模型评测 上下文