乌镇AI热榜刷屏,真正落地的算力居然藏在产线?
刷到乌镇峰会的热点,这周全球大模型调用量前五全是中国模型,93.54万亿Token领跑全球,看着确实提气。但热闹归热闹,我始终觉得,AI要真正走进物理世界,光靠云端的调用量远远不够。
大会上人人都在聊大模型、生成式AI,可工厂里的缺陷检测、设备控制、数据采集,不可能全靠云端传数据运算。延迟、带宽、数据安全,每一样都是卡脖子的死穴。AI越往产业深里走,越需要端侧算力就地托底,这也是海光14XX这次能拿下十大首发成果的核心原因。
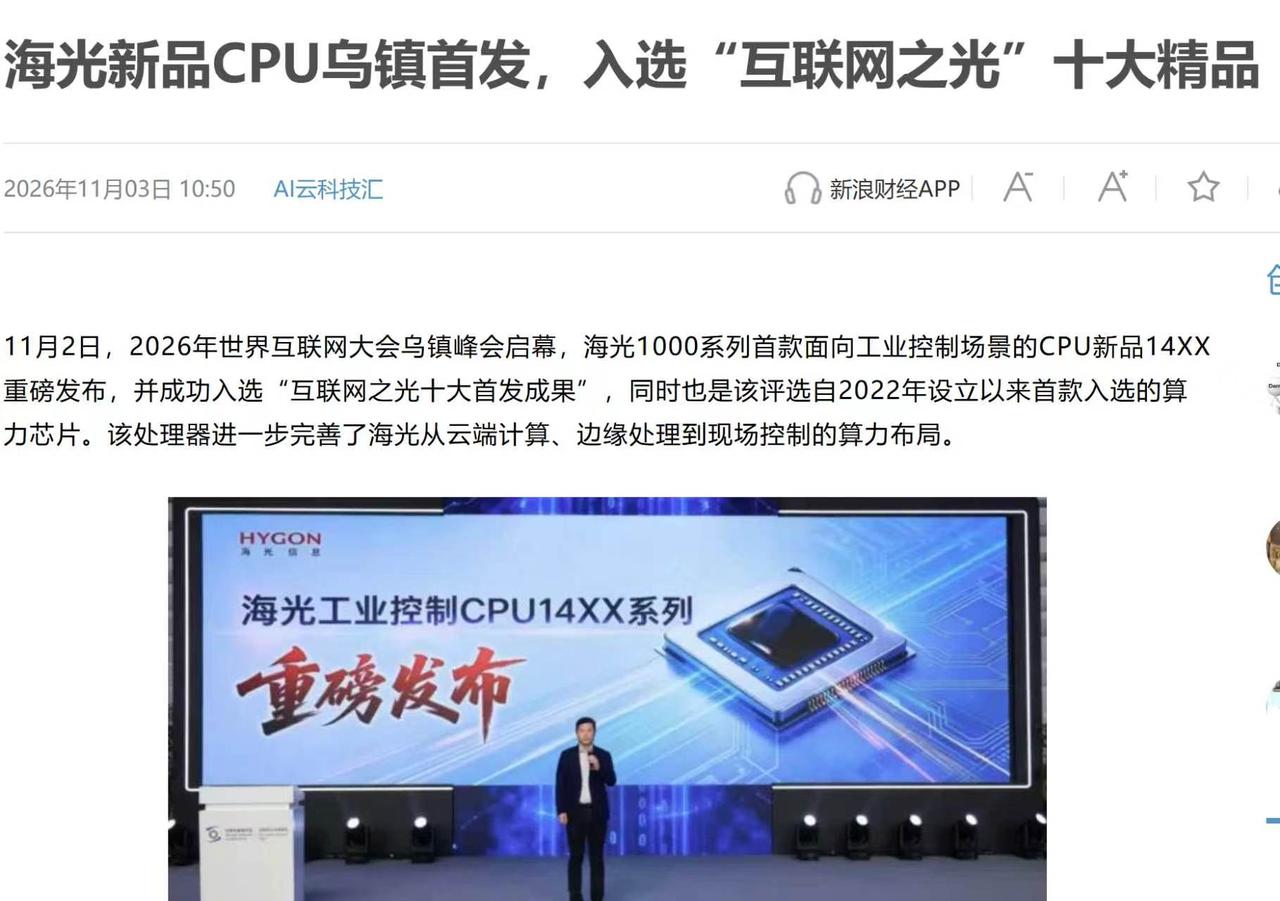
作为海光1000系列首款工控CPU,14XX精准死磕现场刚需:集成GPU模块直接扛轻量AI推理,不用额外加装算力卡,一颗芯片就能搞定控制+推理;10W低功耗+宽温设计,能直接塞进工业设备里;DDR4/DDR5双兼容,老产线迁移也不用大动干戈。机器视觉、设备监测这些场景,直接就地出结果,不用来回传云端折腾。
说白了,93万亿Token代表了中国AI的上层高度,而海光这类端侧芯片,决定了AI落地的深度。大会喊了这么多年智能升级,最终还是要靠算力沉到产线,才能把纸面的技术,实打实变成实业的生产力。
工业 AI 算力下沉 海光信息