神秘模型登顶再引争议,RoboDojo如何应对具身智能企业“刷榜”?
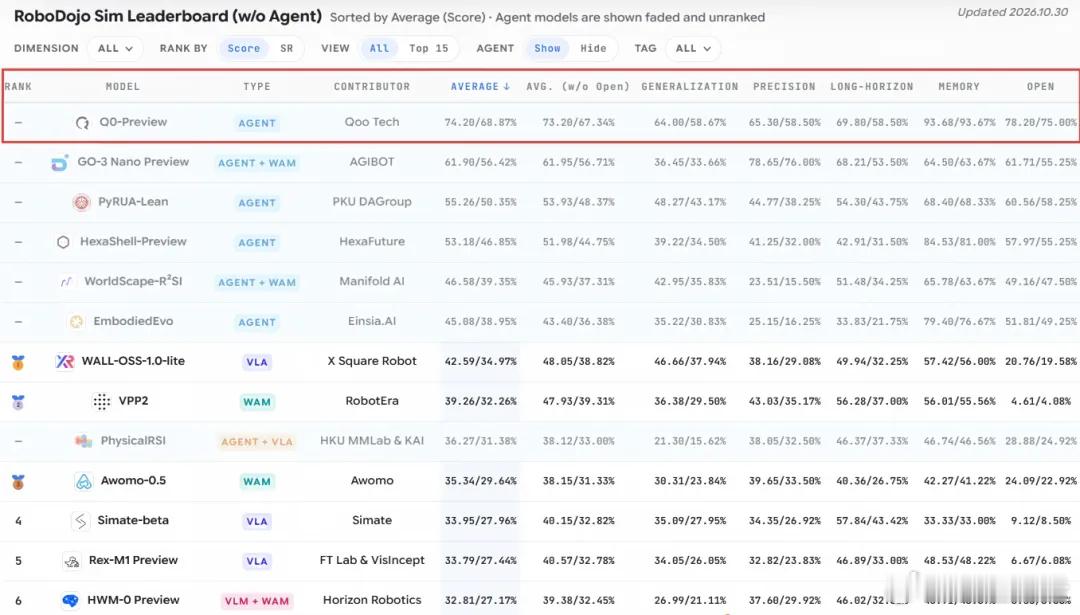
10月30日,RoboDojo仿真榜刷新,一个叫Q0-Preview的模型空降榜首:任务进度分74.20,任务完成率68.87%,领先第二名十几个百分点。
榜单贡献方一栏写着“Qoo Tech”,搜遍全网查无此人。
就在这个匿名冠军引发猜测的同时,这个由港大多媒体实验室与清华牵头、近20所高校实验室共建的具身智能评测,也引来热议——榜首刷新是不是太快了?“榜单第一”的传播合理吗?将AGENT和VLA、WAM并列是否合理?……
01又一个“第一”
RoboDojo发起之后,四面八方的模型都来挑战,高手迭出。
Q0-Preview也是Robodojo Agent赛道最新的榜首,任务进度分达到73.33、任务完成率约68%,是开榜以来首个Score突破70的模型,成功率领先第二名约12个百分点。
由于这一模型的发布者外界不得而知,而其成绩却这么好,其表现和VLA、WAM这类主流路线完全不同,其双臂协同的连贯程度“不像靠遥操数据堆出来的”,真实身份一时间成为讨论的焦点。对一个评测榜单来说,参赛者身份尚不透明时,榜单的解读空间自然会放大。
另外,Q0-Preview也体现出了非常大的不同。
最亮眼的是记忆项,93.68分、成功率93.67%,全榜断层领先,第二名GO-3 Nano Preview只有64.53分,VPP2、WALL-OSS这些顶尖VLA与WAM模型更是只有50多分。
这说明,它是纯Agent路线,带独立记忆模块和校验器,内部维护一张任务进度清单,因此能大幅超越其他模型,尤其是纯粹的VLA或WAM。
不过,Q0-Preview精细操作能力不是顶尖,65.30分落后GO-3 Nano Preview的78.65分。
此外,它只参加Sim仿真赛道,没有提交RealEval真机成绩。
目前,Q0-Preview尚未公开完整技术报告,其规划模块、动作模型及底层模型的具体构成仍有待进一步披露。
02榜单高频变动
Q0-Preview登顶之前,另一个“第一”屁股还没坐热。
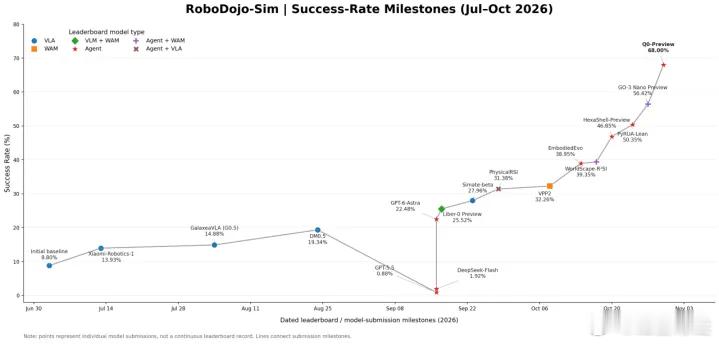
10月27日,智元AGIBOT的GO-3 Nano Preview以61.90分、56.42%成功率加入仿真榜Agent赛道,当时被报道为“登顶”并超越GPT-6 Astra。
其实,就9月底GPT-6 Astra加入榜单之后,也许是受到“击败”GPT-6 Astra的诱惑,有11个新模型加入榜单,而且每个新加入者都是“冠军”,任务成功率从22.48%直接飙升到68%。
40多天11个“王者”,城头大王旗实在太快。其原因,并不是模型进步太快,而是不同技术路线的进步速度有差异,而评测方式和排名规则并没有及时调整,出现了不匹配。
另外,很多公司在RoboDojo刷榜成功后,大肆宣传,号称“世界第一”或“超越 GPT-6”,引发了批评。
还有,不同架构的模型在榜单上混排,很多人也认为不公平。同时,也有人批评评测方法并不公平。
一份发布于10月23日前后的技术精读笔记,就指出说:30个输入接口各异的策略纳入统一评测时,“适配层”本身可能引入公平性偏差;公开榜天然存在针对基准调优的过拟合风险,而论文摘要未说明如何区分真实泛化与基准过拟合;真机部分基本无法由第三方复现。
如何看待RoboDojo的调整
针对近期争议,RoboDojo发起人、香港大学在读博士陈天行发帖直接给出了回应。
陈天行表态颇为坦诚——“RoboDojo发布于pre-Astra时代,总体设计本身面向具身基模,面对新方案审核我们一直在调整,实际上我们背后卡了很多提交,发布本帖目的也是开一个对话的窗口,暴露问题和倾听解决方案。”
他也回应了数据泄露传闻。他说,RoboDojo没有像RoboTwin那样开源数据合成方案,初心恰恰是防hacking。针对“市场上据说出现RoboDojo数据”的传闻,他的回应是“绝不是我们流出的,我们没有获得过任何经济利益”,办法是维护闭集进行额外测试,“发现过有团队在闭集中表现明显下降,最后拒绝了上榜”。
真正大动作在于规则调整。陈天行说,RoboDojo开源一个多月后,Astra带来的新范式冲击很大,而RSI/Agent方案大多需要交互迭代、速度慢,不适合与后训练模型平行比较,于是团队独立出Agent子榜,主榜只排名非Agent模型方案,并要求PR里明确标注赛道,避免overclaim。
另一个规则调整是,关闭Open维度——“我们发现难以监控/审核该方案是否存在hacking情况”,两周前已提出移除该维度计分。
至于评测本身怎么改,他给的是个人看法:Agent榜单按Zero-shot(零样本)进行分榜,鼓励提交具身基模方案(“我们测试算力不足,Agent方案很耗时”),限定评测时间(“当前很多方案评测时间过长,给我们造成很大的压力,同时横向对比不公平”),更适合Agent方案的评测也在计划中。
从目前信息看来,陈天行坦率承认了RoboDojo的不足。它最初的设计面向具身基础模型,却因为GPT-6 Astra等新范式、Agent类方案加入评测而带来挑战。
而调整思路也直面问题,包括不同架构的模型不宜简单混排,探索Agent独立榜单、关闭Open维度、增加Zero-shot评测等机制,都是“对症下药”的。
评测团队不指望一劳永逸,而是常常听取意见,并在技术范式变化中重新思考评测体系,也是值得赞赏的。
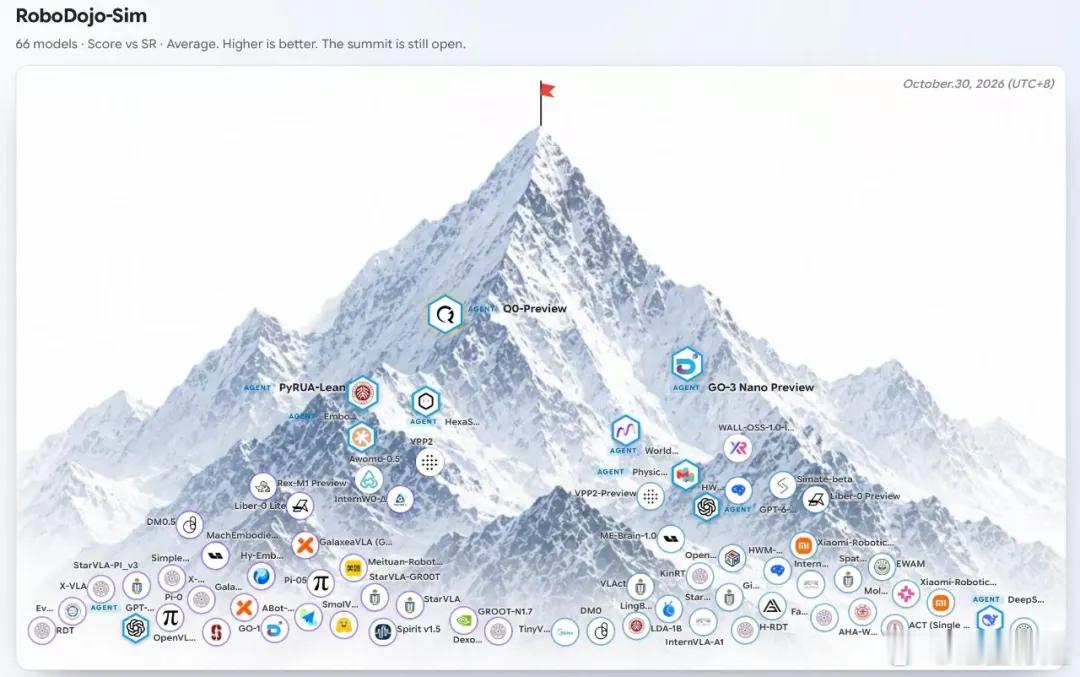
RoboDojo发起3个月,仿真榜已经测试了66个模型。但珠峰图顶端那面红旗写着“The summit is still open”,Q0-Preview的加入让具身智能模型离坡顶还有25分左右的距离。
当具身智能的技术路线从VLA扩展到Agent,当模型能力开始快速突破,行业需要的不只是一个排行榜,而是一套能够识别不同技术路线真实能力、衡量泛化水平、检验真机表现的评测体系。