测了几道题,就能知道 AI 真的会了吗?
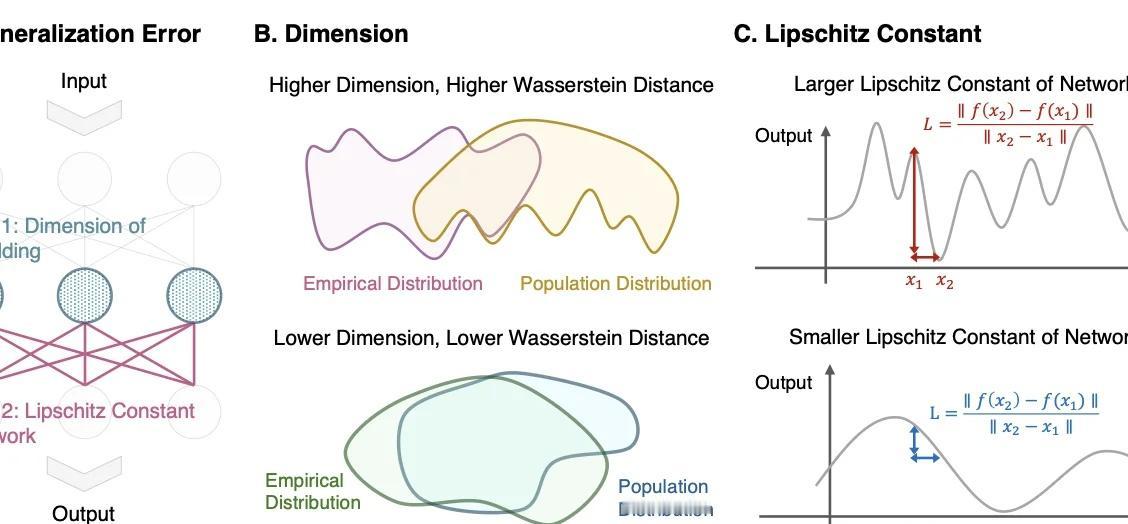
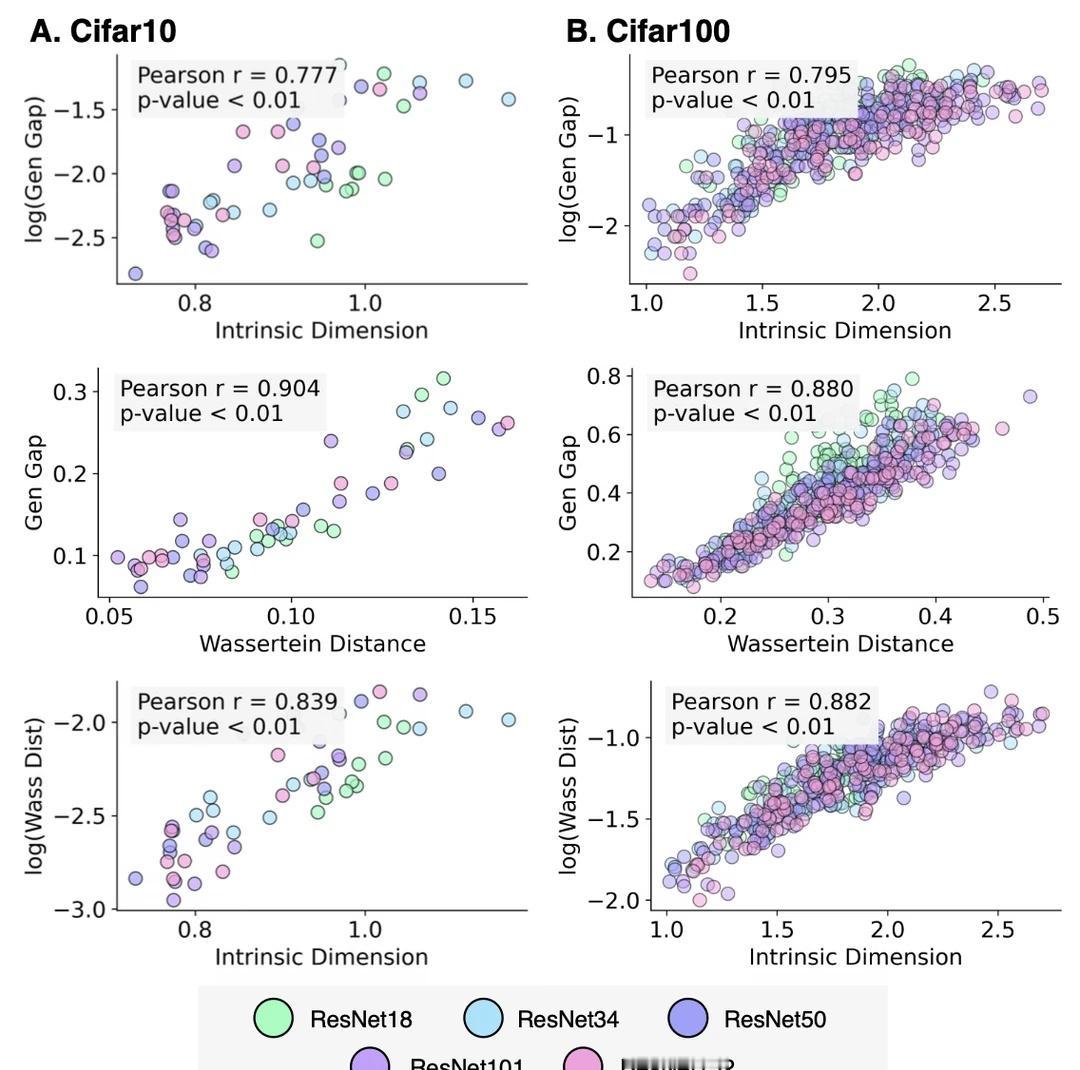
想象一下,你想判断一个学生英语好不好,却只抽查了几道题。如果抽到的题都差不多,这个分数可能不太能说明问题;如果题型覆盖得比较全面,成绩就更有参考价值。 看 AI 也有类似的问题:我们在一小批测试数据上看到的成绩,能代表它面对更多新数据时的表现吗?这篇论文说,可以从两件事来理解。 第一,测试数据有多“杂”。 如果数据的变化比较集中,少量样本就比较容易看出整体情况;如果数据变化很多、差异很大,就需要更多样本,才能判断模型整体表现。 第二,模型对变化有多敏感。 一张图片稍微变暗一点,或者一句话换个说法,模型的判断就大幅改变,说明它容易受到变化影响。反过来,结果比较稳定,说明它没那么敏感。 所以,论文想表达的是:数据越容易被少量样本代表,模型对变化越稳定,我们就越有把握:测出来的成绩接近它面对真实数据时的表现。 研究者用“表征的内在维度”描述数据变化有多复杂,用“Lipschitz 常数”描述模型对变化有多敏感。名字听起来有点专业,但可以先记住上面这句话。 还有一个重要提醒:这篇论文不是说“维度越低,AI 就越聪明”,也不是说低维模型的准确率一定更高。它讨论的是:训练好的模型,在有限评估数据上的表现,能不能代表整体表现。 📄 Understanding Generalization from Embedding Dimension and Distributional Convergence AI论文日报 人工智能 机器学习 泛化