OpenAI 发了 BioBasicsBench:和生物公司 Ligo 一起,用 100 个常规湿实验任务,测 AI Agent 读原始实验证据的能力——凝胶、菌落板、显微镜图、仪器导出,还有失败和对照。
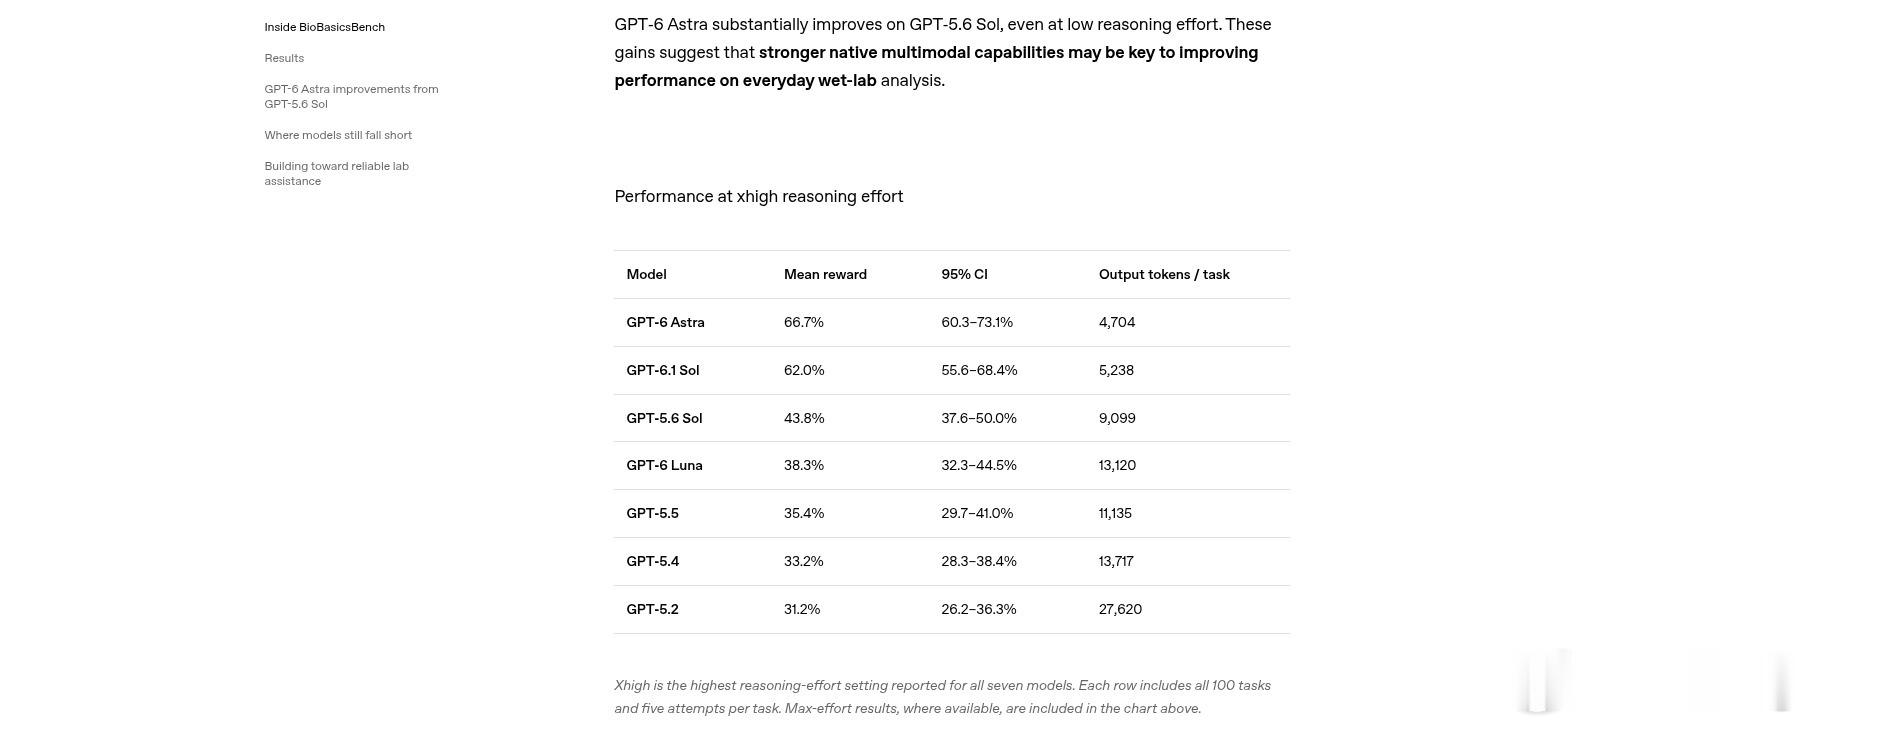
官方数字:在最高推理档,GPT-6 Astra 平均拿到 66.7% 的分数;前代 GPT-5.6 Sol 是 43.8%。进步明显,但官方自己也写:分数高,还不等于能在实验室里做可靠判断。
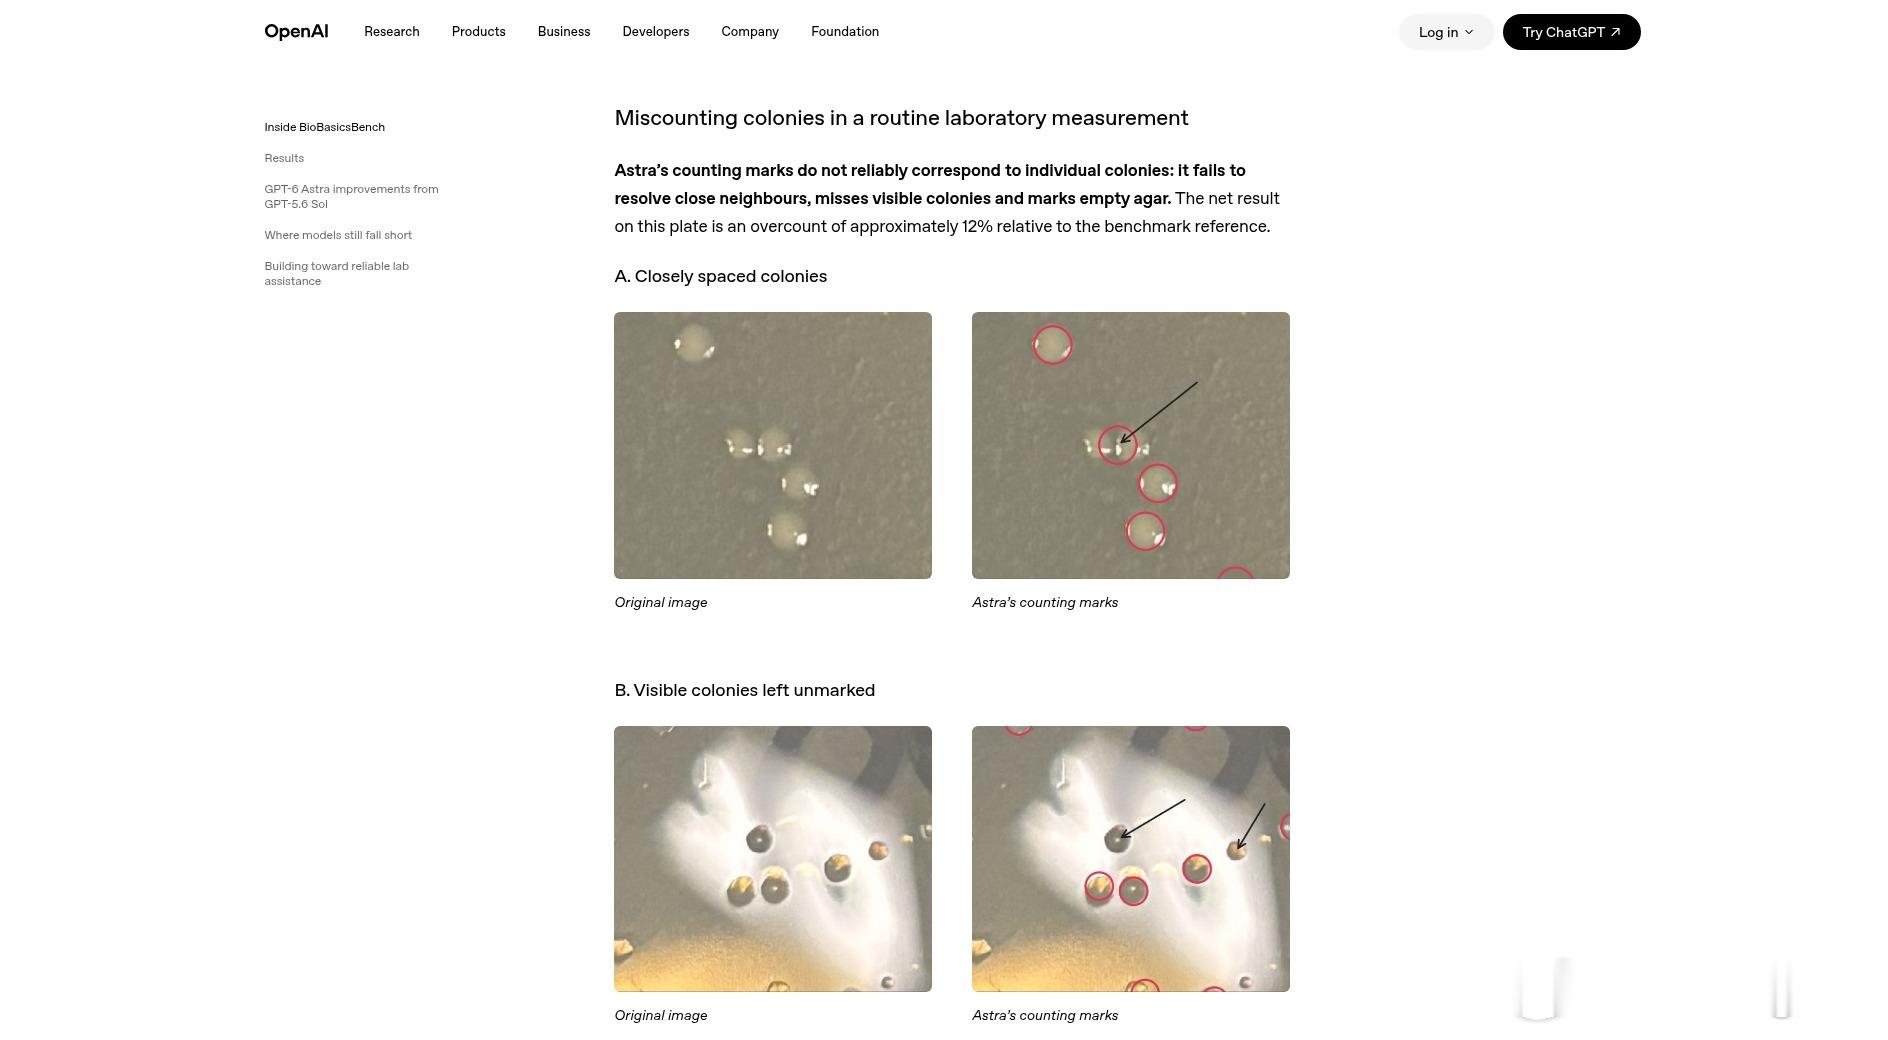
我更盯它强调的失败模式:假设压过对照、只挑对自己有利的现象、把空琼脂也数成菌落。
这跟现场干活一个道理。证据不够,就别急着下结论;对照没看清,就别把活往下推。
OpenAIAI智能体人工智能人工智能超话