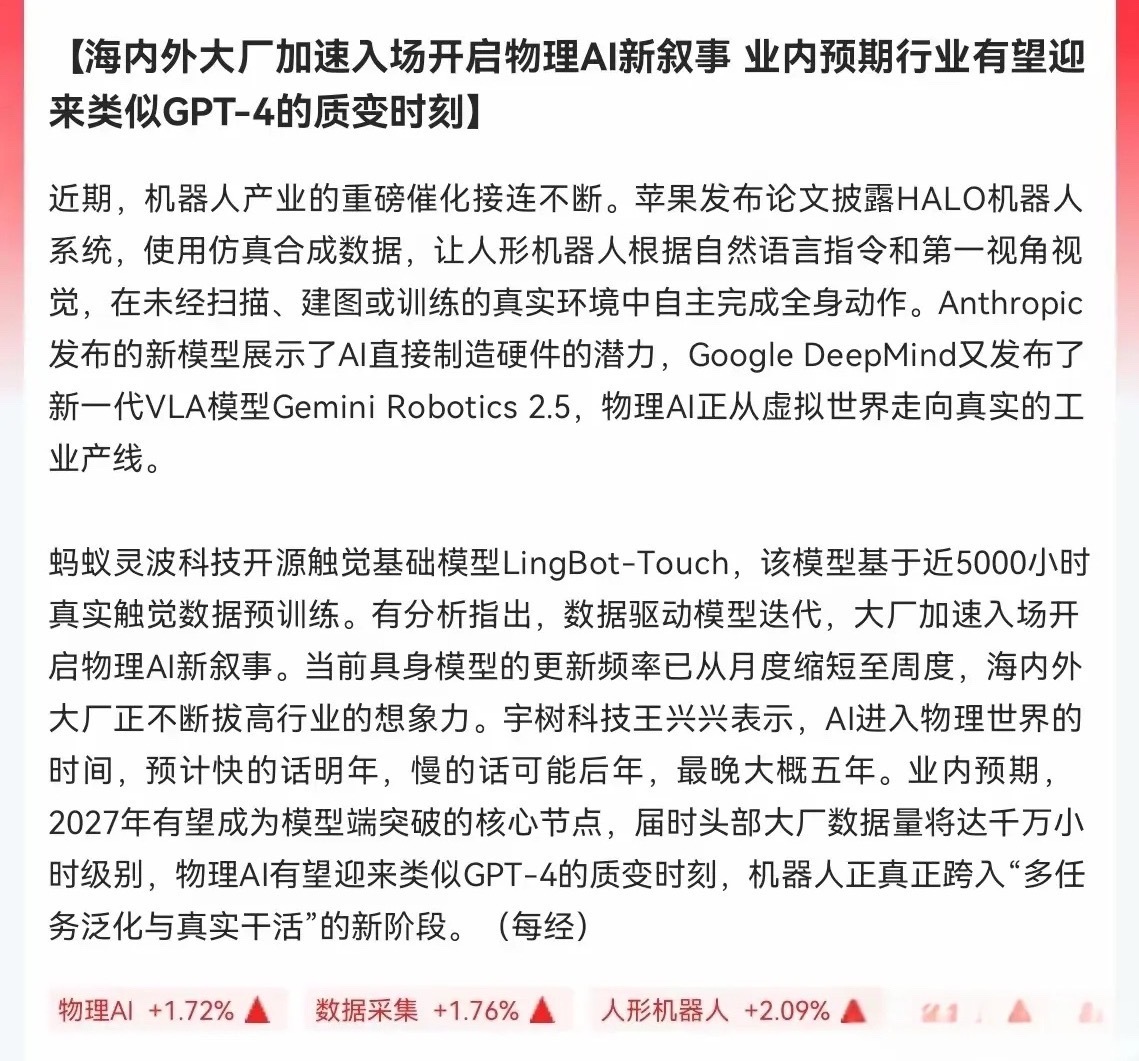
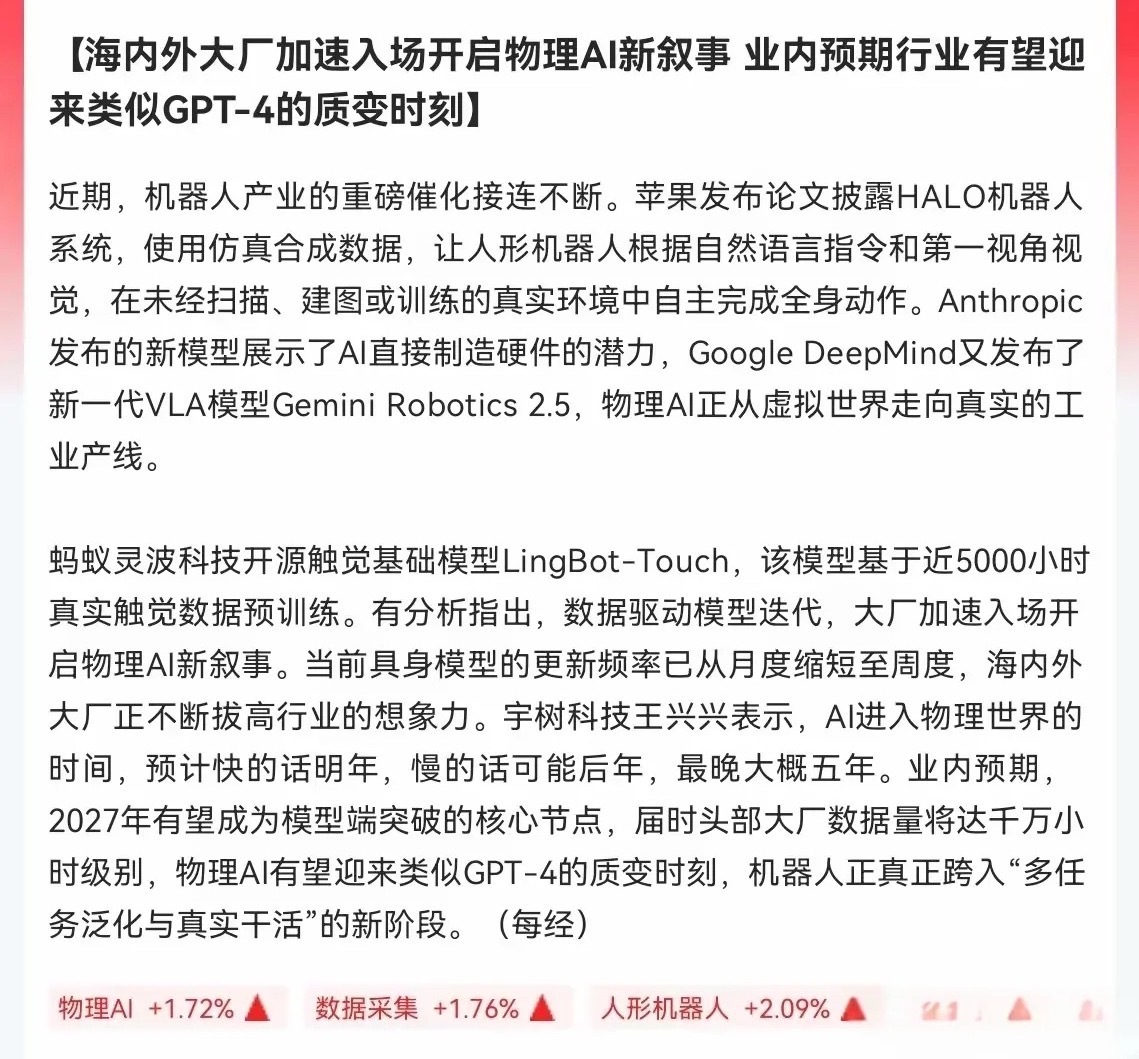
海内外大厂加速入场开启物理AI新叙事业内预期行业有望迎来类似GPT-4的质变时刻物理AI对芯片算力的拉动,和云端大模型有本质区别。云端追求极致算力密度,物理AI则要在功耗、散热、实时性、功能安全的严格约束下完成感知与推理。这决定了机会不只属于GPU,而是分散在边缘推理芯片、车规/机器人专用SoC、FPGA预处理、以及配套的存储与散热等多个环节。
边缘推理芯片:物理AI的主战场,形态在分化
物理AI的推理发生在机器人本体或产线现场,无法事时回传云端。Arm测算,2025年全球物理AI相关计算需求约250亿美元,到2030年将达2000亿美元,是2025年的8倍。这个增量主要落在边缘侧。
通用边缘AI芯片在走“够用就好”的路线。韩国DEEPX的DX-M1提供25 TOPS算力,功耗仅2到5瓦,主打低散热、M.2插槽即插即用,面向自主移动机器人导航和本地视觉处理。无锡诚恒微的CH37系列做到64 TOPS峰值算力,芯片面积仅7.29平方厘米,让机器人脱离云端在本地完成视觉、语音识别与决策。爱芯元智的AX8860则定位“大算力边端”,配合推理卡和服务器形态,瞄准工业质检、精密装配等场景。
专用架构芯片在尝试绕开传统路径。苏州睿芯的“高光D35”基于RISC-V数据流架构,明确不跟云端芯片拼算力规模,而是聚焦物理世界的智能计算,配备128GB大显存支撑边缘侧本地部署大模型。莱迪思则从FPGA切入,先用FPGA做传感器信号汇聚和预处理,再交给GPU,减少GPU在预处理上的算力消耗,相关方案已在机器人客户中量产。
车规与机器人关节芯片:被低估的增量环节
汽车和机器人的芯片需求逻辑不同。汽车走的是集中式架构+大算力SoC路线,智驾芯片算力从双OrinX的500 TOPS向三图灵芯片的2250 TOPS跃升。国内车企自研芯片浪潮正在改写格局:2026年8月国内智驾域控芯片装机中,英伟达份额从年初的45.1%降至30.2%,地平线和华为在追赶。Arm推出面向物理AI的Total Design生态,联合80余家伙伴降低车企定制芯片的门槛,本质是在争夺这个增量市场的底层架构话语权。
机器人关节则是另一个容易被忽视的算力落点。MIPS的Actus平台把实时电机控制、边缘推理和确定性网络集成在单颗RISC-V芯片上,专为紧凑型机器人关节设计,用硬件多线程避免中断开销,让传感器融合和预测性维护模型在驱动电机的同一芯片上运行。这类芯片单价不高,但人形机器人关节数量多,总量可观。
配套环节:存储、散热、封装是被动受益但确定性不低的方向
物理AI芯片在边缘运行,功耗受限但数据量不小。SiMa.ai的物理AI芯片平台集成了美光的LPDDR5X内存,核心诉求就是在高带宽和低功耗之间找平衡。国内券商研报也指出,冷板式液冷和2.5D封装已进入产业化放量前夜,盾安环境、沃格光电等液冷与先进封装环节企业直接受益于AI应用深化带来的基建投入。
需要留意的结构性差异
云端AI的算力竞争高度集中于英伟达,但物理AI的芯片格局更分散。机器人本体厂商对成本极度敏感,工业场景对功能安全和实时性的要求又高于消费电子,这给了国产芯片和专用架构公司切入的窗口。但反过来,碎片化也意味着单个芯片厂商的天花板受限于它能绑定的终端出货量。Arm预测的2000亿美元市场是总量,落到具体公司身上,取决于能否在某一类载体(汽车、人形机器人、工业AMR)上形成规模交付。
简言之:物理AI的算力机会不在“更大算力”,而在“更合适的算力”——边缘推理芯片看谁能平衡功耗与实时性,车规芯片看国产替代和车企自研的博弈,关节与配套环节看机器人量产爬坡的真实节奏。