NorthCUA:电脑AI如何积累经验?
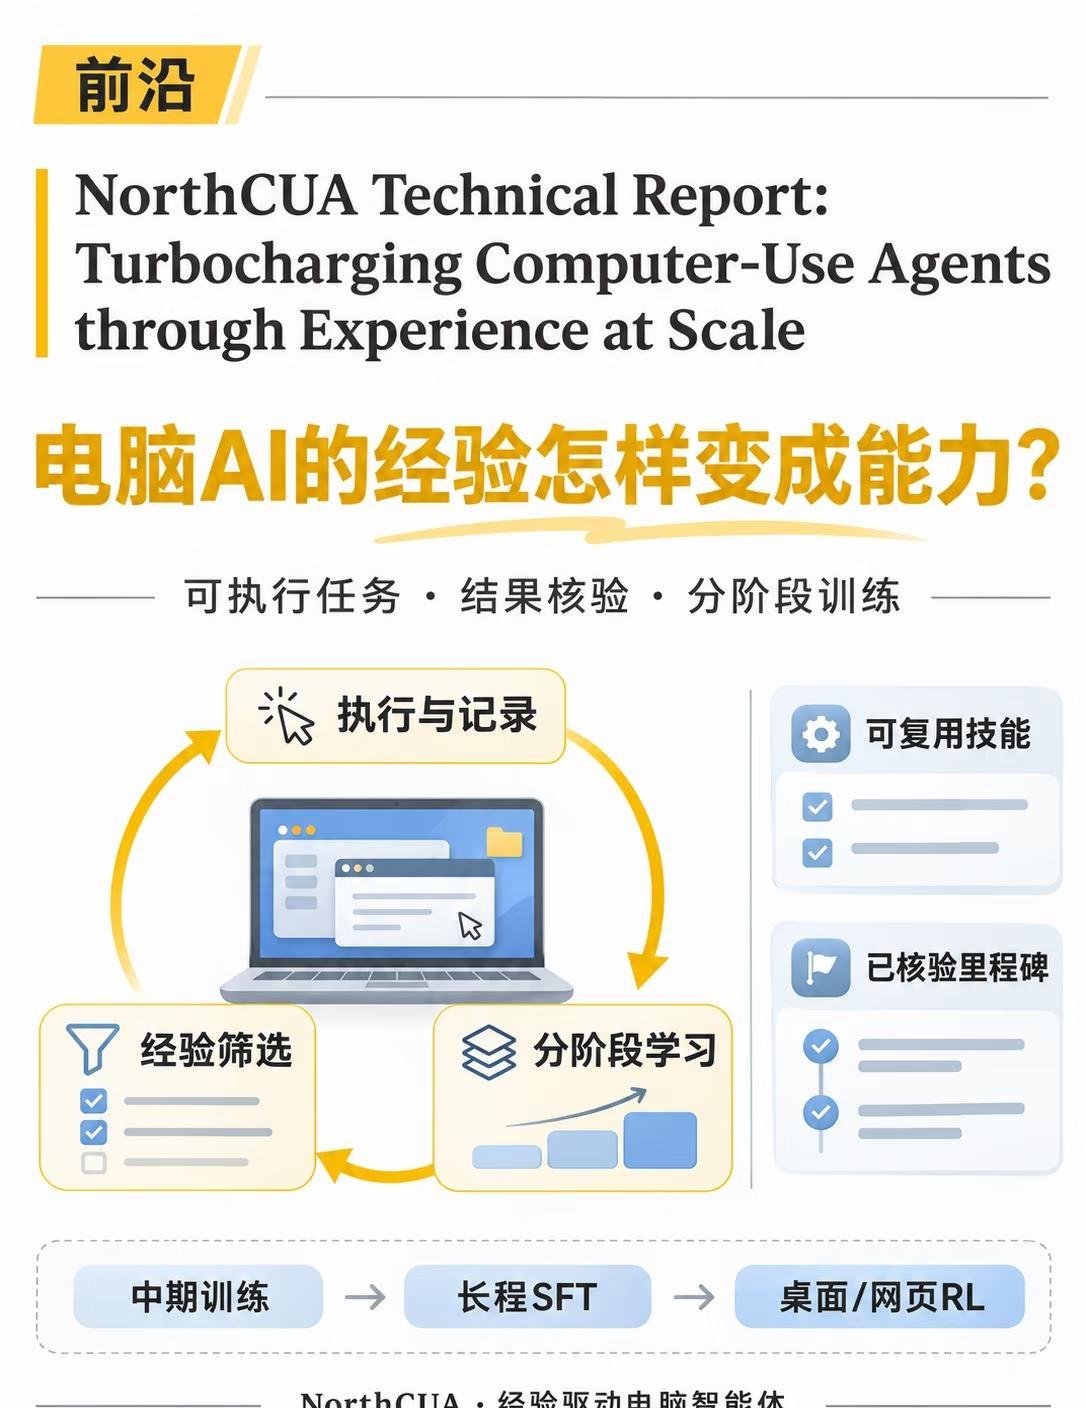
电脑AI会点按钮,距离完成跨软件工作流还有多远?NorthCUA把重点放在“经验怎样生产、核验,再用于训练”。它把任务构建、执行框架和模型学习连起来,让每次尝试留下可检查的过程与结果。
经验飞轮先准备真正可执行的任务:用户目标、输入文件、软件环境和验收条件要一起成立。Harness运行桌面或网页操作,保存截图、动作、产物和结果;需要检查真实工作区时,环境会保留到核验结束。再检查产物是否满足目标。
难题采集有两条路线。一条把探索中发现的操作方法写成技能,再交给独立尝试验证;另一条把长任务拆成可检查的里程碑,同时保存工作区快照和智能体上下文。后续分支从已核验进度继续,最终仍由原任务验证器验收。这里的递归改进发生在经验采集:积累可复用步骤和进度,再把合格轨迹交给学习阶段。
训练分三步。广泛GUI中期训练使用超过10万条轨迹、400万步操作,并补充单步控件定位数据;长程SFT聚焦约3000条、31万步经过检查的完整流程;随后用同一策略在桌面与网页上进行GRPO,学习自己新尝试的成功与失败。有效失败样本也进入RL比较,而非只保留成功记录。
Nano、Mini和Pro基于Qwen3.5,分别为9B、35B和397B语言模型总参数;后两者为稀疏模型,活跃参数约3B和17B。报告中,Pro在OSWorld-Verified的361项受支持任务、每题最多100步设置下,最终成功率为88.6%。换到OSWorld 2.0的108项任务、最多500步,完整完成率为30.6%,部分得分为66.8%;两种指标不能混作“完成了任务”。
速度也有取舍。Ultrafast在强化学习前的Nano上加入直接选择动作的接口。Head+LoRA在固定320项成功筛选子集上,平均用时约缩短至原来的1/2.3;全812项任务的成功率则从64.2%降至60.6%。这支持特定条件下的质量与延迟权衡,不代表所有任务都等比例提速。
边界仍在陌生软件、界面变化,以及验证器覆盖不到的开放内容。跨模型榜单还受工具、观察和预算影响,不能把名次全归因于模型权重。NorthCUA更值得关注的,是把执行记录、结果证据和训练反馈接起来,让“做过很多次”逐步变成“知道哪些经验可靠”。
智能体 大模型训练