【思进摘要点评大模型AI 技术模型蒸馏 “拒绝蒸馏” 爆料背后:大模型需要跳出跟随式追赶】(资讯来源 | 华尔街俱乐部)
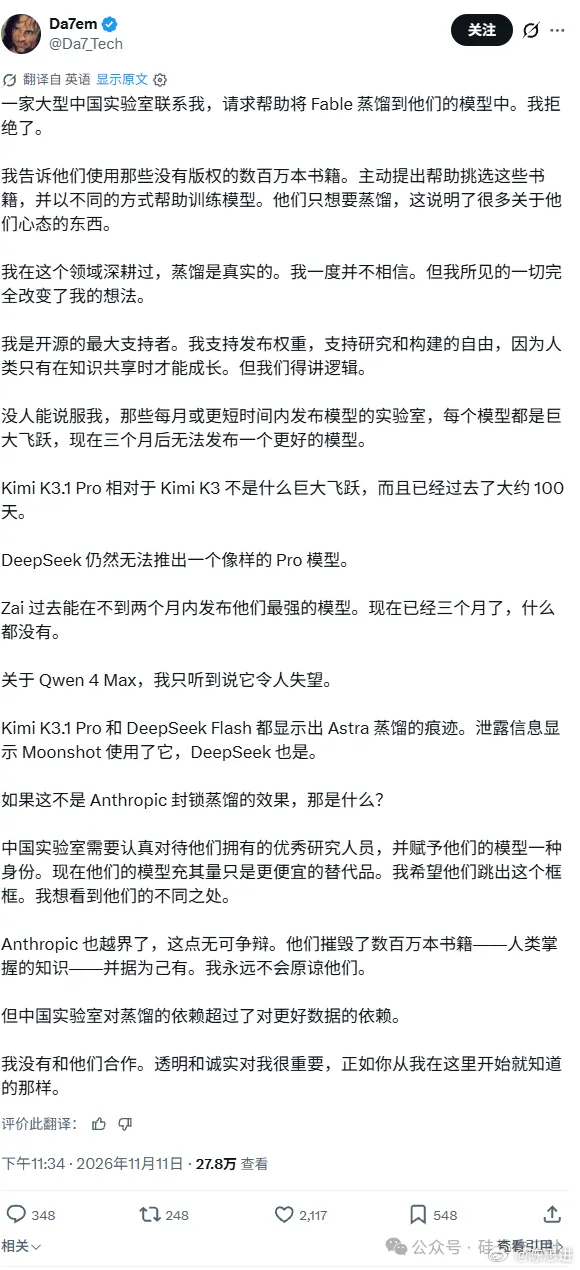
近期一位 AI 博主发文,称拒绝了国内一家大模型实验室蒸馏 Anthropic Fable 模型能力的请求,在业内引发讨论。这只是单方口述,缺少聊天记录、企业实名等佐证,不能直接认定相关企业违规。
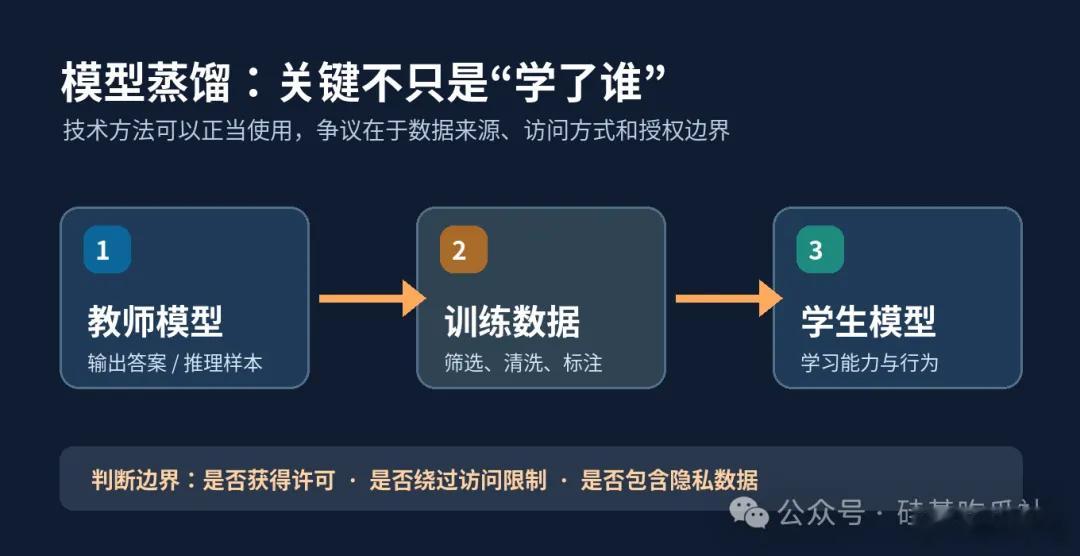
先厘清一个前提:模型蒸馏本身是成熟常规技术,用来把大模型能力迁移给小模型、控制成本,技术本身没有对错,核心边界在于数据是否获得授权、有没有绕过平台限制批量抓取。此前 Anthropic 曾指控国内厂商违规提取模型能力,这只是它的单方调查结论,并非司法定论,不能直接等同于国内行业普遍依赖蒸馏。同时 Anthropic 自身也存在扫描书籍训练的版权争议,不过书籍数字化和绕开接口批量提取模型输出,二者性质并不相同。
还有一个容易被忽略的点:Anthropic 上线防护机制后,可用于蒸馏的对外数据大幅减少,有人猜测部分团队迭代因此放缓。但模型发布节奏受算力、调优、评测排期多重因素影响,同期 Qwen4-Max 也开启预览,性能好坏,最终要靠公开可复现的评测来验证。
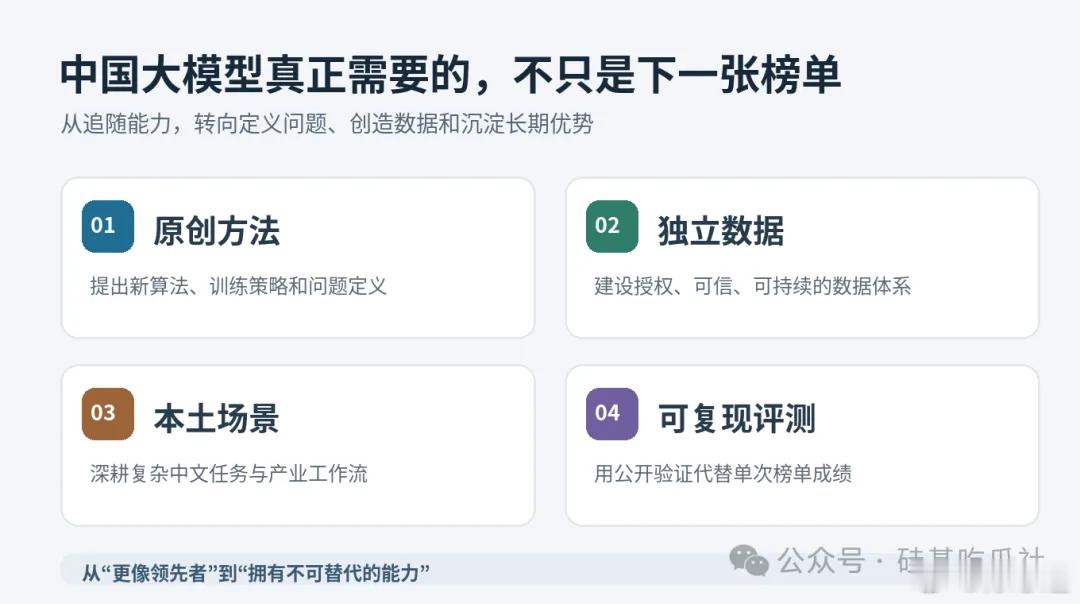
在我看来,比起合规争议,更值得深思的是路径依赖的风险。蒸馏适合快速复刻已有能力,却很难定义下一代智能的方向。一直跟着别人的考卷优化跑分,即便性价比突出,也容易丢失原创的问题定义能力。真正的长期壁垒,是在中文复杂任务、产业软件、长周期智能体、基础科研场景搭建自有数据底座,沉淀独有的方法论。等到外部模型不可调用时,依然能拿出原创解法,才是核心竞争力。
> > 个人观点分享,不构成行业定论