2026年11月15日,华为云MaaS(ModelArts Studio)平台悄然上线了开源盘古最新一代模型openPangu-2.1-Pro。
把时间线往前拨两周,这次上新其实带着点“虚晃一枪”的戏剧性。11月1日,华为云曾发布公告,宣布将于11月6日停售上一代openPangu-2.0-Flash与openPangu-2.0-Pro两款托管模型服务,并于11月30日正式下线。消息一出,“华为云放弃盘古”的议论随即在圈内传开。直到11月初小艺Work率先接入2.1-Pro、随后11月15日MaaS正式接棒上架,外界才看清这并非撤退,而是一次两周走完的快速换代。
耐人寻味的是,这一次,没有铺天盖地的“遥遥领先”式榜单海报,甚至截至11月中旬,官方都未公开openPangu-2.1-Pro的总参数量、激活参数量、开源权重和通用基准测试成绩。唯一明牌摆上桌面的,是一张“输入0.8元、缓存命中0.016元、输出3.2元/百万Token”的定价表,以及围绕Agent、鸿蒙、昇腾的三大定向升级。
这不禁让业界追问:剥开营销滤镜,2026年底最新版的华为盘古大模型,到底处于什么水平?
要看懂新版盘古的成色,得先看清它过去两年走过的路。
2024年6月HDC 2024的盘古5.0,以及2025年6月HDC 2025基于CloudMatrix 384超节点发布的盘古5.5,走的是典型的“AI for Industries”闭源行业路线——依靠L0基础大模型、L1行业大模型、L2场景模型的分层架构,深入煤炭、气象、政务等重资产B端场景。
真正的转折点发生在2026年6月12日的HDC 2026。余承东接手盘古大模型后,华为打出了开源牌:正式发布openPangu 2.0(包含Pro与Flash两个版本,统一支持512K上下文),并于6月30日和7月31日陆续在GitCode、HuggingFace等平台开源模型权重、基础推理代码、预训练与后训练代码及技术报告。
余承东在HDC 2026上曾说过一句很实诚的话:由于大量昇腾算力优先供给国内其他企业需求,华为自留算力规模有限,因此将更聚焦时延和吞吐率优化。
这句话其实已经解释了今天新版盘古的全部底色。华为很清楚,在算力优先对外供给的约束下,没必要跟互联网大厂去拼无底洞式的通用参数军备竞赛。盘古的牌面,必须从“通用跑分王”转向“昇腾软硬件协同效率最高、且最懂鸿蒙与政企生态的生产力底座”。
由于11月刚刚上线的openPangu-2.1-Pro尚未披露参数规模与基准分数,评估新版盘古的通用硬实力,必须回到三个多月前完整开源的openPangu 2.0技术底座上寻找参照系。
从HuggingFace公开的模型卡来看,openPangu 2.0在底层工程上确实拿出了相当扎实的技术细节:
1. 极致的稀疏激活与混合注意力:2.0-Pro总参数505B、每Token激活仅18B;2.0-Flash总参数92B、激活仅6B,两者均基于34T tokens预训练。模型保留了MLA(多头潜在注意力),并以1:2的比例混合DSA(动态稀疏注意力)与SWA(滑动窗口注意力),在保持512K长上下文精度的同时,大幅压低了长序列推理的显存与访存成本。
2. 残差拓扑与自投机解码:用4-stream mHC设计替代传统残差连接以提升表征多样性;内置3个MTP(多令牌预测)头实现自投机解码加速;训练期采用Muon优化器加速收敛;后训练则通过“快慢思考合一SFT + 多专项RL + 在线策略蒸馏(OPD)”把推理能力压缩进小尺寸激活参数中。
这套架构在实际跑分上呈现出非常鲜明的“长板极长、短板可见”的偏科特征(以下均为Thinking模式官方自报数据):
在数学竞赛与轻量化蒸馏上,盘古的表现堪称惊艳。2.0-Pro在AIME 2026拿到95.4%(配合Python达97.9%),GPQA-Diamond达87.9%,LiveCodeBench V6达85.7%,TAU2-Bench达81.1%,IFEval达94.5%。更值得留意的是仅6B激活参数的2.0-Flash,它在AIME 2026拿到93.3%、LiveCodeBench V6拿到85.1%,甚至在TAU2-Bench(88.0%)和IFEval(95.9%)上反超了Pro版。这说明华为在昇腾集群上的在线蒸馏和结构化指令遵循确实做到了国内顶尖水准。
但硬币的另一面同样清晰。即便在官方自报口径下,2.0-Pro在代表真实软件工程修复能力的SWE-bench Verified上仅得68.5%(2026年主流模型中位数已达75.7%),事实性问答SimpleQA Verified也只有34.9%。更重要的是,大模型王者峡谷等聚合平台明确标注,2.0系列的这批分数均为厂商系统卡自报,尚未经过Epoch AI等独立第三方统一脚手架复跑;而在SuperCLUE、LMSYS Arena等公共盲测榜单中,盘古的覆盖度与声量也明显低于DeepSeek-V4.1、Qwen3.8与GLM-5.3。
理解了2.0的底色,再来看11月15日刚上线的openPangu-2.1-Pro,华为的算盘就非常通透了。这一次升级没有把精力花在刷通用榜单上,而是做了三个极具功利主义色彩的定向切口:
第一刀切在Agent工程落地。针对智能体最容易翻车的“工具选不对、多步状态丢”,2.1-Pro基于10万余条专项数据重点优化了Skills触发、工具选择与多步调用能力,并直接接入小艺Work、智果AgentArts、码道CodeArts、果办OfficeAce等自有产品矩阵。
第二刀切在生态专属编码。2.1-Pro没有去和海外模型卷通用Web前端代码,而是把专项语料砸向了两个“别人不愿深耕、自己非做不可”的领域:鸿蒙ArkTS应用开发,以及昇腾NPU算子生成。一家同时握有芯片和操作系统的厂商,把大模型嵌进自己的软硬件闭环里,才是最难被外部模型替代的护城河。
第三刀,也是最具杀伤力的一刀,切在了推理成本账上。openPangu-2.1-Pro支持512K上下文(最大输入500K、最大输出384K、最大思维链256K,思考模式可按需关闭),兼容OpenAI与Anthropic协议;更重要的是,它的定价彻底告别了上一代“按输入长度惩罚”的分档逻辑,输出单价从2.0-Pro(>=32K档)的17.6元/百万Token暴降82%至3.2元,输入未命中0.8元,而前缀缓存命中价更是打到了惊人的0.016元/百万Token。
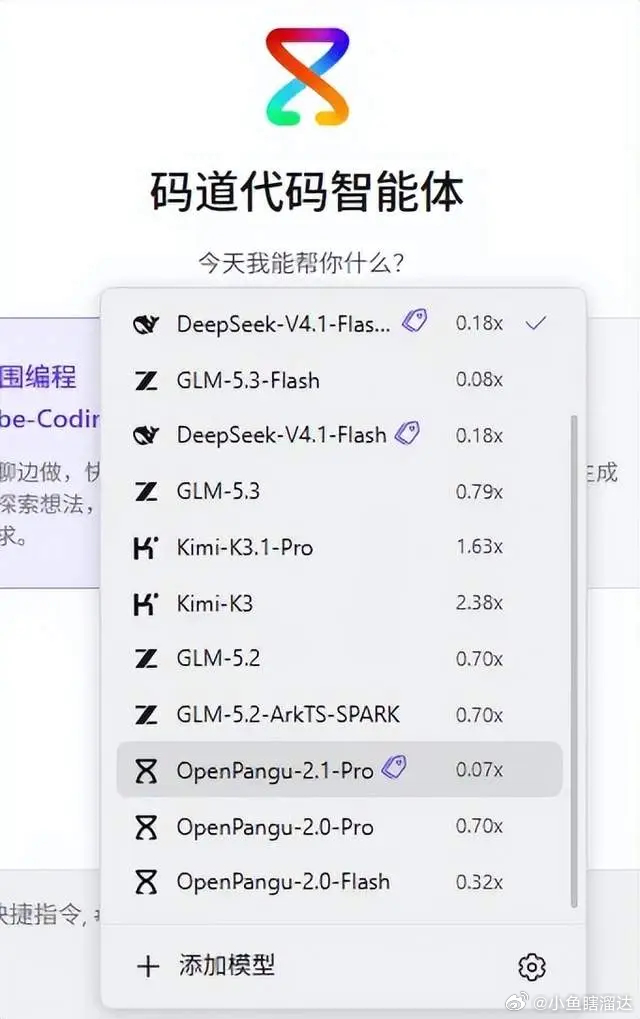
根据鲲鹏昇腾开发者社区基于华为云11月15日官方价格页的实算:在一个12万输入、8千输出的常规多轮Agent任务中,非缓存口径下2.1-Pro单次调用成本仅0.1216元,明显低于同在华为云MaaS上架的DeepSeek-V4.1-Flash(0.3040元)与GLM-5.3(0.4640元);如果业务流量的前缀缓存命中率能做到60%,单次成本还能进一步压低到0.0652元。
那么,新版华为盘古大模型到底是什么水平?
如果把2026年11月的大模型牌桌摊开来看,Gemini 4、GPT系列、Claude Opus等海外四强,以及国产的DeepSeek-V4.1、Qwen3.8、GLM-5.3,正在“1M超长上下文 + 原生多模态 + 通用高阶推理”的全能主航道上贴身肉搏。
新版盘古并没有选择在这条全能赛道上硬碰硬。它目前仍停留在512K纯文本与工具调用区间,通用复杂工程编程与第三方盲测口碑尚未进入绝对第一梯队,且2.1-Pro暂未公布参数与开源权重,客观上给外部选型留了一层“黑盒疑虑”。
但换个维度看,在昇腾NPU原生吞吐优化、长上下文前缀缓存经济学,以及鸿蒙ArkTS与昇腾算子垂直生态里,新版盘古已经拿出了国内第一梯队的专精实力与极具吸引力的性价比。
对于正在做技术选型的团队而言,判断标准其实很简单:如果你的项目围绕鸿蒙生态开发、昇腾算力私有化/信创部署,或者跑的是系统提示固定、多轮历史较长的高缓存命中率Agent工作流,openPangu-2.1-Pro值得立刻接入实测;而如果你的核心需求是原生多模态理解、1M超长窗口或通用的复杂全栈软件工程,在2.1-Pro放出开源权重与独立第三方评测之前,同台可用的DeepSeek-V4.1、GLM-5.3或Qwen3.8依然是确定性更高的选择。
在算力受限与商业化深水区的双重夹击下,华为没有执着于讲一个“全知全能”的宏大故事,而是把盘古打磨成了一把专为自家生态与降本而生的实用主义手术刀——这或许比单纯在榜单上多拿几分,更符合商业世界的真实逻辑。