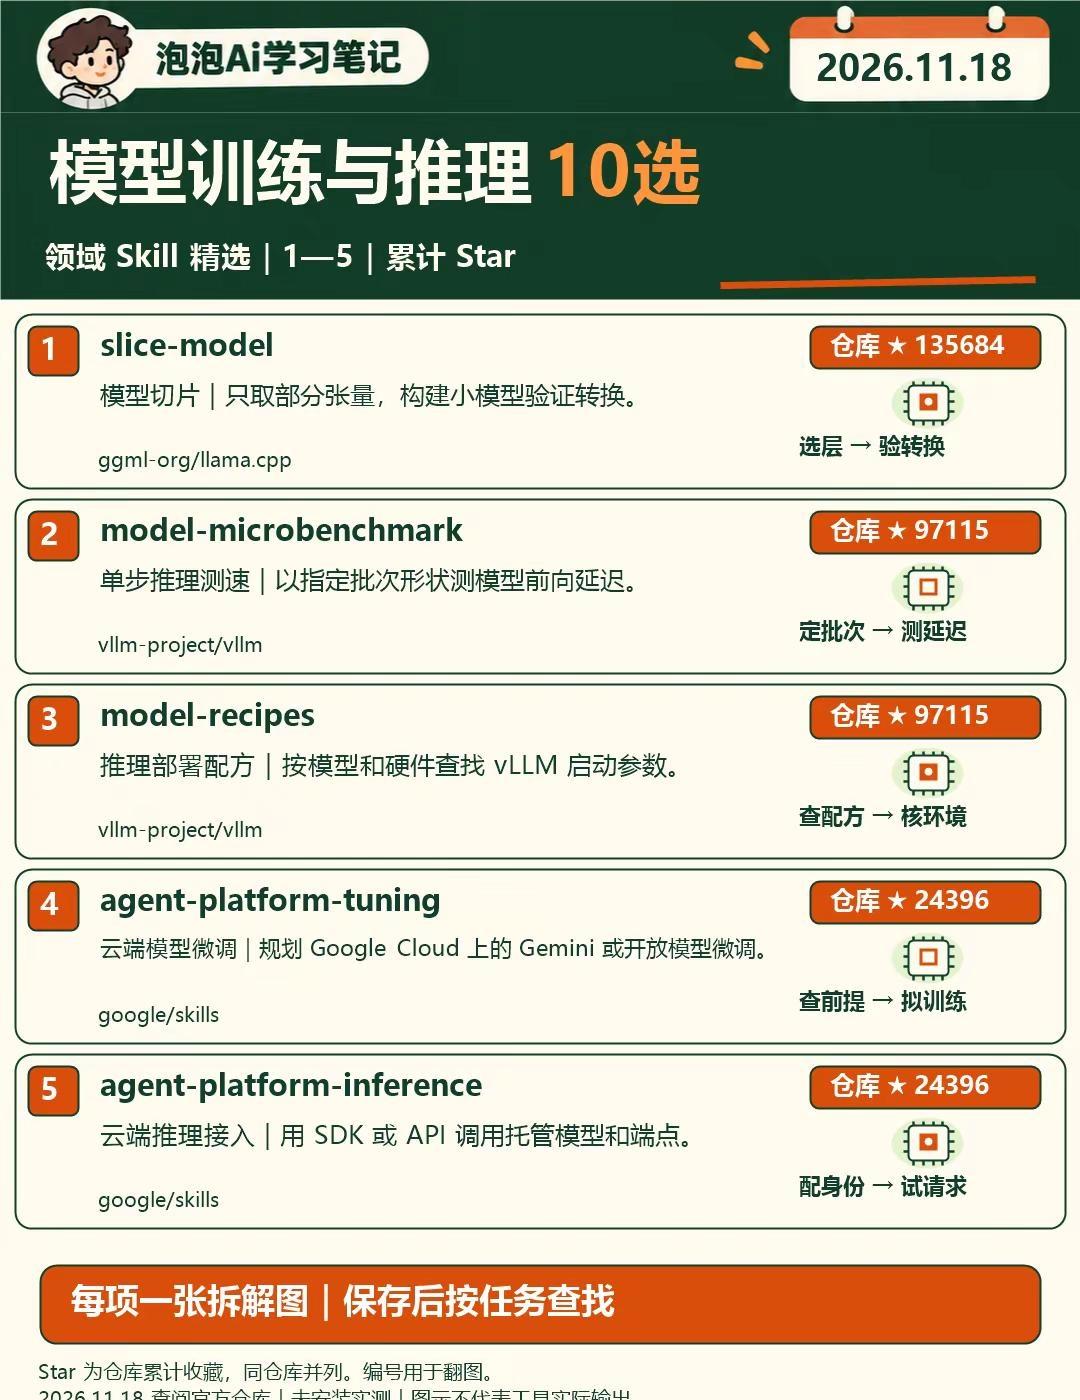
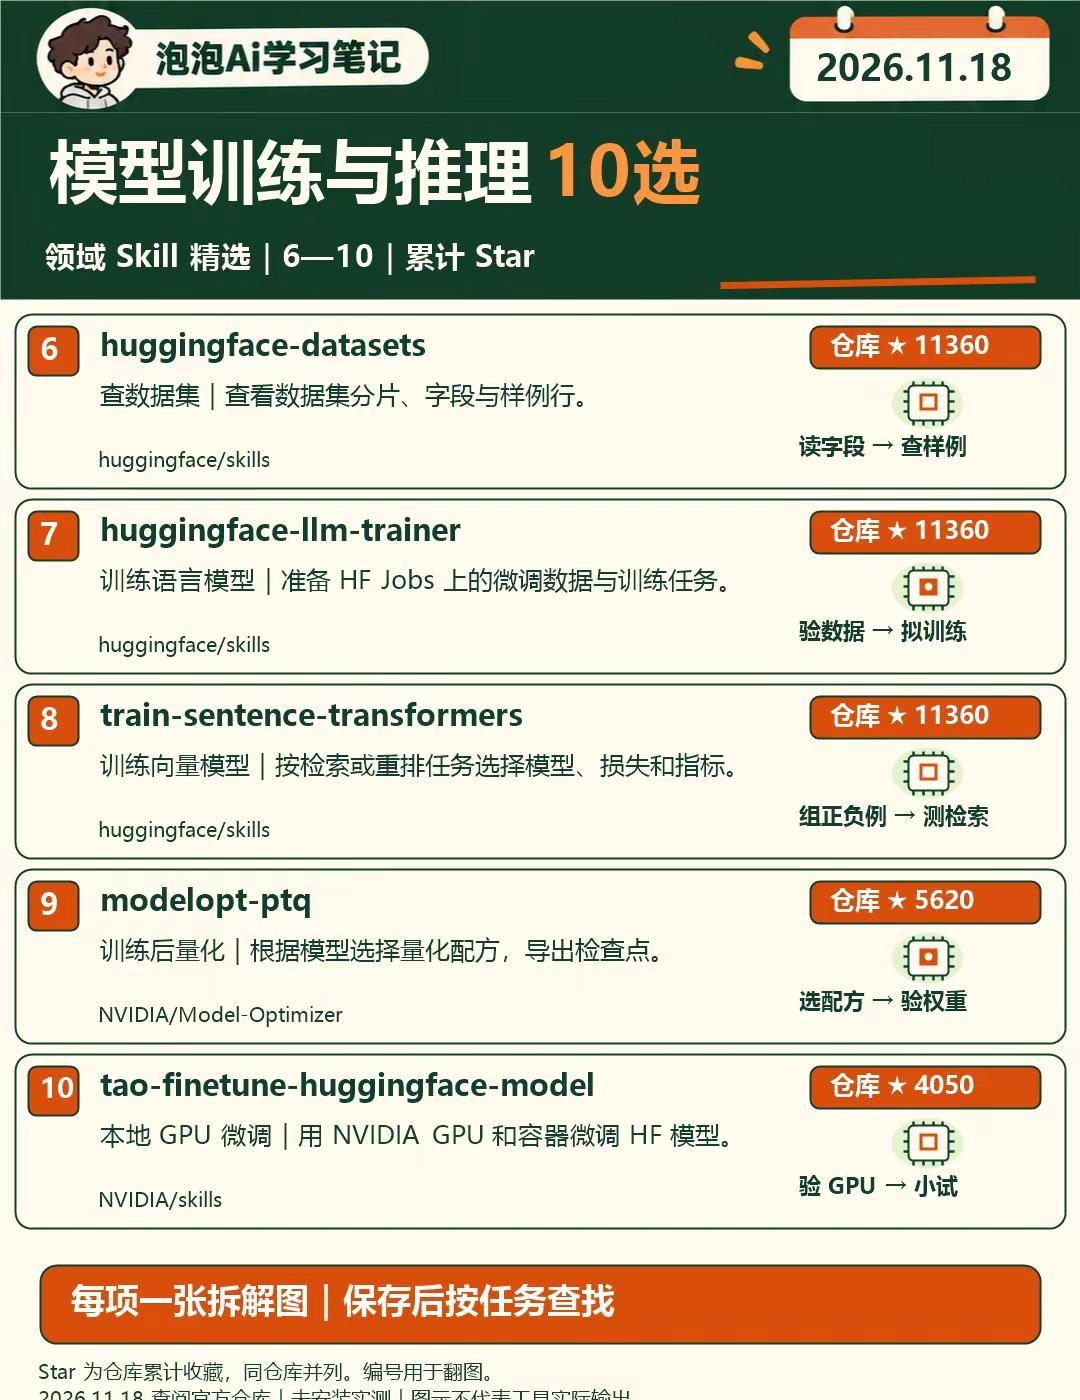
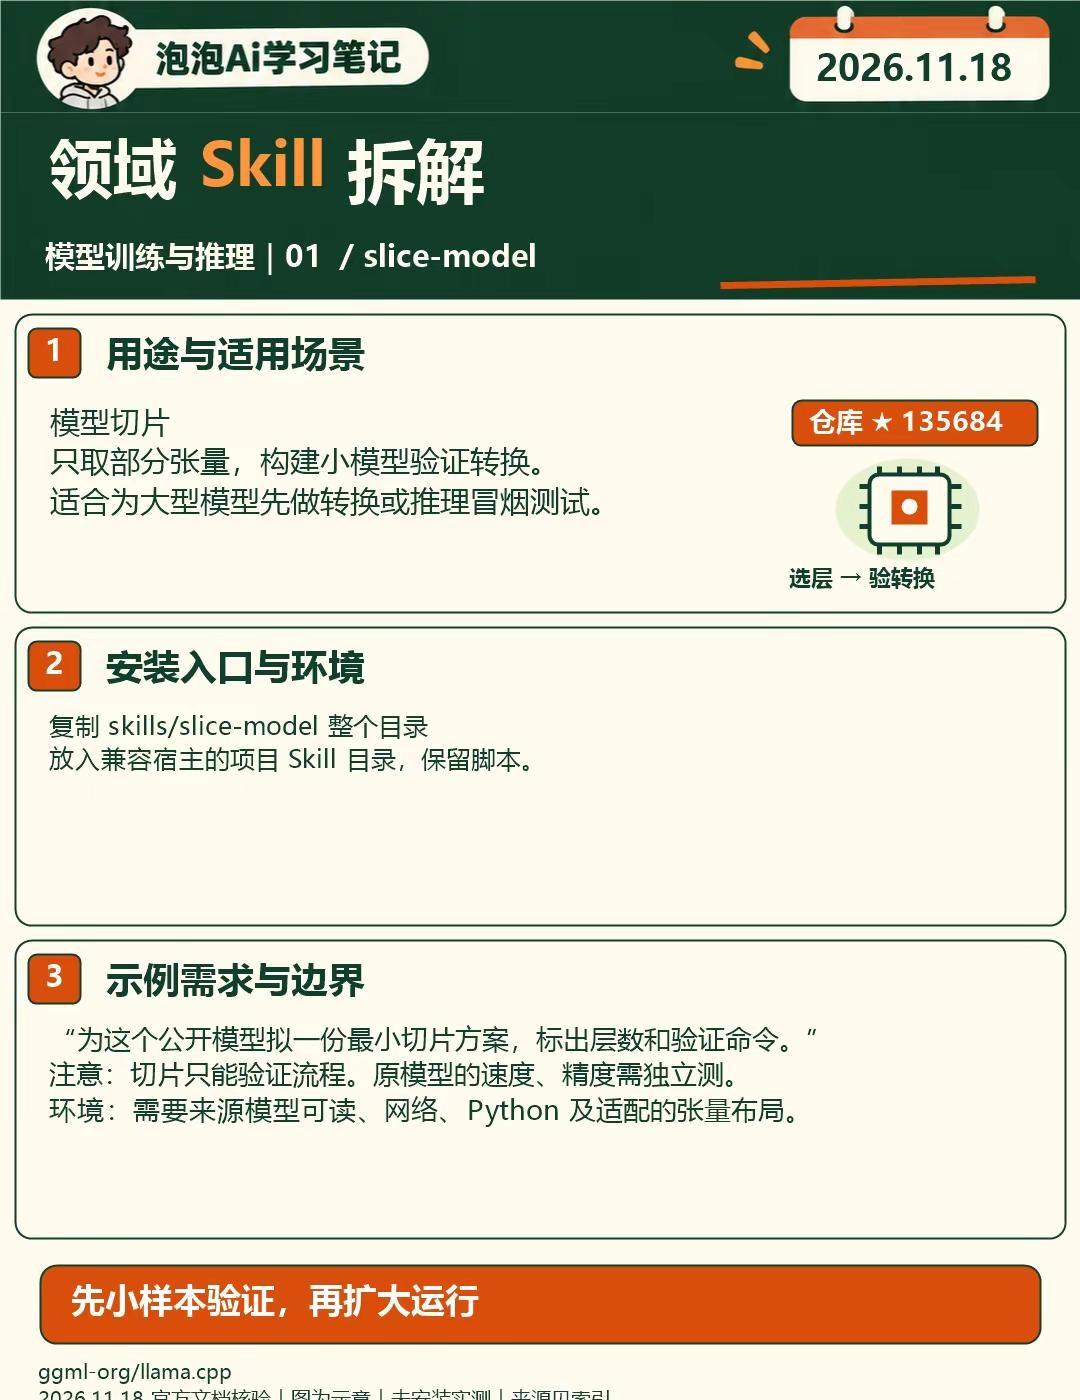
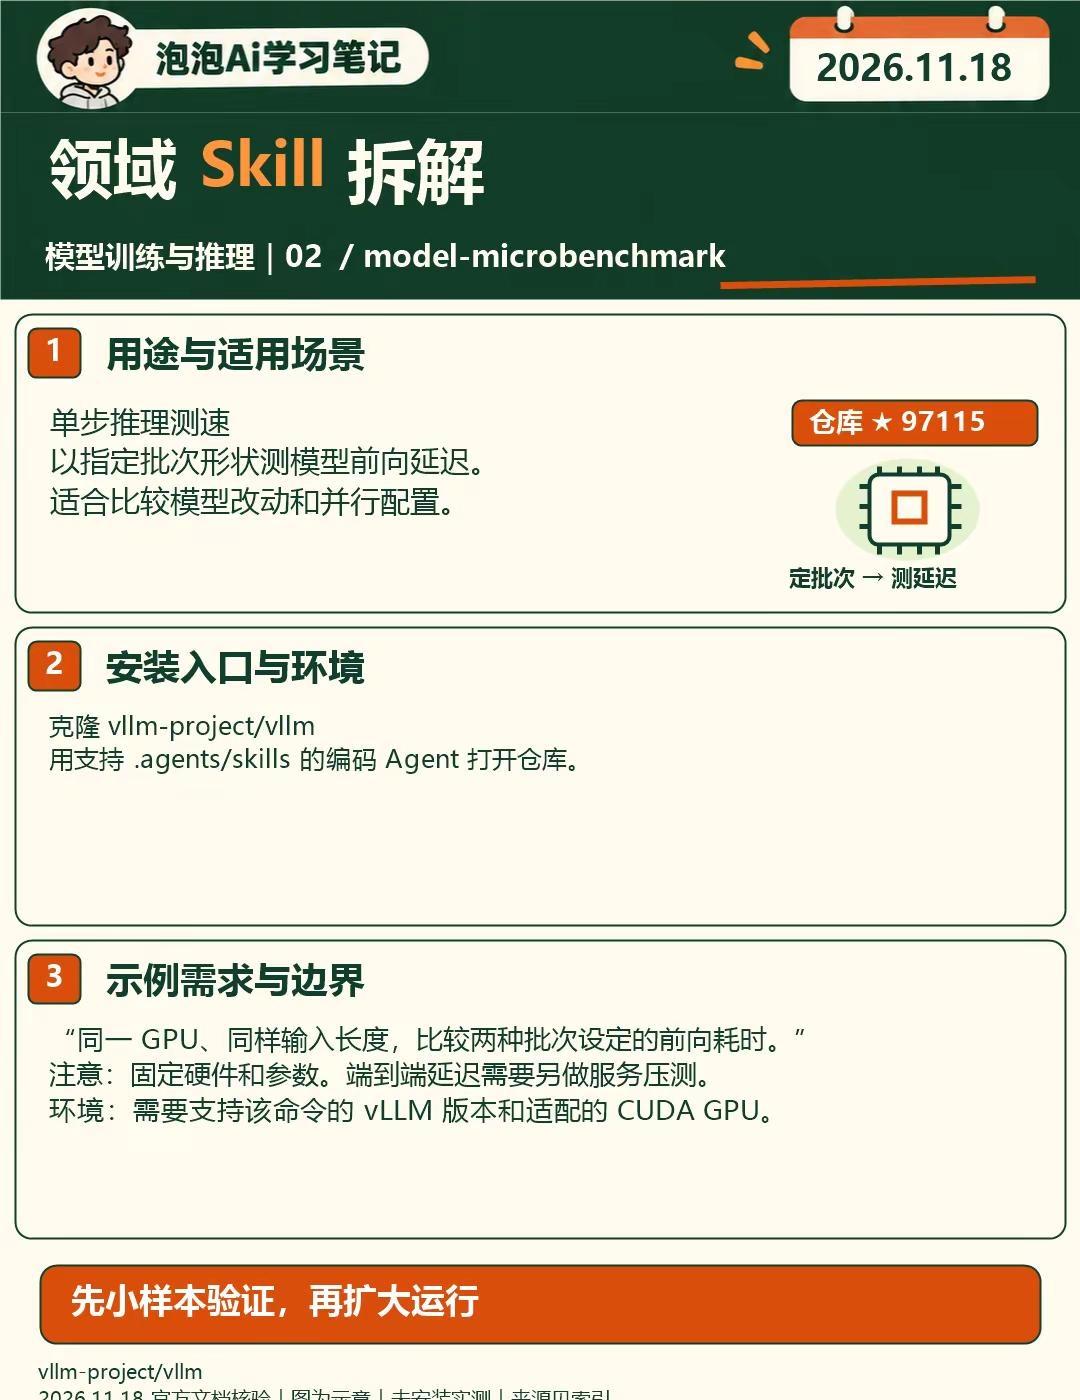
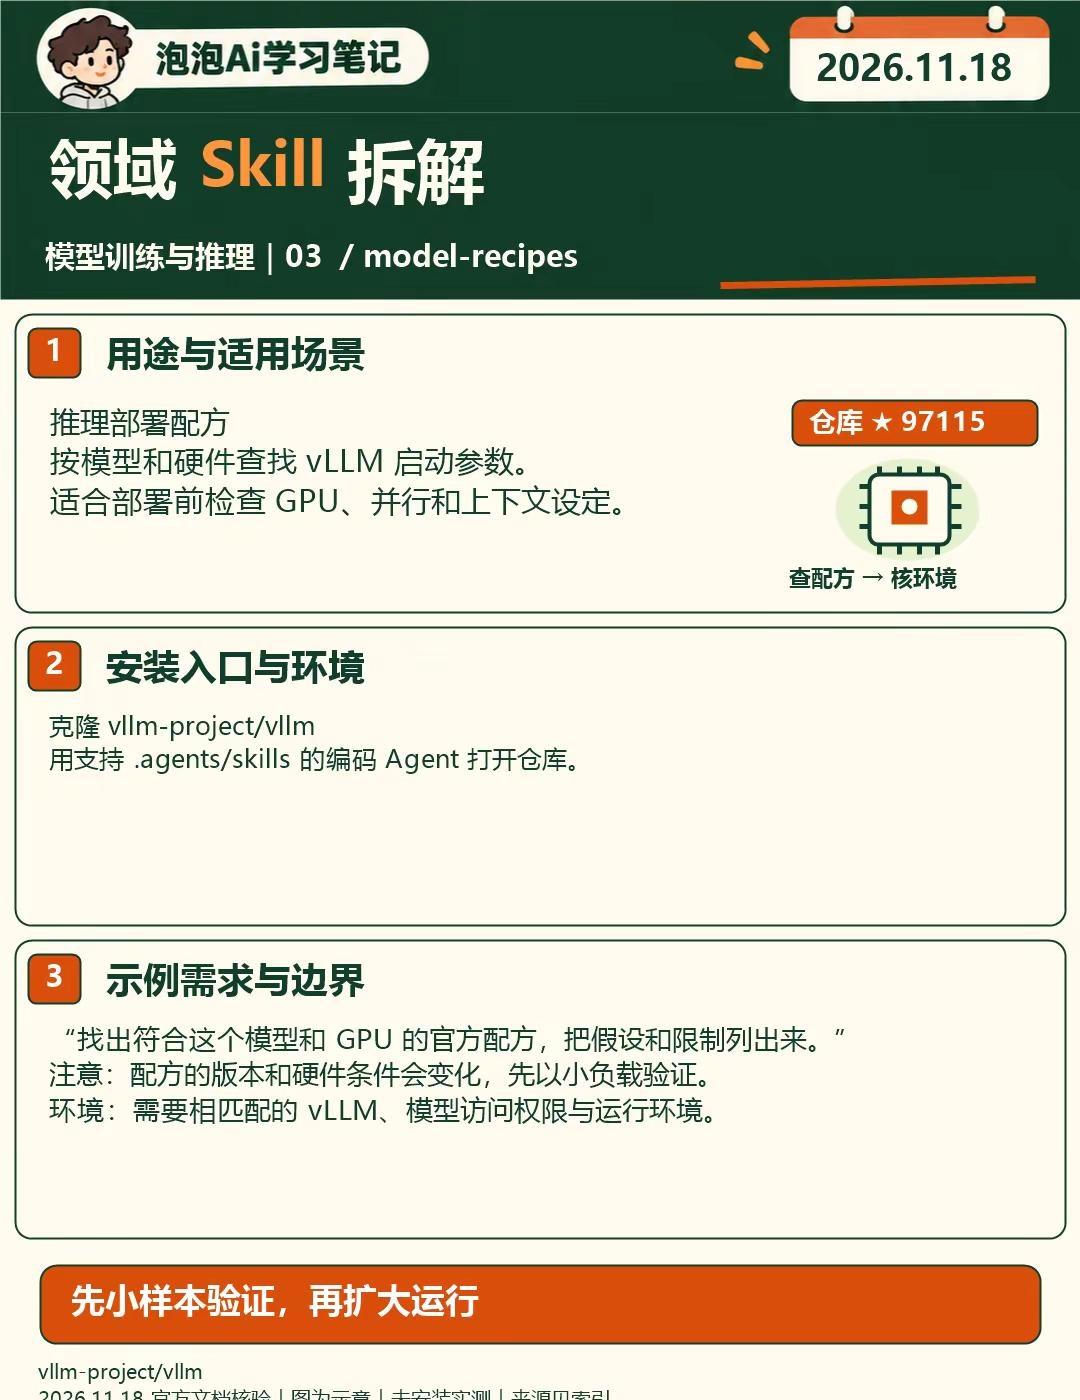
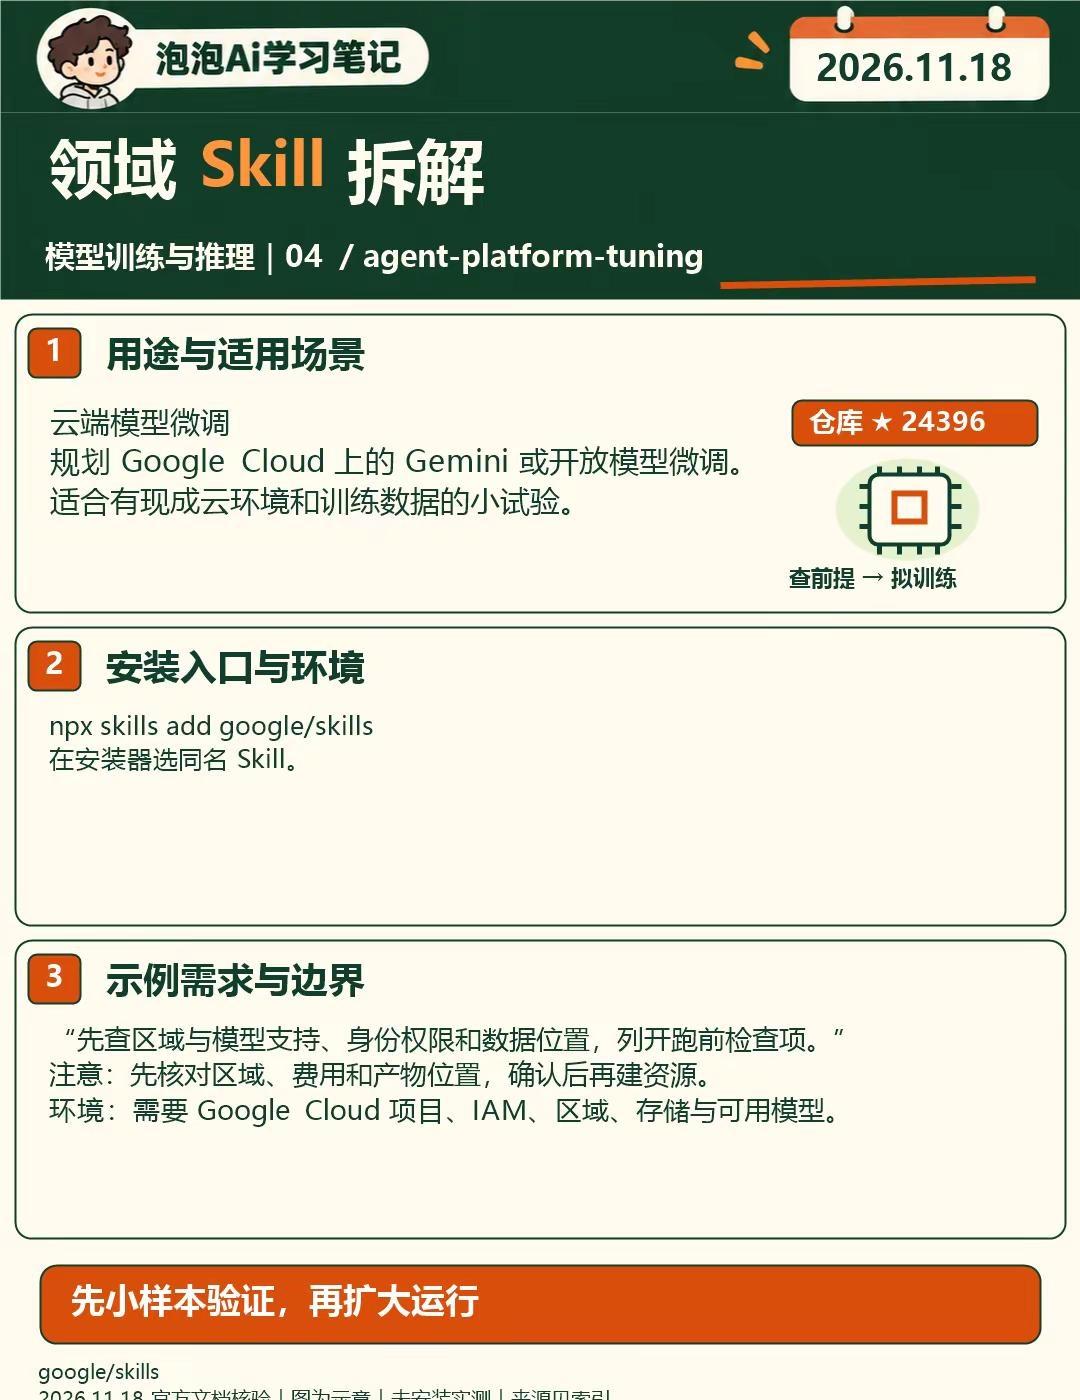
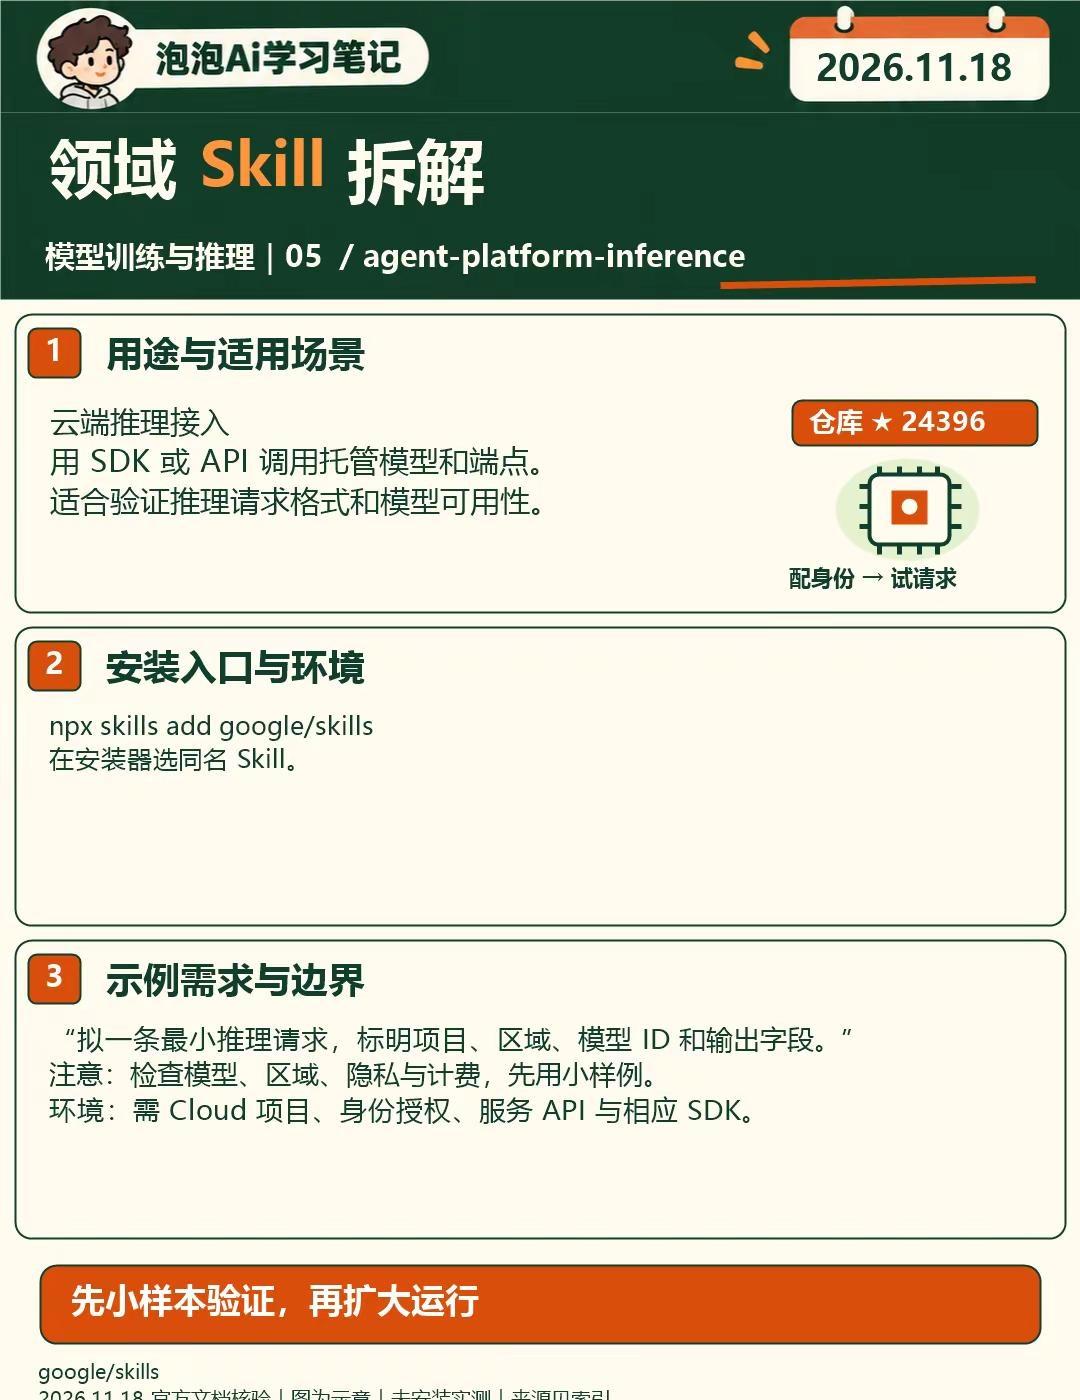
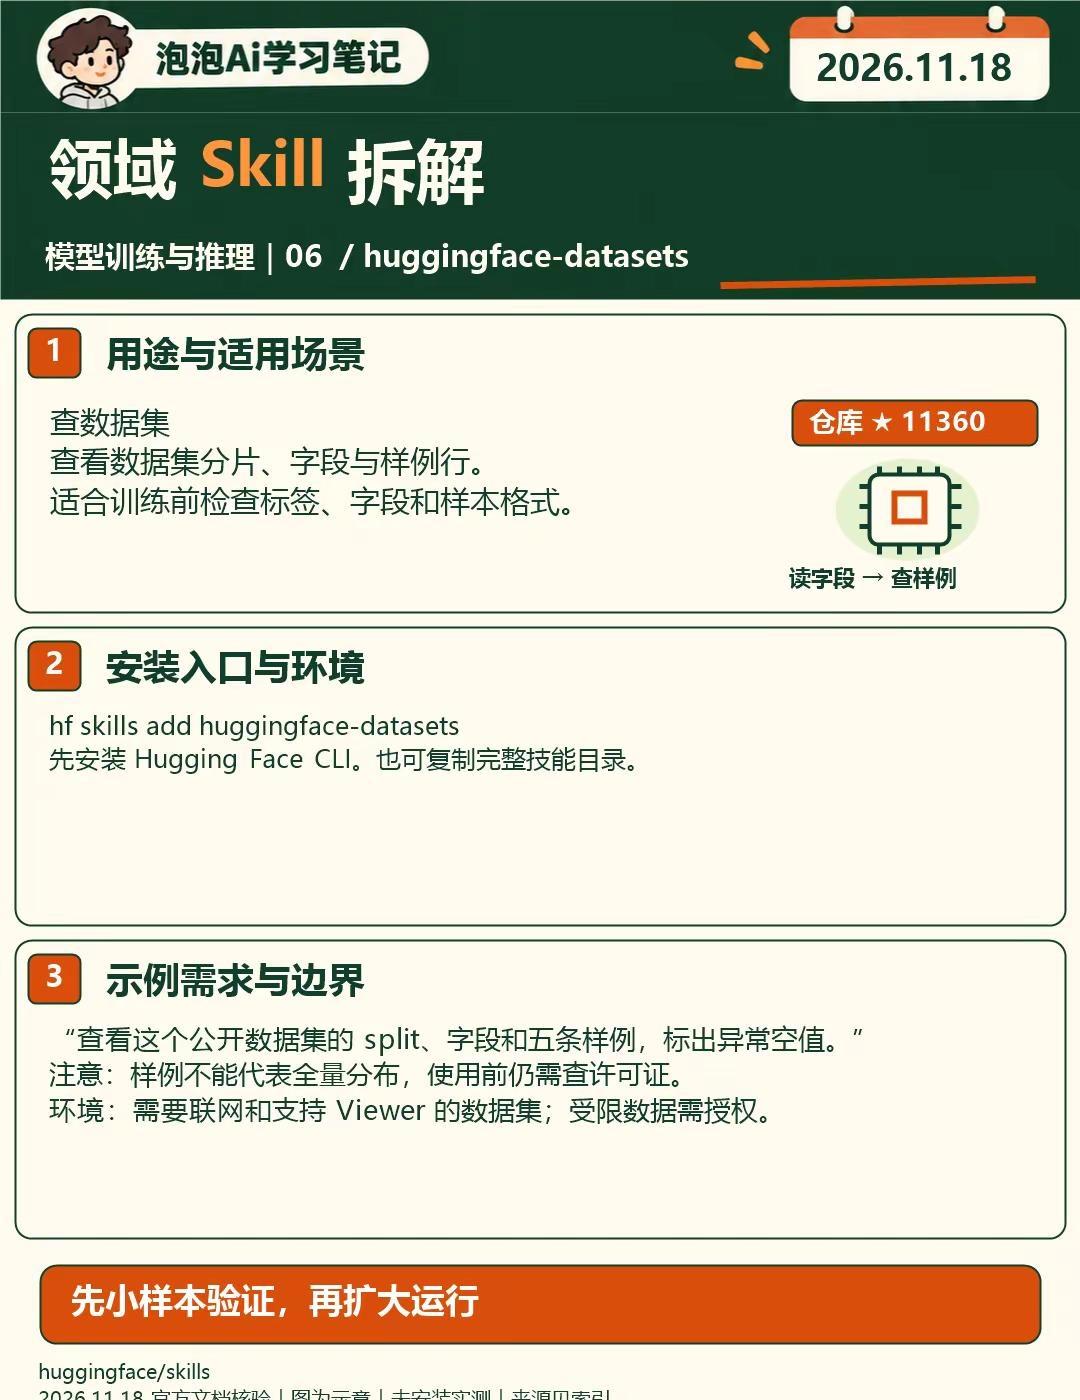
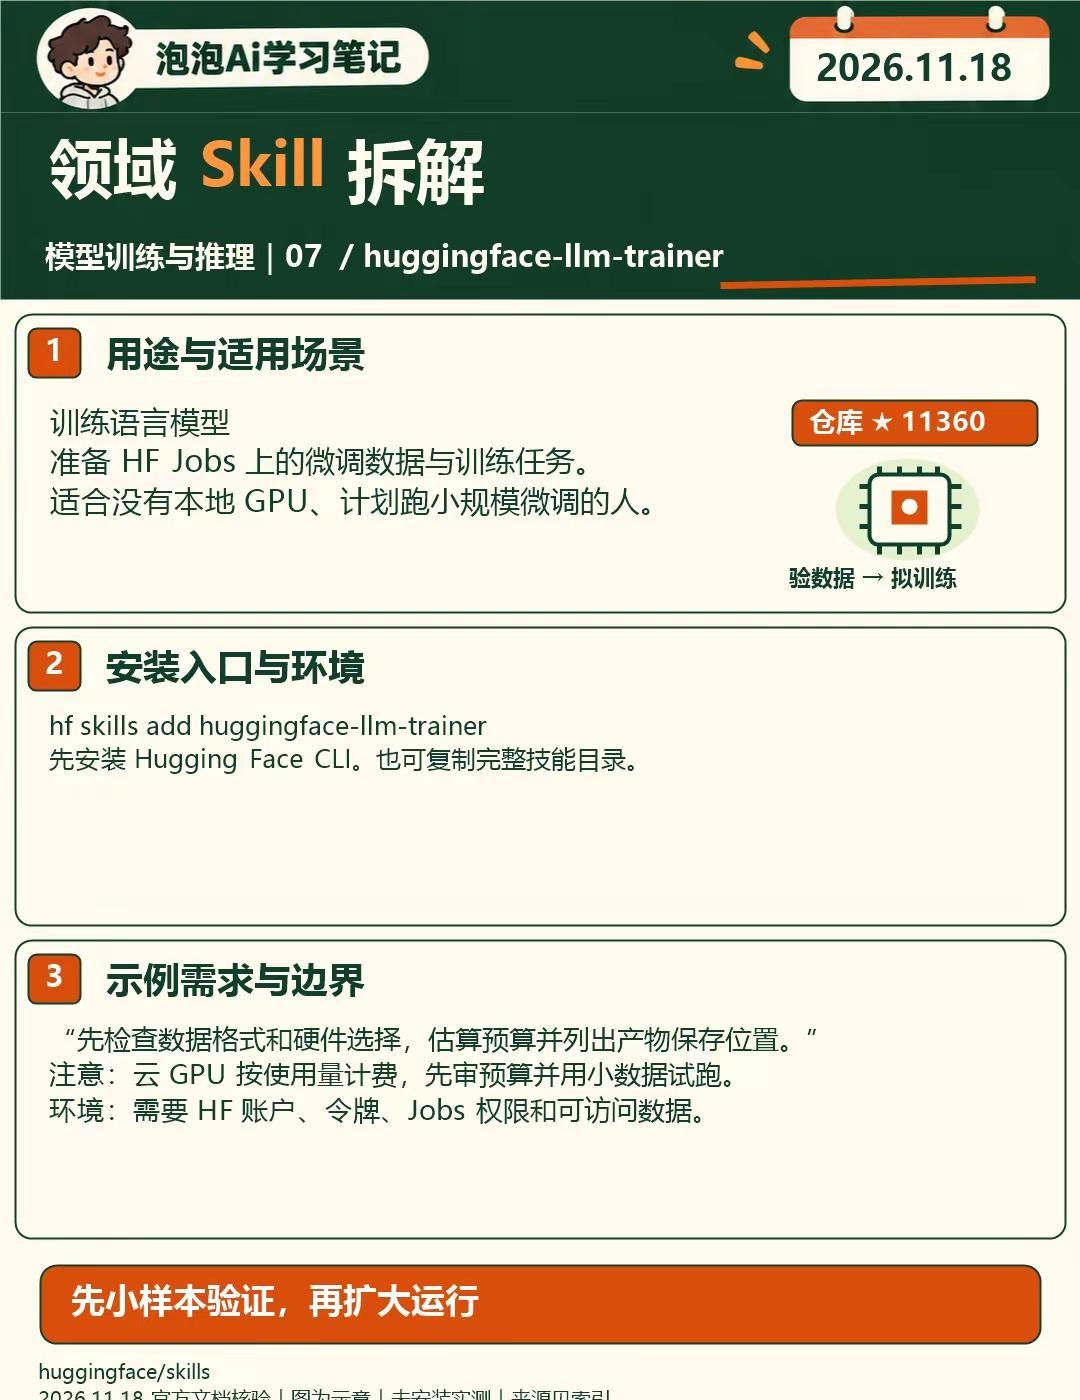
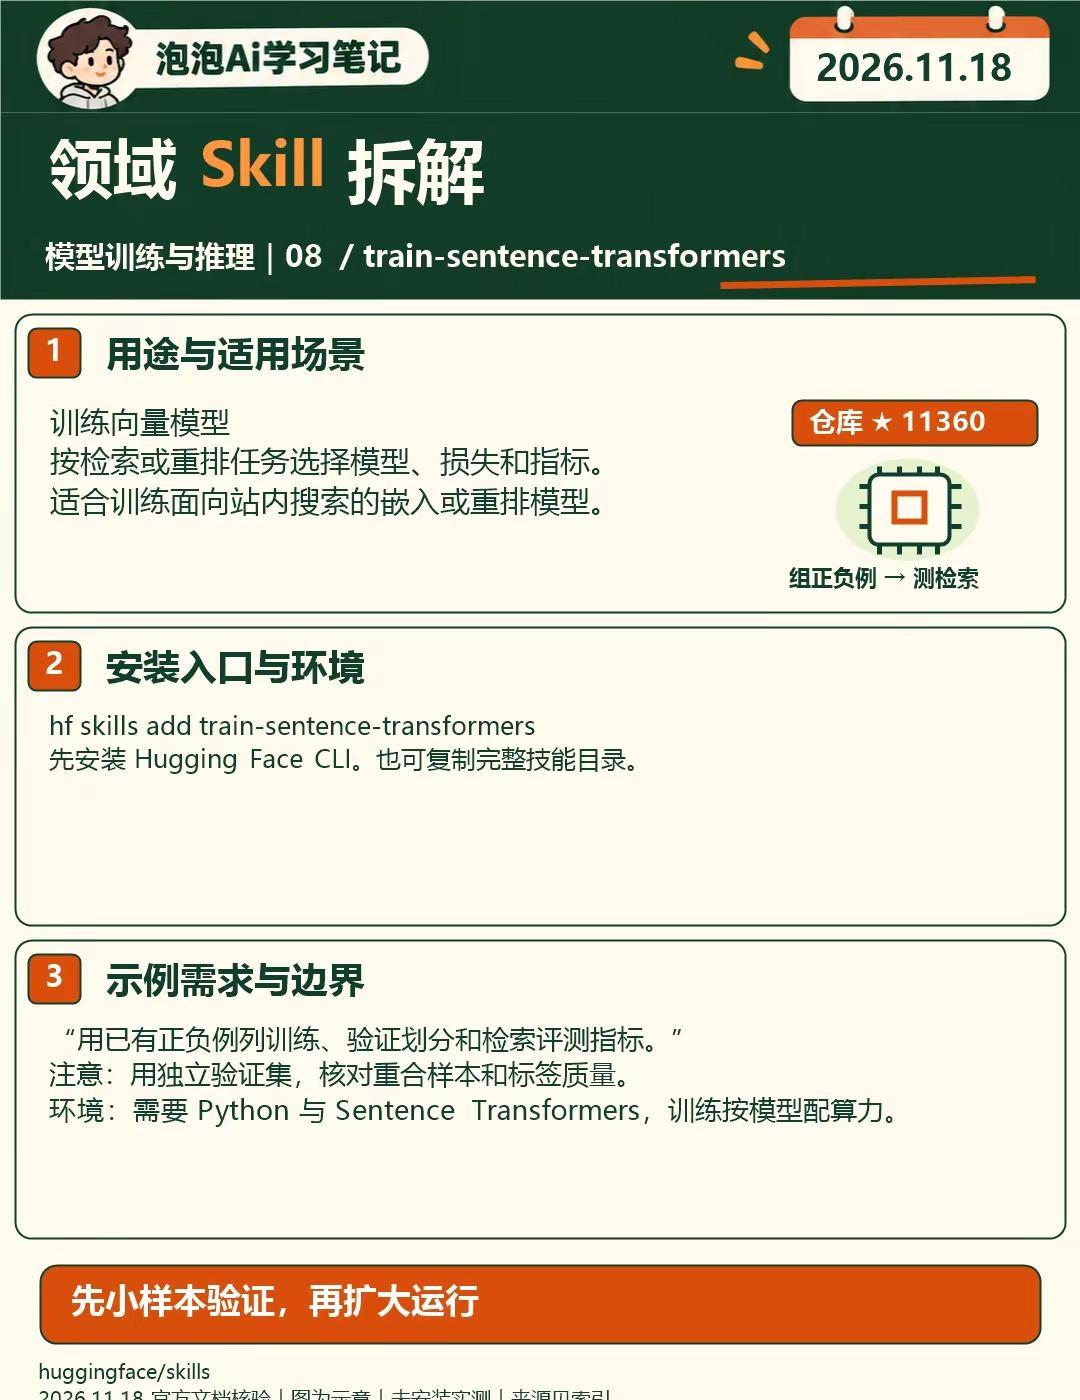
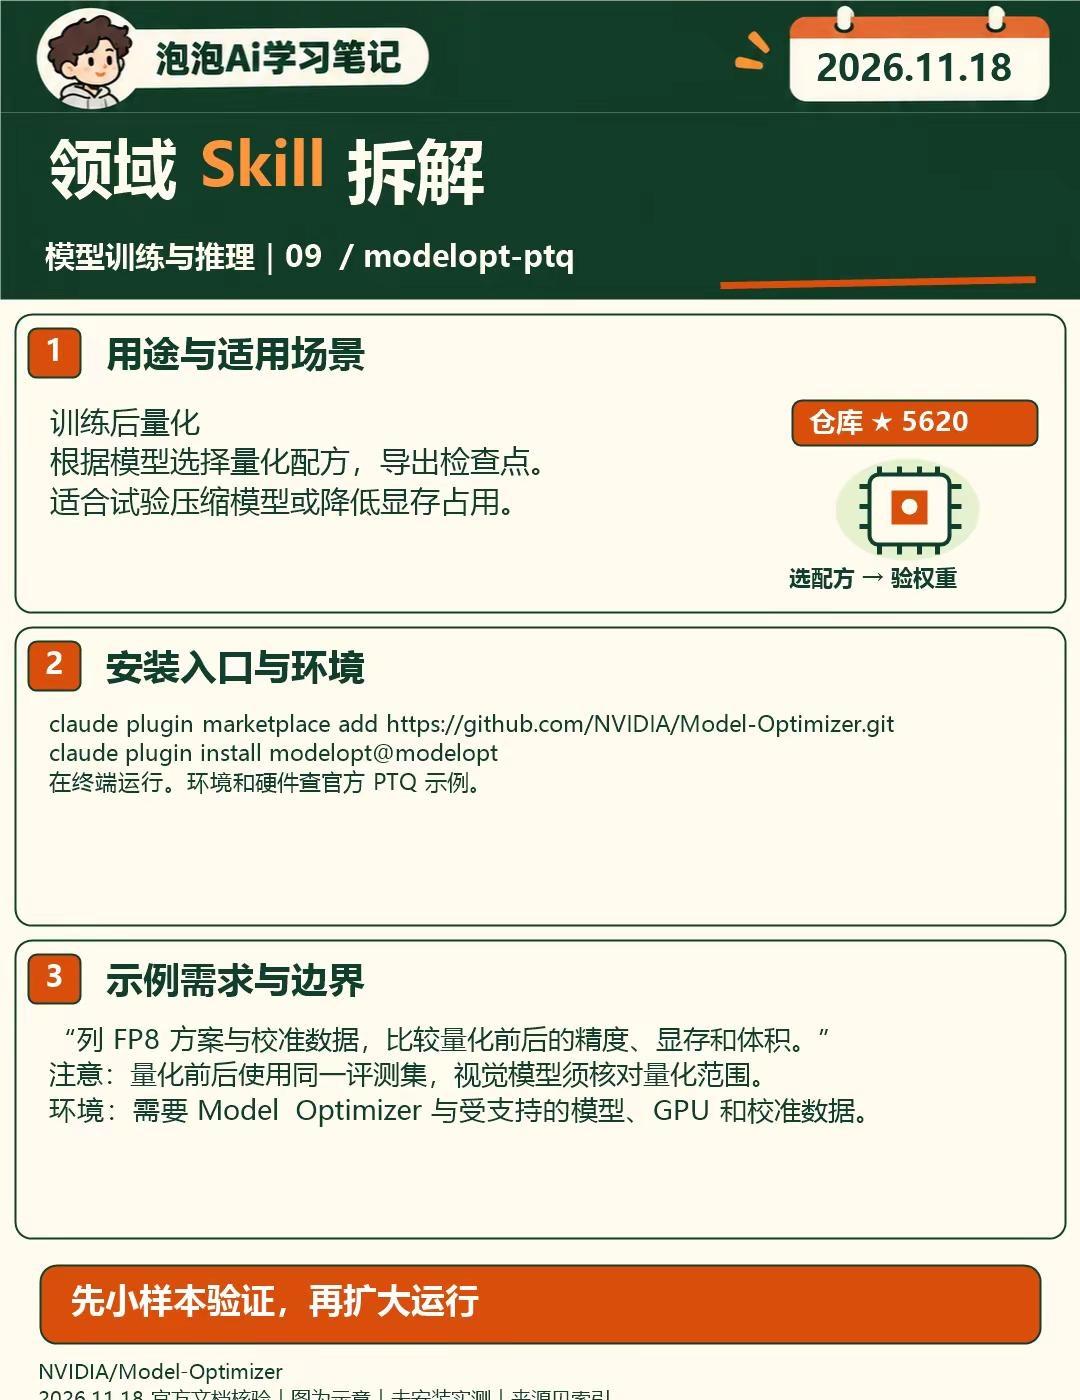
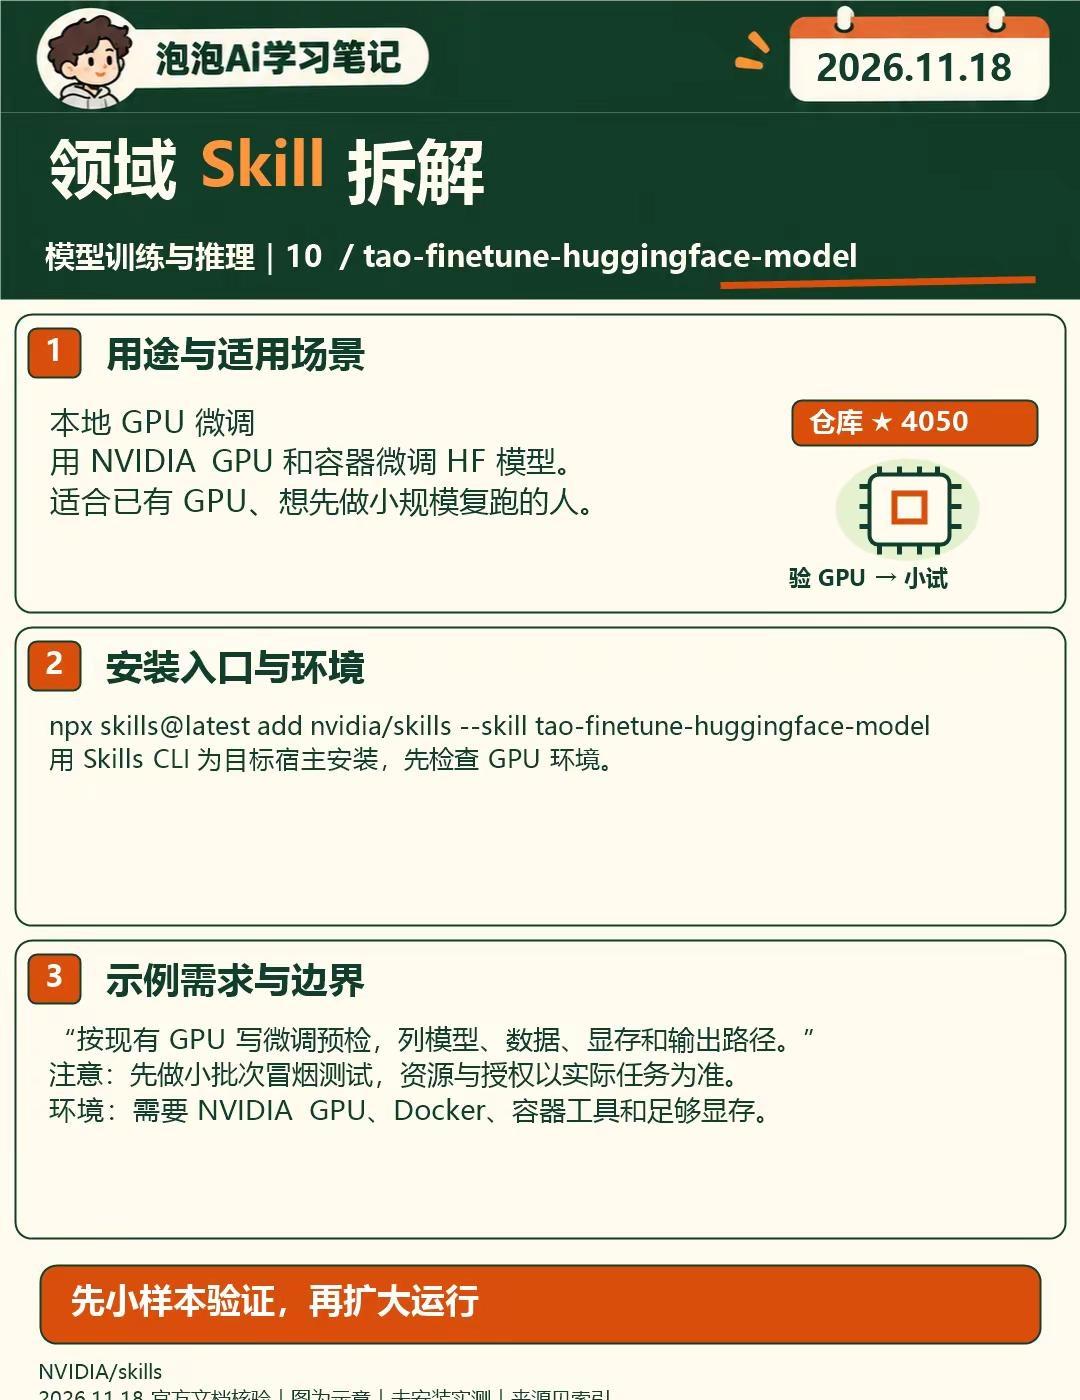
模型训练与推理丨10大高收藏Skill.模型能下载,不代表能顺利开跑。训练前查数据和权限,部署前查硬件与参数,改完还要测速度和精度。这期把这些任务拆给 10 个 GitHub Skill。【图 1|先搭流程、查部署条件】01 slice-model|只取部分张量,构建小模型验证转换。02 model-microbenchmark|以指定批次形状测模型前向延迟。03 model-recipes|按模型和硬件查找 vLLM 启动参数。04 agent-platform-tuning|规划 Google Cloud 上的 Gemini 或开放模型微调。05 agent-platform-inference|用 SDK 或 API 调用托管模型和端点。【图 2|检查数据、训练和量化】06 huggingface-datasets|查看数据集分片、字段与样例行。07 huggingface-llm-trainer|准备 HF Jobs 上的微调数据与训练任务。08 train-sentence-transformers|按检索或重排任务选择模型、损失和指标。09 modelopt-ptq|根据模型选择量化配方,导出检查点。10 tao-finetune-huggingface-model|用 NVIDIA GPU 和容器微调 HF 模型。试试这句:「比较量化前后的模型。用同一批样例、同一张 GPU,分别记录准确率、显存和输出体积。先给方案,确认后再跑。」跑在云上的训练或推理,要先核对账户权限和预算。11 月 18 日按相关候选仓库累计 Star 排序,同仓库的 Skill 共享 Star。安装、依赖与使用边界见逐项拆解,本期未本地安装实测。GitHub ai gpt codex