惊世!Gpt6.2的具身仿真/真机测试出炉
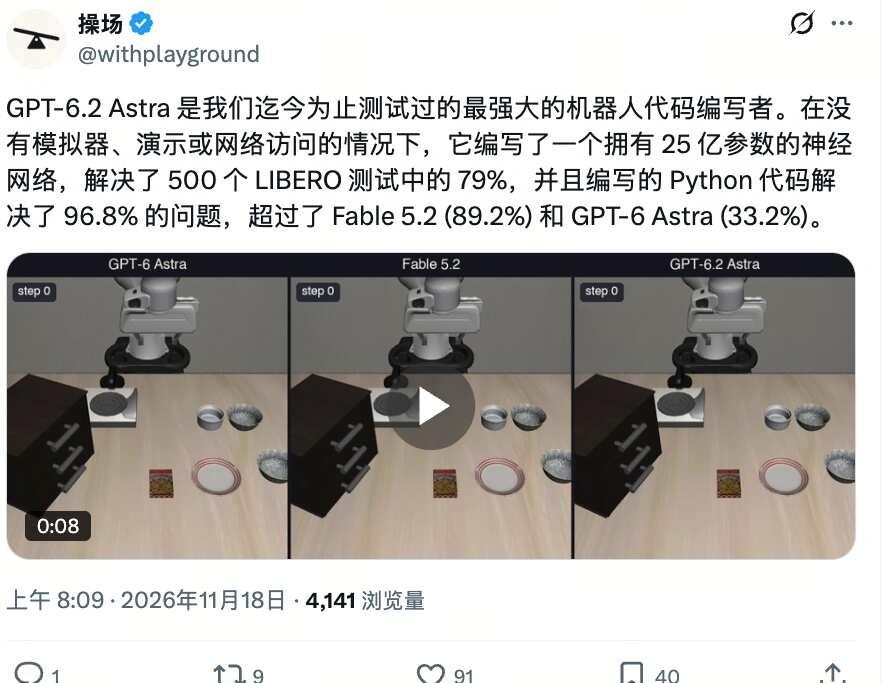
GPT-6.2 Astra发布后,不出所料[吐舌],睡醒一觉,两套互不相关、不同团队做的评测便先后出炉。
一个在仿真里考"LLM写一次策略",一个把真机械臂交给模型现场指挥——方法完全不同,结论却收敛到同一处。
🔬 实验一|方法:把"写一次"和"实时开"放进同一考场(Ishan Nagpal 博客)
▪️产物两种:代码策略 / 小型神经网络(27层、约19.1万非零参数)
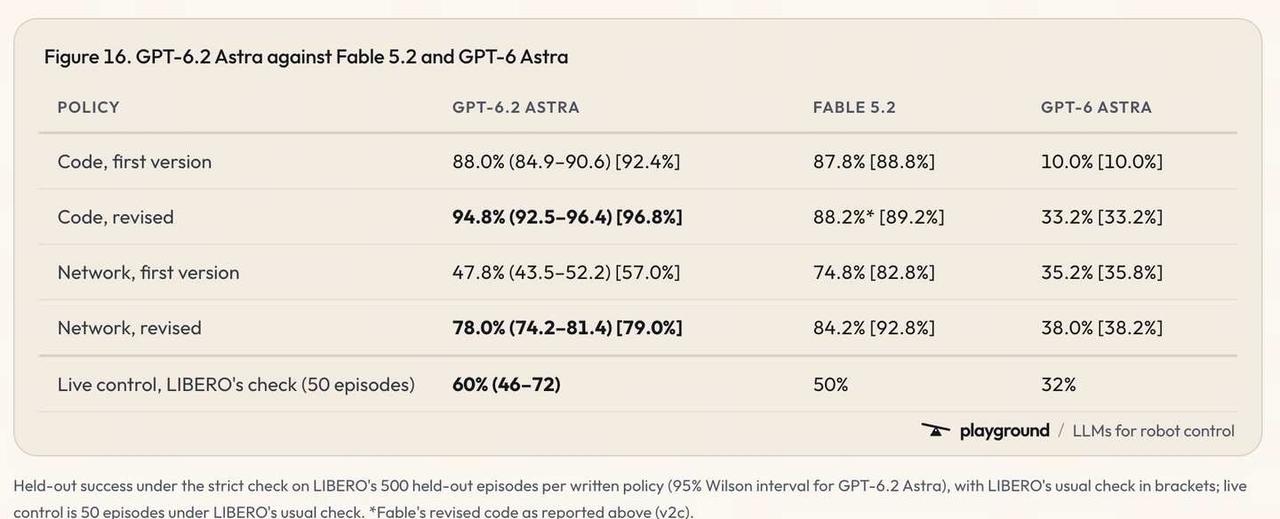
▪️流程:冷启动写初版→只看20条开发rollout→只许改一次→冻结→LIBERO 500个留出场景评分(严格判分,[ ]内为官方判分)
▪️防作弊:逐行审查模型跑过的每个脚本、每条命令,四个策略全部通过,确认没有在测试集上循环拟合
▪️控件:除模型外一切相同——房间、提示词、环境、评分器;同一个LLM还要实时开机器人50场景做对照
📊 实验一结果
▪️写代码:GPT-6.2 **94.8%[96.8%]** > Fable 88.2% > 上代GPT-6 33.2%(修订只改了酒架一题:14/50→48/50)
▪️写网络:Fable 84.2%[92.8%] 仍最强,GPT-6.2 为 78.0%[79.0%]
▪️实时遥控:GPT-6.2 解决 30/50 破纪录(Fable 25、GPT-6 16)
▪️成本/成功:代码1.7美分、网络2.4美分、实时75美分——实时是代码的约43倍
🤖 实验二|方法:真机上的 Agent 闭环(AA-Robotics v0.1 · Artificial Analysis)
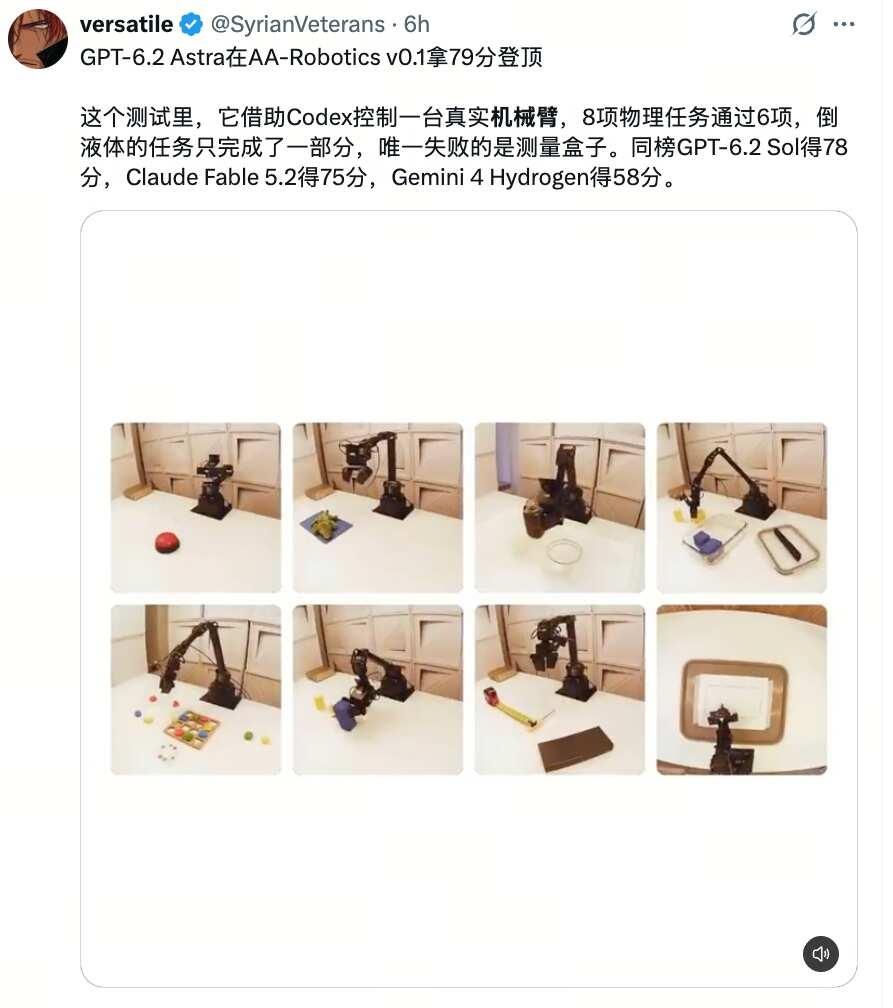
▪️硬件:Hiwonder NexArm 五关节机械臂+夹爪,4路相机(桌边3台+腕部1台)
▪️闭环:Codex读任务→看画面→写代码→HTTP指挥机械臂→每步后可再观察→自行决定继续调整还是提交,裁判按最终状态打分(每题100分、允许部分得分)
▪️任务谱系刻意分轴考:长程(四块积木收盒+盖平盖子)、稳定性(塔独立站住且达最大高度)、精细(倒饮料不洒)、量化(尺寸精确到2mm)
📊 实验二结果
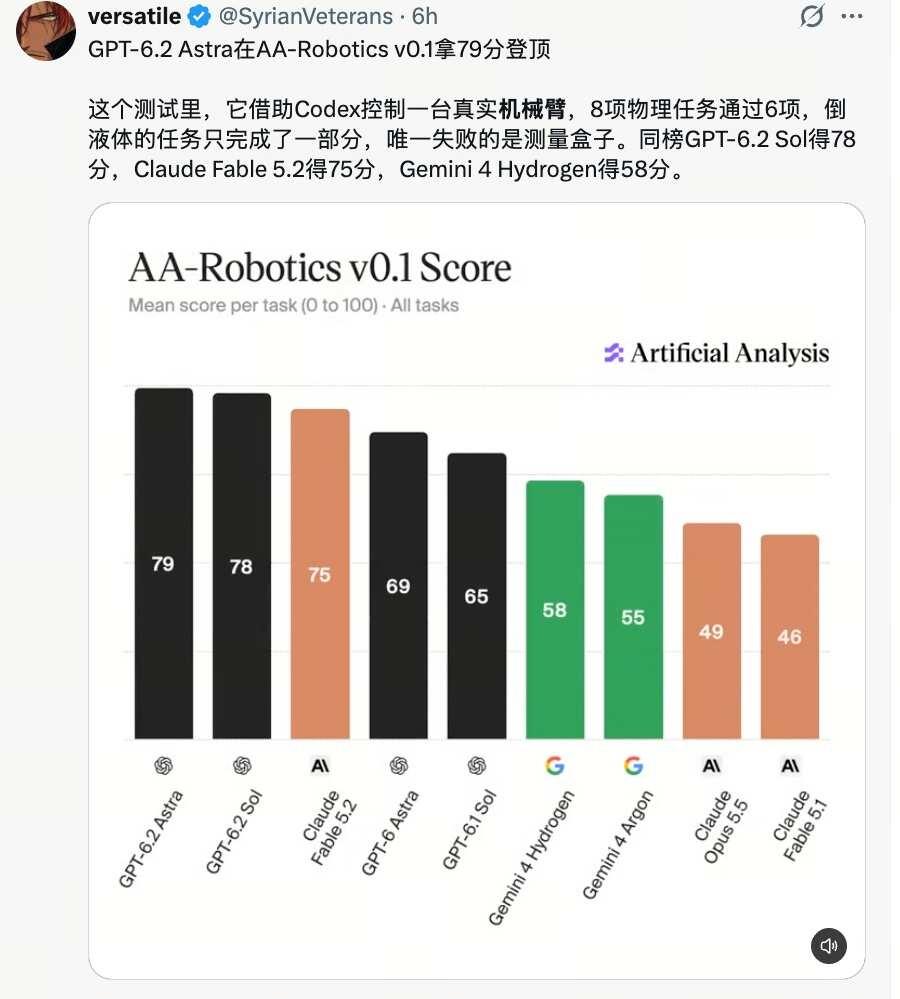
▪️GPT-6.2 Astra 79分登顶,8题过6(上代69.4;Fable 5.2 为75;同批Sol 78)
▪️高光:积木+盖子、搭塔全过👏;失手:倒饮料洒出、量尺寸。
具身智能 机器人 Gpt6.2 大模型