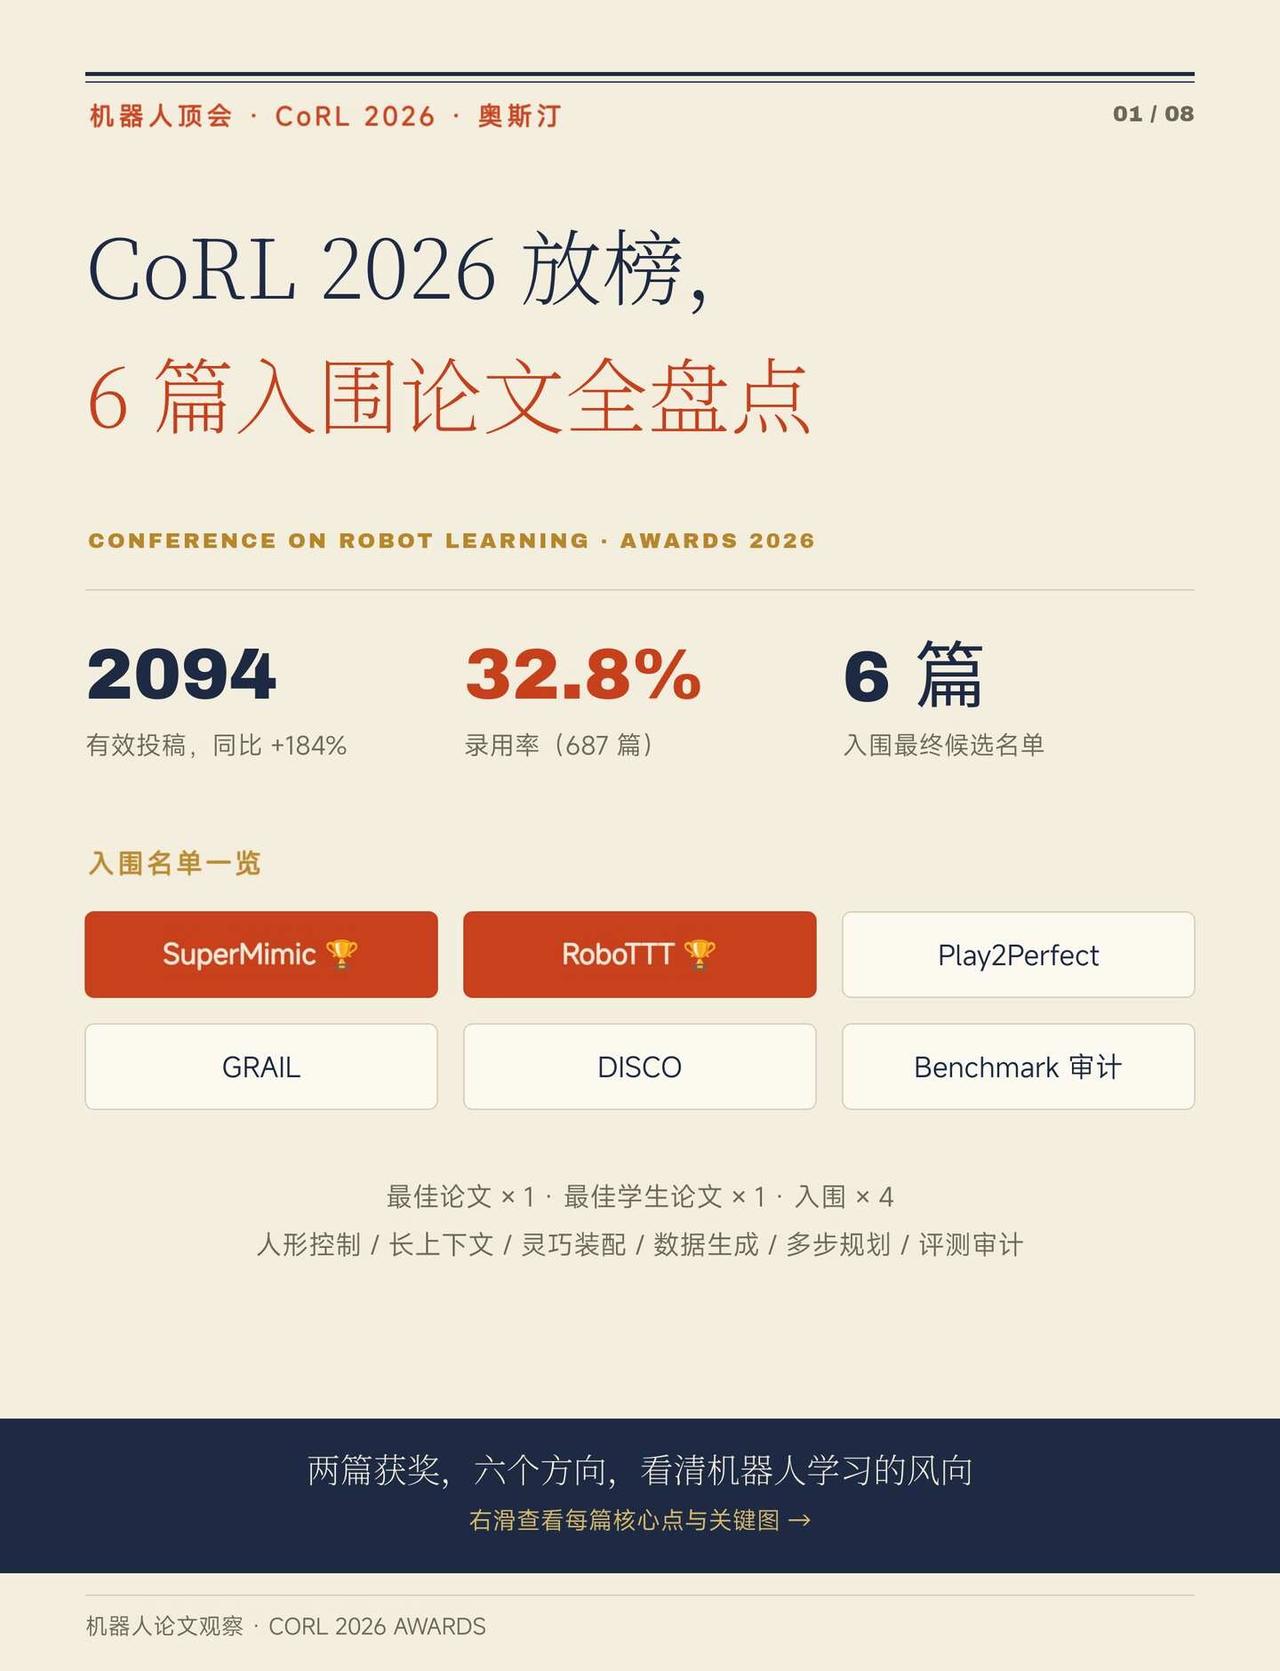
CoRL 2026 6篇获奖论文全拆解全盘点
看了下本届CoRL的获奖名单,基本就是未来1-2年具身智能的技术路线图。
6篇论文基本都奔着卡脖子问题去,废话不多说,下面👇🏻全部拆开
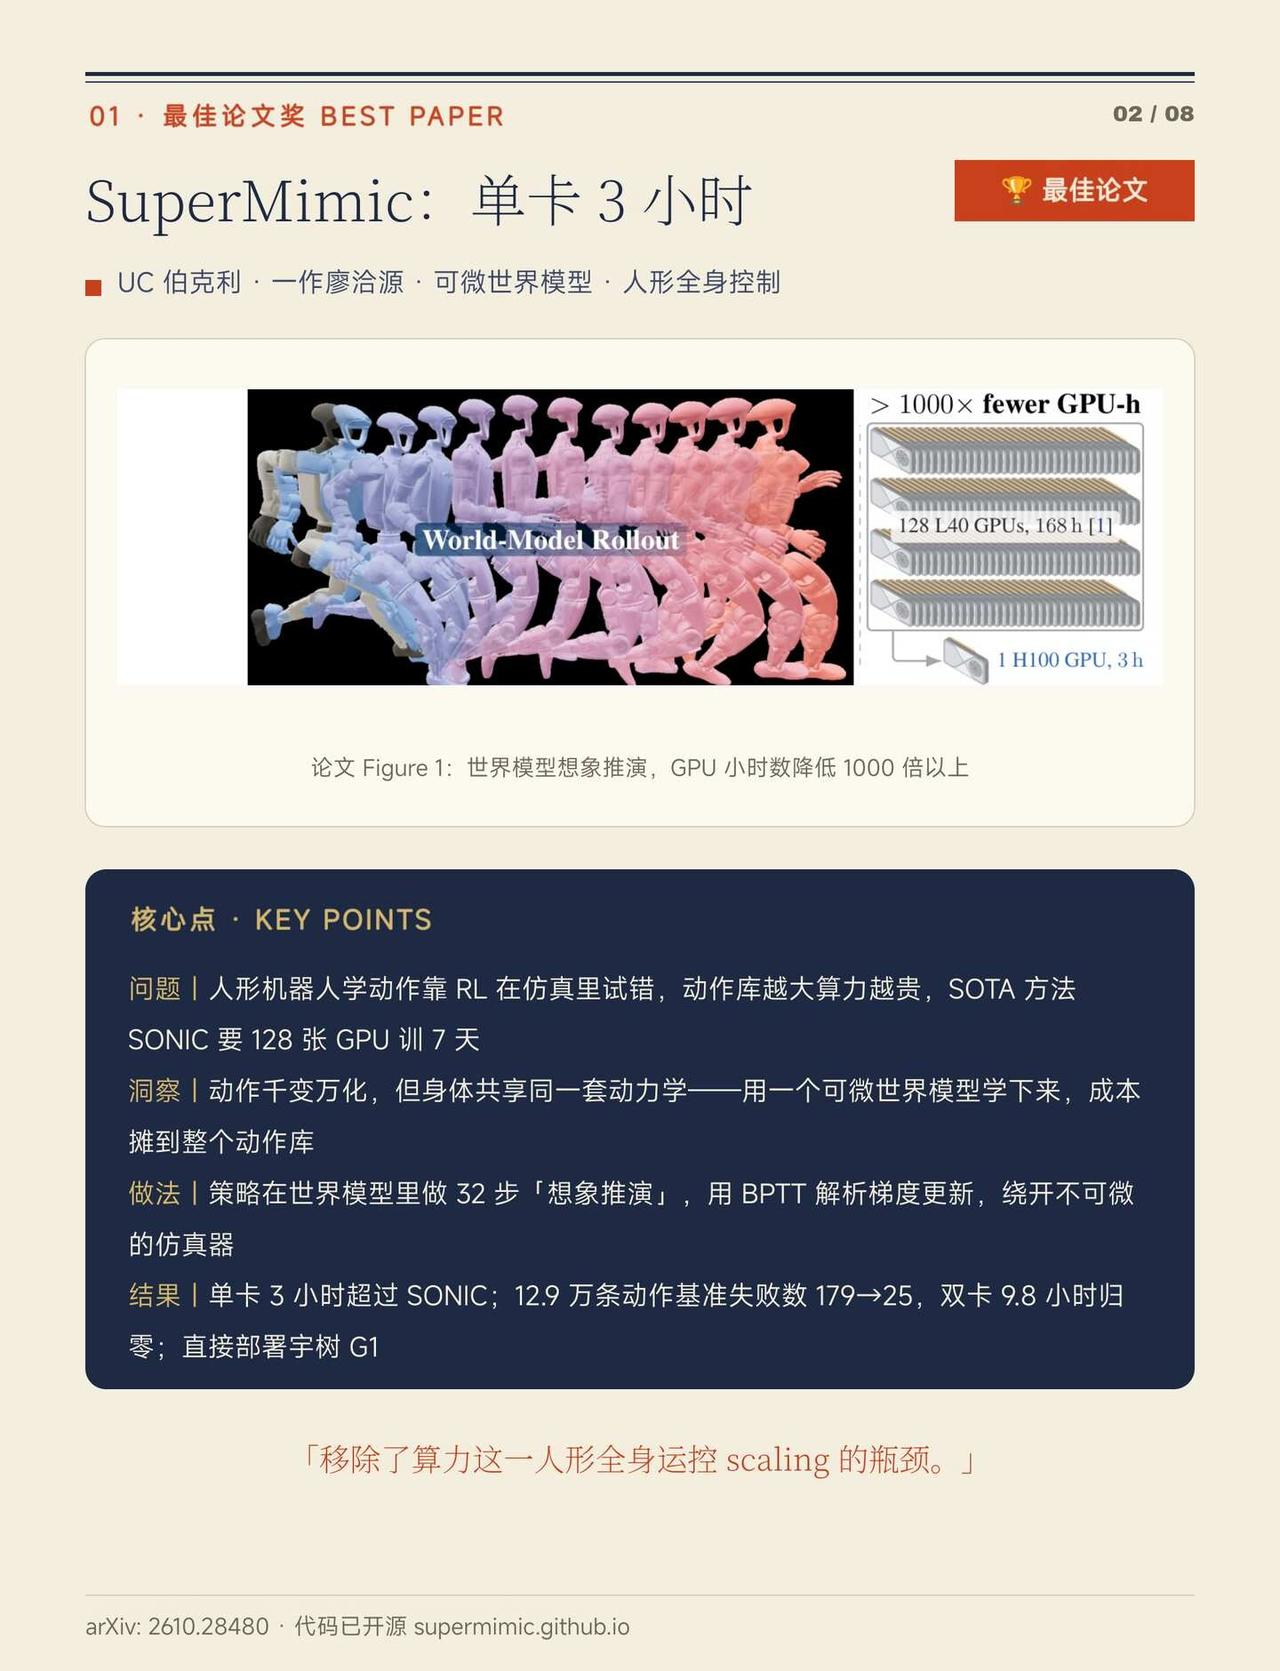
01 最佳论文|SuperMimic(UC伯克利)
人形全身控制强化学习算力成本极高,行业标杆方案需2.1万GPU小时。
用可微世界模型替代物理仿真器,策略在模型内“想象推演”,靠解析梯度更新参数。单卡H100训练3小时,性能超128卡L40训练7天的基线,算力骤降1000倍,失败动作大幅减少,直接打穿了人形训练的算力门槛。
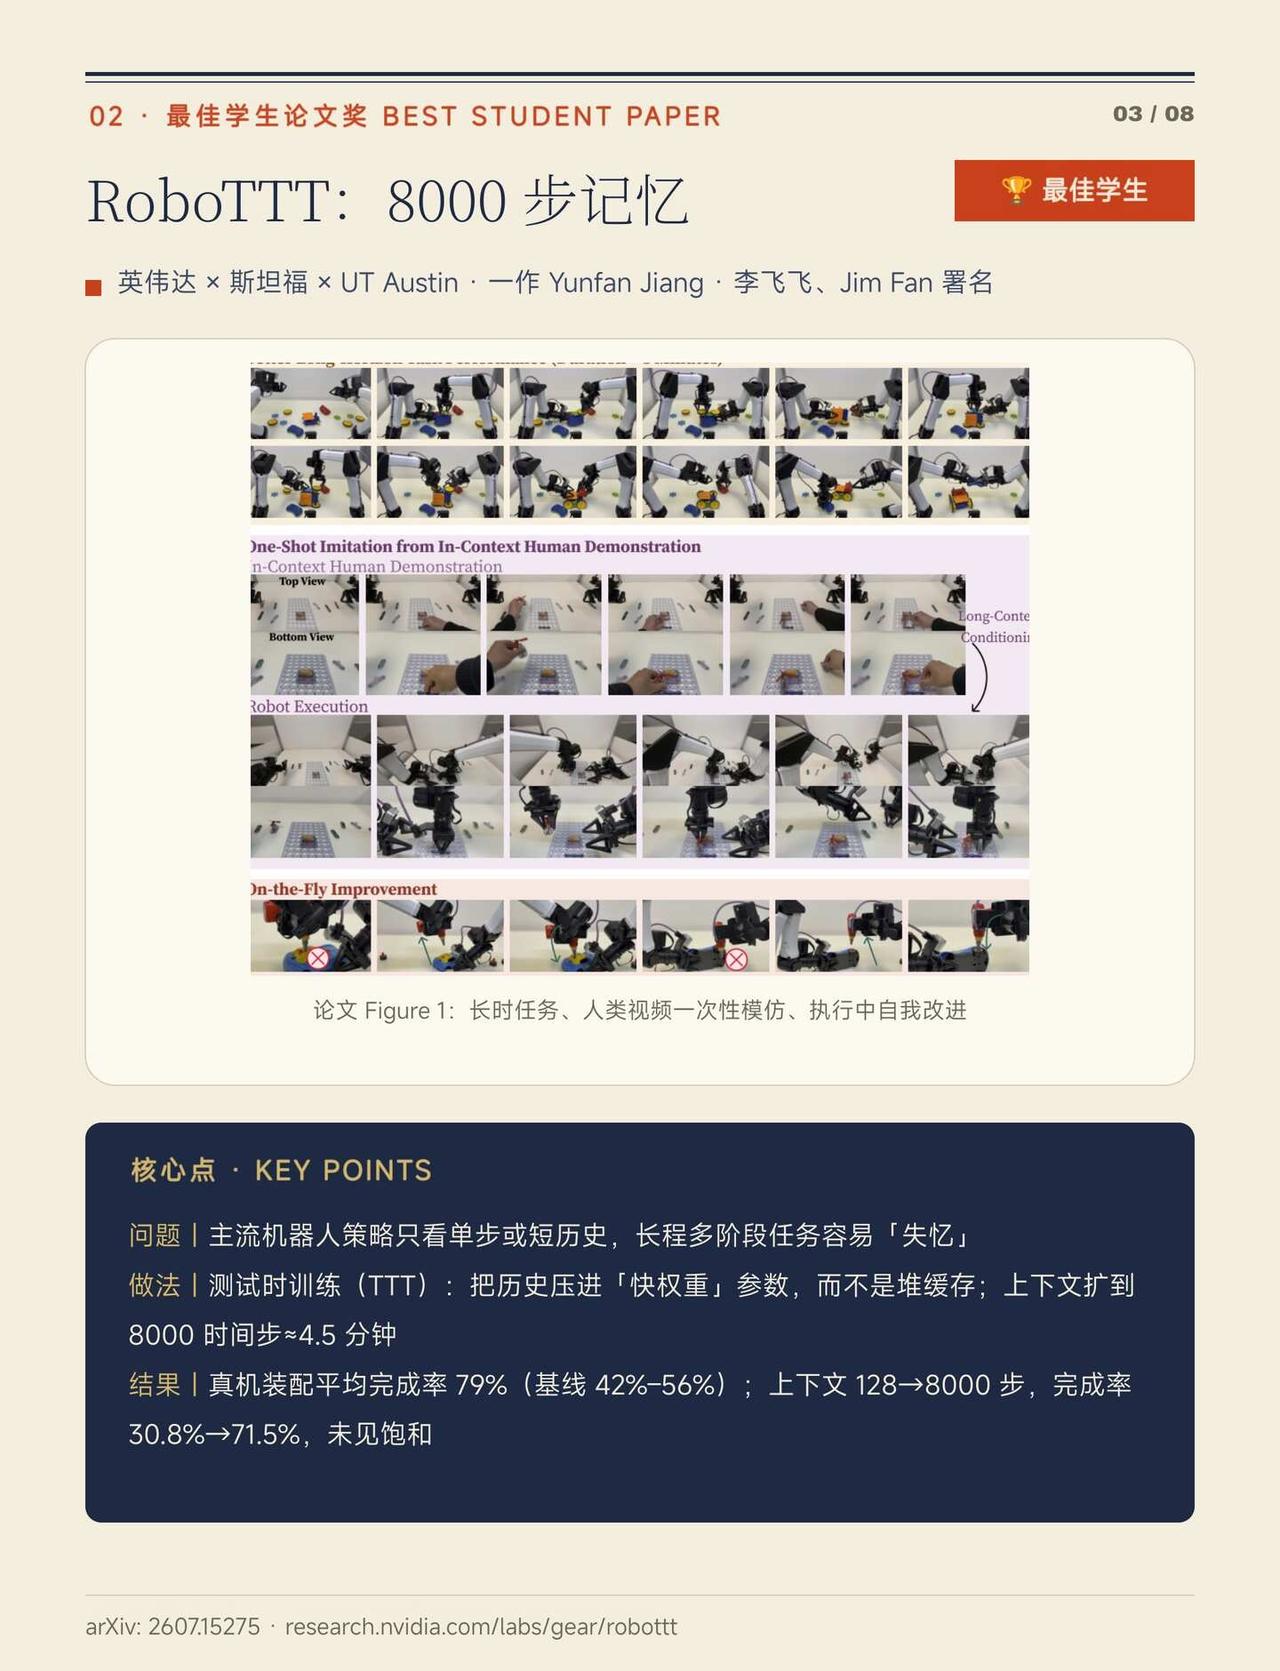
02 最佳学生论文|RoboTTT(英伟达+斯坦福等)
机器人长时序任务易失控,传统缓存方案延迟高、容量有天花板。
引入测试时训练+快权重机制,把历史观测直接写入模型参数。支持8000步超长上下文且延迟不随长度增长,真机装配任务完成率79%(单步基线仅42%),数据利用率是传统方案的3倍。WAM终于能扛长时序闭环,不用事事都靠System2重规划。
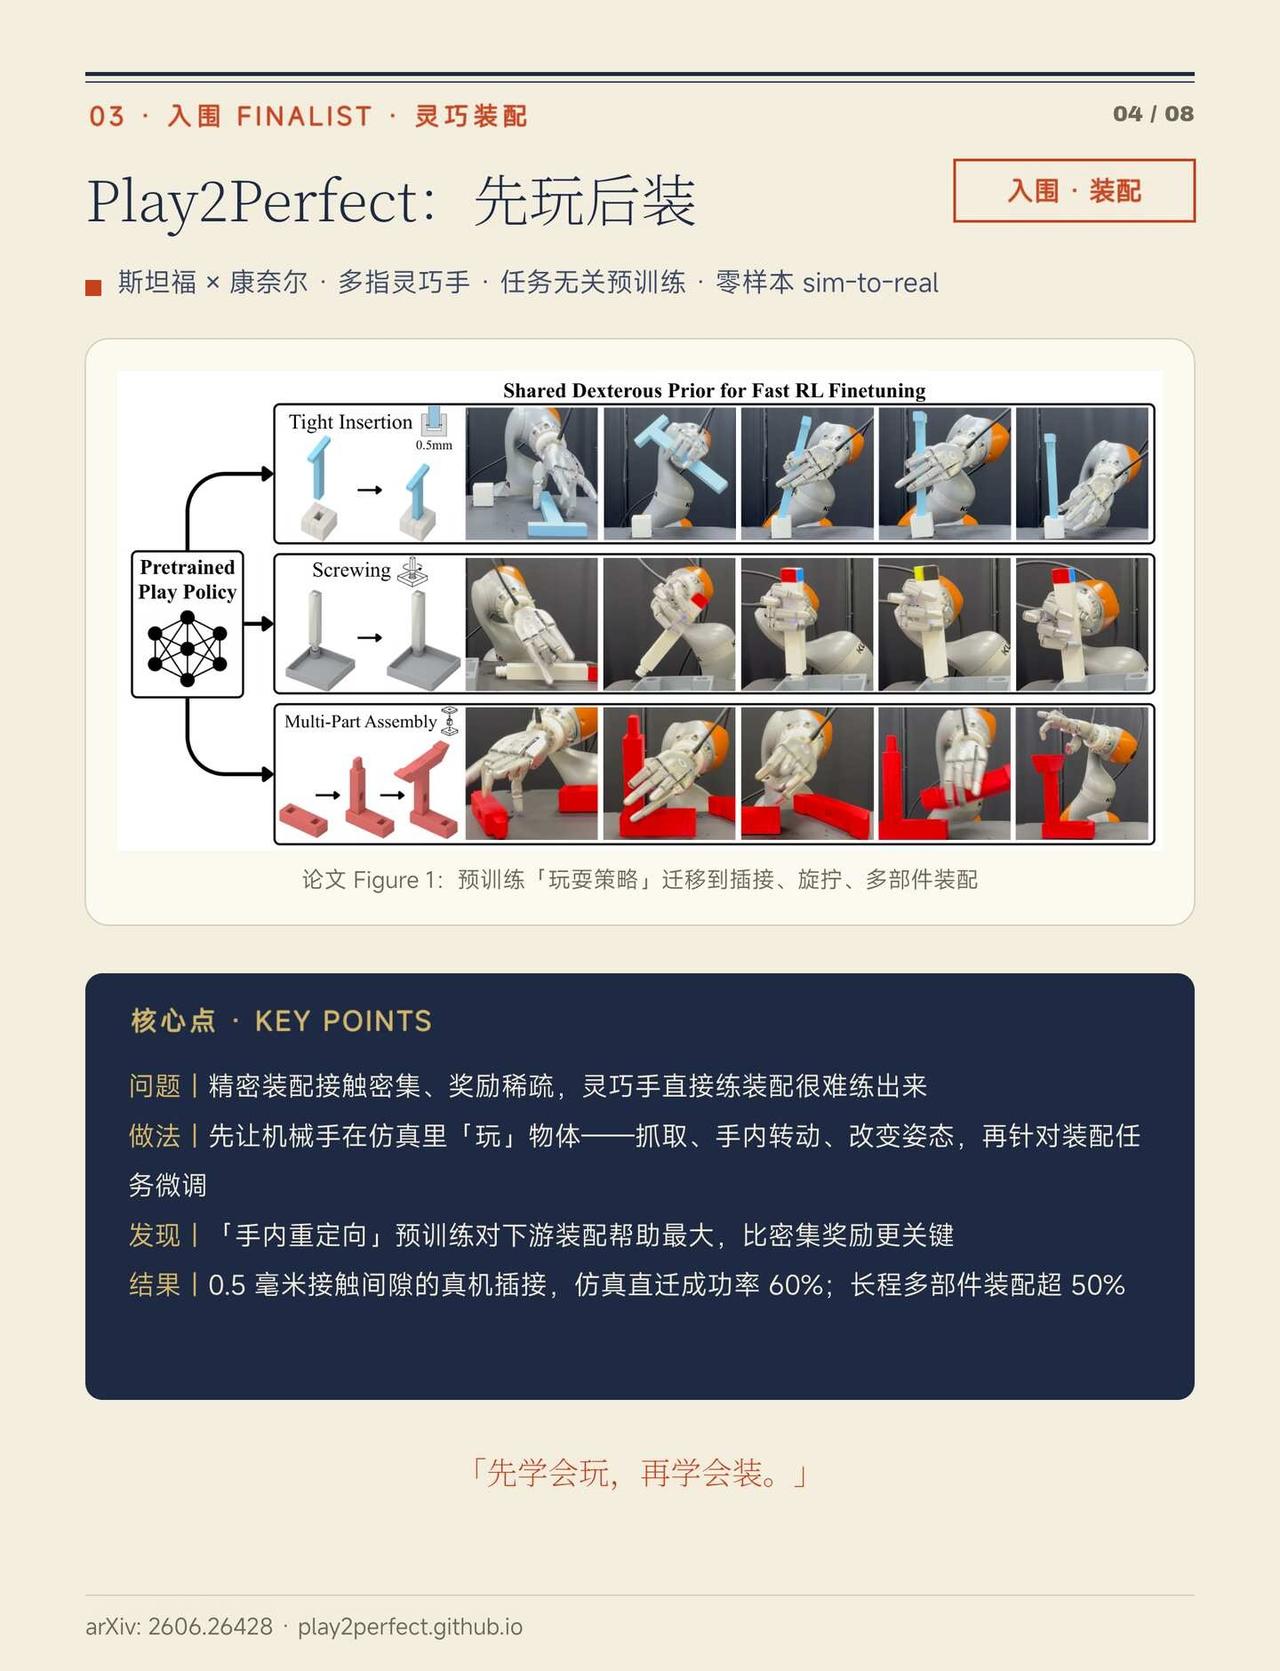
03 Play2Perfect(斯坦福)
0.5mm级精密装配奖励极度稀疏,强化学习难落地,行业长期依赖专用夹爪。
提出“先玩后装”两阶段范式:先让多指手练出抓取、手内重定向的通用操作先验,再微调目标装配任务。样本效率比从零训练高33倍,零样本紧插接成功率达60%,覆盖多类接触密集任务。灵巧手通用预训练有了可复制范式。
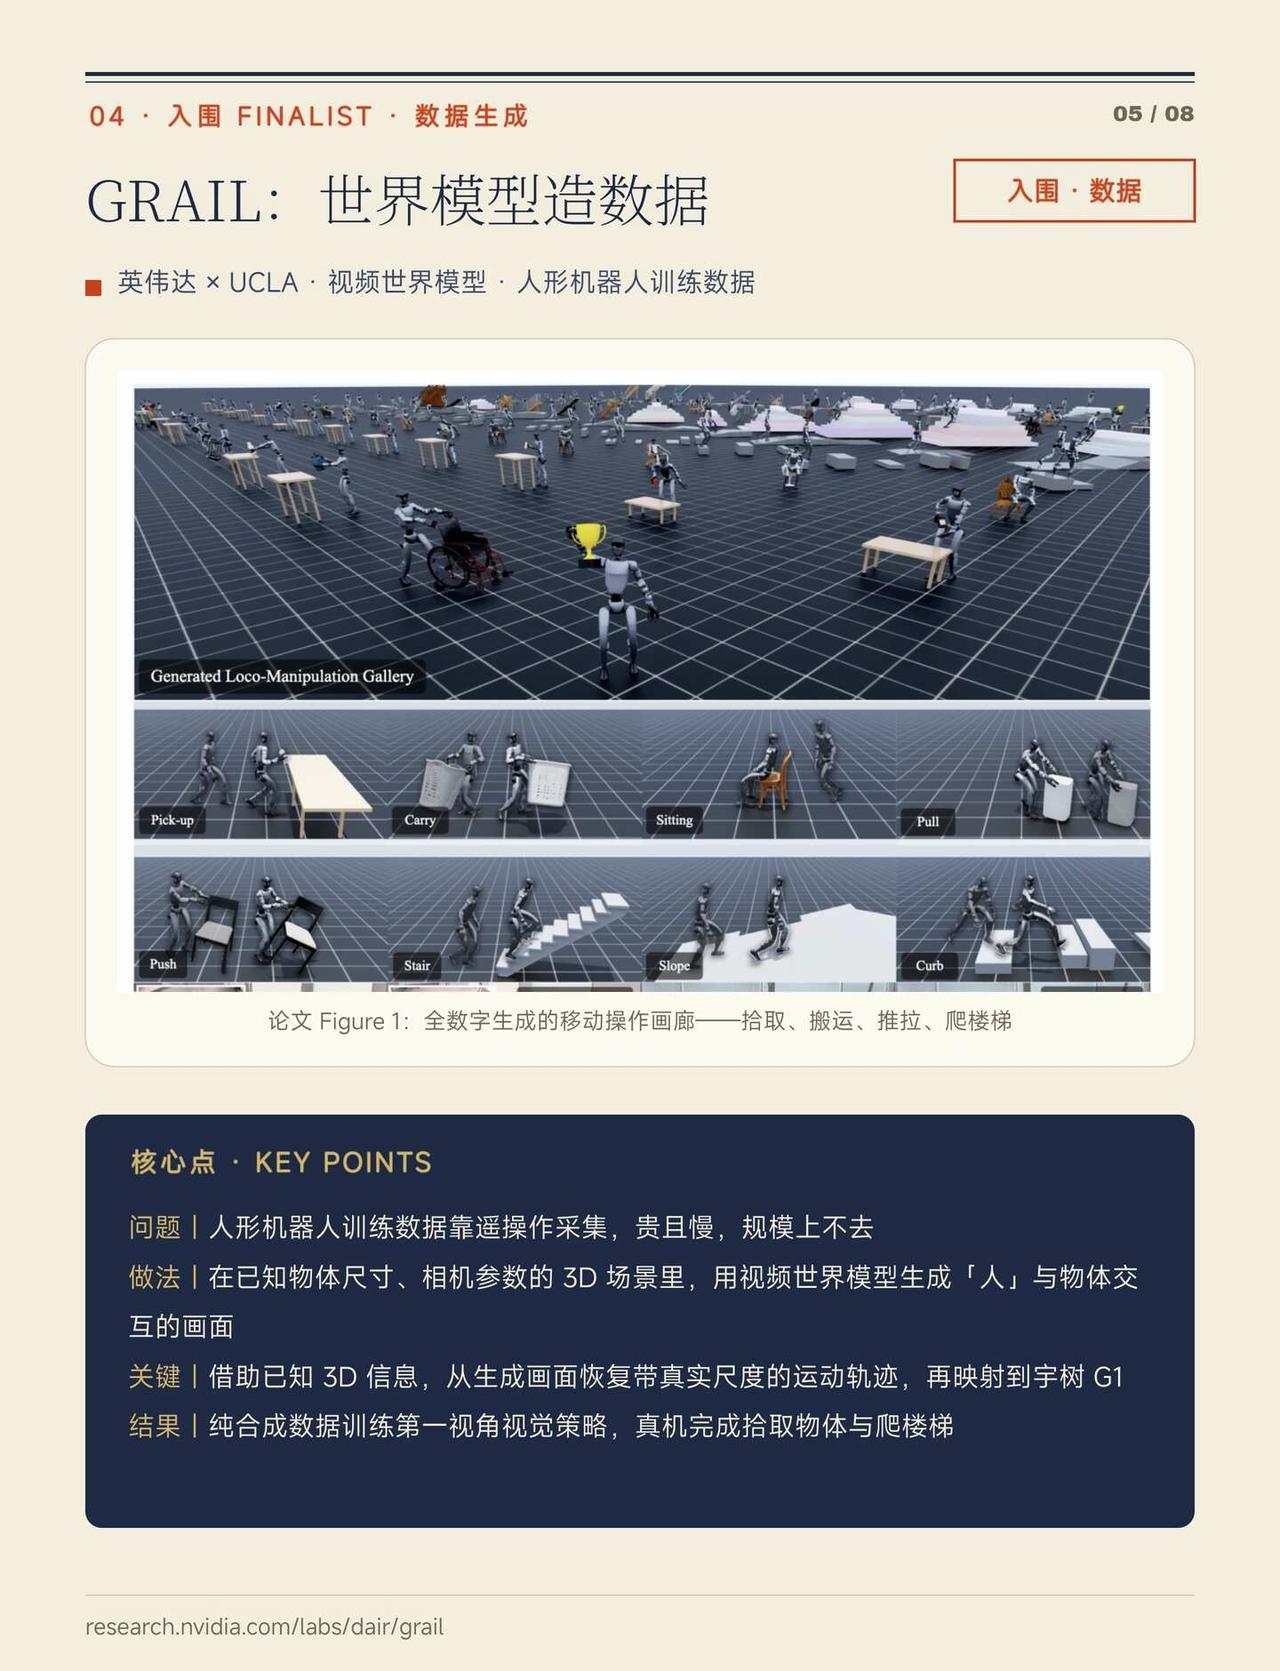
04 GRAIL(英伟达+UCLA)
人形移动操作数据高度依赖物理采集,成本高、难规模化。
搭建全虚拟数据流水线:从3D场景出发,用视频生成模型合成人机交互内容,输出带物理校验的4D运动轨迹。已生成3.5万段合规素材,真机桌面取物成功率84%。人形数据卡脖子的问题,有了纯AI生成的解法。
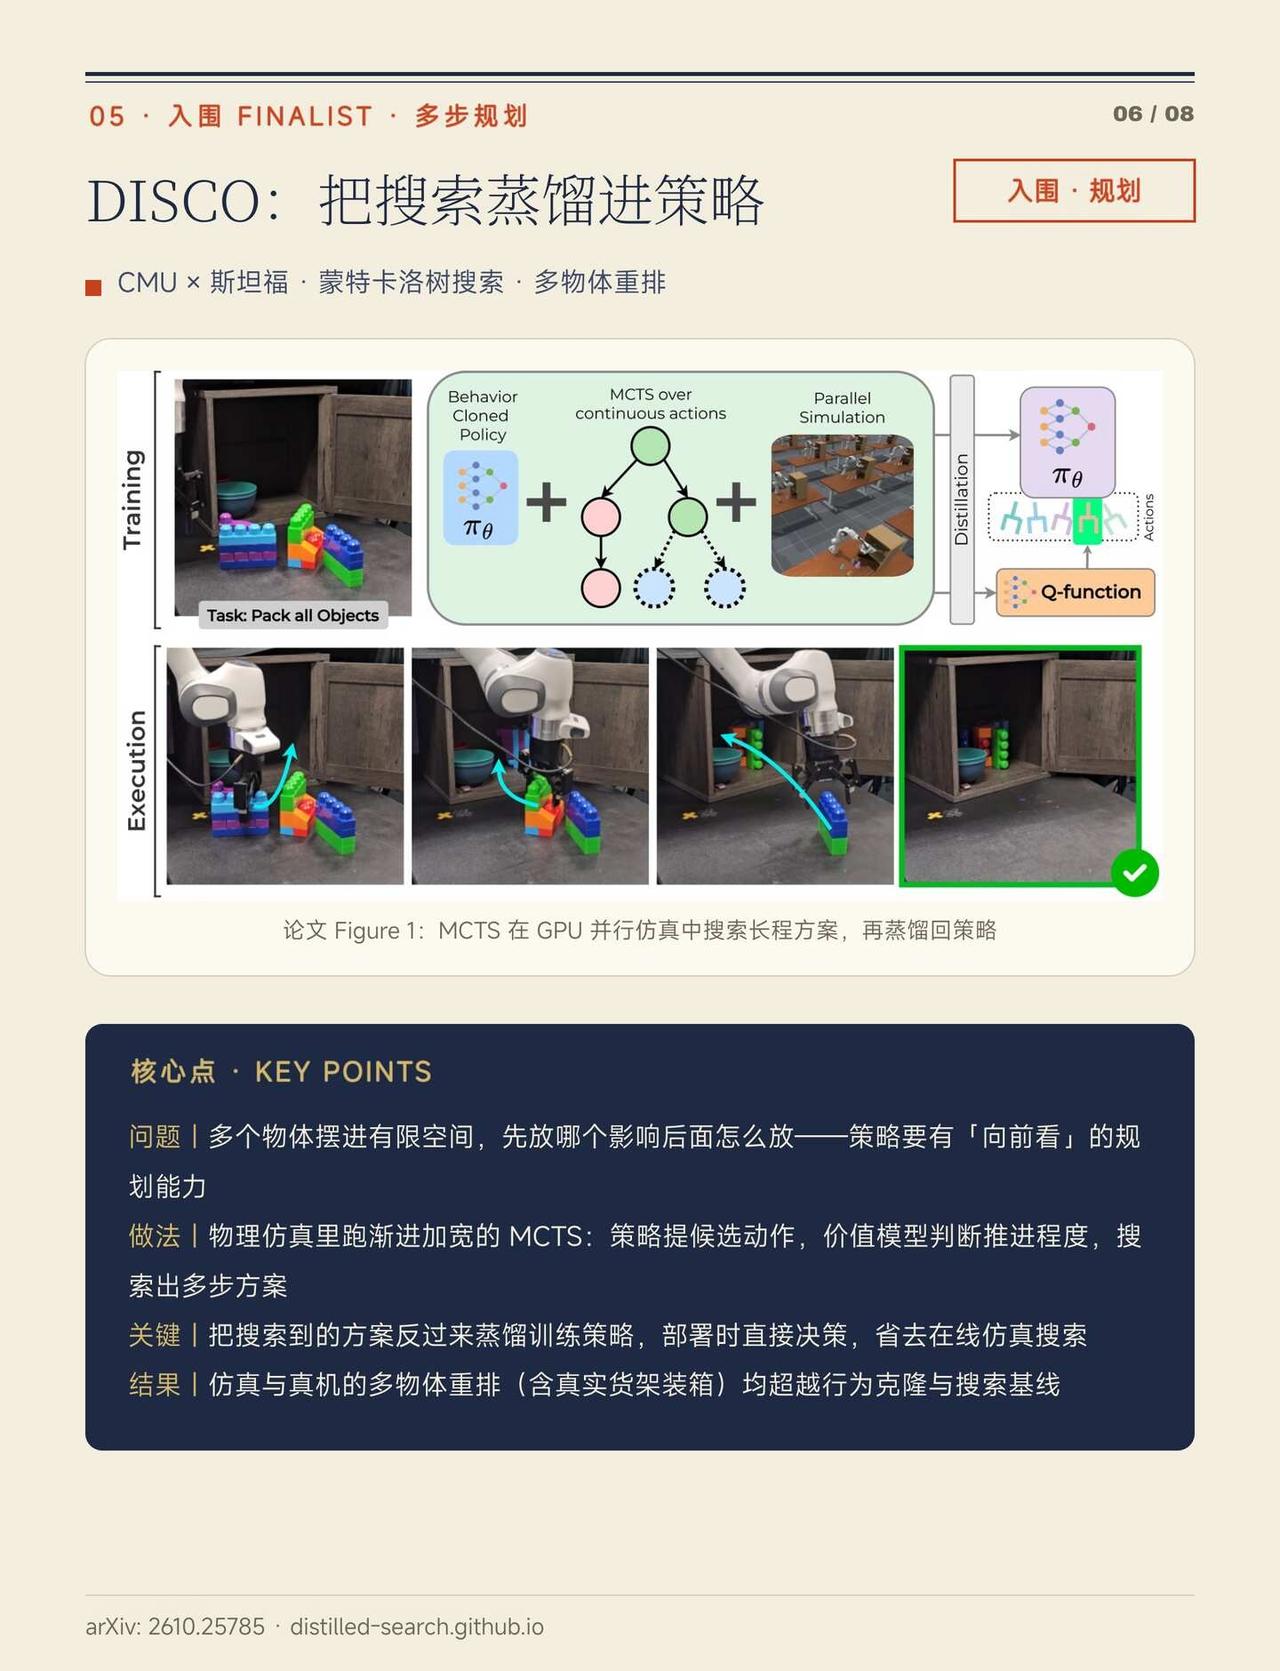
05 DISCO(CMU+斯坦福)
长程多物体任务,纯在线搜索算力爆炸,纯策略模型误差越累积越大。
用“蒙特卡洛树搜索+策略蒸馏”双向闭环:搜索算出全局最优方案,再把能力固化进轻量策略模型。桌面收纳任务全面碾压基线,收敛后可端侧部署,在线零额外算力开销。端侧机器人也能独立完成复杂长任务。
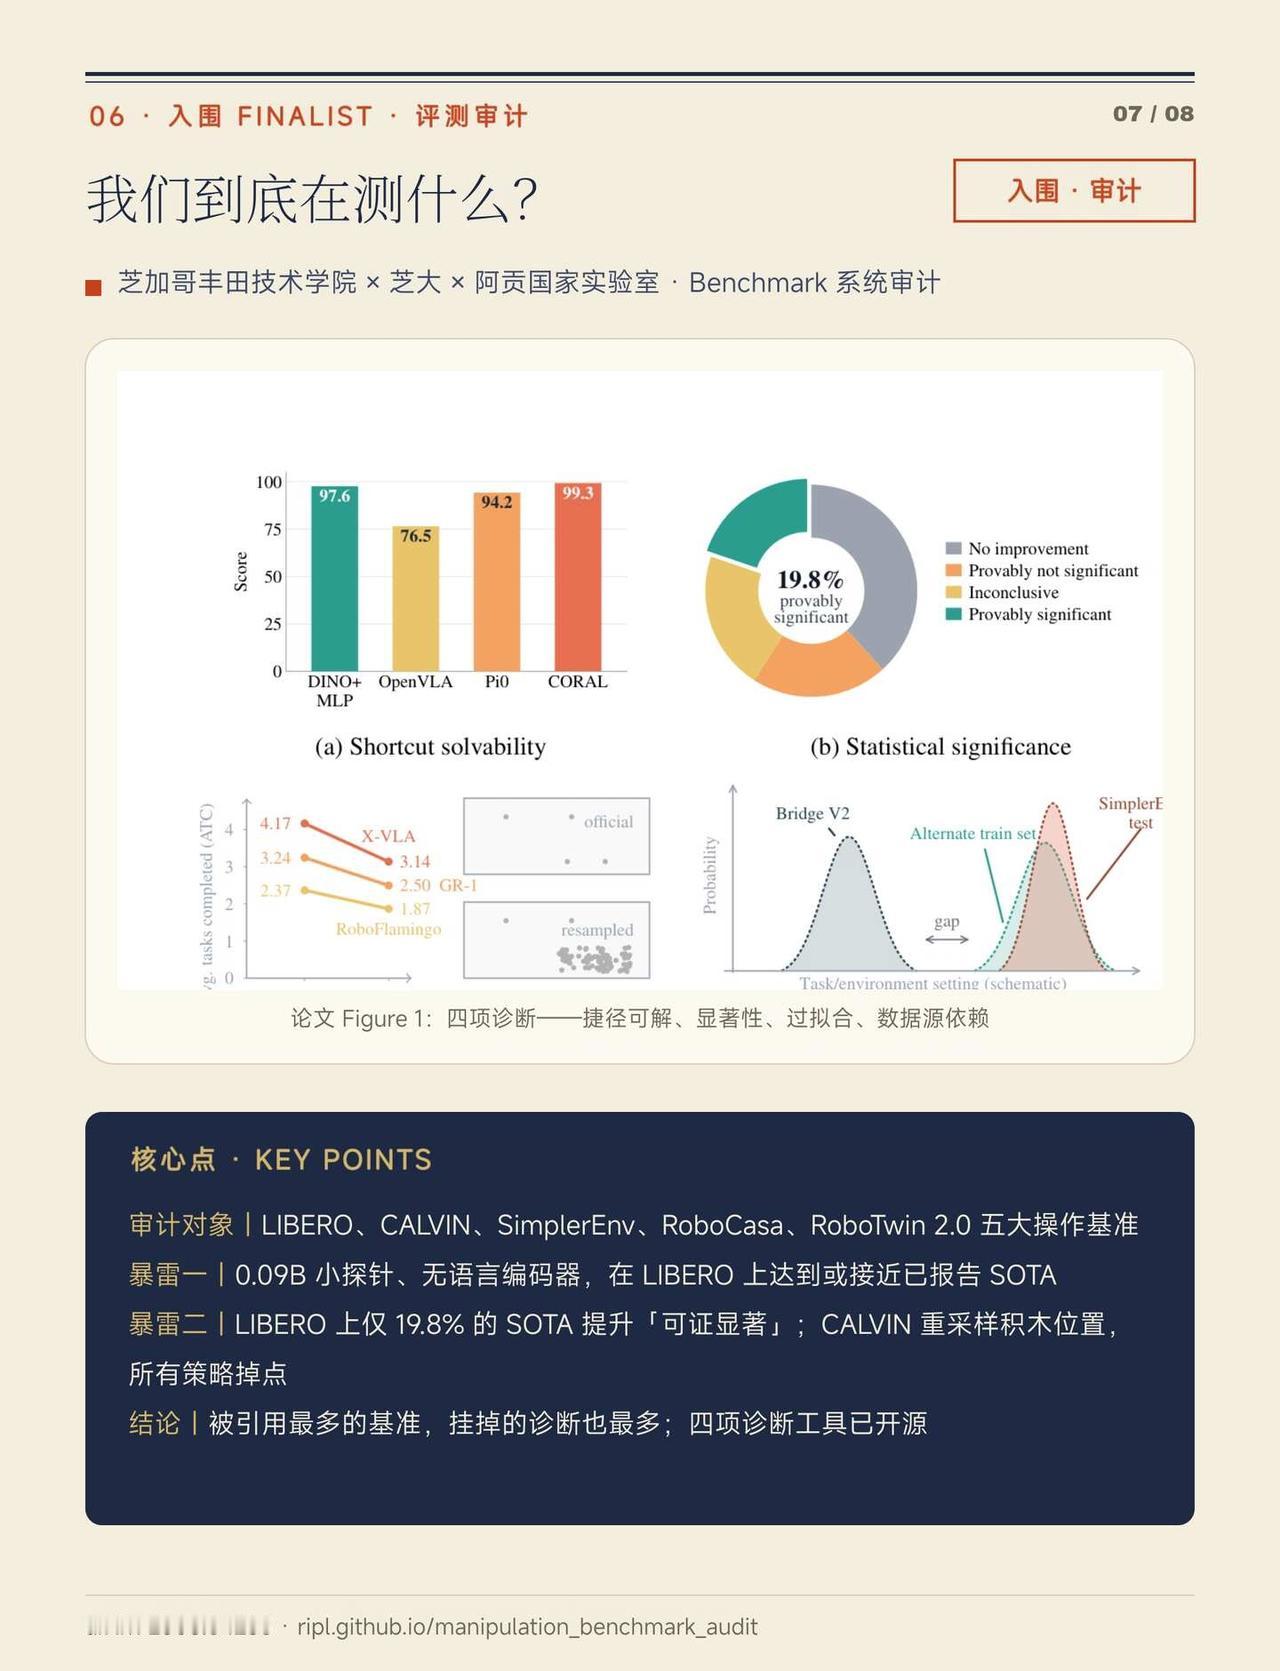
06 基准审计(芝大+阿贡国家实验室)
也就是打假论文📃,全行业都在刷操作榜单,但高分未必等于真实泛化能力。
给全行业提了醒:别沉迷刷榜,真机落地才是硬标准。
CoRL2026 具身智能就业 世界模型 英伟达