英伟达若押注扩散推理,能快多少?
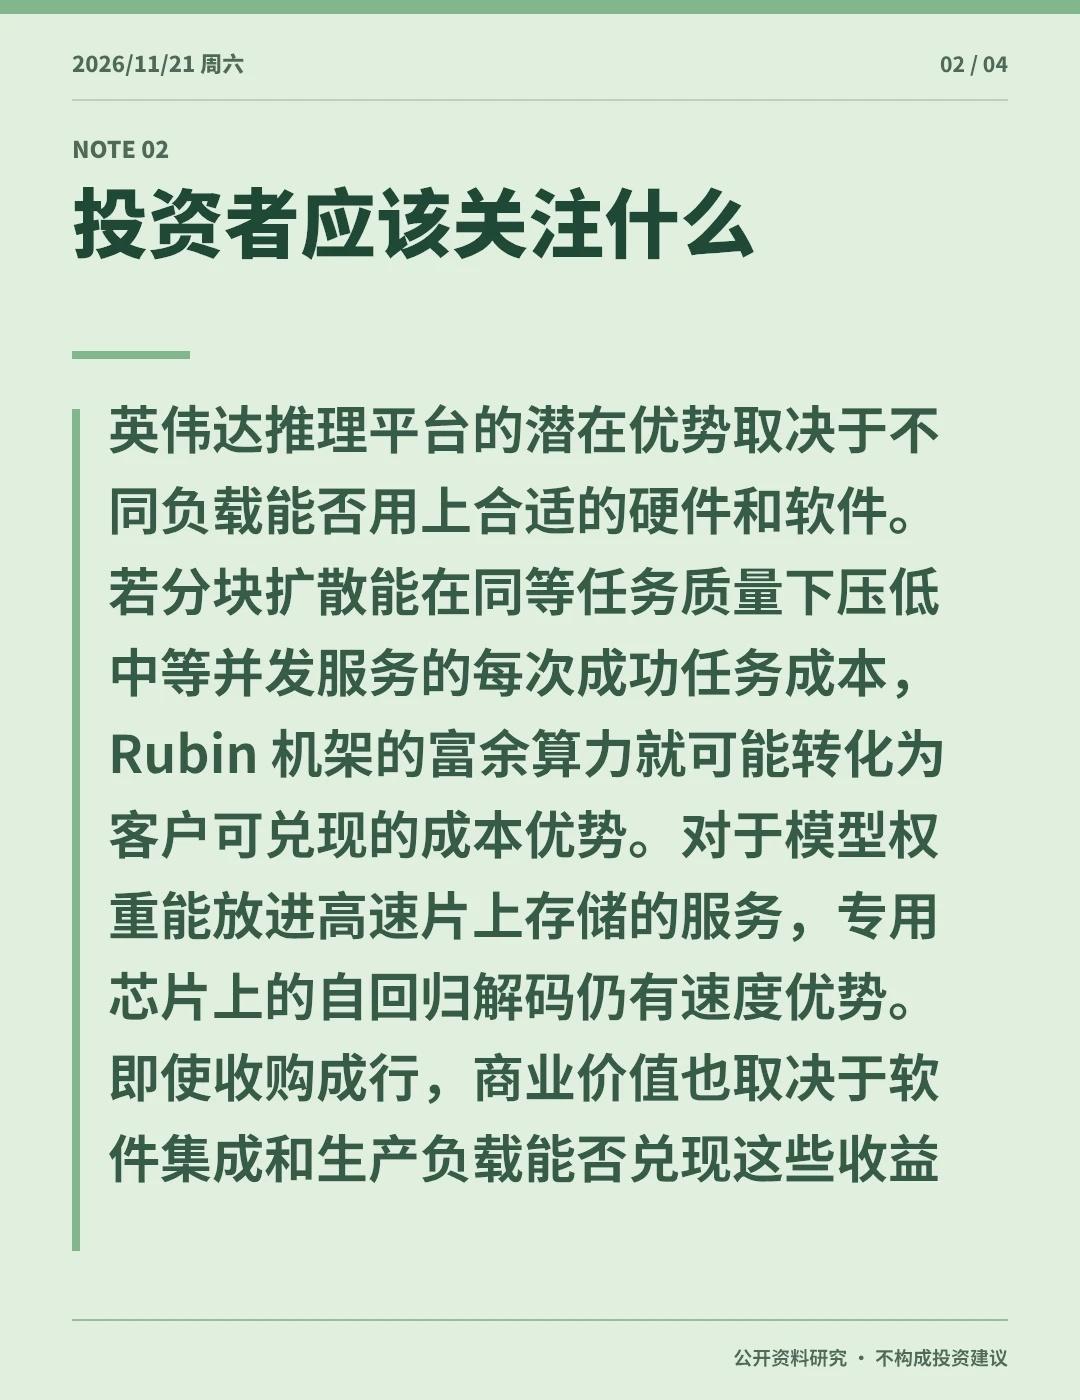
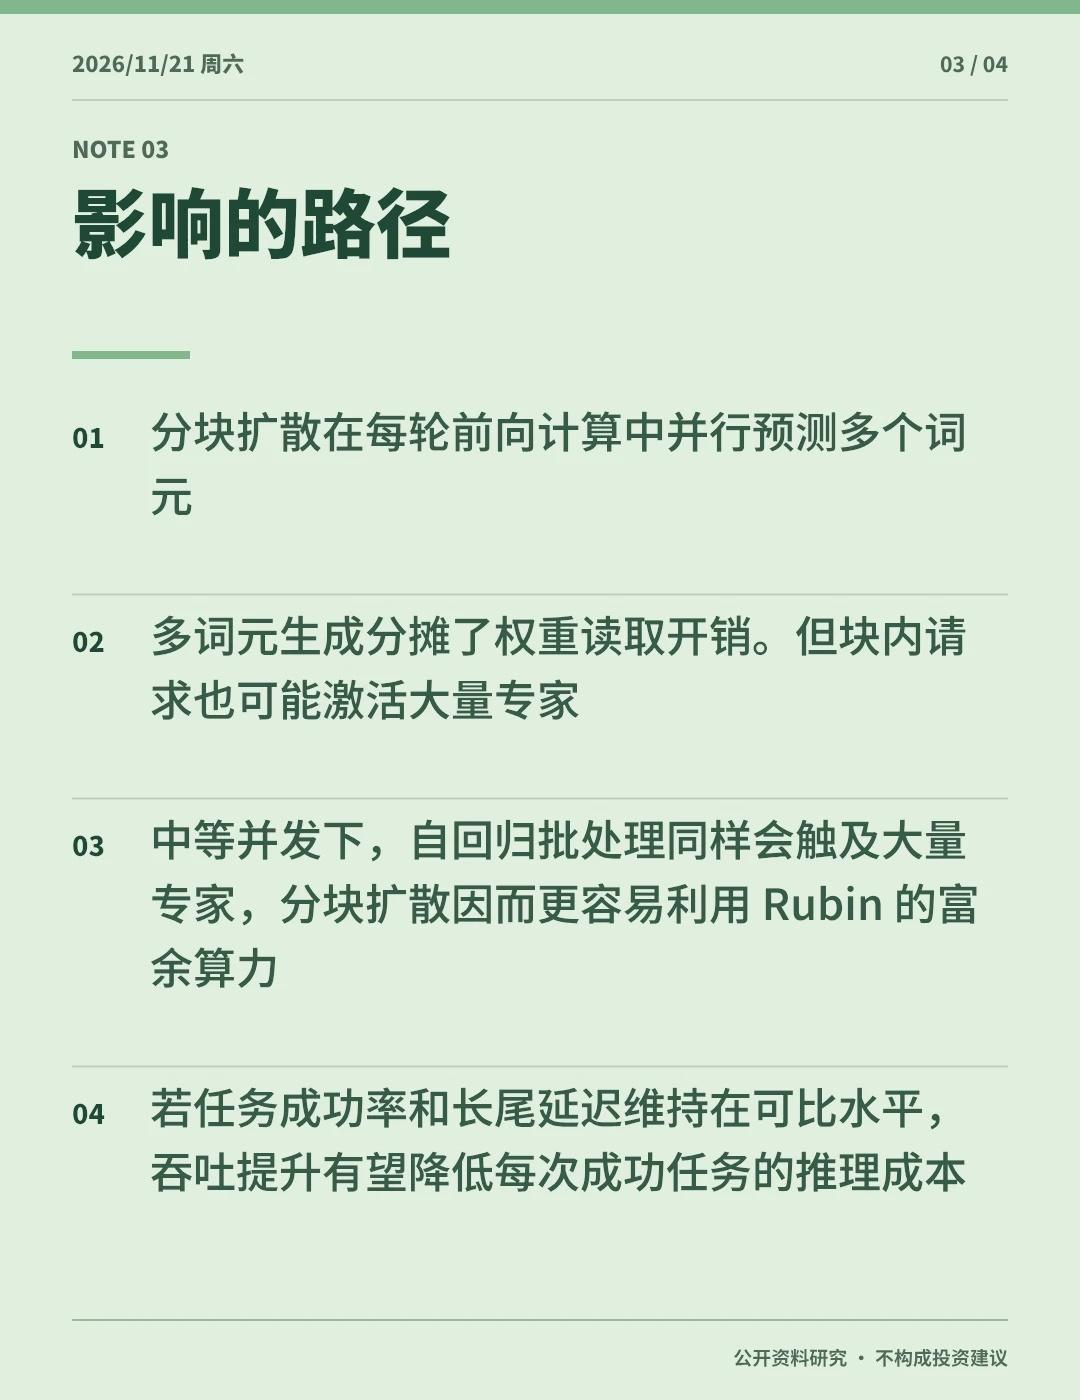
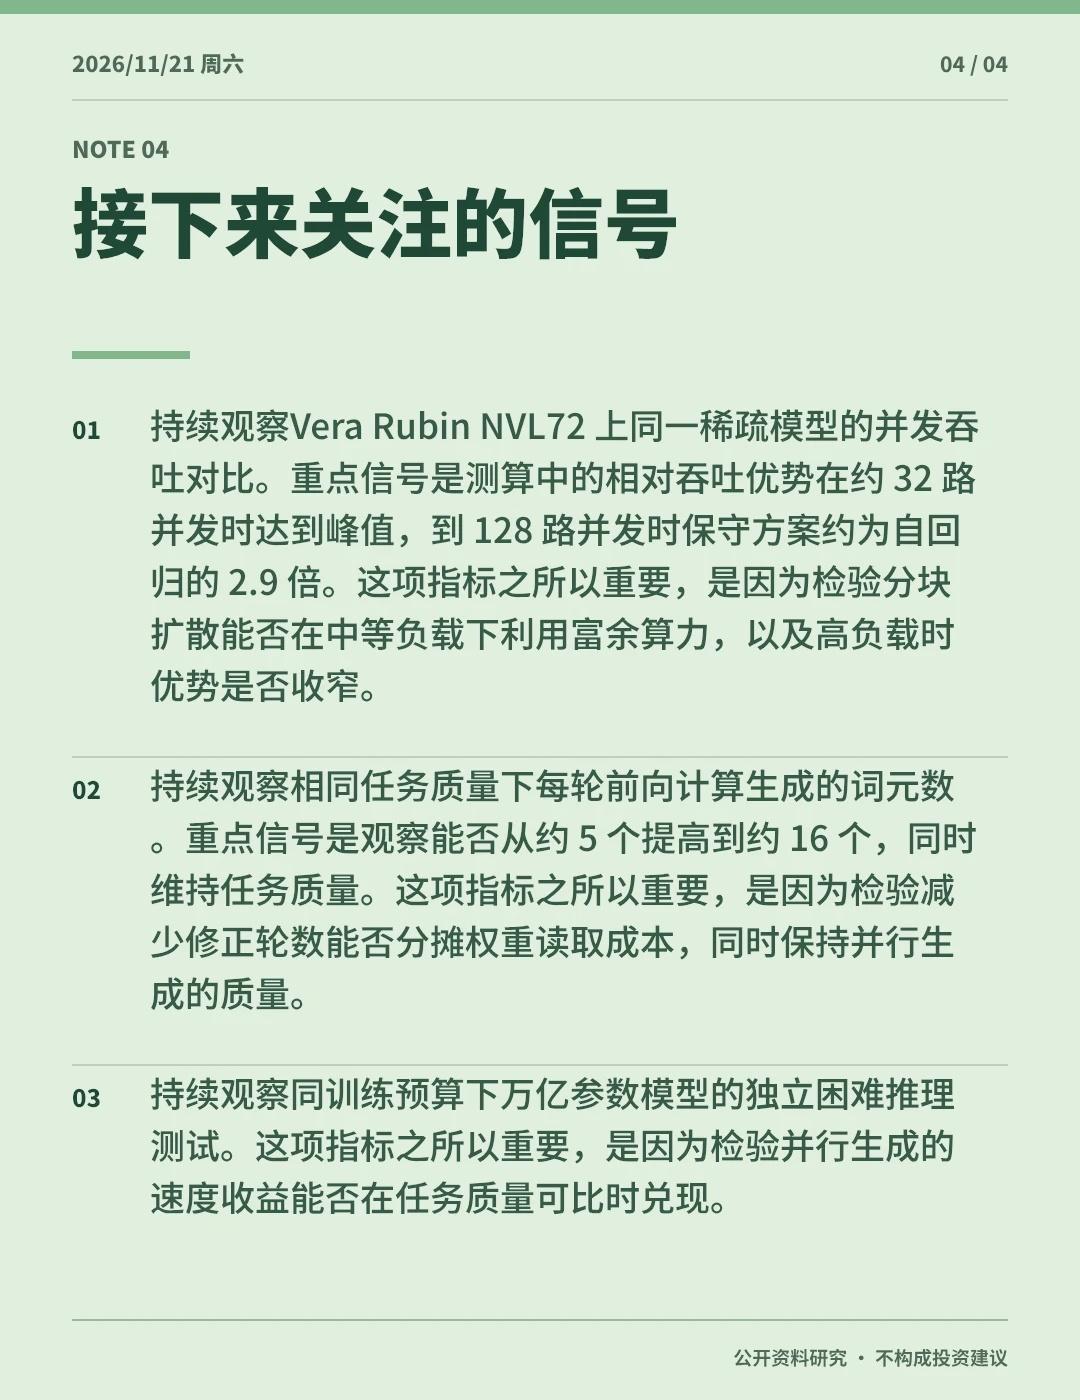
万亿参数扩散模型最有机会提速的场景,是在英伟达 Rubin 机架上服务中等并发请求。分块扩散按顺序生成文本块,在块内并行预测多个词元,再分几轮修正。一次权重读取可以产出多个词元,使传统自回归解码受内存带宽限制时闲置的算力得到利用。若英伟达完成仍未获双方确认的 Inception Labs 收购,并把团队的技术接入现有推理软件,Rubin 就可能多一种降低生成成本的方式。Groq 片上存储方案则适合加速逐词元解码,两条路线可以服务不同负载。 万亿参数模型若采用稀疏混合专家架构,每个词元只调用部分专家子网络,但并行处理一整块时,机架仍可能要读取接近全部专家的权重。按每个词元独立选择专家的简化假设,160 个专家中每个词元选 8 个,64 个词元合起来预计触及约 96% 的专家。这解释了单用户场景下的提速为何只有约 1.4 倍。并发上升后,自回归批处理也会触及大量专家,分块扩散更容易拉开差距。采用 3.2 万词元上下文的单台 Vera Rubin NVL72 机架测算中,优势在约 32 路并发时达到峰值。到 128 路并发,保守方案约快 2.9 倍,每百万词元成本的情景估计由约 0.33 美元降至 0.07 至 0.11 美元。这些数字依赖路由、并行生成效率和机架成本假设,尚待生产实测。 Mercury 3 的公开接口测试已经说明,解码速度与完成任务的成本可能背离。直连时,它每秒生成约 850 至 900 个可见词元,但运行在 Cerebras 芯片上的自回归对照模型约为每秒 2400 个。Mercury 3 在多步骤数据库查询任务上的成功率为 52.5%,低于 Claude Haiku 5.5 的 57.8%。在中、高推理强度下,它还有 7.5% 至 8.6% 的编程请求耗尽词元预算仍未作答。若额外计算消耗在失败请求上,每百万词元更便宜也可能对应更高的成功任务成本。 扩展现有模型未必能解决困难推理中的顺序问题。并行填充容易先确定简单词元,把决定推理方向的关键位置推迟到上下文已经成形之后。训练时保留从左到右的推理顺序、生成时并行处理块内词元,可能缓解这一问题。也可以让扩散模型并行起草,由自回归模型校验。万亿参数部署具备硬件上的可行性,但在相同训练预算下能否达到同规模自回归模型的困难推理水平,仍缺少独立验证。