以「个人健康笔记」为真实案例,从需求拆解到目录结构、SKILL.md 撰写、Python 脚本实现、可视化生成,逐节拆解一个生产级 Skill 是如何诞生的。
本文目录
什么是 Skill?为什么要自己造一个?案例速览:「个人健康笔记」解决了什么问题?创建前的四步准备:需求拆解Skill 的标准目录结构步骤 ①:初始化目录骨架(init_skill.py)步骤 ②:撰写 SKILL.md — Skill 的灵魂步骤 ③:编写 references/ 参考资料步骤 ④:实现 scripts/ 业务脚本关键设计:SKILL.md 的 description 与触发词关键设计:渐进式披露(Progressive Disclosure)关键设计:工作流与异常分支步骤 ⑤:本地安装与调试步骤 ⑥:打包与发布(package_skill.py)常见坑与最佳实践扩展玩法:把这个 Skill 改造成其他场景1. 什么是 Skill?为什么要自己造一个?在 WorkBuddy 中,Skill(技能)是一个模块化、自包含的"知识+工具"包。当你说出某个关键词时,AI 会自动加载对应的 Skill 指令,按既定流程完成任务。
Skill 的三大价值
复用流程:把"我每次都要告诉 AI 的那套步骤"沉淀下来,一次编写、长期生效。扩展能力:通过 scripts/ 让 AI 真正去执行 Python 脚本、操作文件、生成报告。领域知识:通过 references/ 注入只有内行人才知道的判断标准、行业规范。WorkBuddy 自带了 skill-creator 这条 Skill,它本身就是教你"如何造 Skill"的说明书。本文以"个人健康笔记"为真实案例,把这条说明书实例化给你看。
2. 案例速览:「个人健康笔记」解决了什么问题?日常生活中,用户需要定期记录血压、血糖、尿酸等体检数据,并希望:
用自然语言让 AI 帮自己记数据("今天血压 125/82,心率 72")。随时查看历史,支持按时间范围筛选。一键生成折线图,直观看到趋势变化。偶尔修改 / 删除录入错误的数据。如果没有 Skill,AI 每次都要重新询问格式、文件路径、绘图规范……既慢又容易出错。封装为 Skill 后,整个流程只需一句话触发。
3. 创建前的四步准备:需求拆解动手写代码前,先把需求拆干净,可以避免 80% 的返工。
1 明确意图
Skill 要解决的核心问题是什么?目标用户是谁?高频场景是什么?
2 列出操作
用户会用哪些动词?记录、查询、删除、绘图、修改……
3 设计数据
数据存在哪?JSON / SQLite / 远程 API?字段结构是什么?
4 触发词
用户可能说什么?把这些口语化表达写进 description,AI 才会识别。
以"个人健康笔记"为例,拆解后得到:
维度
拆解结果
核心问题
体检数据无统一管理,无法直观看到趋势
高频操作
记录、查询、绘图、修改、删除
数据存储
本地 JSON 文件,~/健康笔记/health_data.json
可视化
纯内联 HTML + matplotlib SVG 折线图,零外部依赖
触发词
健康笔记、血压、血糖、尿酸、体检数据、健康曲线、日期段查询
4. Skill 的标准目录结构一个生产级 Skill 的标准结构如下:
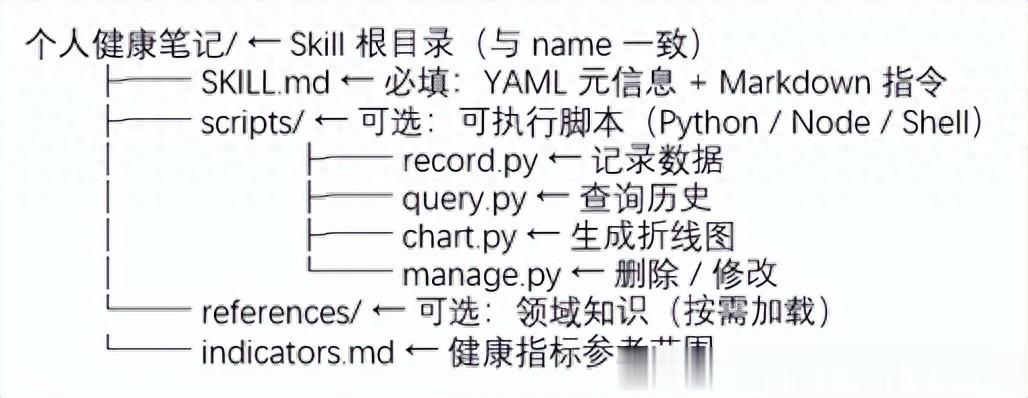
三个核心原则
SKILL.md 是唯一必填文件,没有它 Skill 不会生效。scripts/ 用于可执行逻辑,AI 通过 python scripts/xxx.py 调用。references/ 用于静态知识,AI 读到对应章节时才加载,不污染主上下文。5. 步骤 ①:初始化目录骨架WorkBuddy 提供了 init_skill.py 一键生成标准骨架:
# 在 WorkBuddy 终端中执行python ~/.workbuddy/skills/skill-creator/scripts/init_skill.py \
个人健康笔记 \
--path ~/.workbuddy/skills/
执行后会自动生成:
个人健康笔记/├──SKILL.md← 模板文件(需手工改写)
├──scripts/← 空目录
└──references/← 空目录
注意:Windows 下路径分隔符建议用正斜杠/,或双反斜杠\\,避免转义问题。目录名必须与 Skill 的name完全一致(包含中文)。
6. 步骤 ②:撰写 SKILL.md — Skill 的灵魂SKILL.md 由两部分组成:YAML 前置元数据(必填)和 Markdown 正文(指令正文)。
6.1 YAML 前置元数据---name: 个人健康笔记
description: 记录个人血压、血糖、尿酸等健康检查检验数据,查看历史记录,
根据已记录的数据生成变化曲线折线图,支持日期段查询。
触发词:健康笔记、血压、血糖、尿酸、体检数据、健康记录、健康曲线、
健康趋势、日期段查询、时间段查询。
---
description 撰写的 4 个要点:说明能力:能做什么(记录 / 查询 / 绘图)说明边界:支持哪些数据类型触发词:用户可能说的所有同义表达(中文 + 英文)控制长度:description 永远在上下文中,应保持简洁(建议 100 字内)6.2 Markdown 正文结构
一份高质量的 SKILL.md 正文应包含以下章节:
章节
作用
本案例对应内容
概述
一两句话讲清楚做什么
管理血压/血糖/尿酸等健康指标
数据存储
JSON schema、存储路径
~/健康笔记/health_data.json
结构
支持的指标
字段、单位、正常范围表
血压/血糖/尿酸/心率等
使用方式
分场景给 AI 操作指令
记录 / 查看 / 绘图 / 删除 / 修改
工作流
总览处理流程(5 步)
识别意图 → 收集信息 → 执行 → 反馈
注意事项
边界条件、特殊约定
数据目录、配色方案、HTML 内联
6.3 真实节选 — 「使用方式 · 记录数据」### 1. 记录数据用户说"记录血压"、"记录血糖"、"记录健康数据"等时:
1. 向用户询问需要记录的数据(如收缩压、舒张压、心率等)
2. 调用 `scripts/record.py` 将数据追加到 `health_data.json`
3. 记录完成后告知用户当前值是否在正常范围内
```bash
python scripts/record.py --type <类型> --date <日期> --time <时间> [其他字段...] --note <备注>
```
撰写技巧
每个使用场景都应包含 "用户怎么说 → 你要做什么 → 怎么调用脚本 → 异常怎么处理" 四要素。AI 读完就知道:在这种场景下,我该跑哪个命令、传什么参数、出错了怎么办。
7. 步骤 ③:编写 references/ 参考资料references/ 用于存放 不常变化但很关键 的领域知识。AI 不会在每次对话都加载它,只在 SKILL.md 引用时按需读取。
本案例的 references/indicators.md 内容(节选):
# 健康指标参考## 血压 (Blood Pressure)
| 分类 | 收缩压 (mmHg) | 舒张压 (mmHg) |
|------|--------------|---------------|
| 低血压 | < 90 | < 60 |
| 正常 | 90 - 119 | 60 - 79 |
| 正常高值 | 120 - 139 | 80 - 89 |
| 高血压 1 级 | 140 - 159 | 90 - 99 |
| ... |
## 血糖 (Blood Glucose)
| 状态 | 空腹 (mmol/L) | 餐后 2h (mmol/L) |
|------|-------------|-----------------|
| 正常 | 3.9 - 6.1 | < 7.8 |
| 糖耐量受损 | 6.1 - 7.0 | 7.8 - 11.1 |
| 糖尿病 | ≥ 7.0 | ≥ 11.1 |
> 以上参考值来自《中国高血压防治指南》《中国2型糖尿病防治指南》等权威来源
为什么单独抽出 references/?因为这些参考表很长,全塞进 SKILL.md 会污染上下文;按需加载可以节省 token,并让知识保持可维护。
8. 步骤 ④:实现 scripts/ 业务脚本scripts/ 是 Skill 的"手脚"。每个脚本应做到单一职责、命令行友好、零交互(AI 不会回答"请输入 y/n")。
8.1 脚本设计原则原则
说明
本案例体现
单一职责
一个脚本只做一件事
record / query / chart / manage 各管一摊
参数化
用 argparse 接收参数
--type
--date
--days
等
幂等性
同一操作可重复执行不破坏数据
删除前先展示匹配,确认后再执行
显式输出
打印结果路径 / JSON 供 AI 解析
chart.py 直接打印 HTML 路径
本地优先
数据存用户目录,不依赖外部服务
~/健康笔记/
纯本地
8.2 真实节选 — record.py 核心逻辑import json, os, argparsefrom datetime import datetime
DATA_FILE = os.path.join(
os.path.expanduser("~\\健康笔记"),
"health_data.json"
)
# 1. 解析命令行参数
parser = argparse.ArgumentParser(description="记录健康数据")
parser.add_argument("--type", required=True)
parser.add_argument("--systolic", type=int) # 收缩压
parser.add_argument("--diastolic", type=int) # 舒张压
parser.add_argument("--value", type=float) # 通用数值
parser.add_argument("--note", default="")
args = parser.parse_args()
# 2. 自动创建数据文件
os.makedirs(os.path.dirname(DATA_FILE), exist_ok=True)
if not os.path.exists(DATA_FILE):
with open(DATA_FILE, "w", encoding="utf-8") as f:
json.dump({"records": []}, f, ensure_ascii=False, indent=2)
# 3. 追加新记录
record = {"date": args.date, "type": args.type, "note": args.note}
if args.type == "血压":
record["systolic"] = args.systolic
record["diastolic"] = args.diastolic
with open(DATA_FILE, encoding="utf-8") as f:
data = json.load(f)
data["records"].append(record)
with open(DATA_FILE, "w", encoding="utf-8") as f:
json.dump(data, f, ensure_ascii=False, indent=2)
8.3 chart.py 的可视化技巧
为了让图表既专业又"零外部依赖",chart.py 做了三件事:
matplotlib 渲染 → 内联 SVG:避免 PNG 失真,浏览器可直接缩放。正常范围绿色区域:用 axhspan 绘制底色,让用户一眼分辨哪些点超标。数据 + 图表同页输出:HTML 同时包含统计卡片、折线图、原始数据表,一份文件搞定所有信息。# matplotlib 输出 SVG,再用正则提取 <svg> 标签svg_buf = io.BytesIO()
fig.savefig(svg_buf, format="svg", dpi=150, bbox_inches="tight")
svg_str = svg_buf.read().decode("utf-8")
svg_match = re.search(r"<svg[\s\S]*?</svg>", svg_str)
return svg_match.group(0) # 内联进 HTML 字符串
9. 关键设计:description 与触发词
description 是 AI 决定是否加载 Skill 的唯一依据。写得不好,Skill 永远不会被调用。
9.1 反面案例❌ 错误写法:description: 一个用于记录健康数据的工具。问题:太抽象,AI 不知道用户说"血压有点高"时要不要触发。
9.2 正面案例(本 Skill 实际写法)✅ 正确写法:description: 记录个人血压、血糖、尿酸等健康检查检验数据,查看历史记录,根据已记录的数据生成变化曲线折线图,支持日期段查询。触发词:健康笔记、血压、血糖、尿酸、体检数据、健康记录、健康曲线、健康趋势、日期段查询、时间段查询。优点:能力描述 + 同义触发词齐全,AI 命中率高。
9.3 触发词设计原则覆盖动作(记录、查询、删除、绘图)覆盖对象(血压、血糖、尿酸、体重)覆盖口语化表达("帮我看看血糖曲线"、"最近血压怎么样")中英文混排(如果用户会英文就加上)10. 关键设计:渐进式披露(Progressive Disclosure)WorkBuddy 的 Skill 采用"分层加载"机制,最大化节省上下文:
层级
何时加载
本案例
L1 · 元数据
永远在上下文中(用于触发判断)
name
+
description,约 100 字
L2 · SKILL.md 正文
触发后才加载
工作流、命令、注意事项,约 2KB
L3 · references/
AI 主动引用时才读取
正常范围表等,按需加载
L4 · scripts/
需要执行时才调用
Python 脚本不进入上下文,只跑结果
经验法则
SKILL.md 正文保持在 300 行以内。超过的部分一律抽到 references/。脚本本身不进上下文,只暴露 CLI 参数和输出格式。
11. 关键设计:工作流与异常分支SKILL.md 中应当有一节"工作流",用 5 步法 串起所有操作:
## 工作流处理健康笔记相关请求时,遵循以下流程:
1. **识别意图** — 判断用户是想记录、查看、生成图表还是管理数据
2. **收集信息** — 如果是记录,询问缺失的必要数据项
3. **执行操作** — 调用对应脚本
4. **反馈结果** — 告知用户操作结果,记录数据时附上正常范围参考
5. **生成图表时** — 直接打开 HTML 文件预览
异常分支处理
如果场景复杂,可以加 条件分支:
### 删除 / 修改时的安全策略用户说"删除某条记录"、"修改某天的血压"时:
1. **先查后删** — 展示匹配的记录让用户确认
2. **支持索引** — 多条匹配时要求用户指定 `--index`
3. **永久操作前确认** — 删除是不可逆的,必须明确收到指令才执行
12. 步骤 ⑤:本地安装与调试
把 Skill 放到 WorkBuddy 的 skills 目录下,重启或刷新 后即可生效:
# Windows 用户级 Skill 路径C:\Users\shenweixing\.workbuddy\skills\个人健康笔记\
# 项目级 Skill 路径(仅当前项目可见)
C:\Users\shenweixing\WorkBuddy\<项目>\.workbuddy\skills\个人健康笔记\
调试清单打开 WorkBuddy 对话框,输入触发词:"帮我记录一下今天的血压"。观察 AI 是否正确识别并加载本 Skill。观察 AI 是否正确调用 scripts/record.py 并传对参数。手动运行 python scripts/record.py --help 检查命令行是否解析正常。检查 ~/健康笔记/health_data.json 是否被正确创建。
调试常见错误:
description 写得过于简略,AI 完全没识别 → 补全触发词路径含中文导致 os.path.expanduser 失败 → 用 os.path.expanduser("~\\健康笔记")Python 脚本需要 matplotlib,但环境未装 → pip install matplotlib 或用纯内置库13. 步骤 ⑥:打包与发布(可选)当你希望把 Skill 分享给他人 或 上传到市场 时,使用 package_skill.py:
# 打包为 .skill 文件python ~/.workbuddy/skills/skill-creator/scripts/package_skill.py \
~/.workbuddy/skills/个人健康笔记/
# 输出
个人健康笔记.skill # 可双击安装到其他 WorkBuddy 实例
打包会自动做三件事:
校验 SKILL.md 的 YAML 格式检查 scripts/ 中的 Python 脚本是否能正常导入生成可分发的 zip 包发布到市场
如果希望让更多用户使用,可以前往 WorkBuddy 技能市场 提交申请。通过审核后会出现在内置市场中,用户一键安装。
14. 常见坑与最佳实践常见坑
正确做法
description 只写"管理数据"
把动词、对象、触发词写全
SKILL.md 写成 5000 字大长文
正文 ≤ 300 行,详细资料放 references/
脚本里有
input()
让用户输入
用 argparse,AI 不会回答交互问题
图表依赖网络 CDN(Chart.js / ECharts)
全部内联,单文件 HTML 才能离线分享
数据存到
C:\
根目录
用
os.path.expanduser("~")
回到用户目录
硬编码
C:\Users\shenweixing\...
跨用户使用时必须用
~
展开
把正常范围写进 SKILL.md 主文件
放 references/indicators.md 按需加载
脚本里中文 print 没加
encoding="utf-8"
始终
encoding="utf-8",避免 Windows GBK 乱码
15. 扩展玩法:把这个 Skill 改造成其他场景个人健康笔记的目录结构是 Skill 的"通用模板",可以快速改造为:
每日阅读笔记:替换 JSON 字段为书名 / 章节 / 摘录 / 心得,触发词改为"读书笔记"。家庭账本:替换数据为金额 / 类别 / 日期,触发词改为"记账、消费统计"。植物养护记录:替换数据为浇水 / 施肥 / 光照,生成养护曲线。宠物体重追踪:记录体重 + 喂食量,生成趋势图。学习打卡:记录学习时长、专注度,生成学习曲线。核心改造点只有三处:改 description、改 JSON schema、改脚本参数。其余目录结构、渐进披露原则、工作流思路完全可复用。
结语:Skill 的本质是"把一次性的复杂操作,变成可重复的自动化"。本案例的"个人健康笔记"从零到一经历了 ① 需求拆解 → ② 目录初始化 → ③ 撰写 SKILL.md → ④ 编写 references/ → ⑤ 实现 scripts/ → ⑥ 本地调试 → ⑦ 打包发布 七步,这套流程适用于所有 Skill 的创建。掌握后,你就能把任何"你希望 AI 帮你做的事"沉淀成长期资产。