6月29日,国务院常务会议专门听取人工智能发展情况汇报,然后给出了一个很具体的部署方向:"加快关键技术攻关和超大规模智算集群建设"。
"超大规模智算集群"——这五个字是整场会议最值得拆解的关键词。
争议一:什么是"超大规模"?
国常会的表述没有给出具体数字。但从近期产业动作推断,"超大规模"可能指的是万卡级别以上的智算集群——即同时部署一万张以上AI加速卡的计算集群。
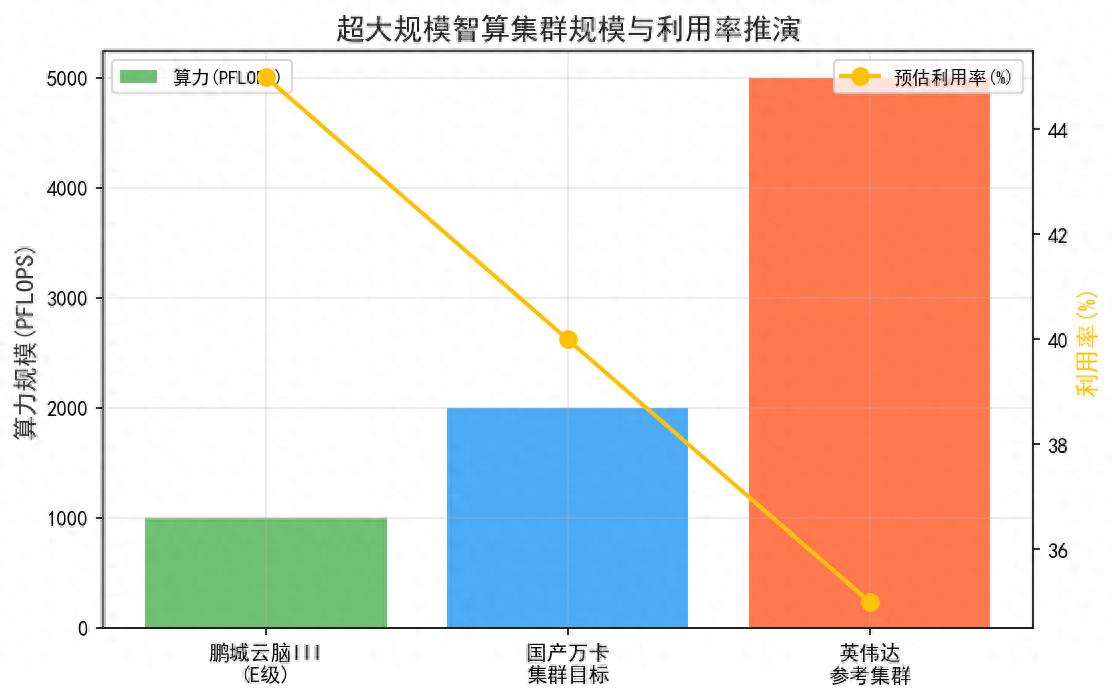
目前中国已公开的最大规模智算集群是深圳的"鹏城云脑III",规划算力规模达到E级(1000PFLOPS)。6月30日报道提到深圳在算力领域拿下"全球第一"——虽然这个"全球第一"的具体口径和评判标准还不够清晰,但至少说明深圳在智算集群建设上走在了国内前列。
国常会同时提到"强化高质量数据供给"——这暗示不只是堆算力卡,还要配套数据基础设施。算力集群没有高质量数据喂进去就是空转——这个认识算是到位了。
争议在于:万卡集群的实际利用率到底有多高?英伟达内部数据显示,很多大型GPU集群的平均利用率只有30%到50%。任务调度效率损失、数据传输延迟、模型并行通信开销、排队等待时间——这些环节层层吃掉理论算力。如果中国的万卡集群面临同样问题,"超大规模"就只是一个数字而非实际产出。
反面观点也有:国产AI芯片集群效率可能反而更高。原因在于芯片架构更统一——不像英伟达集群里经常混着A100、H100、B200不同代际的GPU,国产集群通常用同一种芯片,调度更简单。寒武纪和华为的集群方案都强调"软硬一体优化",理论上可以减少调度损耗。
我觉得这个争议目前没有定论。国产万卡集群的实际运行数据还没公开到可以做独立验证的程度。8月寒武纪中报可能会给出一些实际算力交付的线索——但更详细的利用率数据,可能要到更多客户公开分享使用经验之后才能评估。
争议二:国产算力能撑住"超大规模"吗?
这是最核心的争议。
支持方的证据:寒武纪2026年Q1营收28.85亿元同比增长159.56%,证明国产AI芯片正在快速放量。国金证券指出寒武纪已实现智谱GLM-5系列模型Day0同步适配——"国产模型迭代正与国产算力相互赋能,产业形成正向循环"。中信证券说"国产算力订单预期清晰度显著增强,供应链备货节奏加速"。广发证券还注意到寒武纪申请了大额银行授信额度,"反映了业务拓展信心,为扩大晶圆、HBM等原材料采购做资金准备"。
反对方的证据同样有力:国产芯片在单卡性能上仍然和英伟达有数倍差距。训练端差距更大——英伟达Blackwell单卡FP16算力约2.5PFLOPS,寒武纪最新思元系列算力约0.5-1PFLOPS区间。达到同样训练效果需要5倍以上的卡数。而且HBM供应紧张——国产芯片也需要HBM,全球HBM产能被英伟达锁定了大部分。
中间立场可能是最接近事实的:推理端差距远小于训练端。寒武纪310系列在推理场景的性价比已经可以和英伟达A100/H100竞争,这是寒武纪营收爆发的主因。"超大规模智算集群"如果以推理为主,国产算力确实可以撑住。但如果要大规模训练基础模型,目前做不到——推理是"能用",训练是"不够用"。
国常会的部署没有区分训练和推理——这是一个遗憾。两种场景对算力的需求特征完全不同:推理需要大量中等算力卡,训练需要少量顶级算力卡加上高速互联。政策应该更有针对性,"超大规模推理集群"和"超大规模训练集群"的建设路径、成本结构、技术要求都不一样。
争议三:谁来建谁来管谁来用?
国常会提出"加强人才、资金等要素保障,支持企业开展基础研究和前沿探索",同时要求"深入实施'人工智能+'行动,促进智能产品和服务加快规模化商业应用"。这暗示了一个方向:政府出政策和资金、企业出技术和执行力、市场出应用场景。
但"超大规模智算集群"的建设成本极高。一个万卡集群的基础设施投资(不算芯片本身)需要数十亿元——机房、电力、冷却、网络、存储。加上芯片采购总成本可能超过百亿元。
谁来承担这个成本?政府主导的问题是效率和运营能力——政府机构缺乏AI集群的实际运营经验。企业主导的问题是投资回报周期长——智算集群的商业化运营目前在国内还缺乏成熟模式。目前国内通行做法是"政企合作"——地方政府出地和电、企业出设备和运营。但这种方式下集群的商业化运营能力往往是短板——建完了不知道怎么卖算力。
另一个争议是数据。"强化高质量数据供给"背后的问题是:高质量数据从哪来?公共数据开放程度仍然不够,企业数据跨机构共享的法律框架还不完善,国际数据引入面临各种限制。没有数据集群就是空转——有算力没数据的集群比没有集群更浪费,因为基础设施的折旧成本每天都在发生。
我的判断
国常会这次部署的信号意义大于操作意义。它确认了AI是国家战略优先级、确认了算力集群是基础设施方向、确认了政策支持会持续加码。但具体怎么建、建多大、谁来运营、数据怎么供给——这些关键操作细节还需要后续政策文件补充。
对产业最直接的影响是信心。国常会定调之后,各地政府的智算集群规划会加速推进,国产AI芯片采购需求会更明确,相关企业订单确定性增强。但"超大规模"也暗含风险——如果盲目追求规模忽视利用率和数据质量,结果可能是巨大的算力浪费。英伟达的教训已经说明:算力不是越多越好,而是越有效越好。
来源:新华社(6/29)、新浪财经(6/30)、钛媒体(6/30)、每日经济新闻(6/29)、腾讯新闻(6/30)
从更宏观角度看国常会的AI部署还隐含了一个战略信号中国正在把AI从产业政策提升到国家基础设施层面。超大规模智算集群的定位不是某个企业的产品而是国家基础设施类似于高速公路电力网络通信基站。这个定位意味着建设投入可以更大规模因为算基建而非单纯商业投资运营模式可以更长期基建投资回报周期20到30年政策支持可以更持续基建是国策不是短期补贴。
如果把智算集群类比为国家高速公路网目前中国可能处于修第一条高速的阶段相当于1990年代初的高速公路建设起步期。从第一条到全国网络还需要10到20年。但高速公路的经验也告诉我们前期投入巨大但长期回报更巨大物流效率提升带动的经济增长远超修路成本。智算集群可能也有类似的长期回报逻辑只是这个回报需要更长时间才能兑现。
数据图表5