GPT-5.6三档齐发,却被政府卡了脖子 6月26日到27日,OpenAI悄咪咪地"发布"了GPT-5.6。说是发布,其实更准确的说法是"有限预览"——只有大约20家受信任的合作伙伴拿到了访问权限,普通开发者和用户连API入口都看不到。这件事本身就够蹊跷了,一个商业公司发布新产品,居然要先经过美国政府两个办公室的审核。没错,白宫科技政策办公室和国家网络主任办公室,这两个机构在这次的发布流程里扮演了角色。事情是这样的。OpenAI原本的计划大概率不是这样遮遮掩掩的。从目前流出的信息看,GPT-5.6这次一次性推出了三个档位:Sol(旗舰)、Terra(均衡)、Luna(性价比)。这种三档并行的策略明显是学乖了——过去GPT-5.5那个定价被骂得太惨,这次起码让预算有限的开发者有个Luna可以选。但问题的核心不在这里,而在于这次发布的"受限"性质本身。
先说说这三个模型到底什么水平。Sol Ultra在Terminal-Bench 2.1上跑了91.9%的得分,这个数字是目前已知的全球最高分。作为对比,Claude Mythos 5的成绩是88.0%。Sol标准版也有88.8%,依然压了Mythos 5一头。往下数,Luna是84.3%,Terra反而最低,只有82.5%。这个排序有点意思——你可能会以为Terra作为"均衡档"应该在中游,结果Luna的性价比版本反而比它高。我推测可能是因为Terra的定位比较尴尬,预算够的直接上Sol,预算紧的选Luna,Terra夹在中间反而不讨好,训练资源分配上可能也没给够。入5美元、输出30美元每百万token。这个定价在2026年年中这个时间点上,说实话并不便宜。Claude那边Mythos 5的定价如果参考之前的Mythos系列,大概在Sol的70%左右。
但OpenAI这次的算盘可能是:我性能比你高,定价持平就算良心了。然后Terra是输入2.50美元、输出15美元,Luna是输入1美元、输出6美元。Luna这个档位,如果你只是做一些常规的RAG应用或者客服机器人,其实够用了,84.3%的Terminal-Bench得分也不是闹着玩的。 。根据IT之家和新浪科技的报道,这次的"有限预览"是美国政府要求的。具体是哪两个部门?白宫科技政策办公室(OSTP)和国家网络主任办公室(ONCD)。这两家机构出现在一次商业AI模型发布的流程里,怎么看怎么别扭。OpenAI自己的表态也很微妙,他们说"我们不认为这种政府审核流程应该成为长期默认"——翻译一下就是:我们知道这不对劲,但这次先忍了。这里有几个层面可以聊。第一层是国家安全逻辑。
GPT-5.6的能力,尤其是Sol Ultra那91.9%的Terminal-Bench得分,意味着它在自动化代码生成、网络攻防模拟等场景下的能力已经到了一个让监管者坐不住的程度。你可能会说,Claude Mythos 5也有88.0%啊,为什么Anthropic那边没听说有类似的限制?一个可能的解释是OpenAI的用户规模和应用场景覆盖面远大于Anthropic,GPT的生态渗透更深,一旦出问题波及面更大。另一个可能是OpenAI现在的治理结构——它不是上市公司,但跟微软的关系、跟军方合作的传闻,都让它处在更严格的审查之下。第二层是商业层面的尴尬。OpenAI现在的处境有点像夹在两块磨盘中间:一边是投资者要求它尽快商业化、抢占市场;另一边是政府监管要求在前面设卡。这次有限预览意味着原本计划在6月下旬全面开放的API现在至少要推迟到7月甚至更晚。
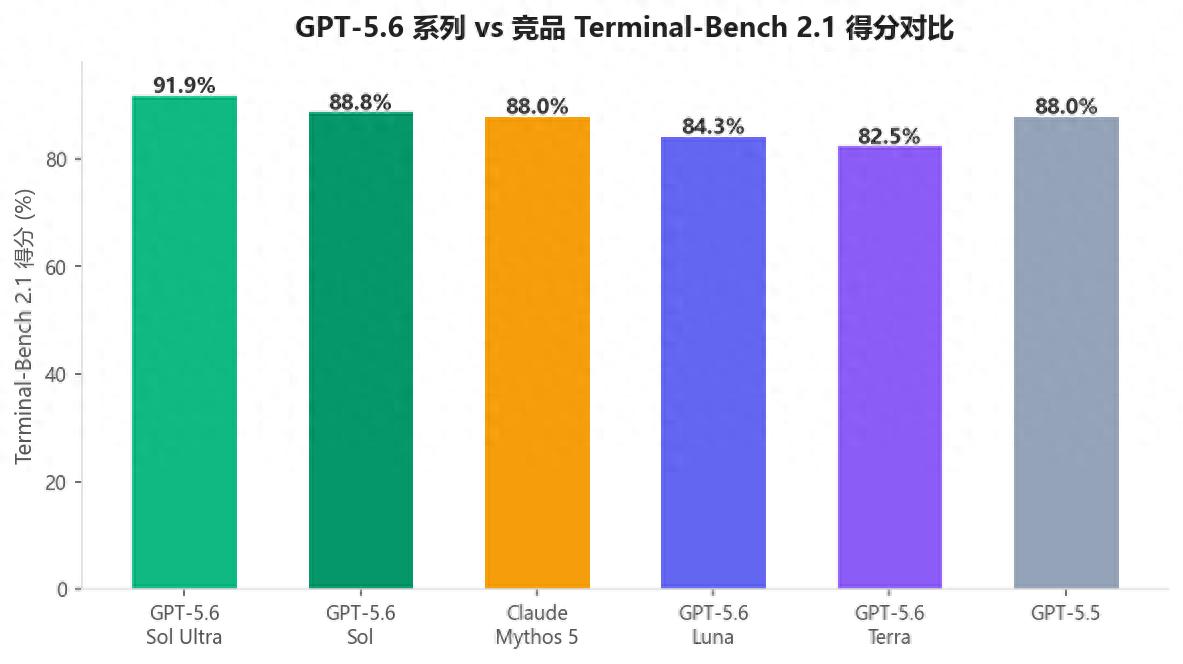
▲ GPT-5.6系列Terminal-Bench 2.1得分对比(数据来源:OpenAI/IT之家 6月27日)
对于那些已经把GPT-5.6纳入Q3技术路线图的创业公司来说,这个变数挺讨厌的。说实话,看到"白宫科技政策办公室审核AI模型发布"这个新闻标题的时候,我第一反应是:这以后会不会变成一个常态?如果答案是会,那硅谷那套"move fast and break things"的创业信条基本上可以进博物馆了。更让我不安的是,这种审核的边界在哪里?谁来决定什么模型"过于强大"而不能公开发布?这批官员里有多少真正懂大模型的?让不懂技术的人来决定技术的发布节奏,这件事本身就很危险。再说说技术层面的亮点。这次GPT-5.6有一个很实在的升级:上下文窗口到了大约150万token,是GPT-5.5的约40万token的3.7倍。这个数字意味着你可以把一整本中等长度的书塞进去,或者一次处理几百页的法律合同。以前做长文档摘要经常要切片处理,现在干脆整本扔进去。
但这里也有一个现实问题:150万token的上下文,你真的用得上吗?绝大多数日常对话和API调用,超过10万token的都很少。这个升级更多是一个"军备竞赛"式的参数炫耀,实际落地场景还需要时间挖掘。 。一个是新的Max推理模式加上Ultra子代理模式。这个Ultra子代理的意思是,Sol Ultra可以把自己拆成多个子任务并行推理,然后再汇总结果。这个设计思路有点像人类专家团队协作:一个首席专家把问题分解,几个副手分别深入研究各自的部分,最后首席专家综合得出结论。从效率角度看这是个很好的方向,但代价是消耗更多的token——如果你是按输出token数计费的,用Ultra子代理模式可能会让你的API账单突然胖一圈。另一个是性能效率的改进。根据OpenAI提供的测试数据,在GeneBench v1上,GPT-5.6用比GPT-5.5更少的token达到了更好的结果。
ExploitBench上,GPT-5.6用大约三分之一的输出token达到了跟Mythos Preview差不多的性能。这两个数据加在一起说明一个问题:GPT-5.6不仅仅是在"更大"的方向上走,它也在"更聪明地用token"这个方向上有进步。这对于成本敏感的开发来说是个好消息,因为输出token通常是API账单里最贵的部分。 7月份还有一个值得期待的节点:Cerebras部署。Cerebras的芯片架构跟NVIDIA的GPU很不一样,它是 wafer-scale 的设计,单一芯片就有整张晶圆那么大。部署在Cerebras上的GPT-5.6预计能达到750 token每秒的生成速度。这个数字如果属实,那是真的快——目前H100上跑GPT-5.5大概在100-200 token/s的量级,750是一个很大的飞跃。但Cerebras的产能一直是问题,能覆盖多少用户要打一个问号。
我看到有人说这次政府限制发布是"美国自己的监管在拖后腿",中国公司会趁机追上。我不太认同这个看法。且不论技术差距的问题,单说这件事反映出的本质:当一个AI系统的能力达到某个阈值之后,它就不纯粹是一个商业产品了,它变成了一个带有公共属性的基础设施。这个转变是所有AI公司最终都要面对的。OpenAI先撞上去了,不代表别人就不会撞。与其幸灾乐祸,不如想想如果换作是国内的大模型公司,遇到同样的情况会怎么处理。训练数据截止时间是2026年5月,这个信息也很重要。这意味着GPT-5.6对2026年上半年的世界有一定的了解,包括DeepSeek-R2的发布、全球AI监管的动态等等。但如果你问它2026年6月底的事情,它大概率还是会说"我的训练数据截止到2026年5月"。这是大模型的通病,不是GPT-5.6特有的,但每次新模型发布总有人忘记这一点。最后说一个细节。
OpenAI这次没有做大规模的营销造势,甚至连个像样的发布直播都没搞。这跟GPT-5.5发布时的高调形成鲜明对比。我估计他们自己也没想到政府审核这一茬会拖这么久,搞得发布会都开不痛快。有限预览大概会持续几周,如果审核流程顺利的话,7月中下旬应该能看到更广泛的开放。到时候Sol的API能不能顶住流量高峰,又是一个问题——GPT-5.5发布那天API挂了好几个小时,这次OpenAI应该不会在同一个坑里摔两次吧,应该不会吧…… 我个人的判断是:这次"政府卡脖子"事件,短期来看是OpenAI的麻烦,长期来看可能是整个AI行业的一个分水岭。以前大家默认的逻辑是:我有更好的模型,我就能更快地推向市场。以后这个逻辑可能要加一个前置条件:前提是政府允许我推。这个变化对创业公司的影响尤其大,因为创业公司不像大公司那样有资源去应付复杂的合规流程。
以后AI领域的创新节奏,可能不再只由算力、数据和算法决定,还要加上一个"监管节奏"的变量。
· · ·