用 60 张图,从零构建接近业界顶尖性能的 B200 Attention 内核项目地址:github.com/IaroslavElistratov/b200-attention配套博文:iaroslavelistratov.github.io/b200-attention/
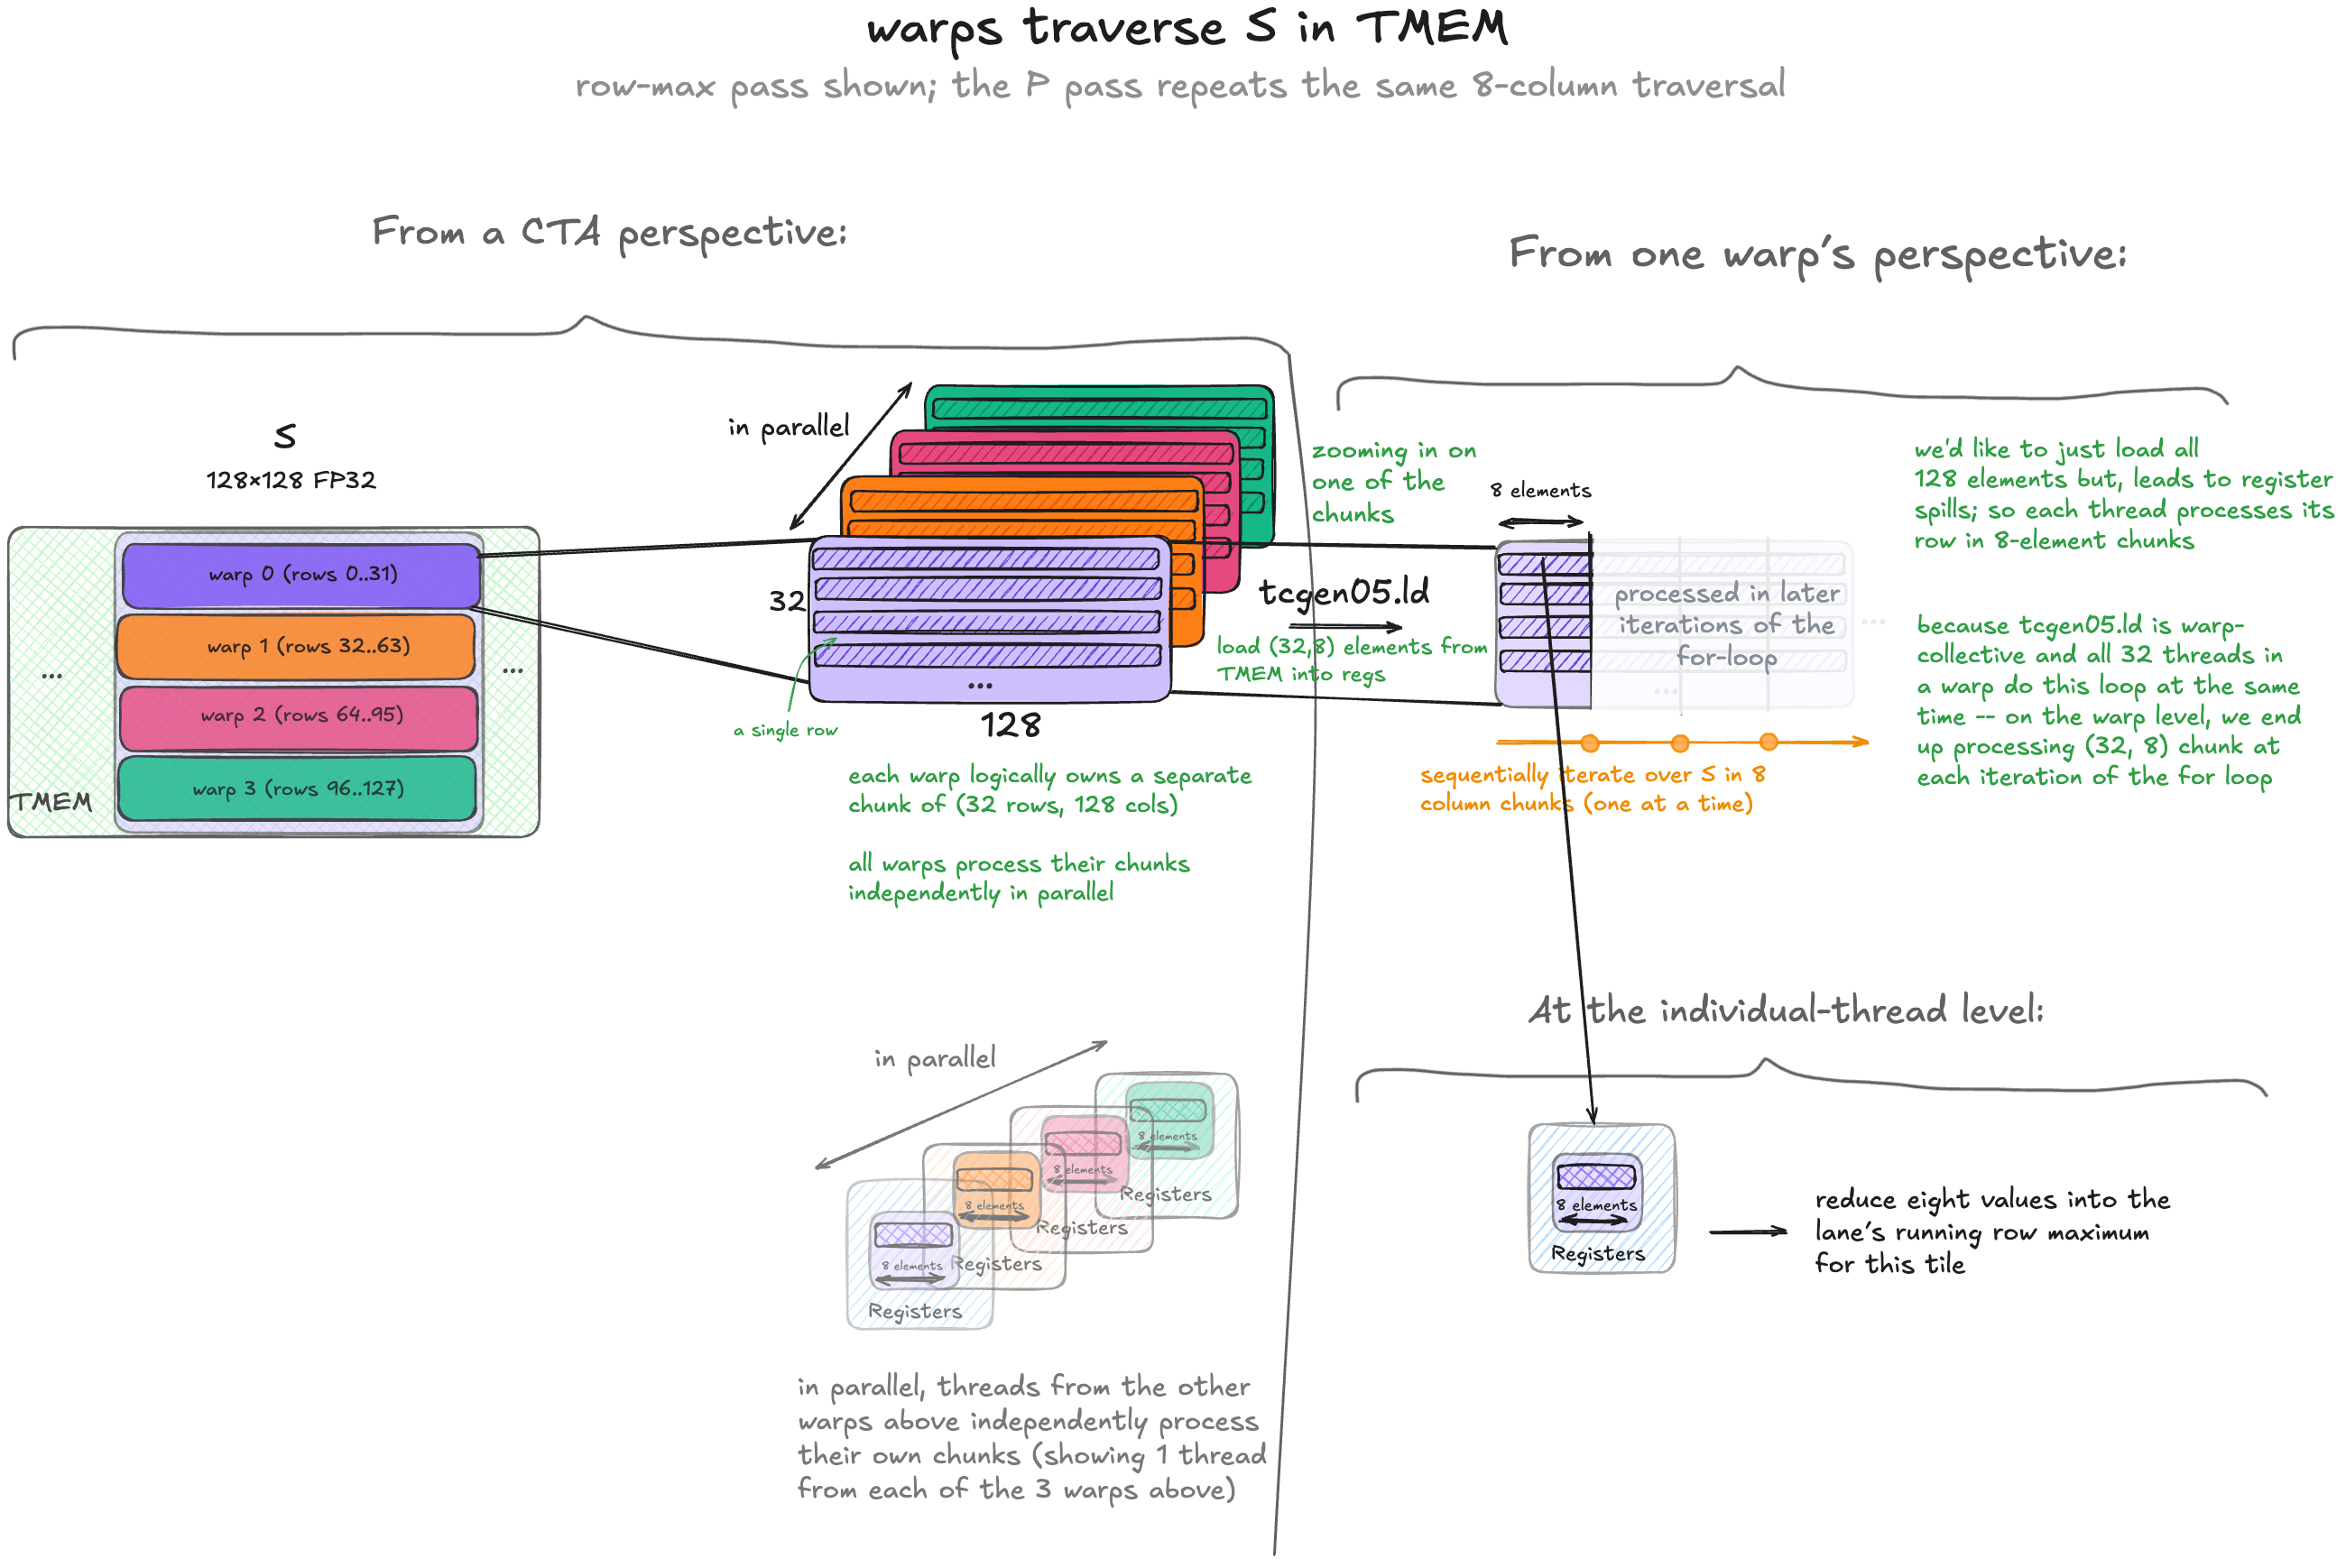
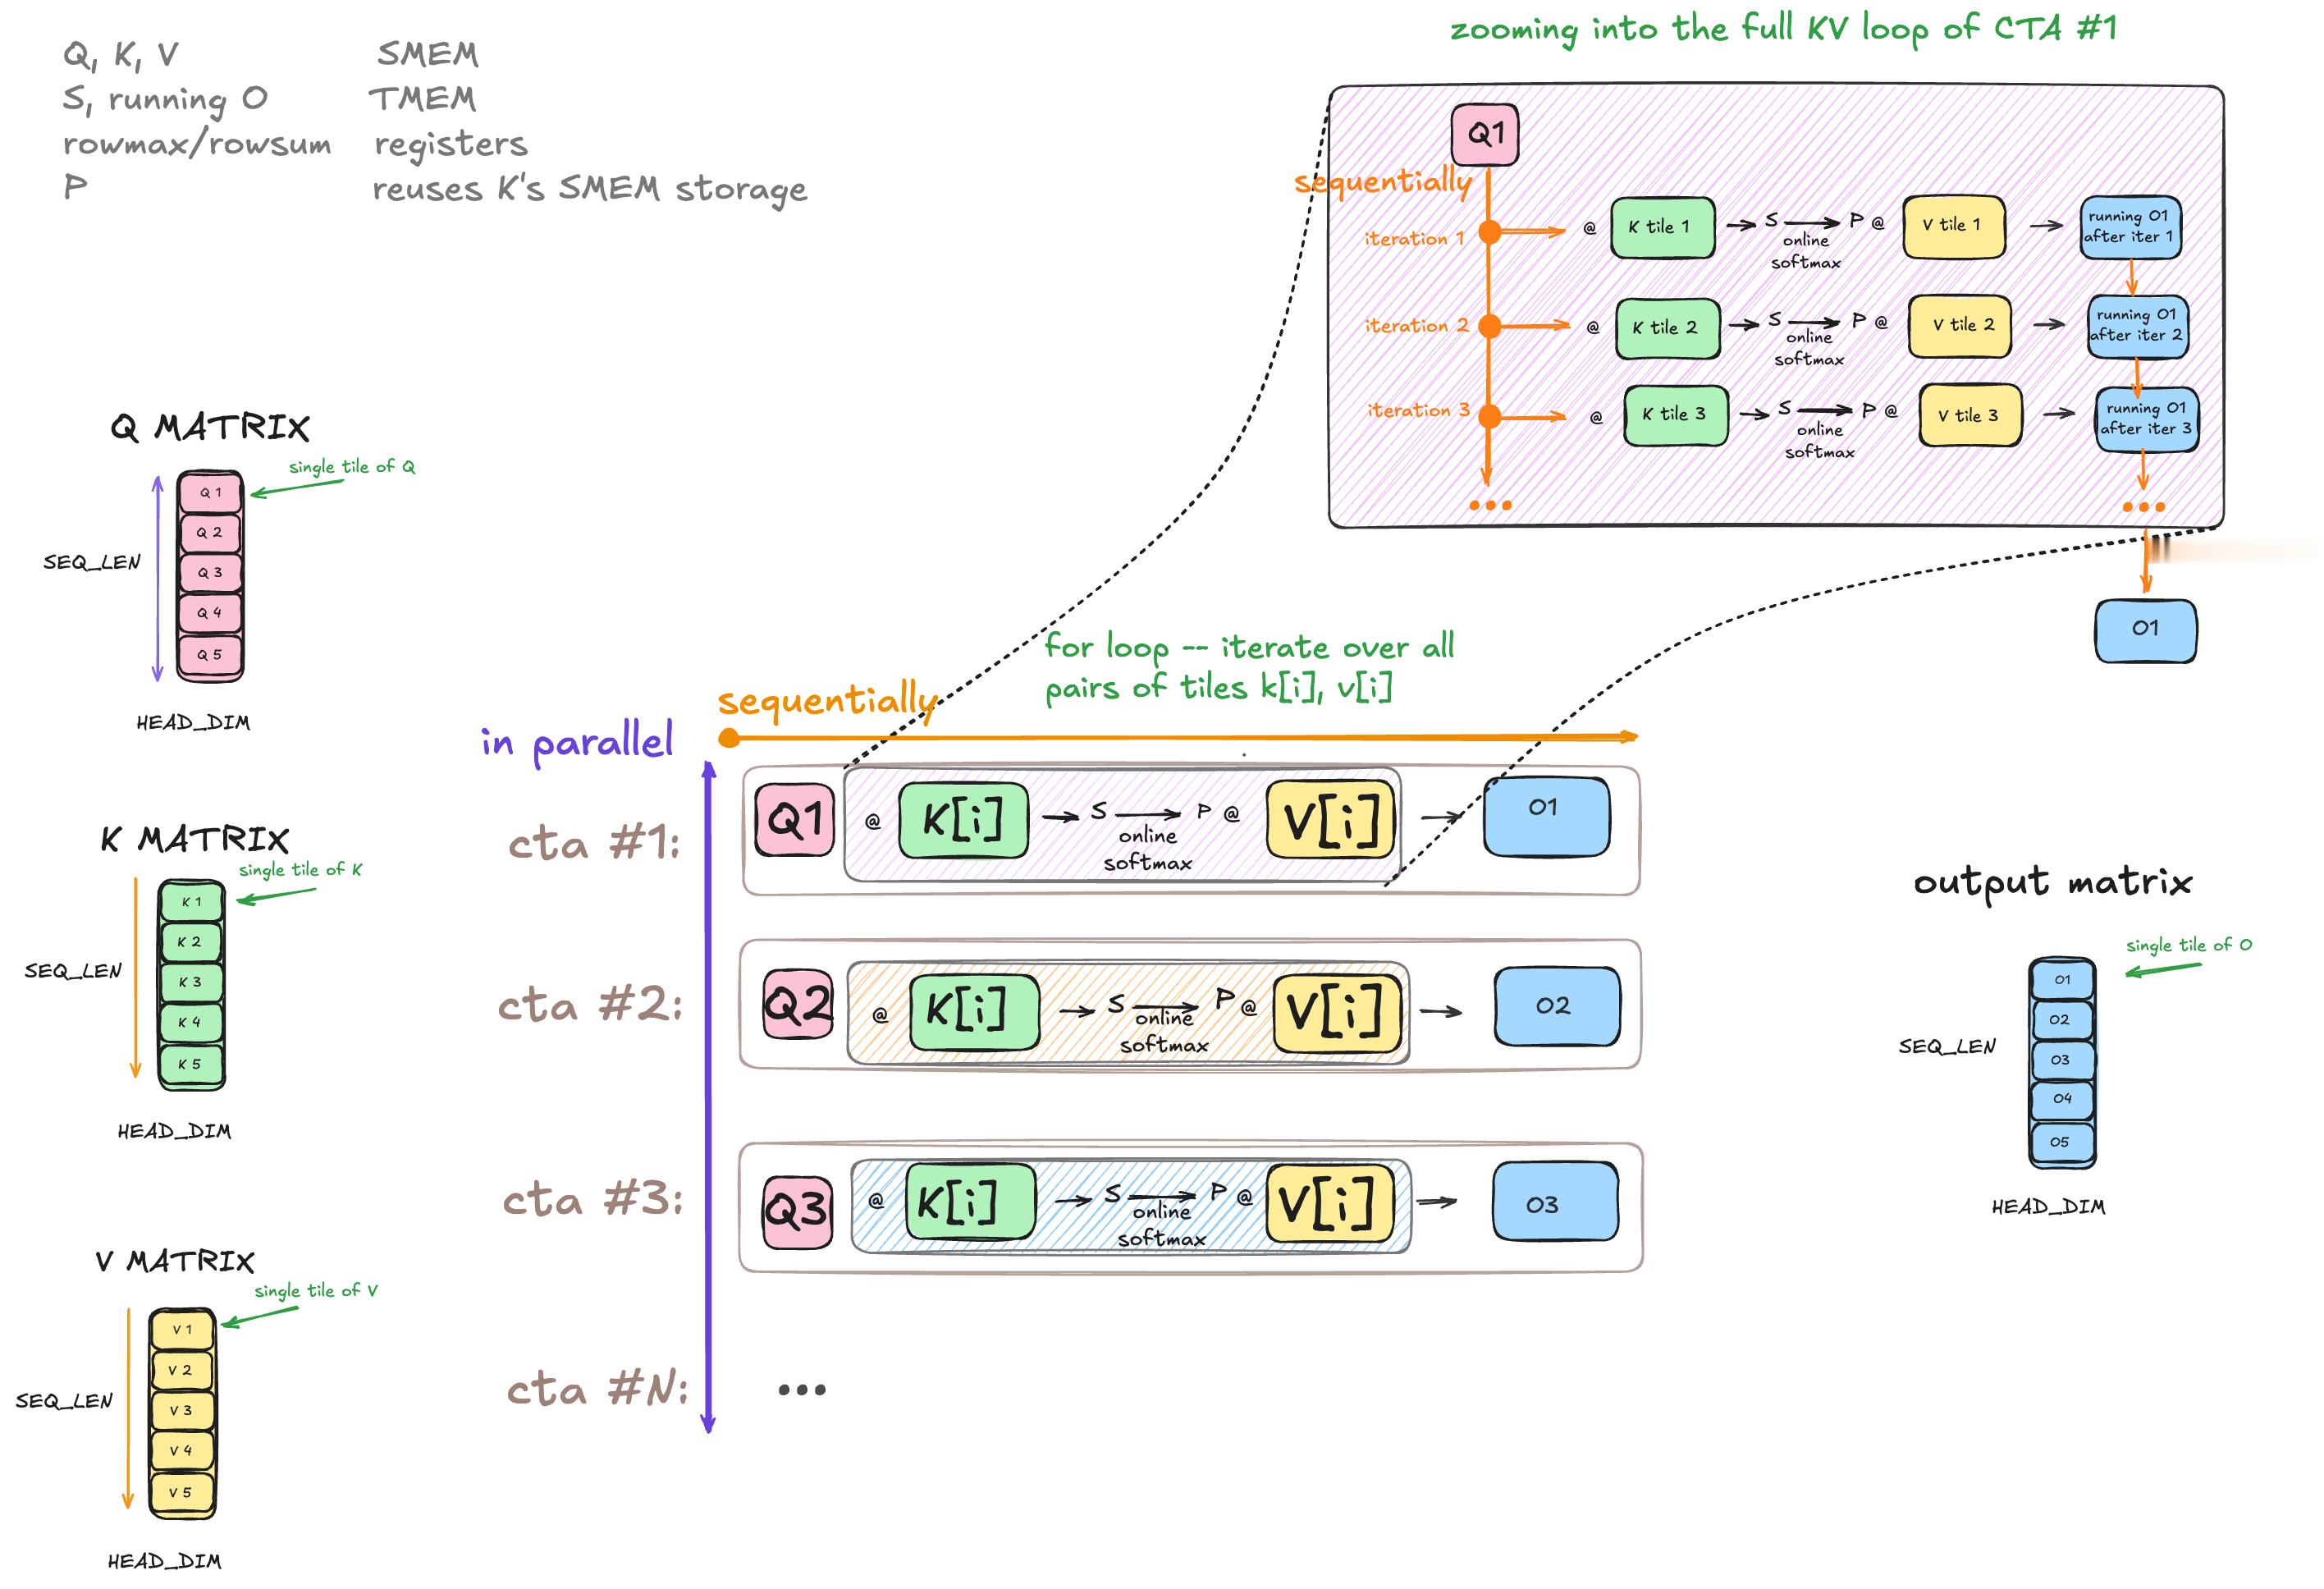
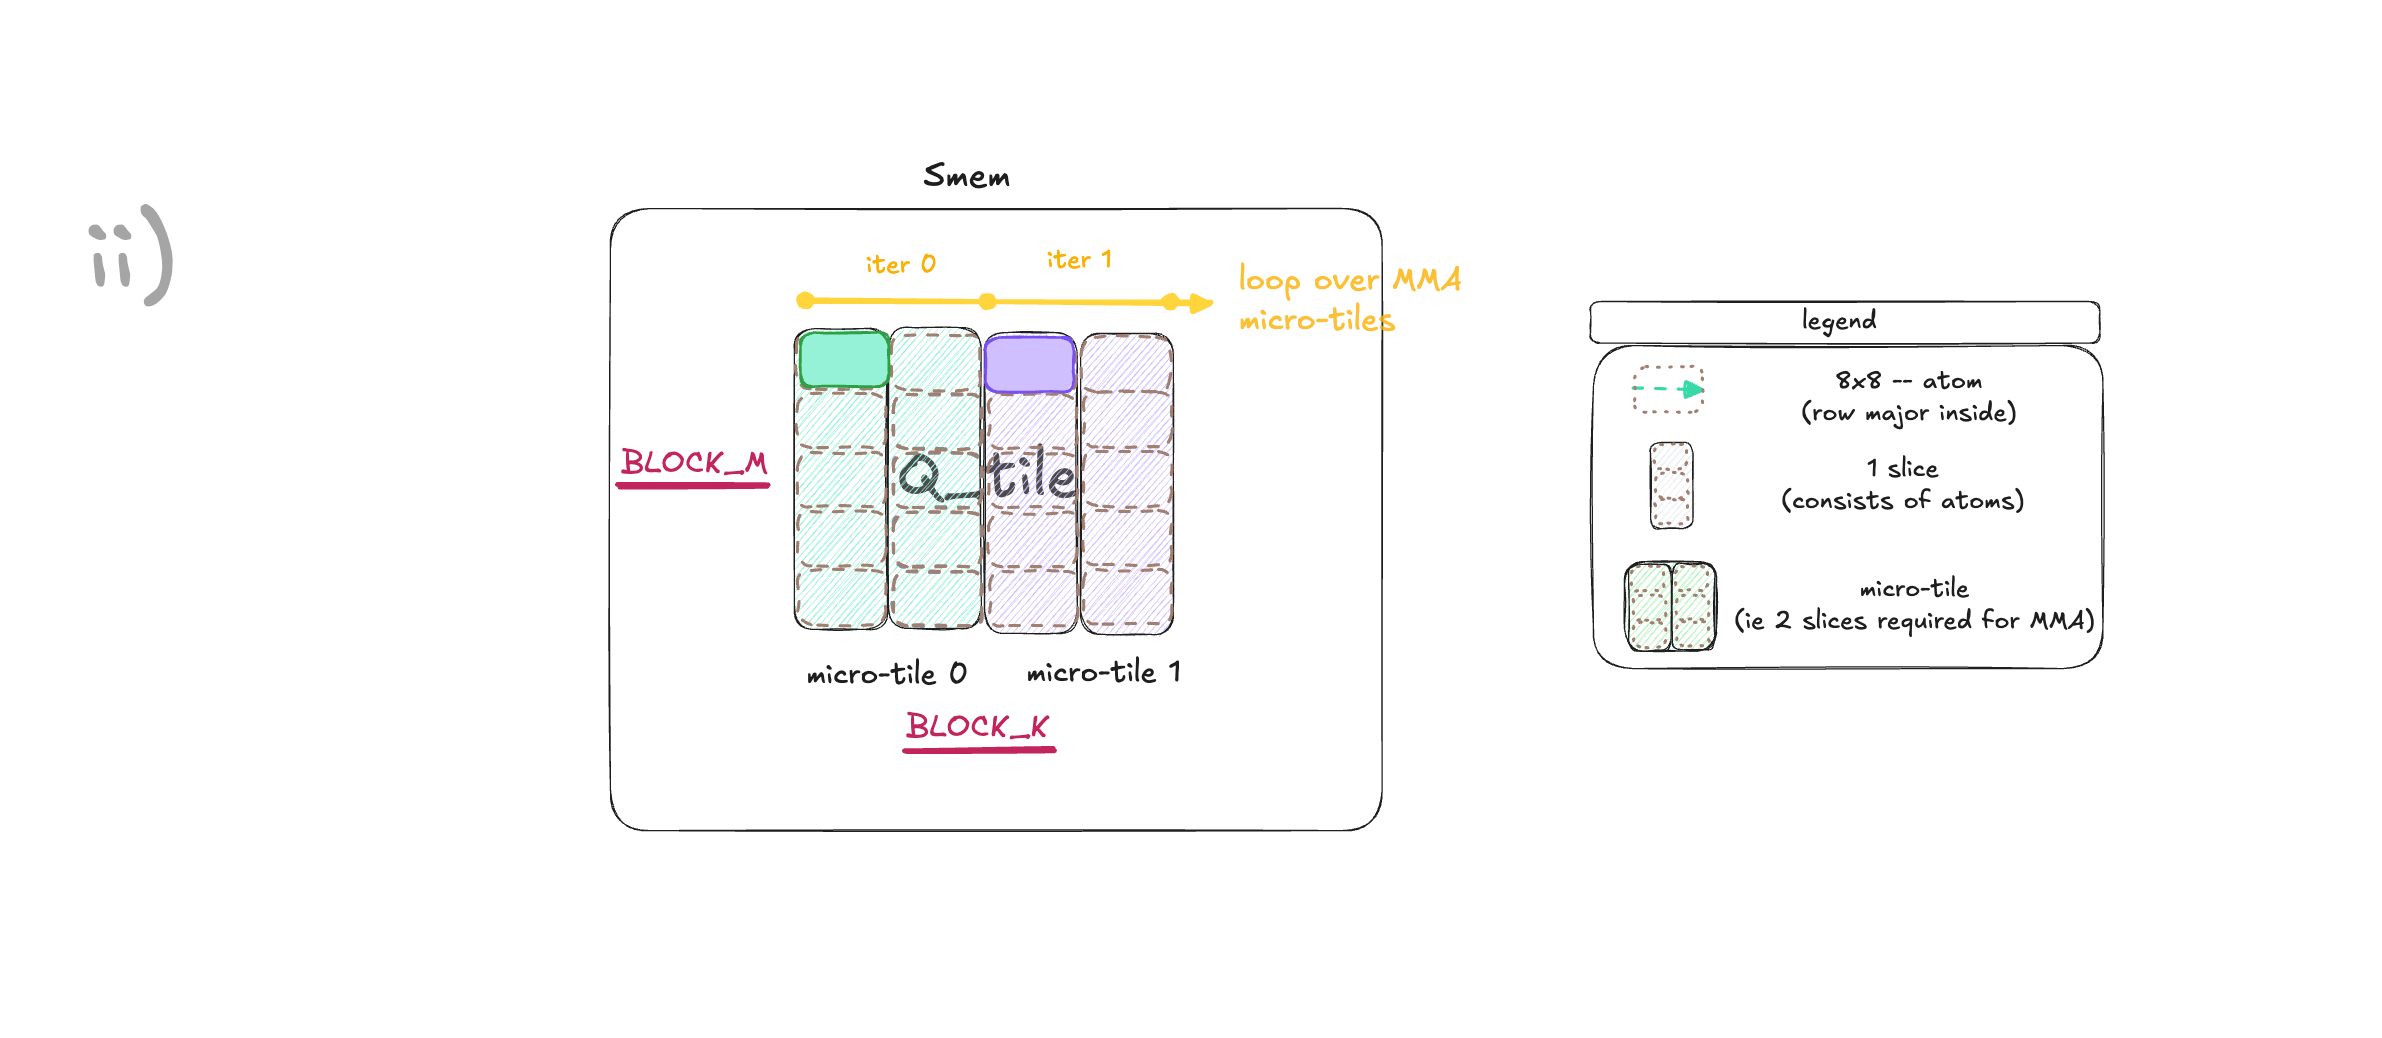
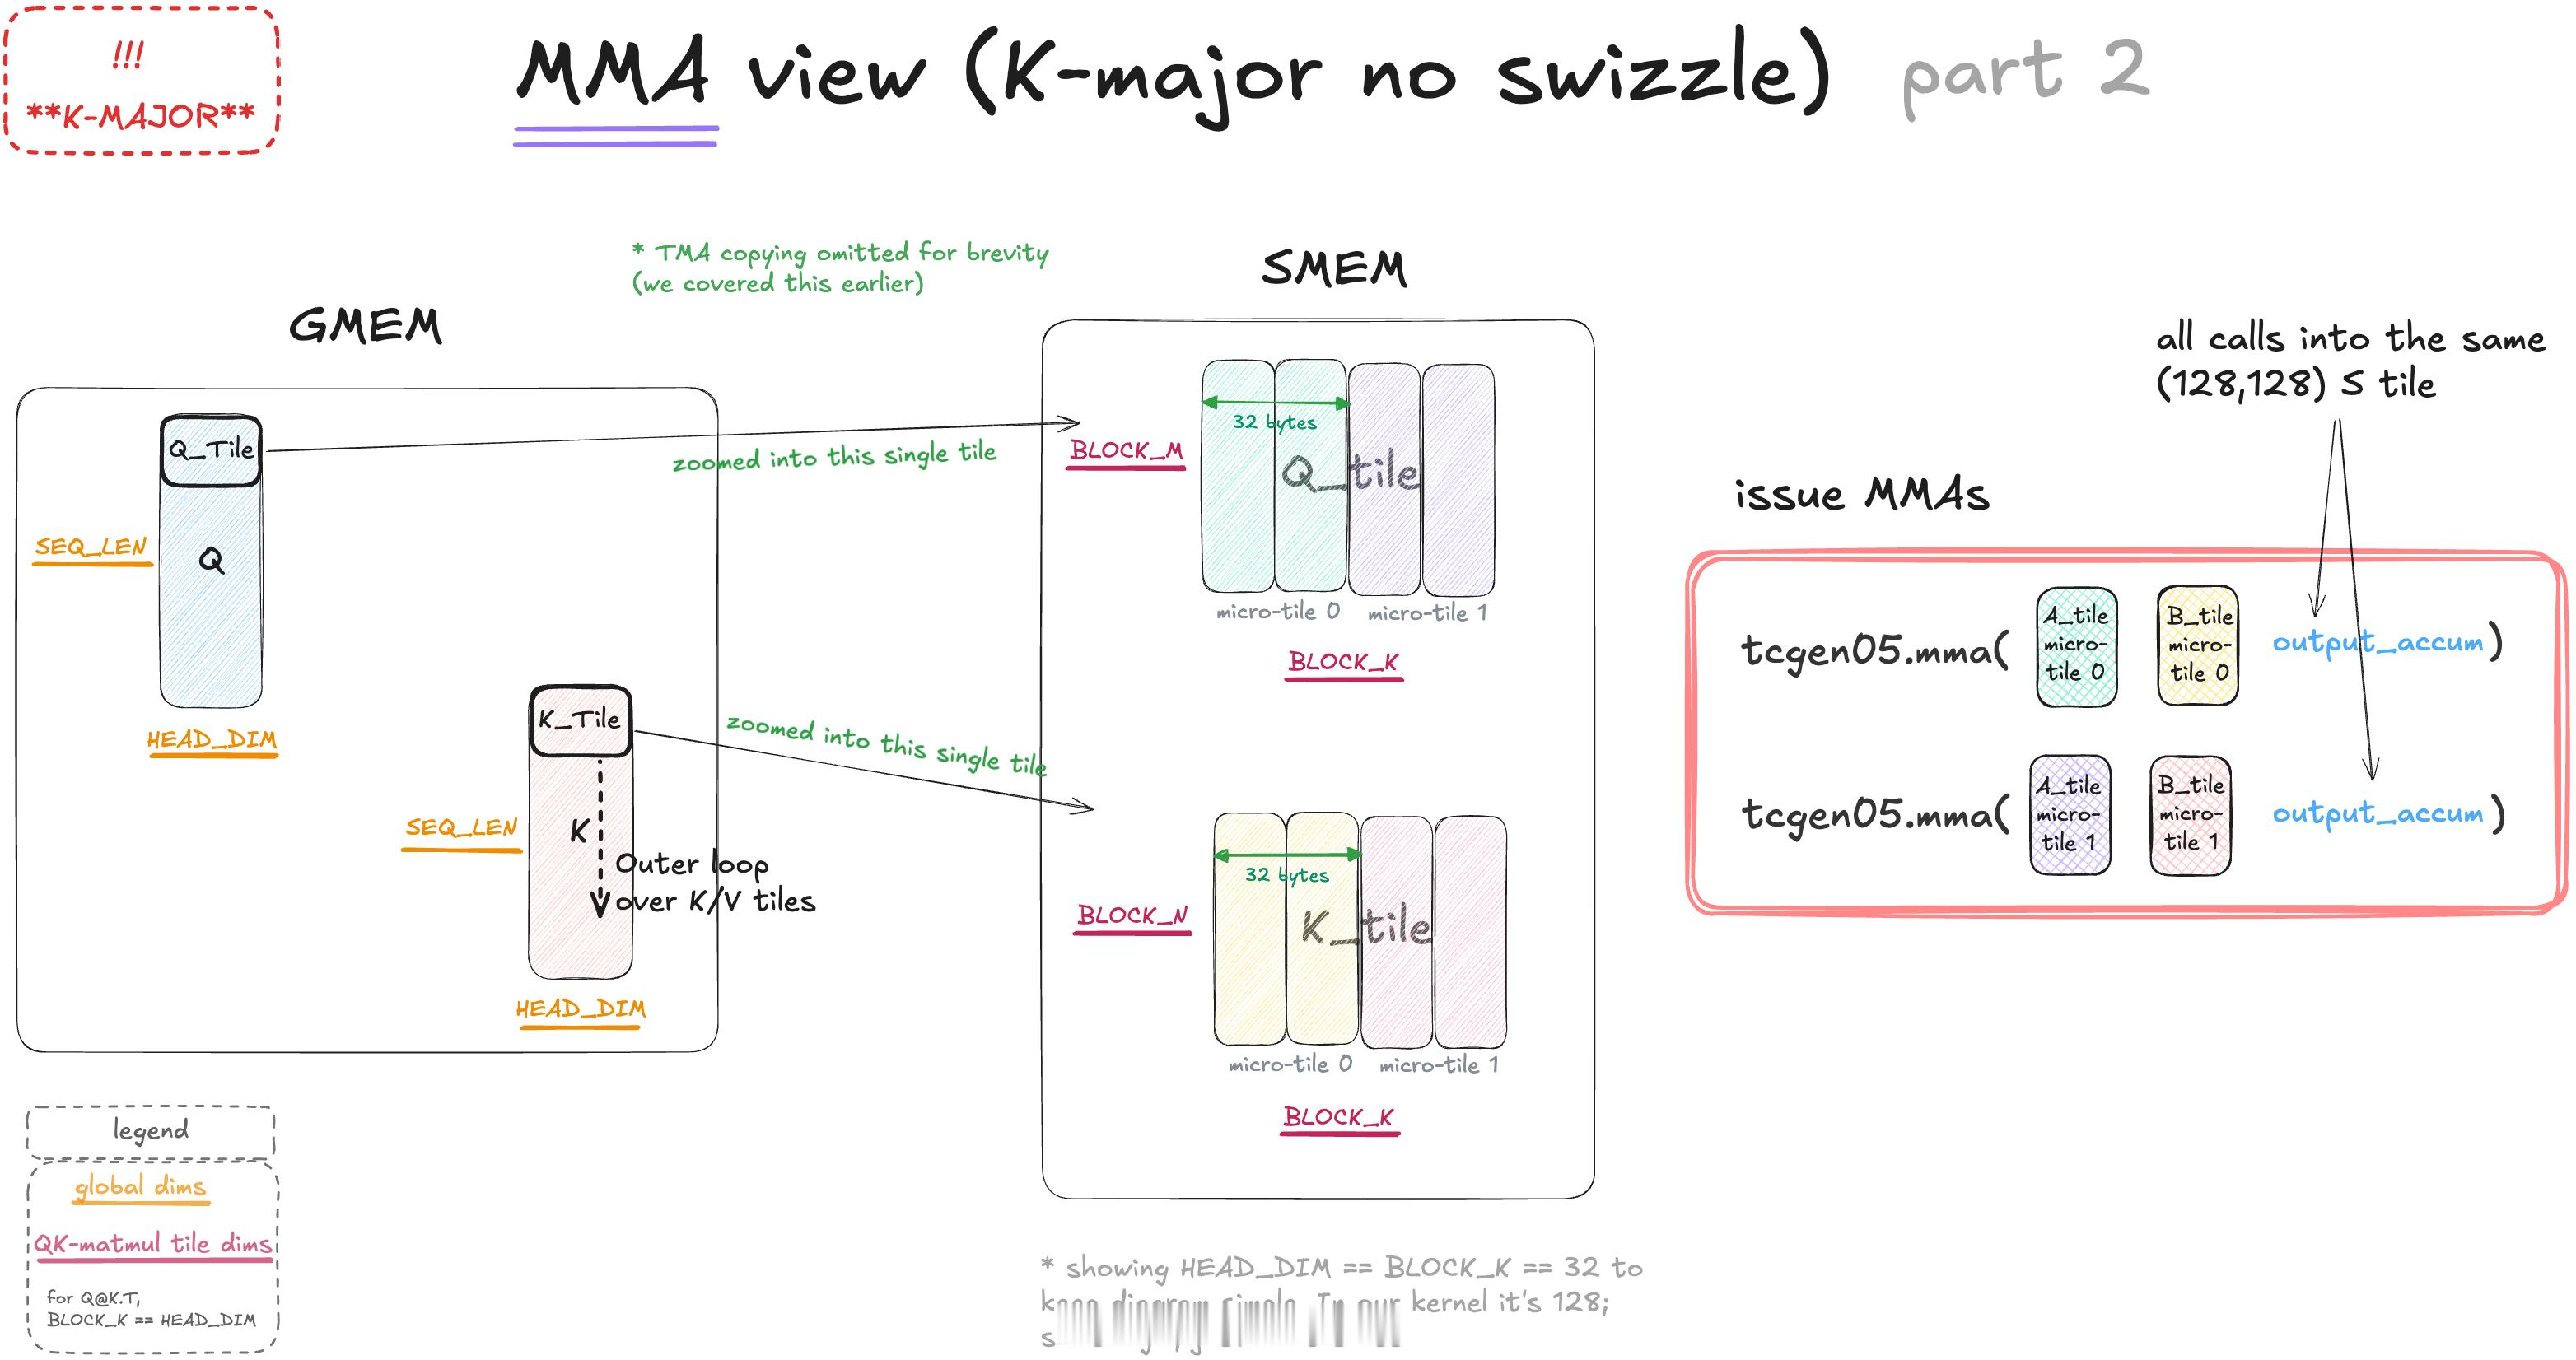
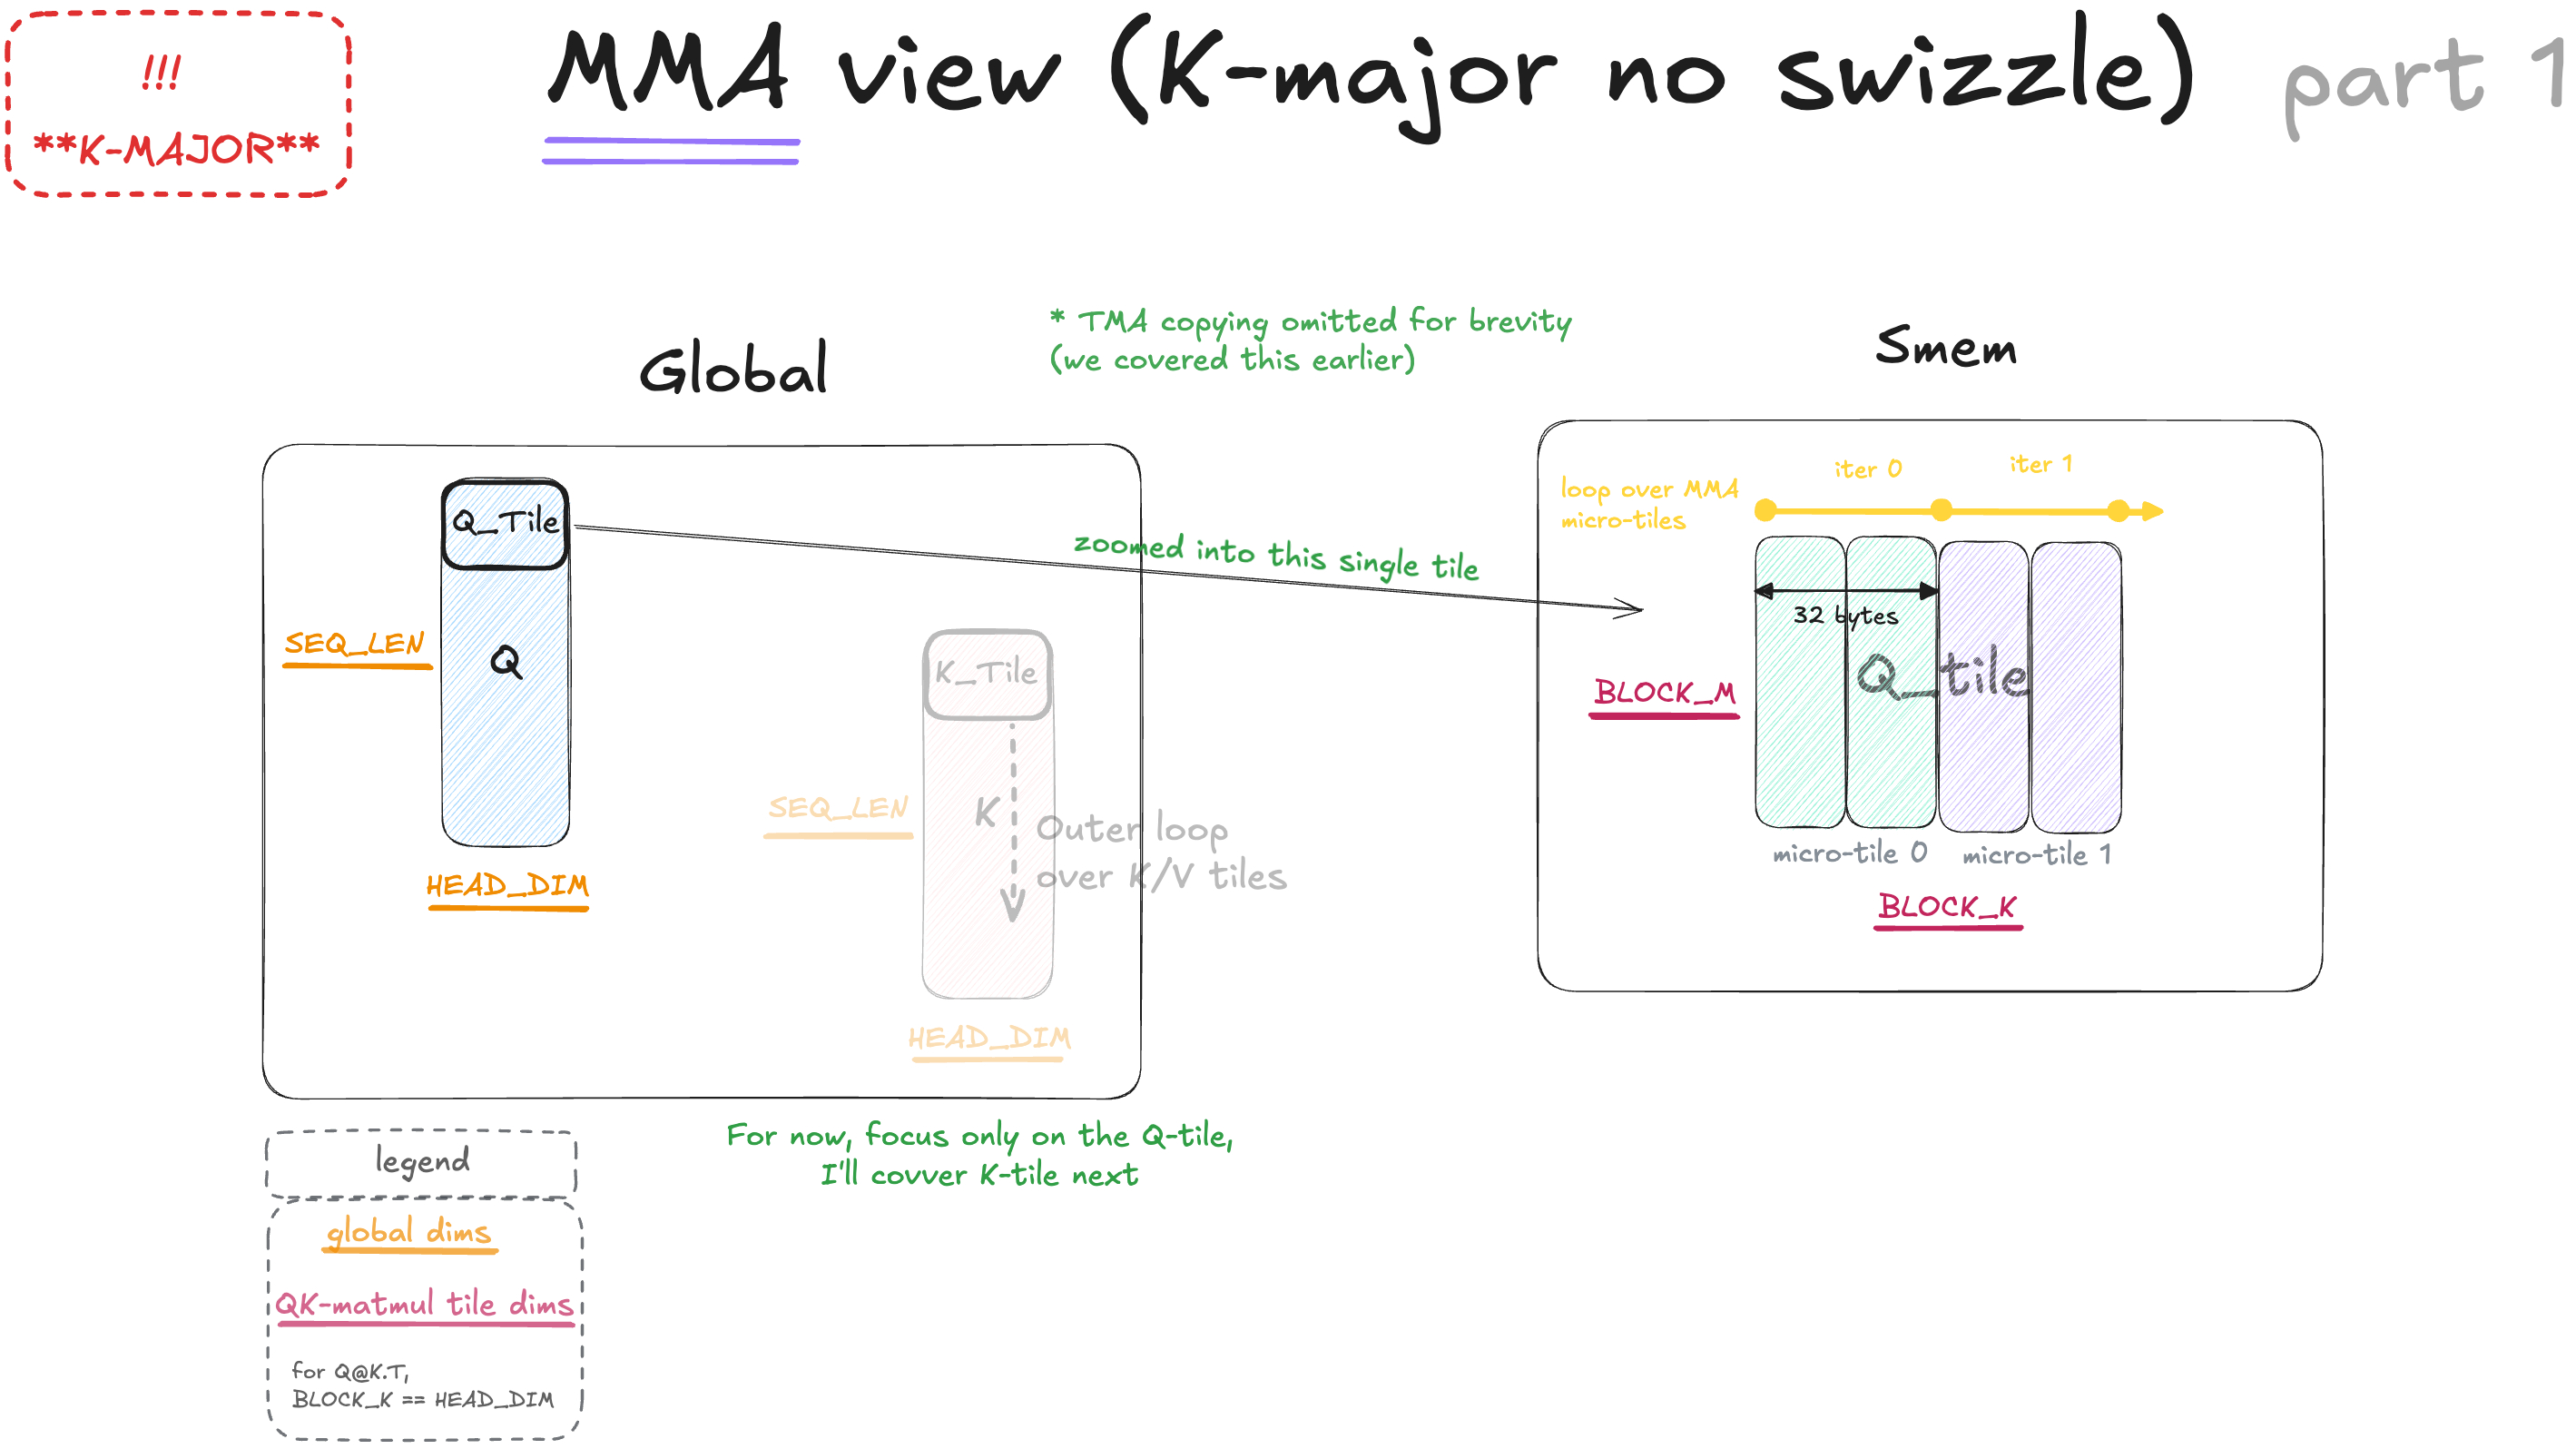
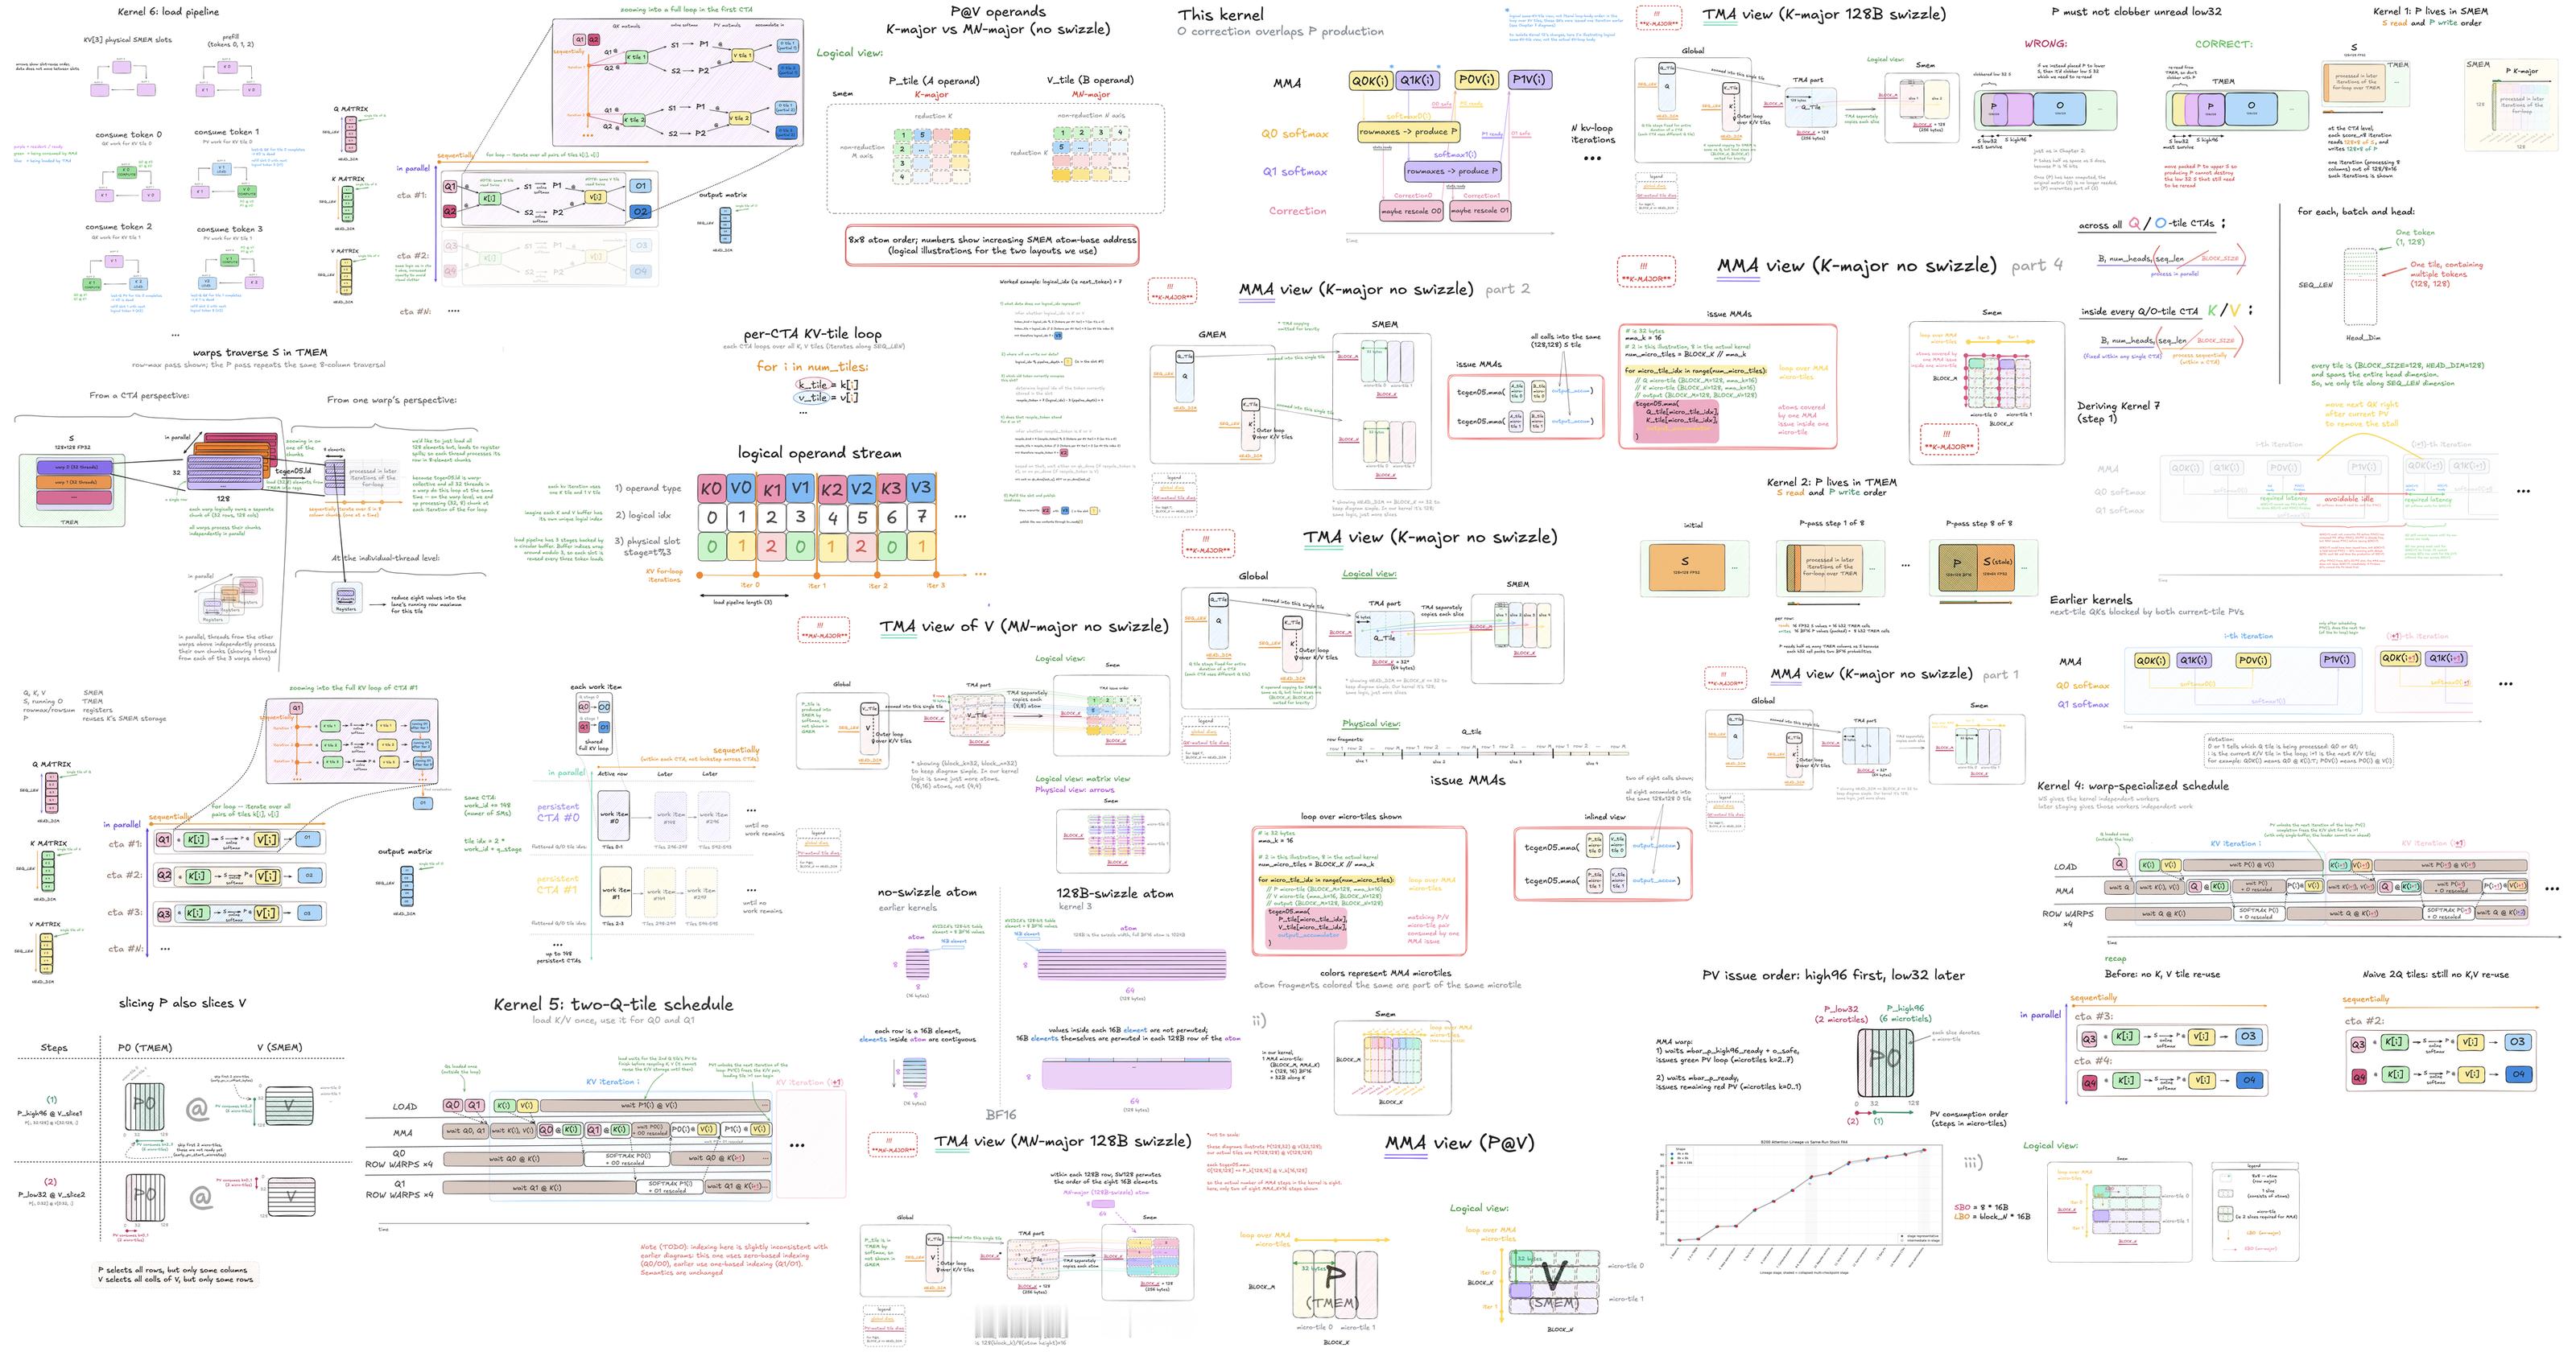
本文将使用 CUDA 和少量 PTX,从零构建一个面向 B200 的稠密注意力内核,并在 FA4 论文使用的 4K、8K 和 16K 测试形状上达到 FlashAttention-4 约 94.4% 的性能。文章的主要贡献是一套由 60 张图组成、相对适合初学者的可视化指南:先建立对朴素内核的直观理解,再逐项加入优化,并配合简洁说明和代码。最后还会把完成的内核接入视频生成模型。文章重点不是榨取最后几个百分点,而是为读者理解最新硬件上的注意力内核、开展自己的 GPU 内核研究打下基础。读者应了解注意力机制和 online softmax,并具备基本 CUDA 知识,但不要求预先熟悉 Blackwell,也不需要自己拥有 B200。