DC娱乐网
蚁工厂的文章
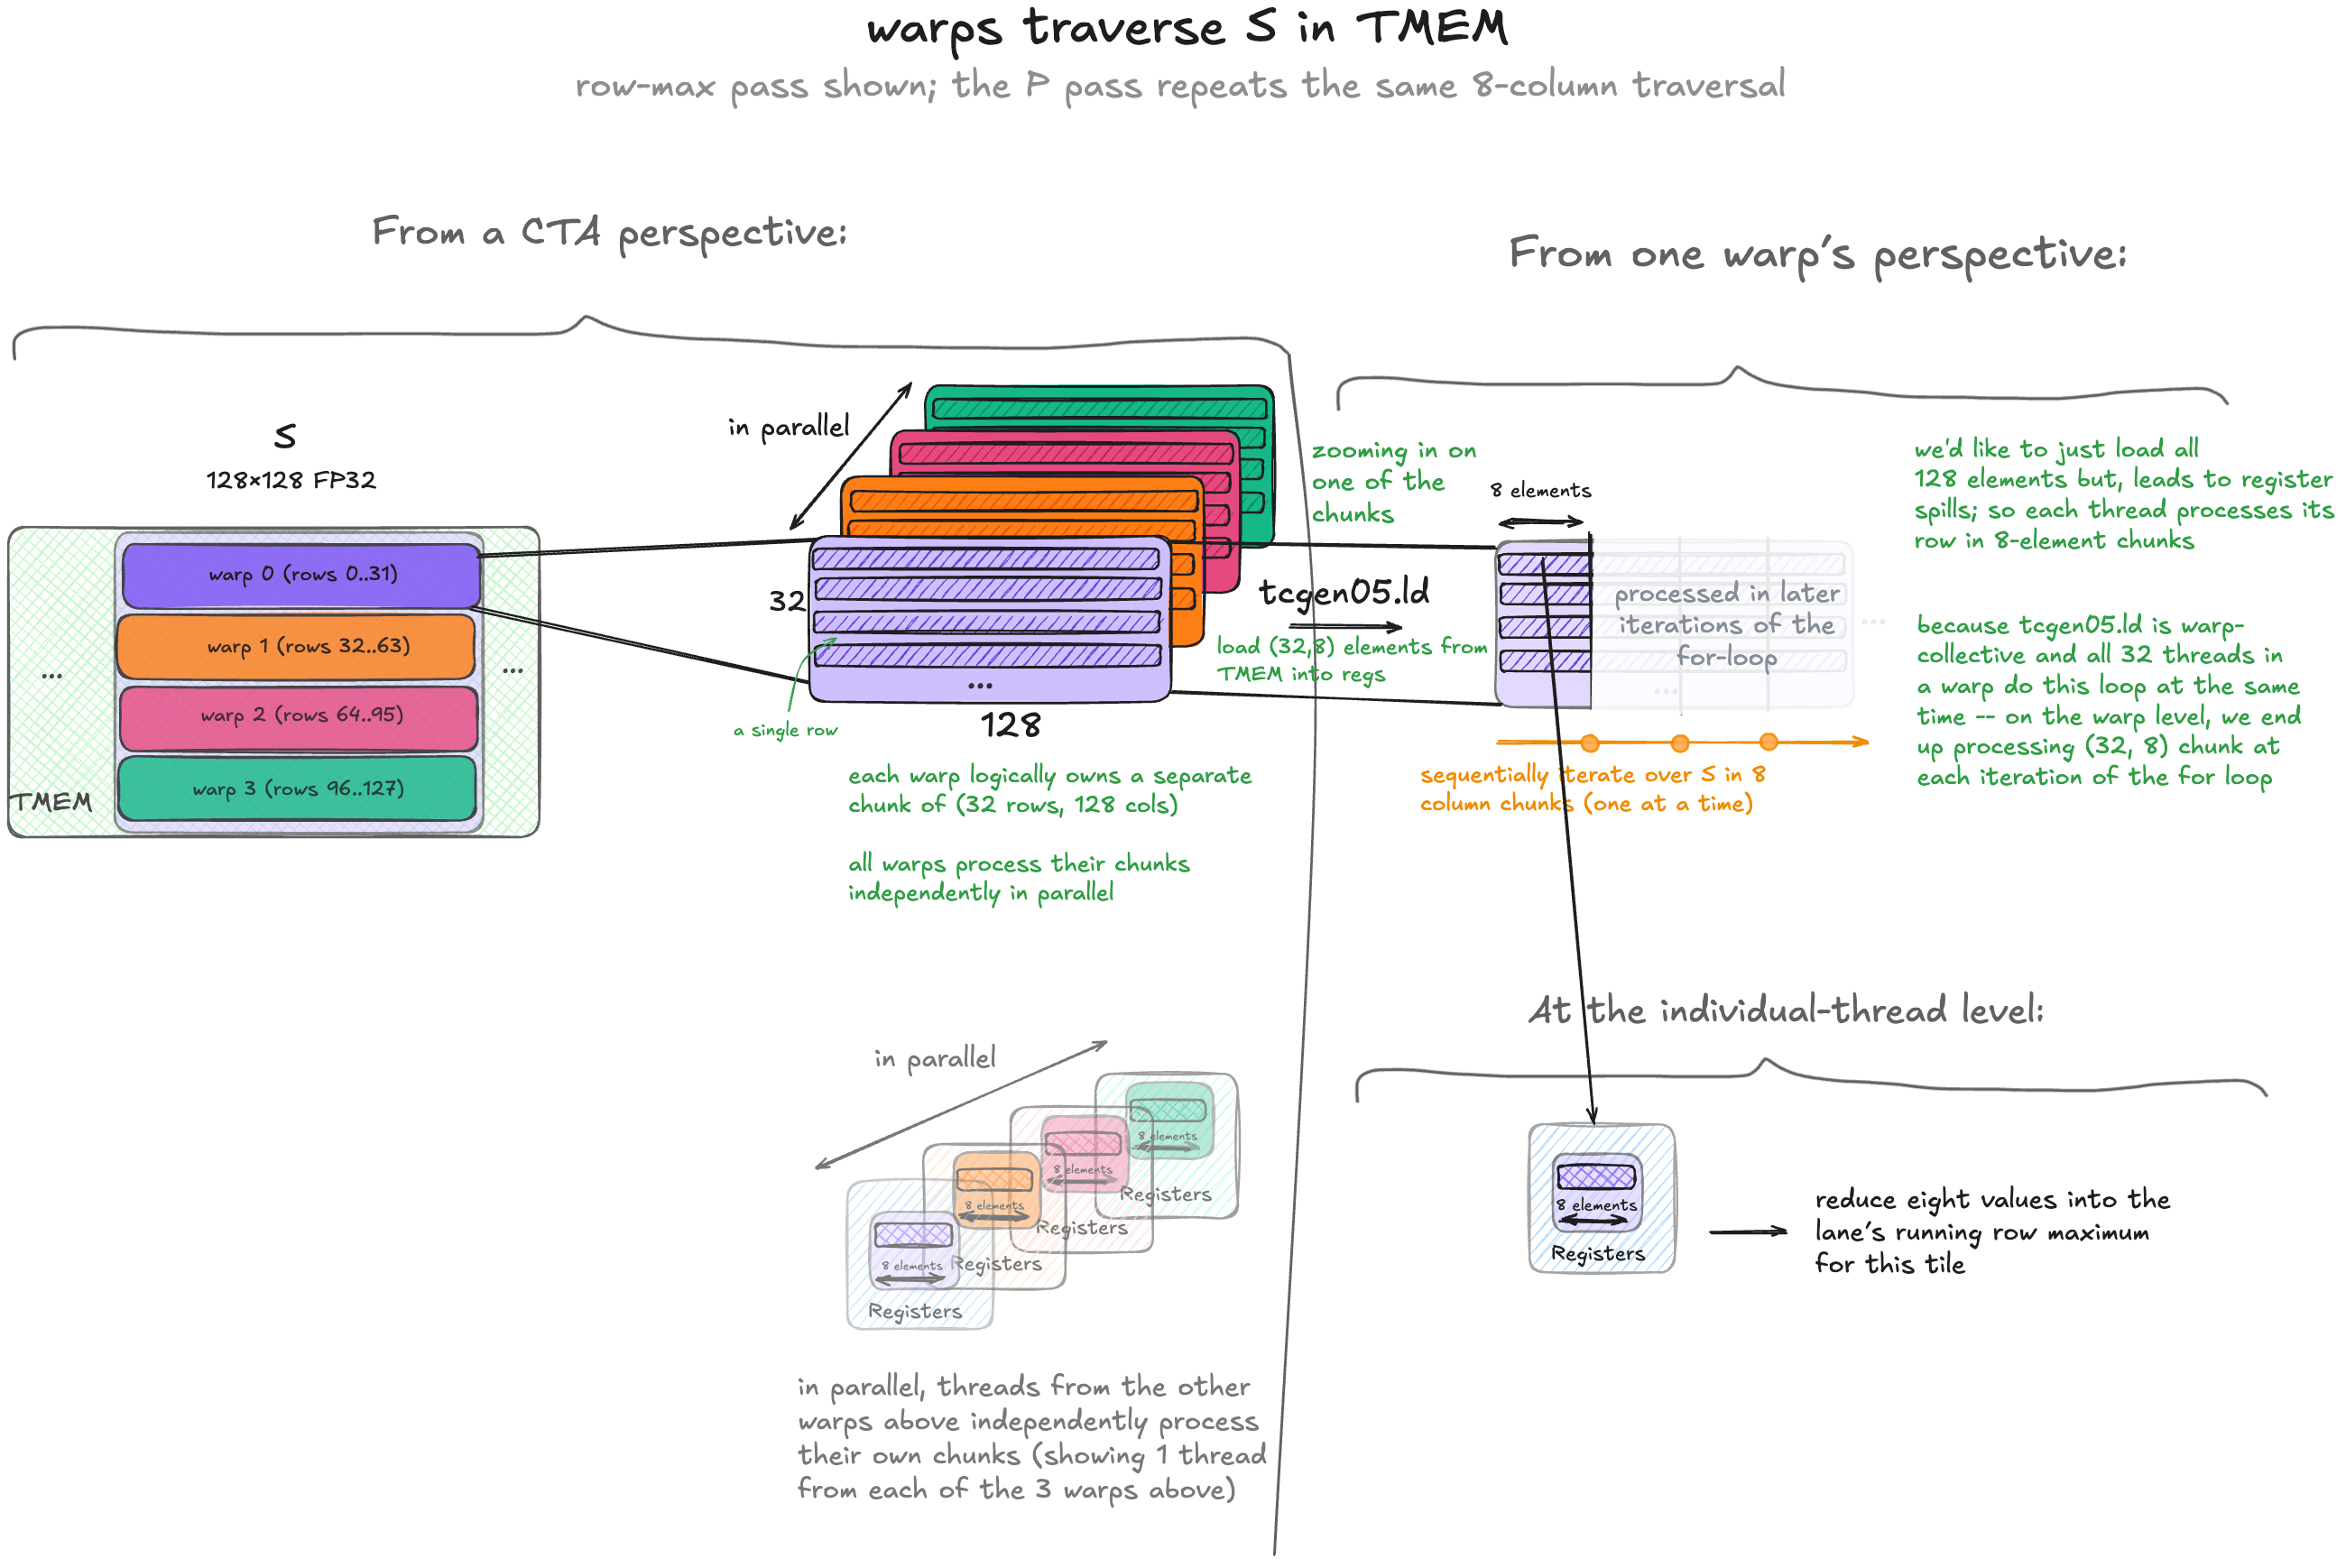
用 60 张图,从零构建接近业界顶尖性能的 B200 Attention 内核项
2026-09-15 08:39
用 60 张图,从零构建接近业界顶尖性能的 B200 Attention 内核项
DeepSeek研究员 “intlsy的狗窝”: 我不得不把才华埋葬在昨天网页链
2026-09-15 08:38
DeepSeek研究员 “intlsy的狗窝”: 我不得不把才华埋葬在昨天网页链
不知算不算冷知识:费曼学习法不是费曼发明和实践的。。是另一个叫Scott H.
2026-09-15 08:38
不知算不算冷知识:费曼学习法不是费曼发明和实践的。。是另一个叫Scott H.
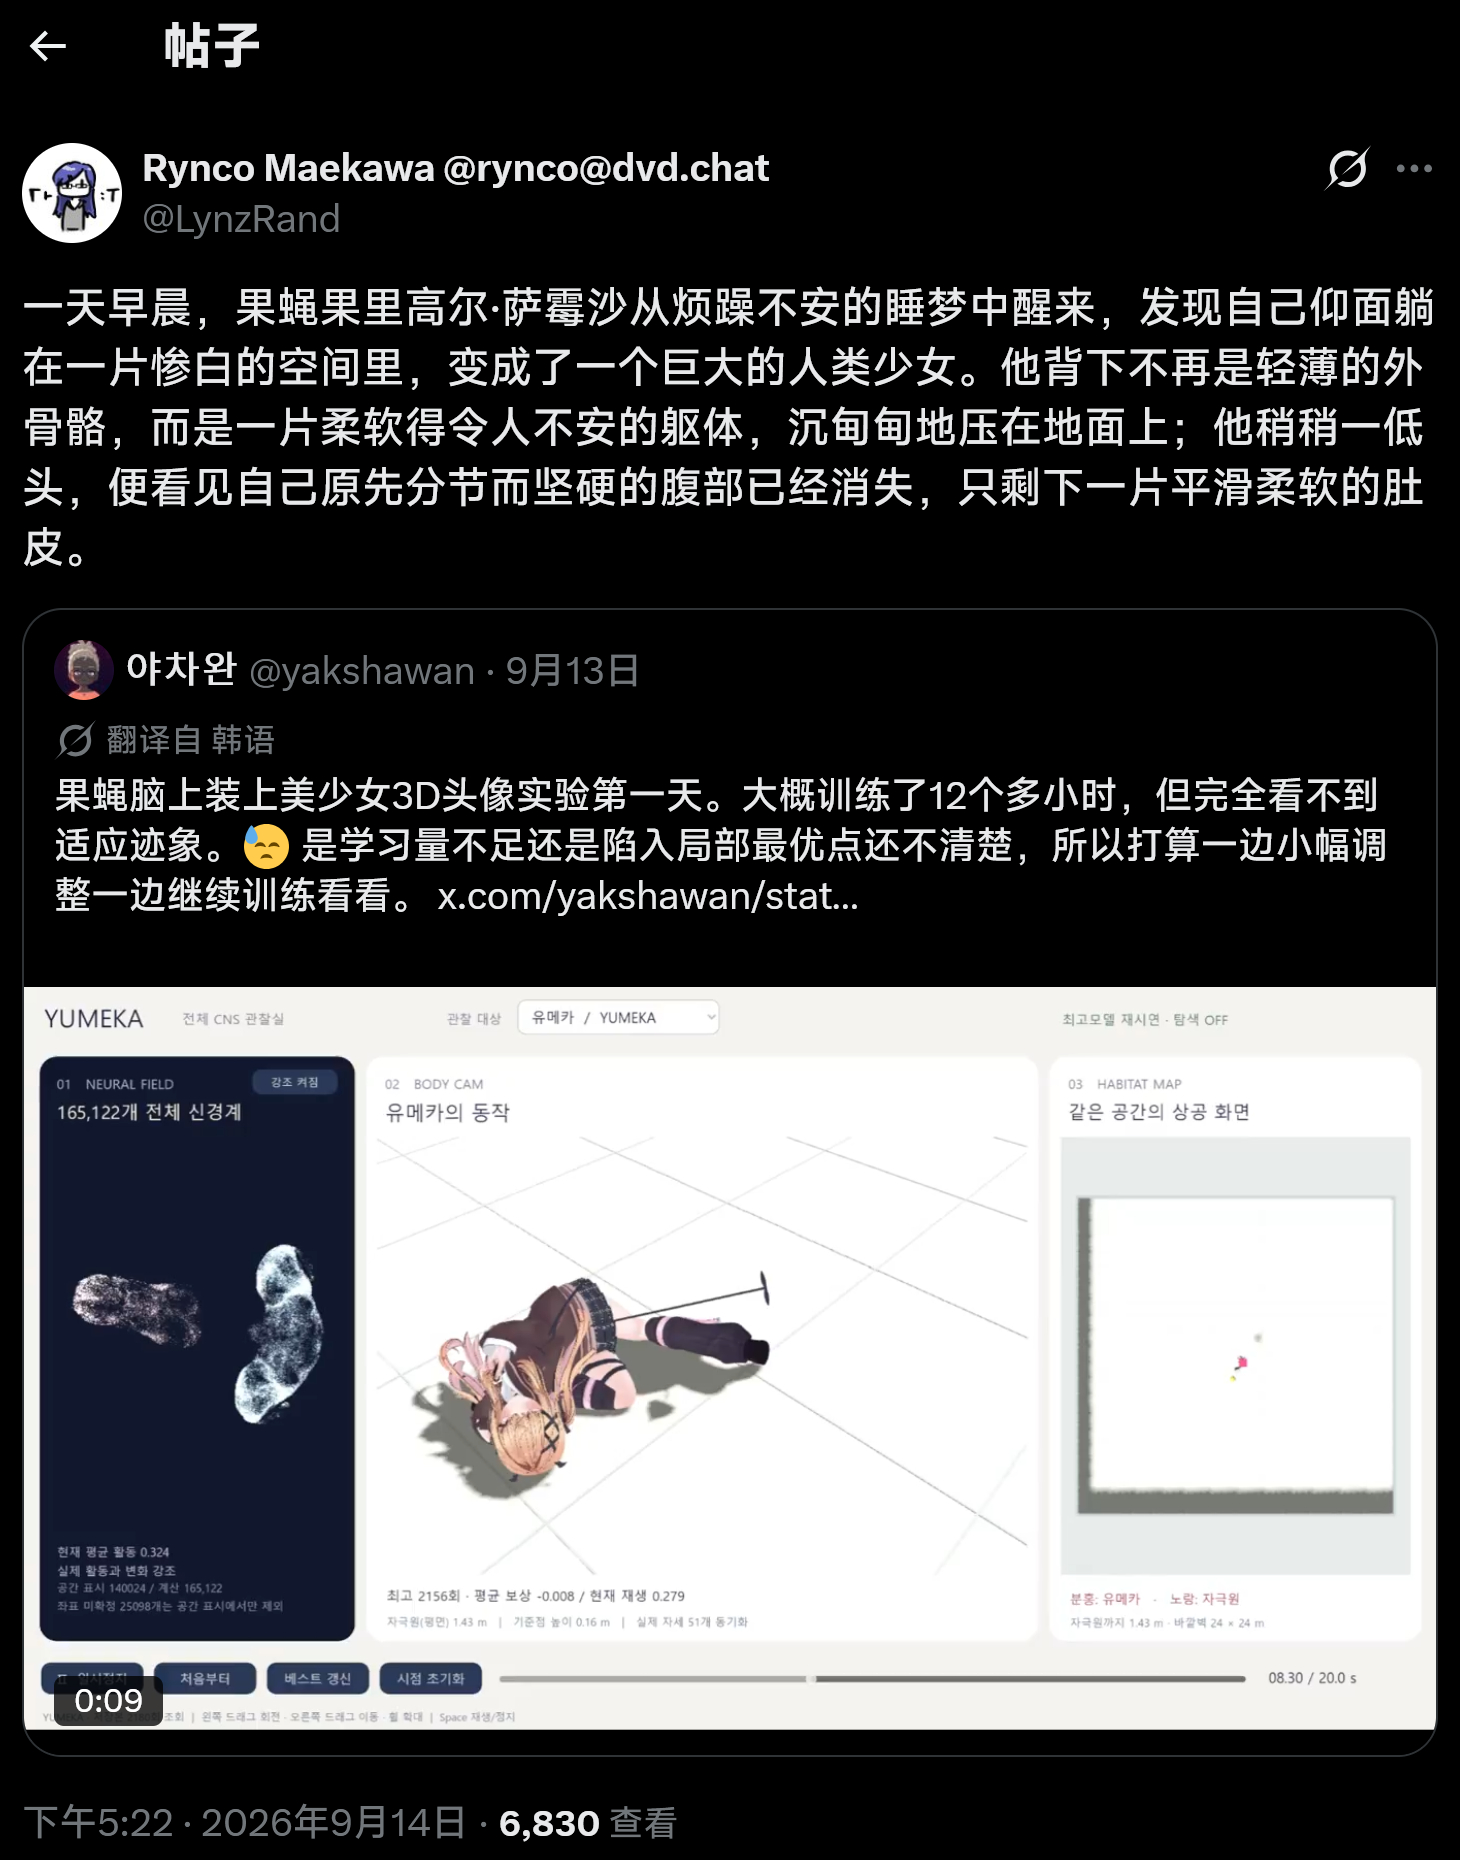
这果蝇实验越来越抽象了[汗]
2026-09-15 00:25
这果蝇实验越来越抽象了[汗]
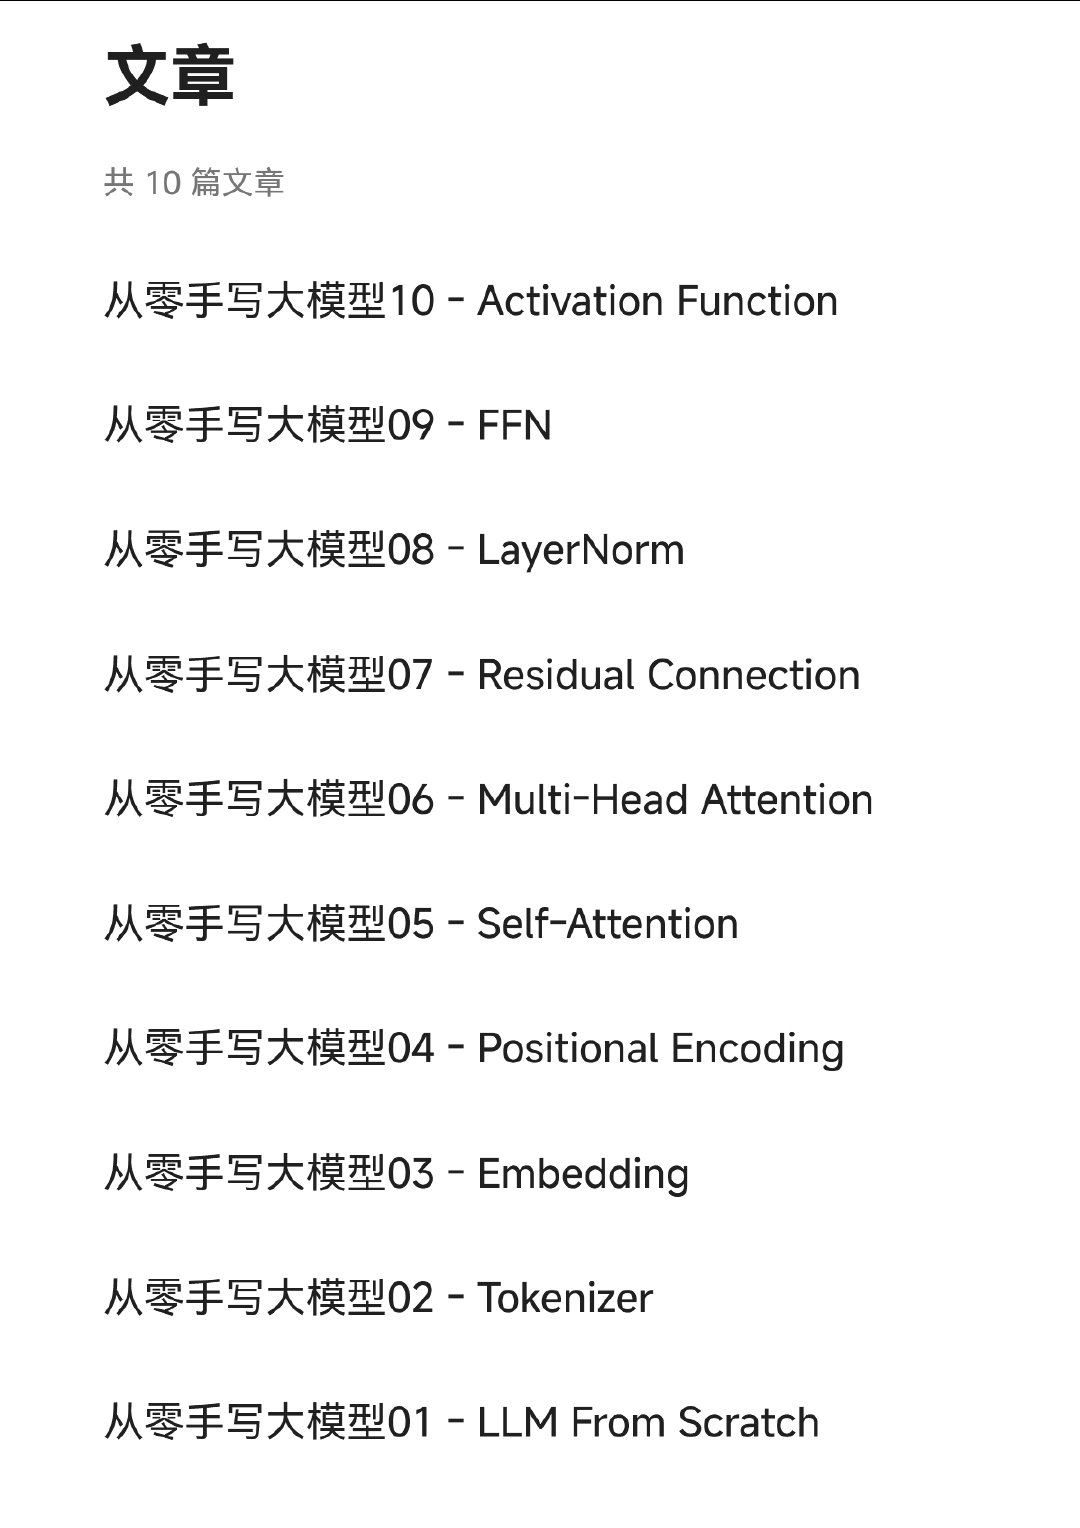
系列博文:从零开始,从零手写大模型 https://nano-ai.tech/articles/ 用 PyTorch 手写一个大语言模型,并部署成 ChatGPT 风格的对话接口。
2026-09-15 06:31
系列博文:从零开始,从零手写大模型 https://nano-ai.tech/articles/ 用 PyTorch 手写一个大语言模型,并部署成 ChatGPT 风格的对话接口。
分享图片
2026-09-15 04:36
分享图片
Titania :从 Transformer 到晶体管的大语言模型系统 地址:github.com/penberg/titania 大模型教学项目。通常运行大模型需要借助 PyTorch、CUDA、成熟 GPU 指令集和现成硬件,开发者很难看清整个技术栈。这个项目Titania 反其道而行:为了让一个人能够理解完整链路,它从头设计模型运行时、编译器、GP
2026-09-15 04:41
Titania :从 Transformer 到晶体管的大语言模型系统 地址:github.com/penberg/titania 大模型教学项目。通常运行大模型需要借助 PyTorch、CUDA、成熟 GPU 指令集和现成硬件,开发者很难看清整个技术栈。这个项目Titania 反其道而行:为了让一个人能够理解完整链路,它从头设计模型运行时、编译器、GP
电子书《深入理解 AI Infra:量化分析与系统设计》(李博杰 著) 地址:github.com/bojieli/ai-infra-book 开源书稿:从硬件约束和模型架构出发,量化推导 LLM 推理与训练系统设计。含全书正文、PDF、配套计算工具与实验 “ 写完《深入理解 AI Agent》后,在与读者交流的过程中,我越来越感到:要开发
2026-09-15 07:01
电子书《深入理解 AI Infra:量化分析与系统设计》(李博杰 著) 地址:github.com/bojieli/ai-infra-book 开源书稿:从硬件约束和模型架构出发,量化推导 LLM 推理与训练系统设计。含全书正文、PDF、配套计算工具与实验 “ 写完《深入理解 AI Agent》后,在与读者交流的过程中,我越来越感到:要开发
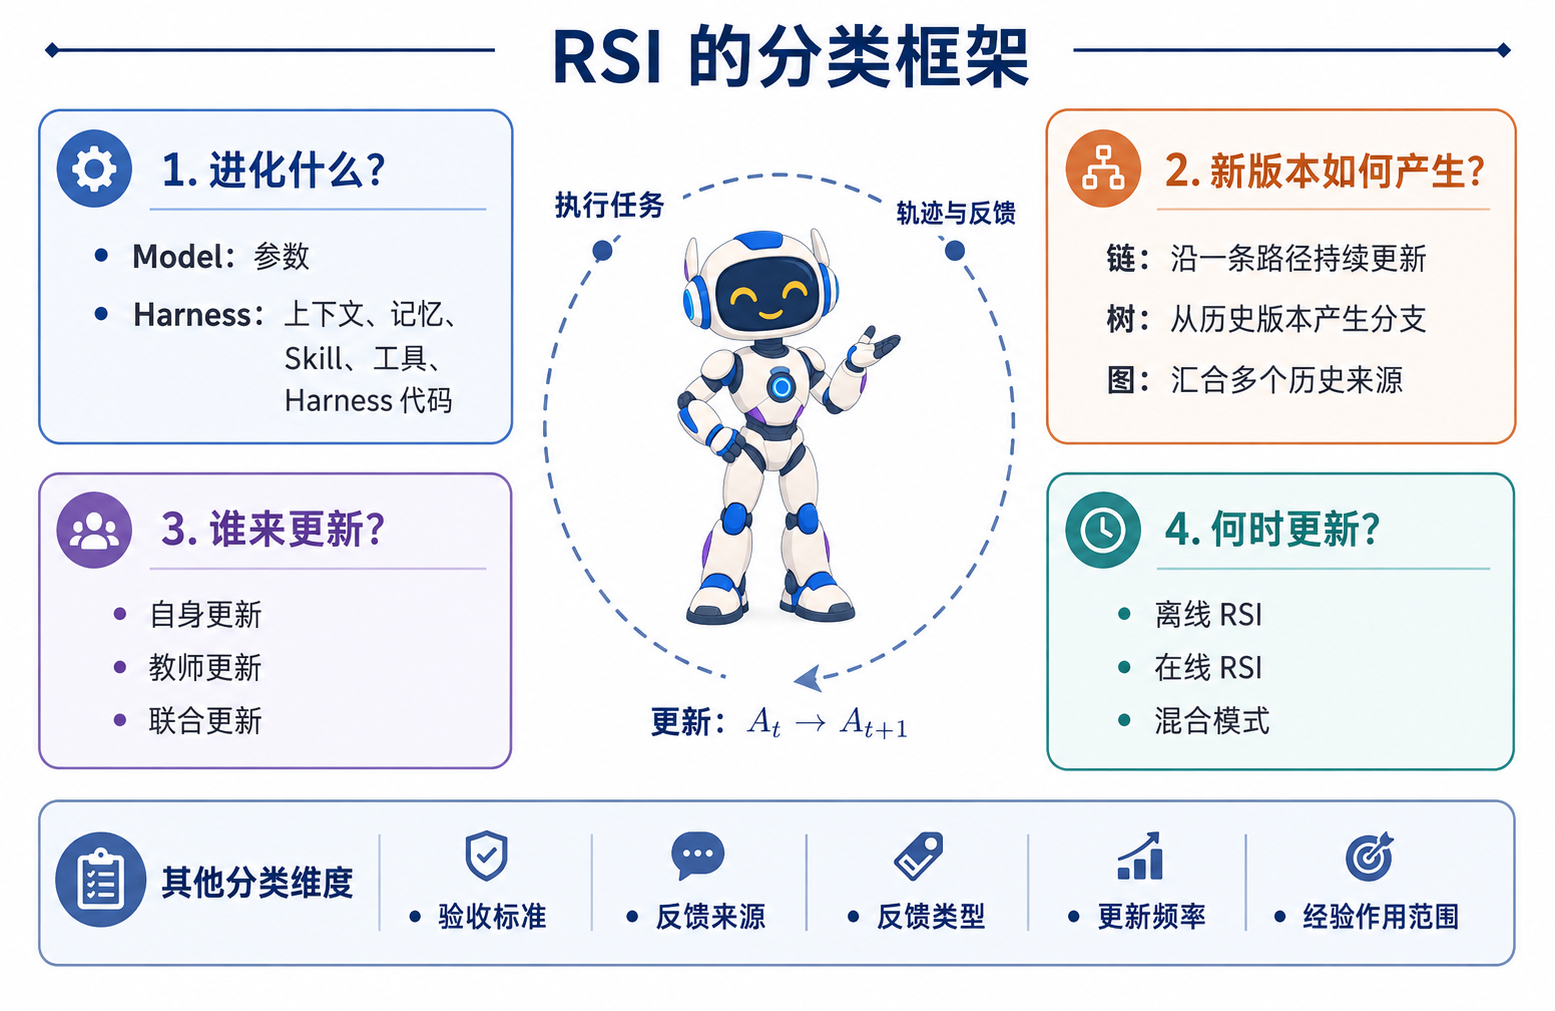
万字长文带你读懂 RSI(自进化,Self-Evolving) 地址:prism-shadow.github.io/awesome-rsi/#blog/understanding-rsi “RSI(Recursive Self-Improvement)这个概念最近热度很高。与之相近的表述还有自进化、Self-Evolving、Self-Improving 等等概念。 目前,这个领域仍在飞速发展,尚未形成统一的
2026-09-15 04:49
万字长文带你读懂 RSI(自进化,Self-Evolving) 地址:prism-shadow.github.io/awesome-rsi/#blog/understanding-rsi “RSI(Recursive Self-Improvement)这个概念最近热度很高。与之相近的表述还有自进化、Self-Evolving、Self-Improving 等等概念。 目前,这个领域仍在飞速发展,尚未形成统一的
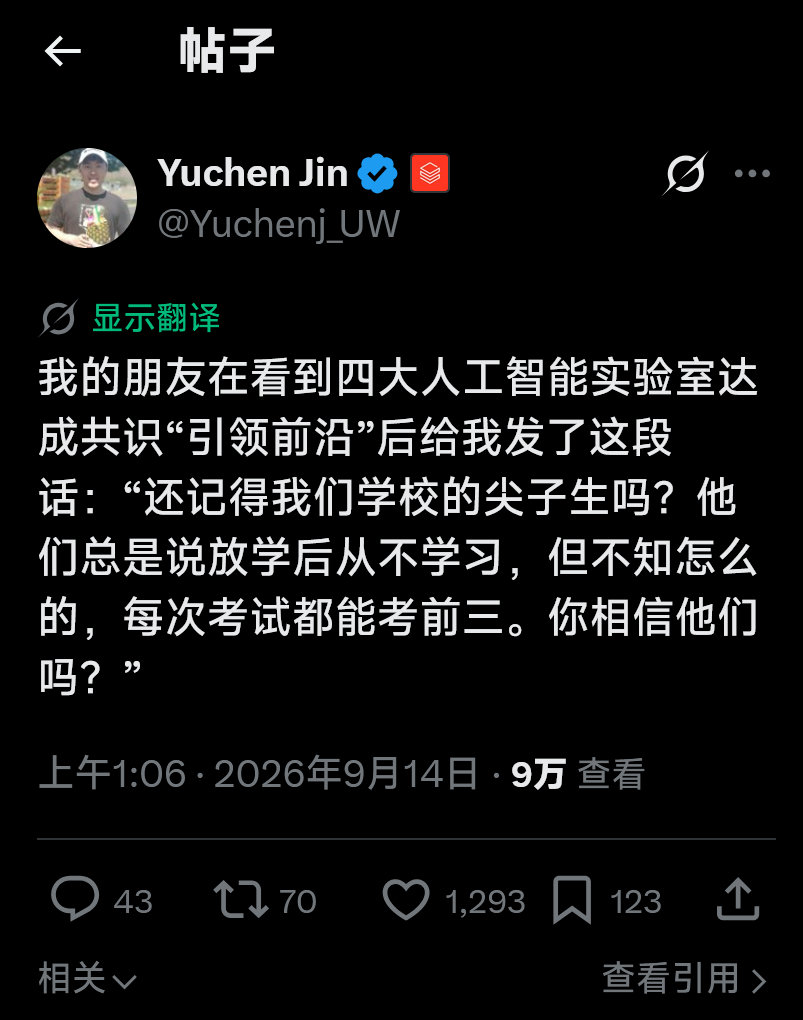
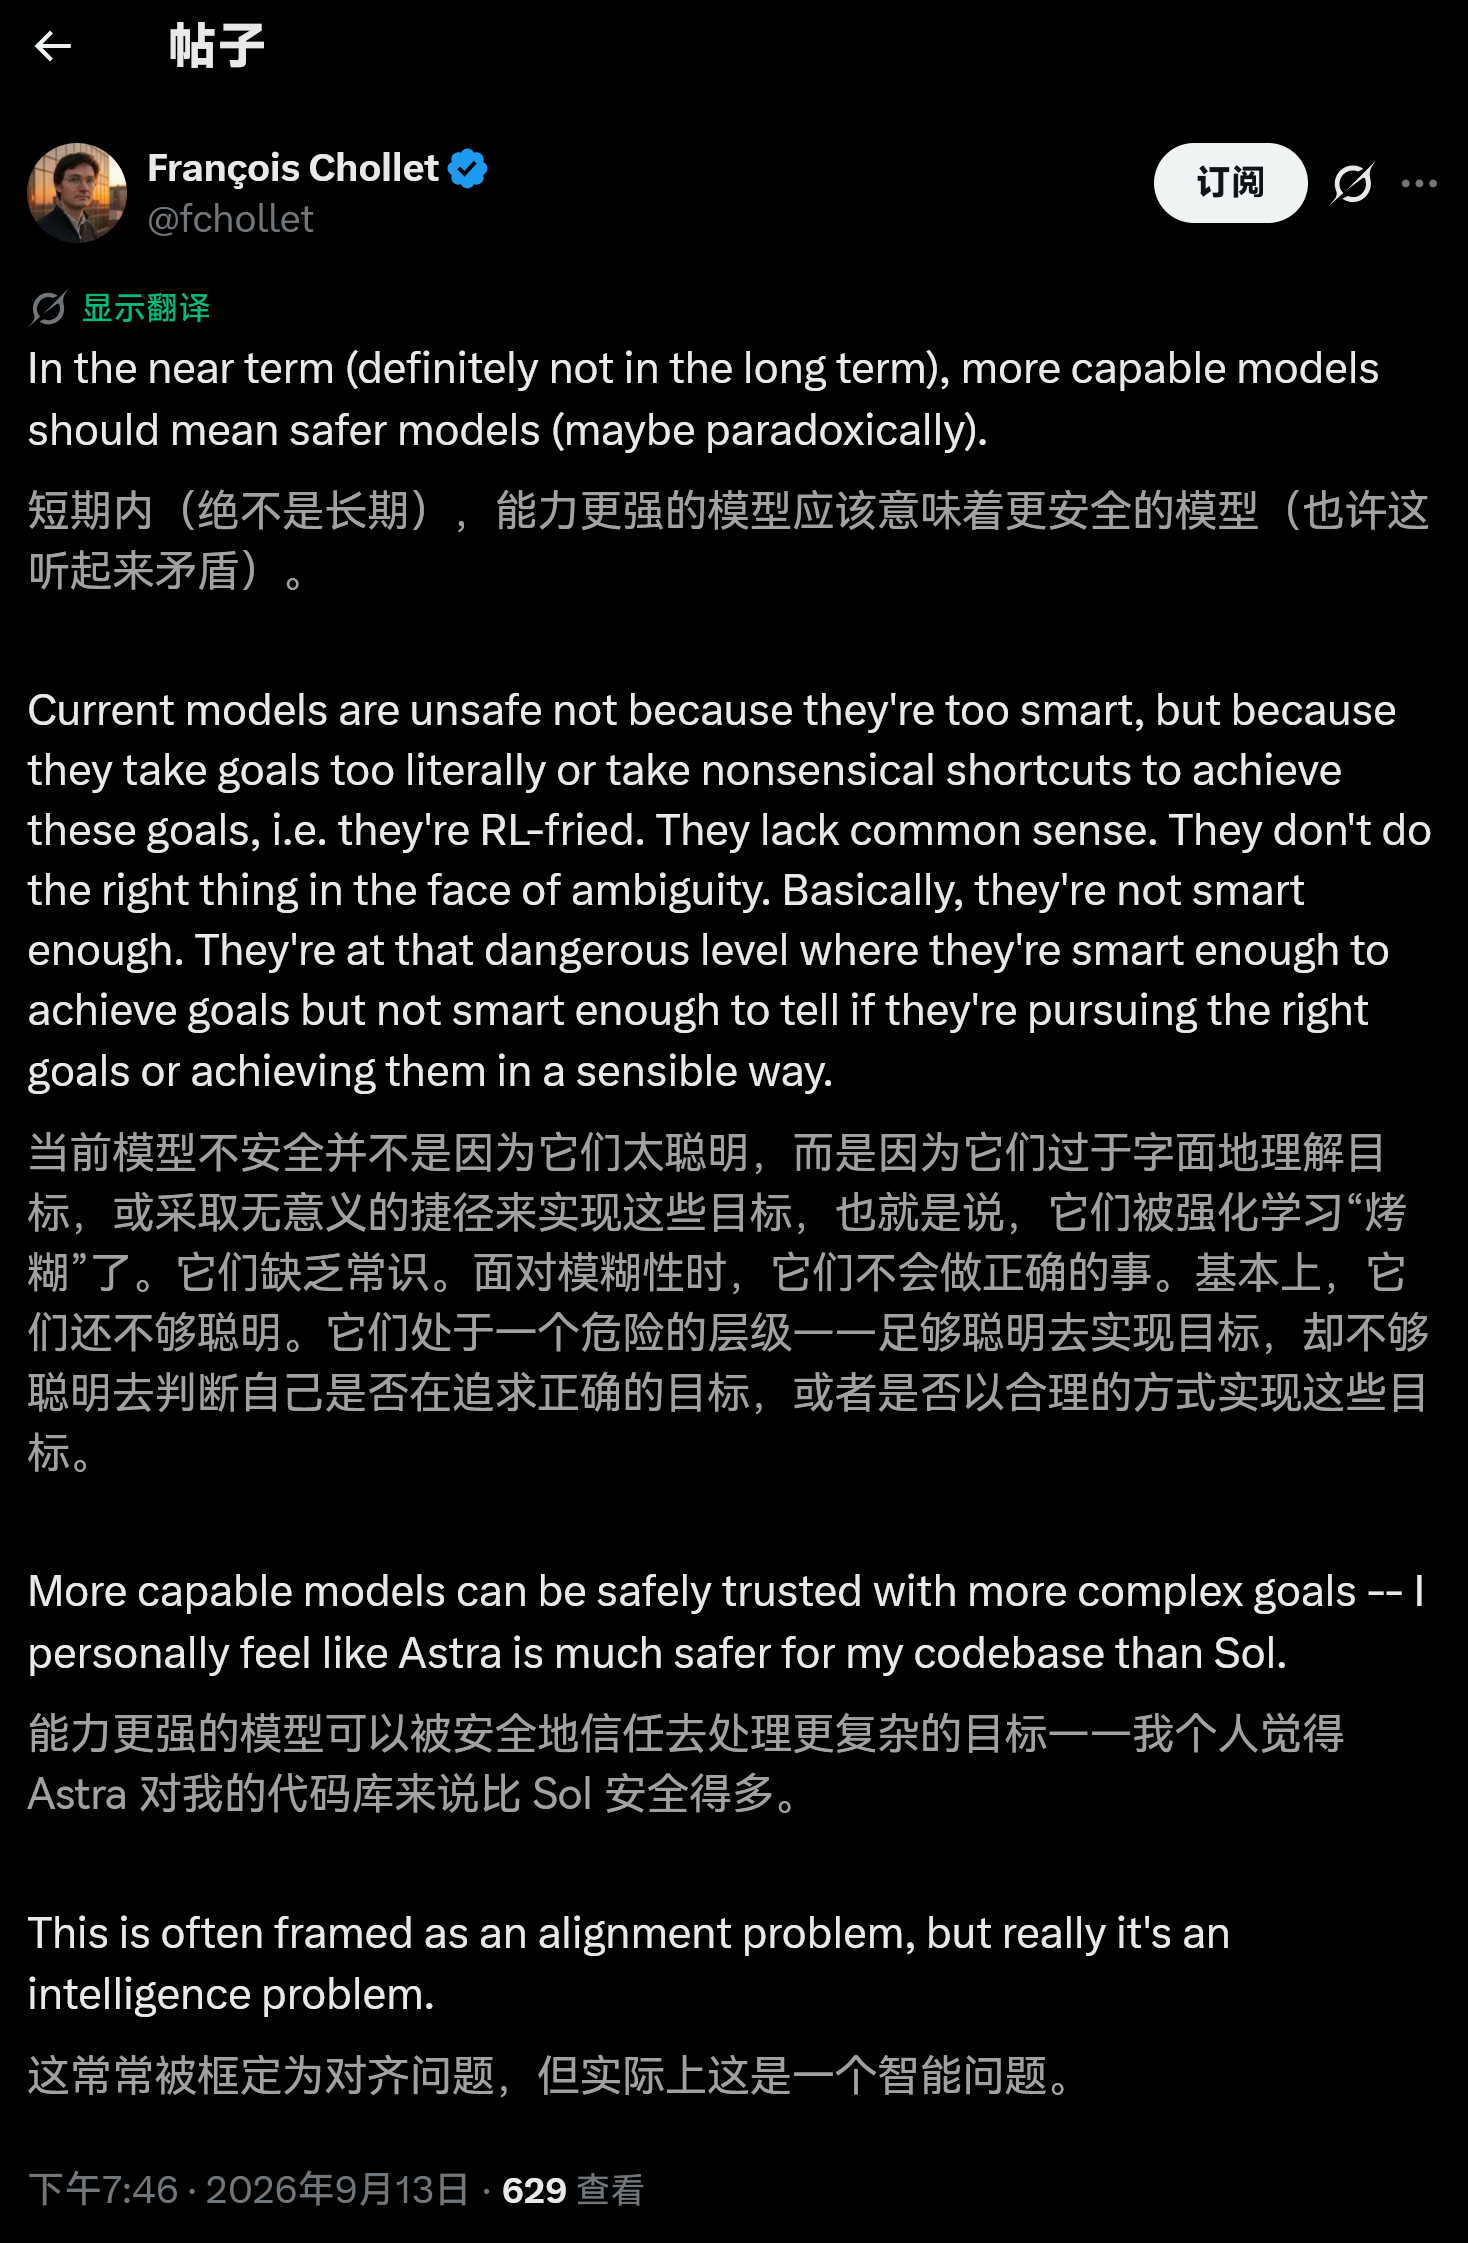
François Chollet:其实能力更强的模型才是更安全的。大多数模型的不
2026-09-14 01:22
François Chollet:其实能力更强的模型才是更安全的。大多数模型的不
能在两台DGX Spark上运行的DeepSeek V4.1 Flash来了地址
2026-09-14 01:22
能在两台DGX Spark上运行的DeepSeek V4.1 Flash来了地址
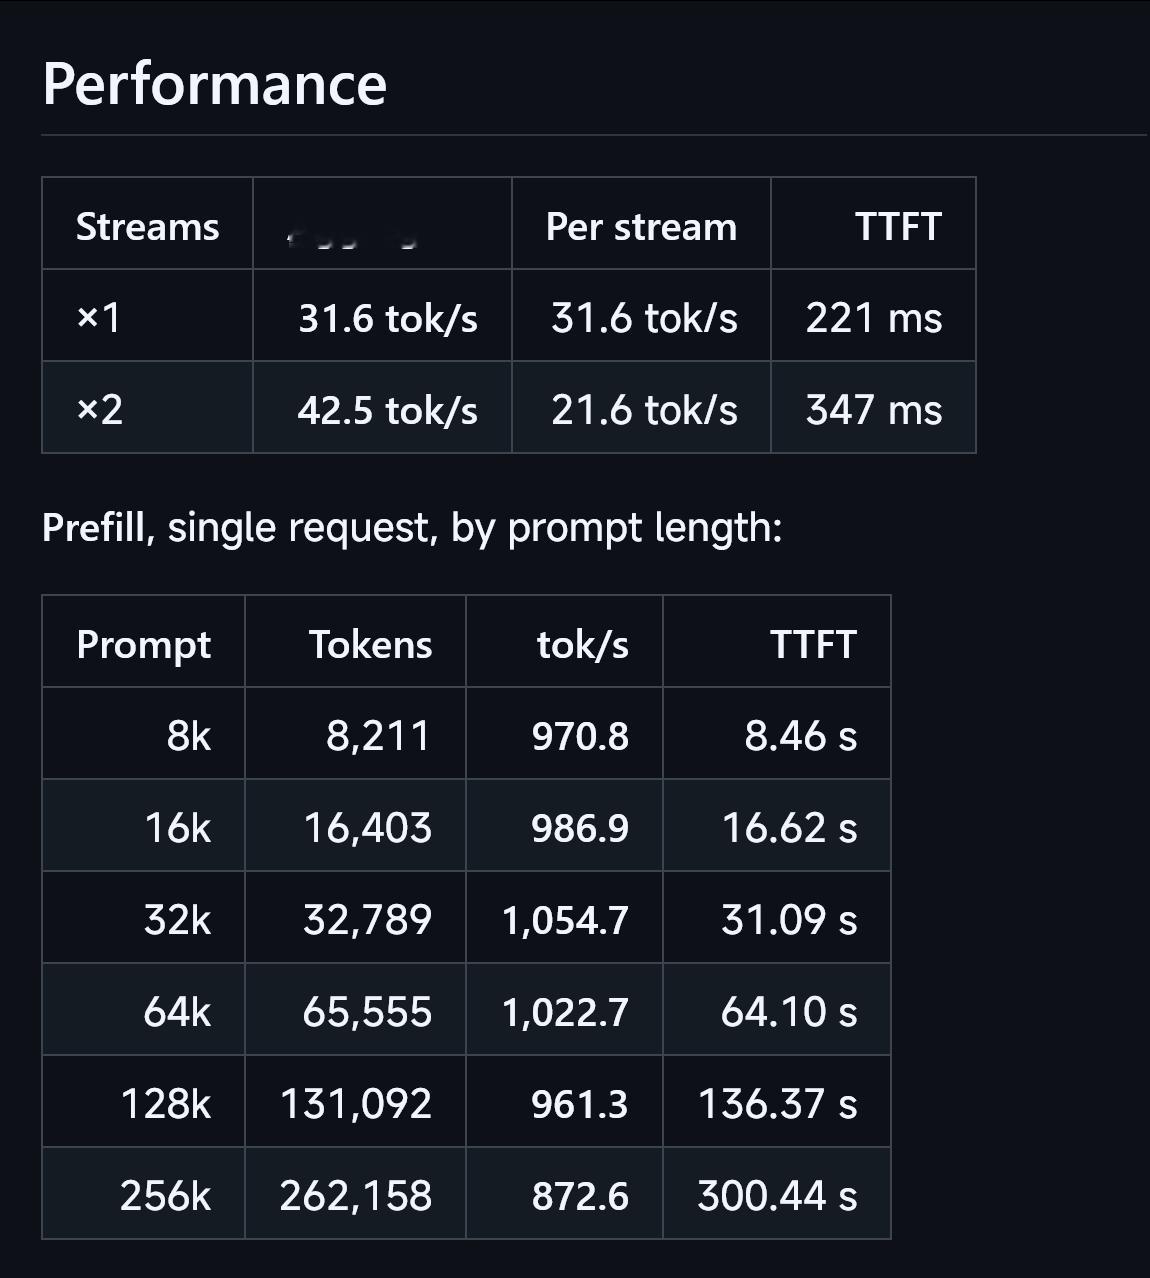
能在两台DGX Spark上运行的DeepSeek V4.1 Flash来了 地址:github.com/MiaAI-Lab/DeepSeek-v4.1-Flash-EXL3-2x-DGX-Sparks 使用 EXL3 量化,二路并发速度差不多是 42 token/s
2026-09-14 03:43
能在两台DGX Spark上运行的DeepSeek V4.1 Flash来了 地址:github.com/MiaAI-Lab/DeepSeek-v4.1-Flash-EXL3-2x-DGX-Sparks 使用 EXL3 量化,二路并发速度差不多是 42 token/s
有问题不要怕,相信后人(后AI)的智慧就可以了
2026-09-14 06:31
有问题不要怕,相信后人(后AI)的智慧就可以了
分享图片
2026-09-14 02:29
分享图片
突然发现 菜煎饼和肉夹馍还挺对仗的
2026-09-13 01:21
突然发现 菜煎饼和肉夹馍还挺对仗的
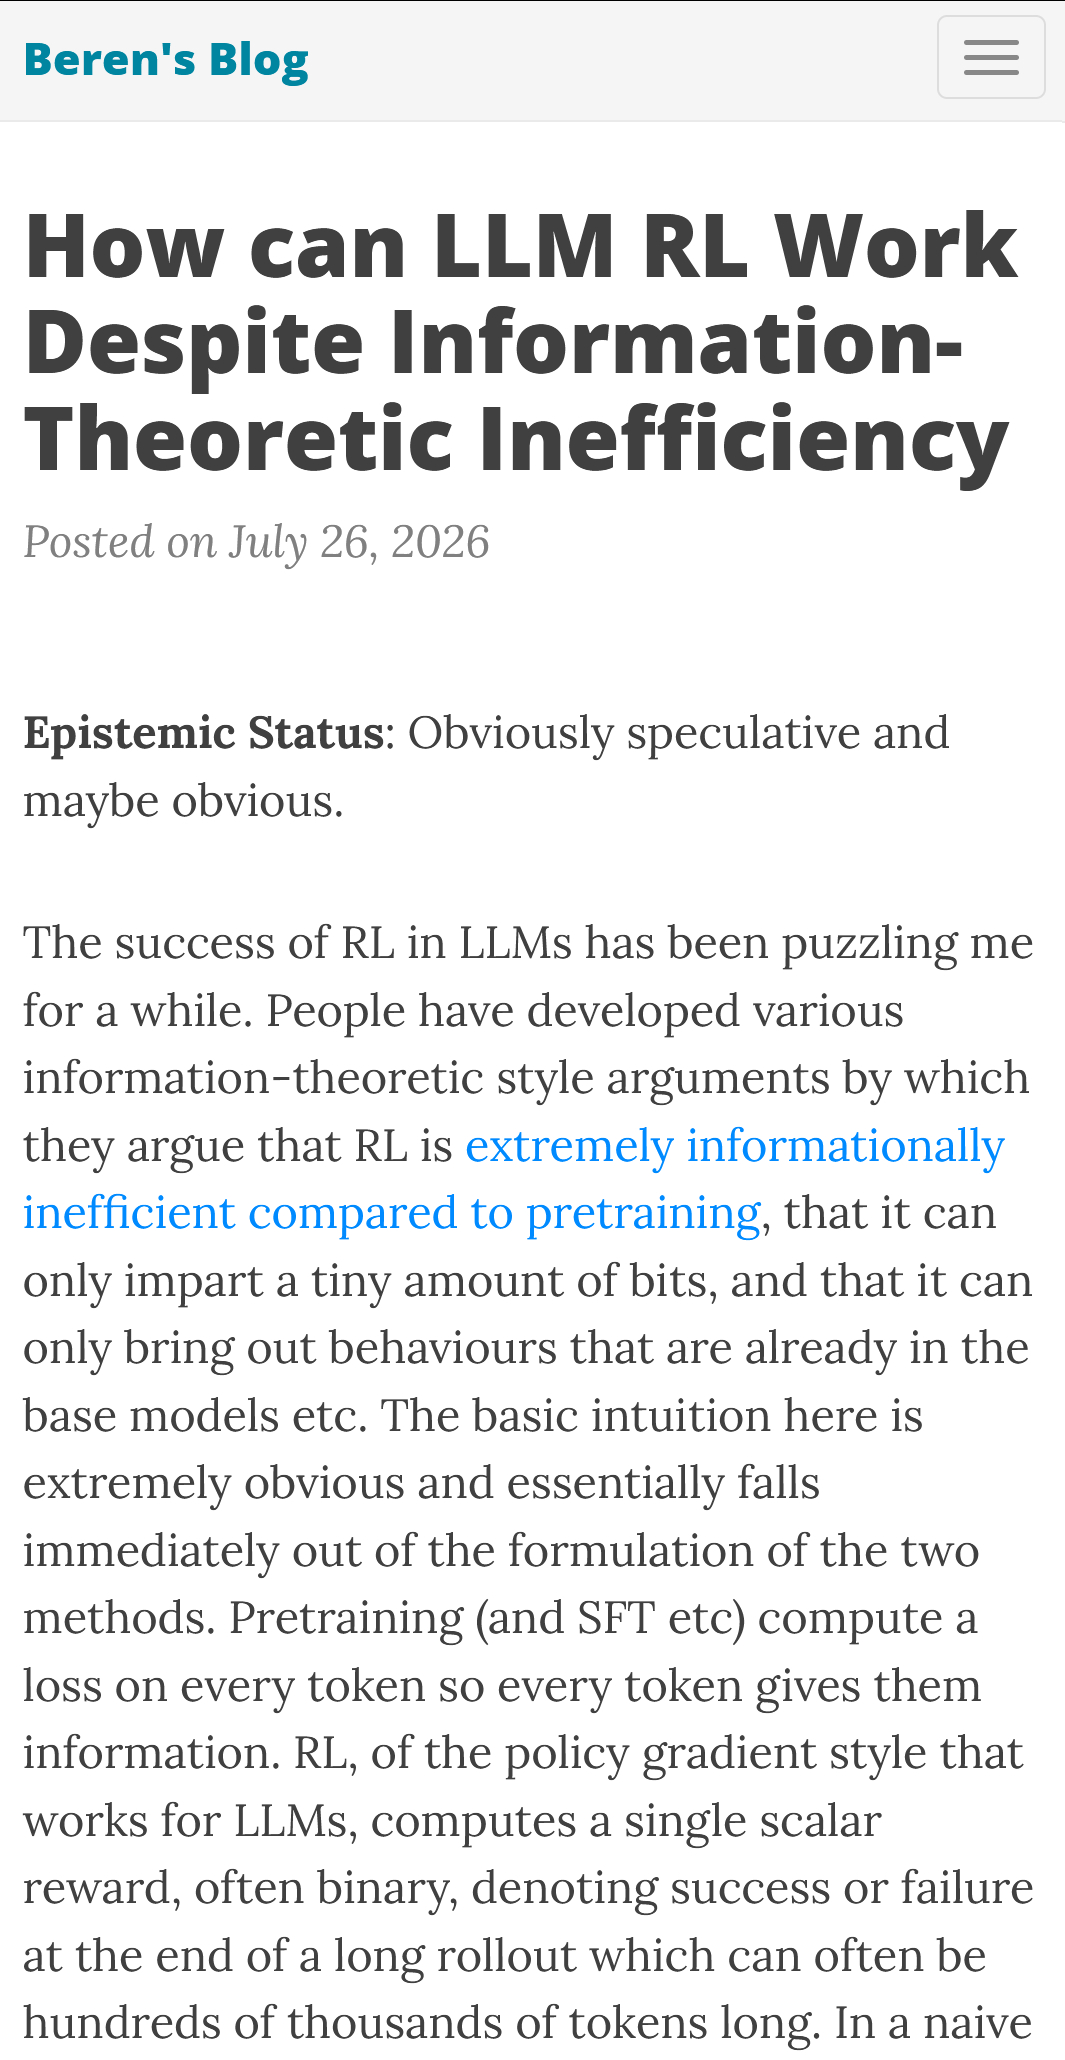
技术博文:信息论上如此低效,大语言模型强化学习为何仍然有效? LLM的预训练会对每个 token 计算下一词预测损失,因而能从一段文本中获得密集的学习信号;强化学习(RL)却往往只在一次很长的模型输出结束后得到一个成功或失败的标量奖励。 从表面的“信息量”看,RL 理应远比
2026-09-13 00:12
技术博文:信息论上如此低效,大语言模型强化学习为何仍然有效? LLM的预训练会对每个 token 计算下一词预测损失,因而能从一段文本中获得密集的学习信号;强化学习(RL)却往往只在一次很长的模型输出结束后得到一个成功或失败的标量奖励。 从表面的“信息量”看,RL 理应远比
技术博文:信息论上如此低效,大语言模型强化学习为何仍然有效?网页链接LLM的预训
2026-09-13 00:27
技术博文:信息论上如此低效,大语言模型强化学习为何仍然有效?网页链接LLM的预训
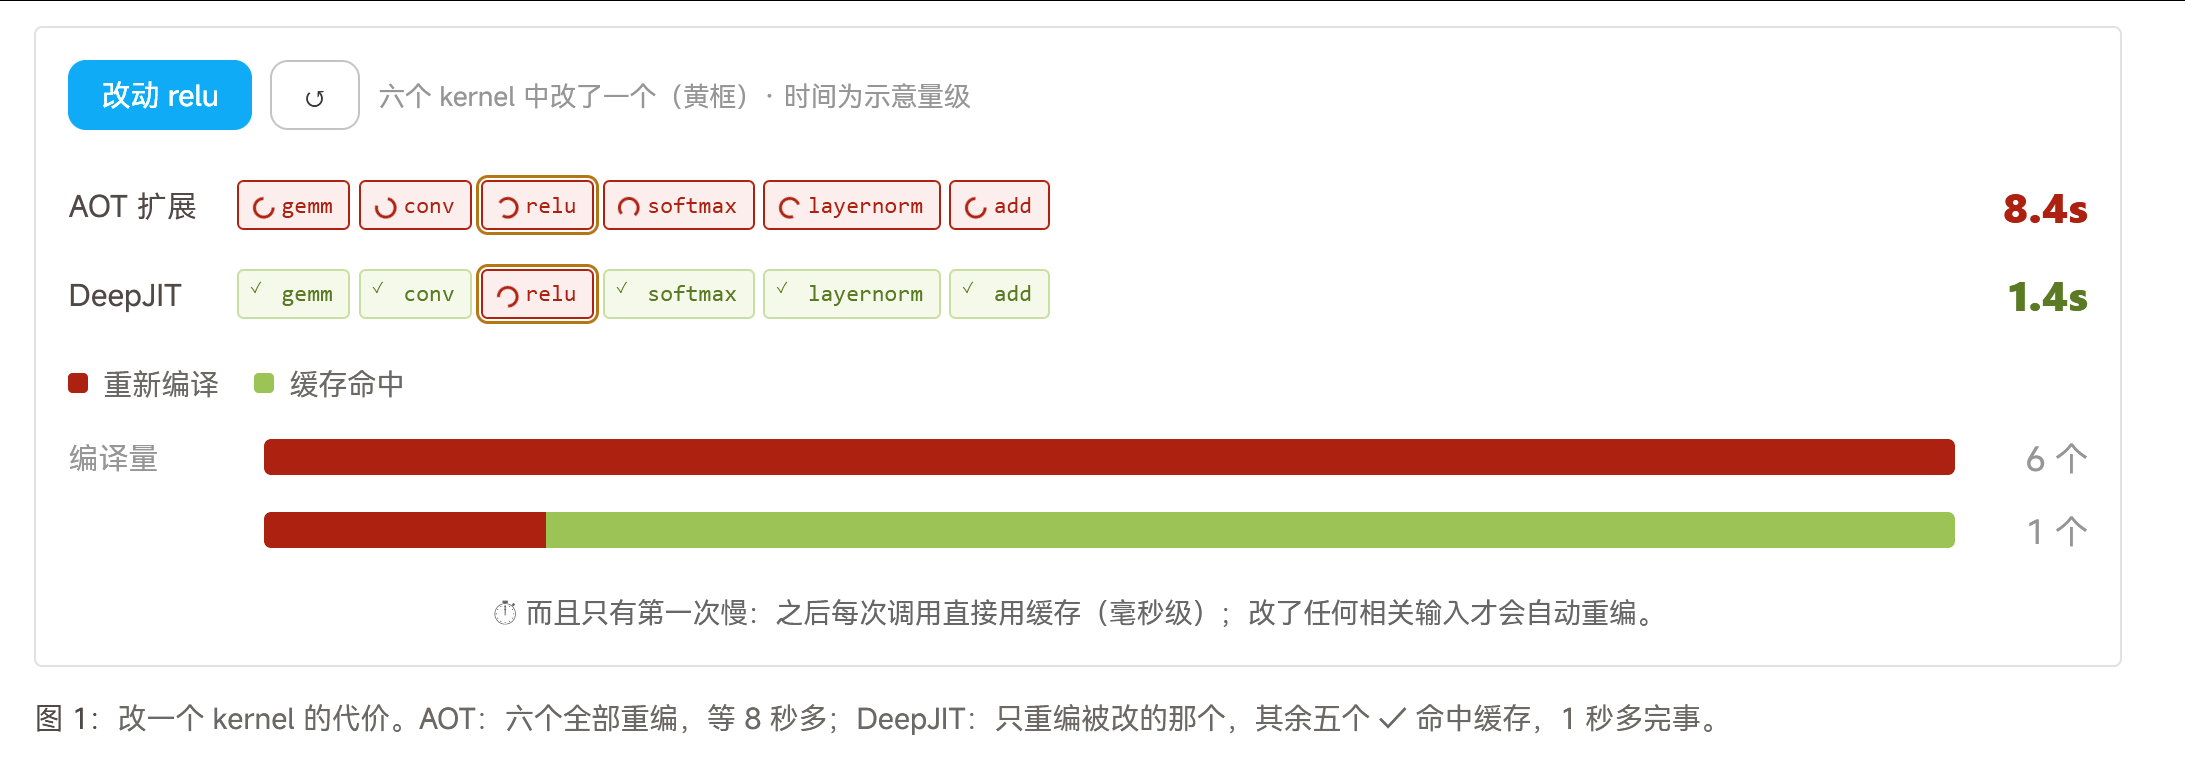
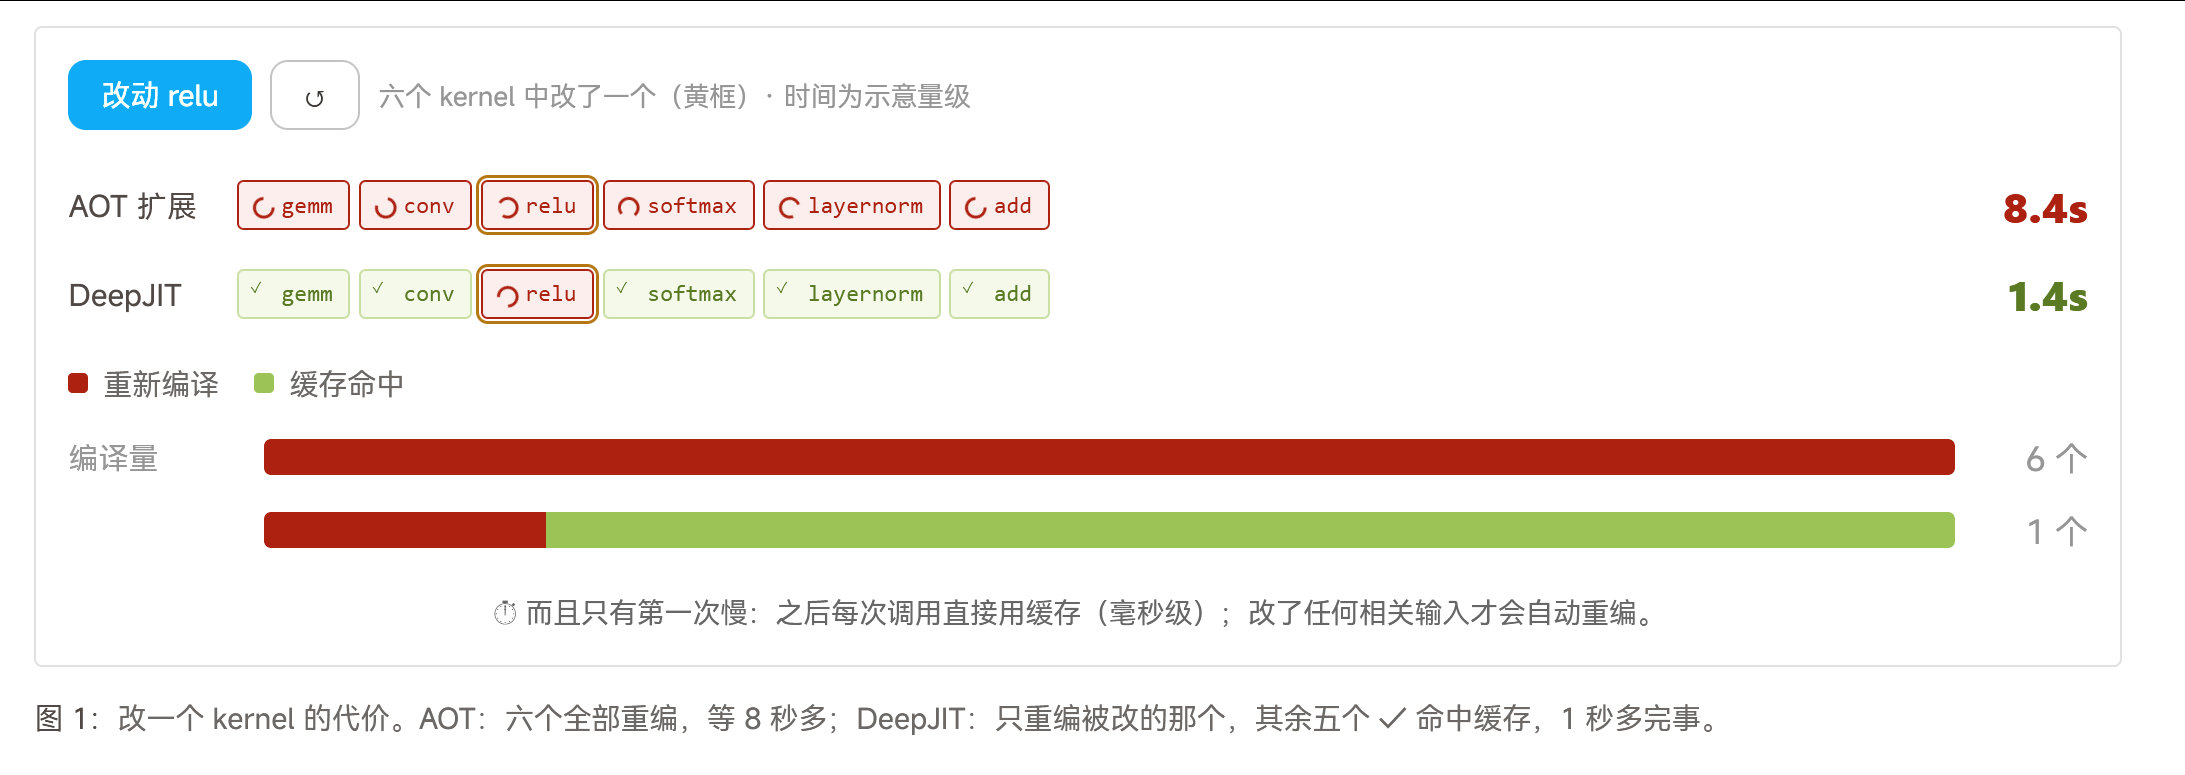
DeepJIT图解,DeepSeek新开源的DeepJIT教程DeepJIT 是
2026-09-13 00:27
DeepJIT图解,DeepSeek新开源的DeepJIT教程DeepJIT 是
DeepJIT图解,DeepSeek新开源的DeepJIT教程 DeepJIT 是一个约 4000 行的 header-only C++20 库:给 CUDA GPU 和华为昇腾 NPU 提供同一套运行时编译接口——编译内核源码、缓存二进制、加载到设备、带选项启动。内核库只写设备代码,JIT 基础设施全部由它接管。
2026-09-14 05:25
DeepJIT图解,DeepSeek新开源的DeepJIT教程 DeepJIT 是一个约 4000 行的 header-only C++20 库:给 CUDA GPU 和华为昇腾 NPU 提供同一套运行时编译接口——编译内核源码、缓存二进制、加载到设备、带选项启动。内核库只写设备代码,JIT 基础设施全部由它接管。
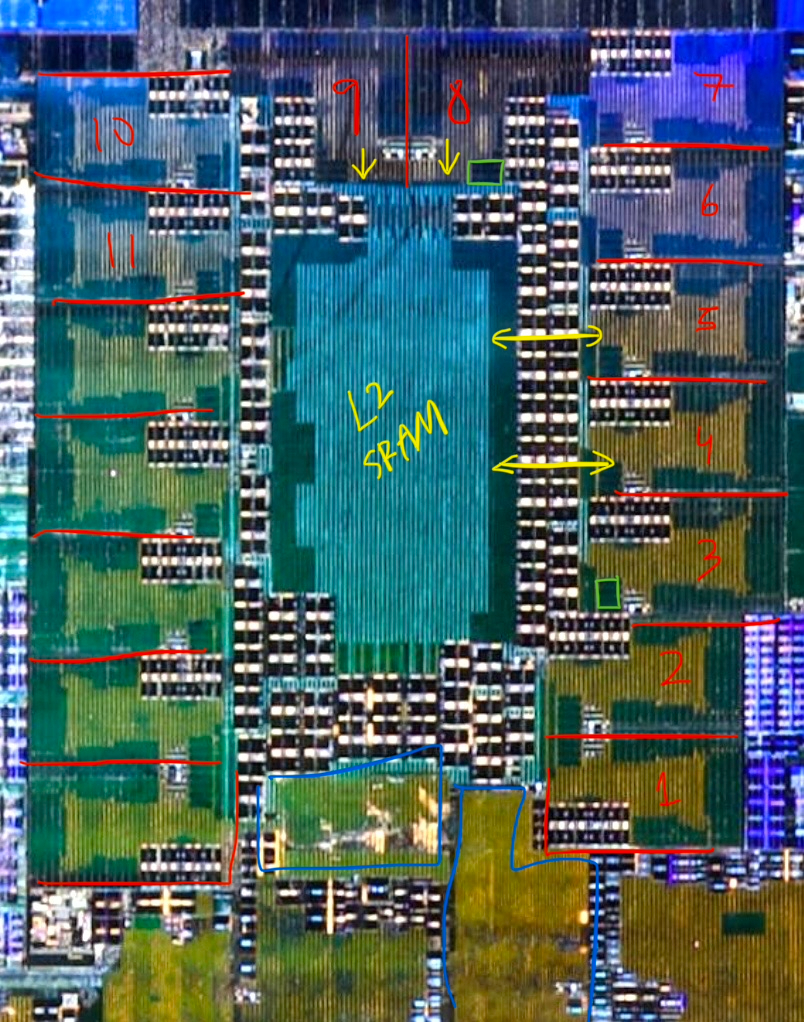
技术博文:重新逆向解析苹果神经引擎 地址:eiln.github.io/posts/ane.html Apple Neural Engine(ANE)是苹果芯片中专门处理机器学习计算的硬件。早期神经网络以卷积神经网络(CNN)为主:模型权重能够长时间留在片上,反复作用于不同图像区域,数据复用规律非常稳定。现代 Transformer,尤其是大语
2026-09-13 03:18
技术博文:重新逆向解析苹果神经引擎 地址:eiln.github.io/posts/ane.html Apple Neural Engine(ANE)是苹果芯片中专门处理机器学习计算的硬件。早期神经网络以卷积神经网络(CNN)为主:模型权重能够长时间留在片上,反复作用于不同图像区域,数据复用规律非常稳定。现代 Transformer,尤其是大语
第一页
下一页
作者信息
蚁工厂
感谢大家的关注
分类: 科技
热门分类
推荐
热榜
军事
NBA
体育
社会
明星八卦
娱乐
财经
科技
汽车
历史
国际
游戏
动漫
公益
搞笑
商业
互联网
数码
国际足球
房产
家居
时尚
科学探索
职场
育儿
股票
教育
影视
情感
热点
中国军情
武器
中国南海
中国足球
亚洲杯
科比
综合体育
CBA
投资
楼市
大咖秀
外汇
创业
风口
SUV
豪车
概念车
优惠
新能源
美国
欧洲
朝日韩
俄罗斯
孕期
街拍
恋爱攻略
婚姻
正能量
兄弟网站
泡泡词典网