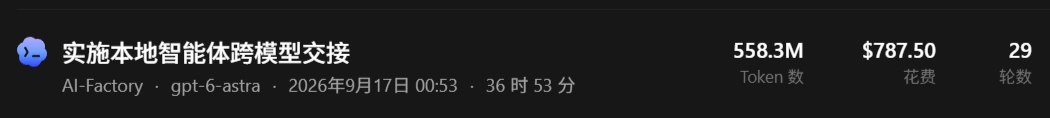
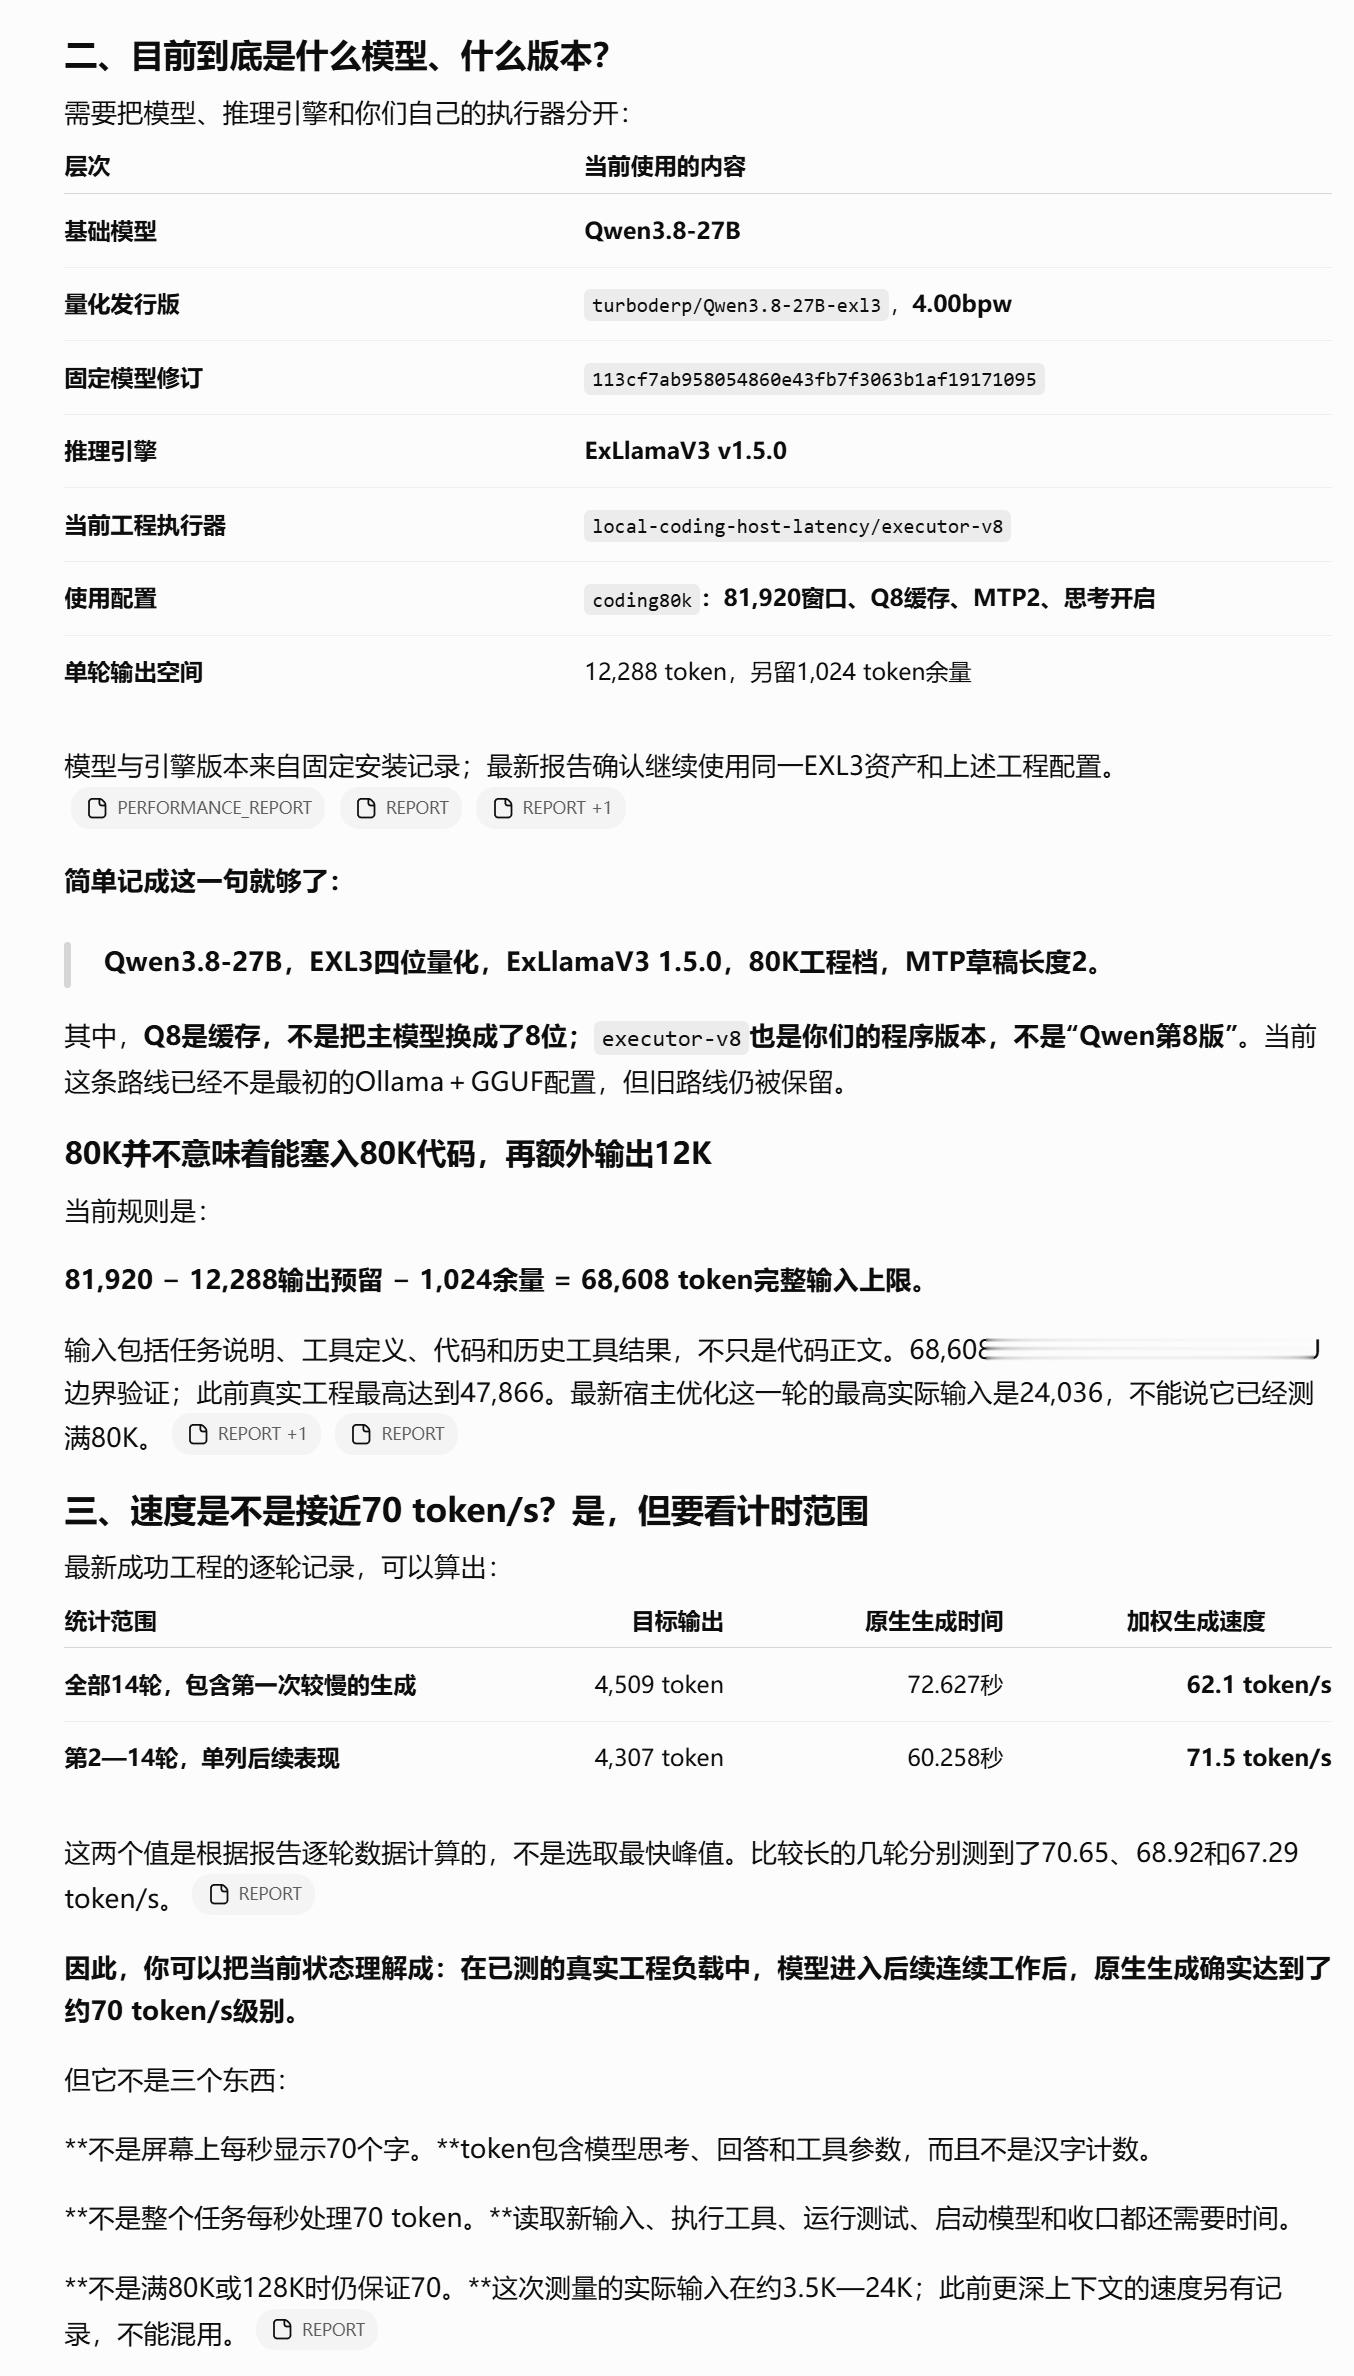
「AI」两天前,我看到有人把Qwen-27B在3090显卡上优化到了63 token/s,当时我就把这个任务发给了GPT-6 PRO,由它写提示词,让Codex完成同样的配置,并把它做成本地的编程Agent。6 PRO写了29份提示词,让Codex执行了29轮,累计37小时,耗费5.5亿token,不仅配置成功,而且把速度优化到了70 token/s.
爽,虽然是爽了,但即使达到了70 token/s我依然感到深深的不划算。5.5亿token,就算显卡24小时运行,一天也就跑回来600万。想把这次配置的token挣回来得工作3个月不停。并且这只是27B的小模型,在排行榜掉得老远了,失去的这5.5亿却是能处理复杂难题的万亿参数的token.尤其还没有算6 PRO的工作量。
这是亏得鼻青脸肿的账单。
当然,如果把此次目标中的“接入本地Agent”排除,直接做速度的最大化优化,估计速度会超过70 token/s一大截。然后把过程写出来,我也发布一下子,混个几十万的流量。这个账单和带来的声誉就能够打平甚至超过。因为无论是模型还是GPU,都是世界通用的。路径只要被一个人跑通,剩下所有人就都能复现。
就比如我仅仅把配置发在微博,想要复现,也就是把任务发给Codex这么简单。跑通的过程会把试错又剔除了一些,成本是越来越低的。我现在深深怀疑人们热衷于搞开源,是因为配置本地模型是亏本的,那么不如把方案发出,一鱼多吃。