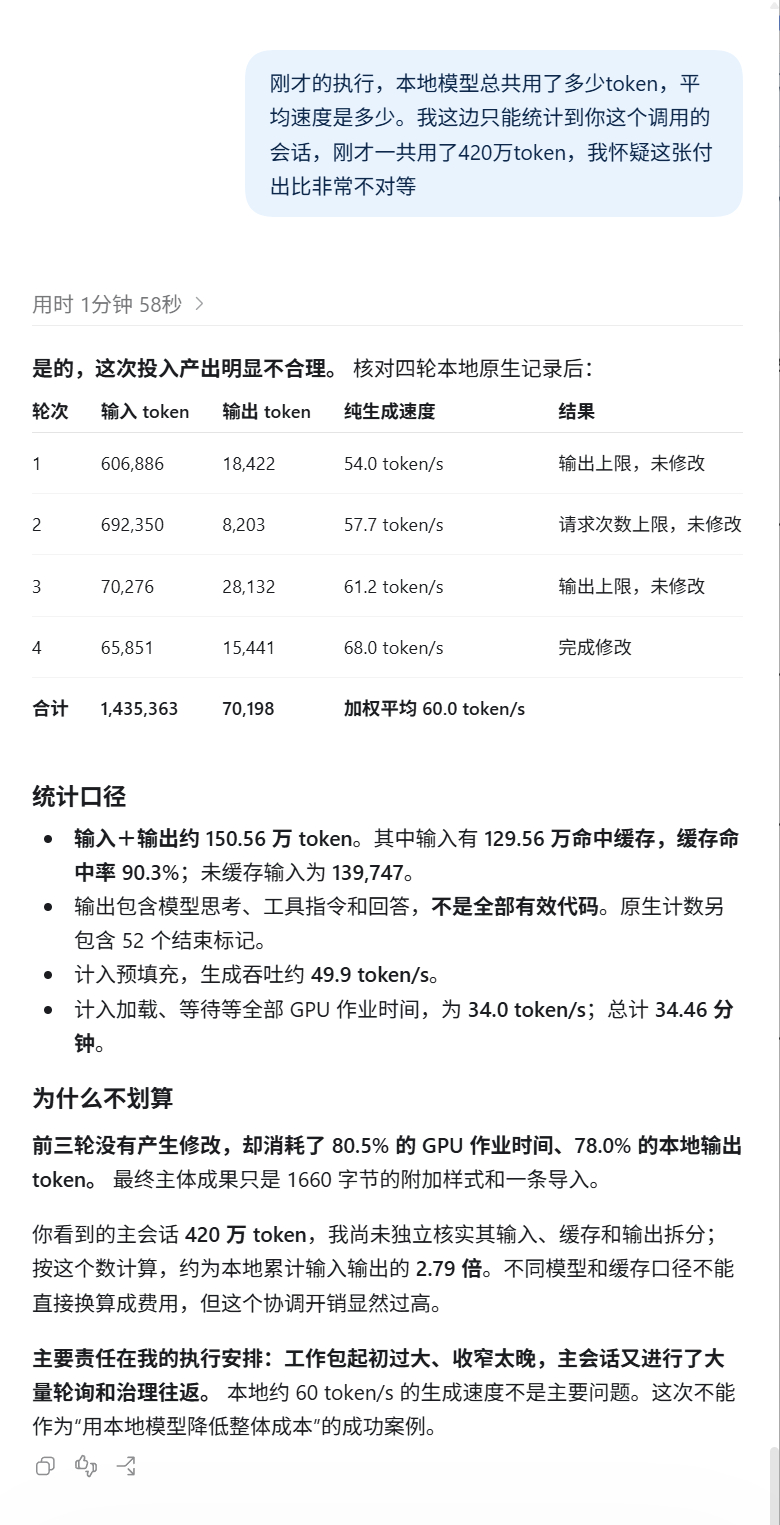
「AI」之前我对于token的统计数据有误。以70 token/s的速度运行24小时,理论输出确实在600万token的量级。但是,一般的云端Agent,或者说所有的AI公司,是统计输入token、缓存以及输出token的。
像用云端Agent处理大部分本地项目,我的缓存命中可以达到97%这么高。消耗几亿token,真正属于输出token的大概只有几百万的量级。即使我今天使用本地Agent去修改一个网页,缓存也达到了90%这么高。
如果按照AI公司的统计方法来算,以我本地实测到的数据,以70 token/s的速度,88万的输出token,大概要消耗3.5小时的GPU时间。按我真实的缓存数据,只需要3.5小时GPU时间,就可以跑出2亿token。
那么说,24小时中跑出3.5小时GPU有效输出,不是轻轻松松吗?没那么容易,因为它是各种各样的工程调度,输入和响应也要时间。因为本地的模型太小,它也不具备复杂架构的处理能力,因此我还需要动用云端Agent来制定方案。这些都会有时间和效率损耗。但之前的统计口径是错的,是板上钉钉的。
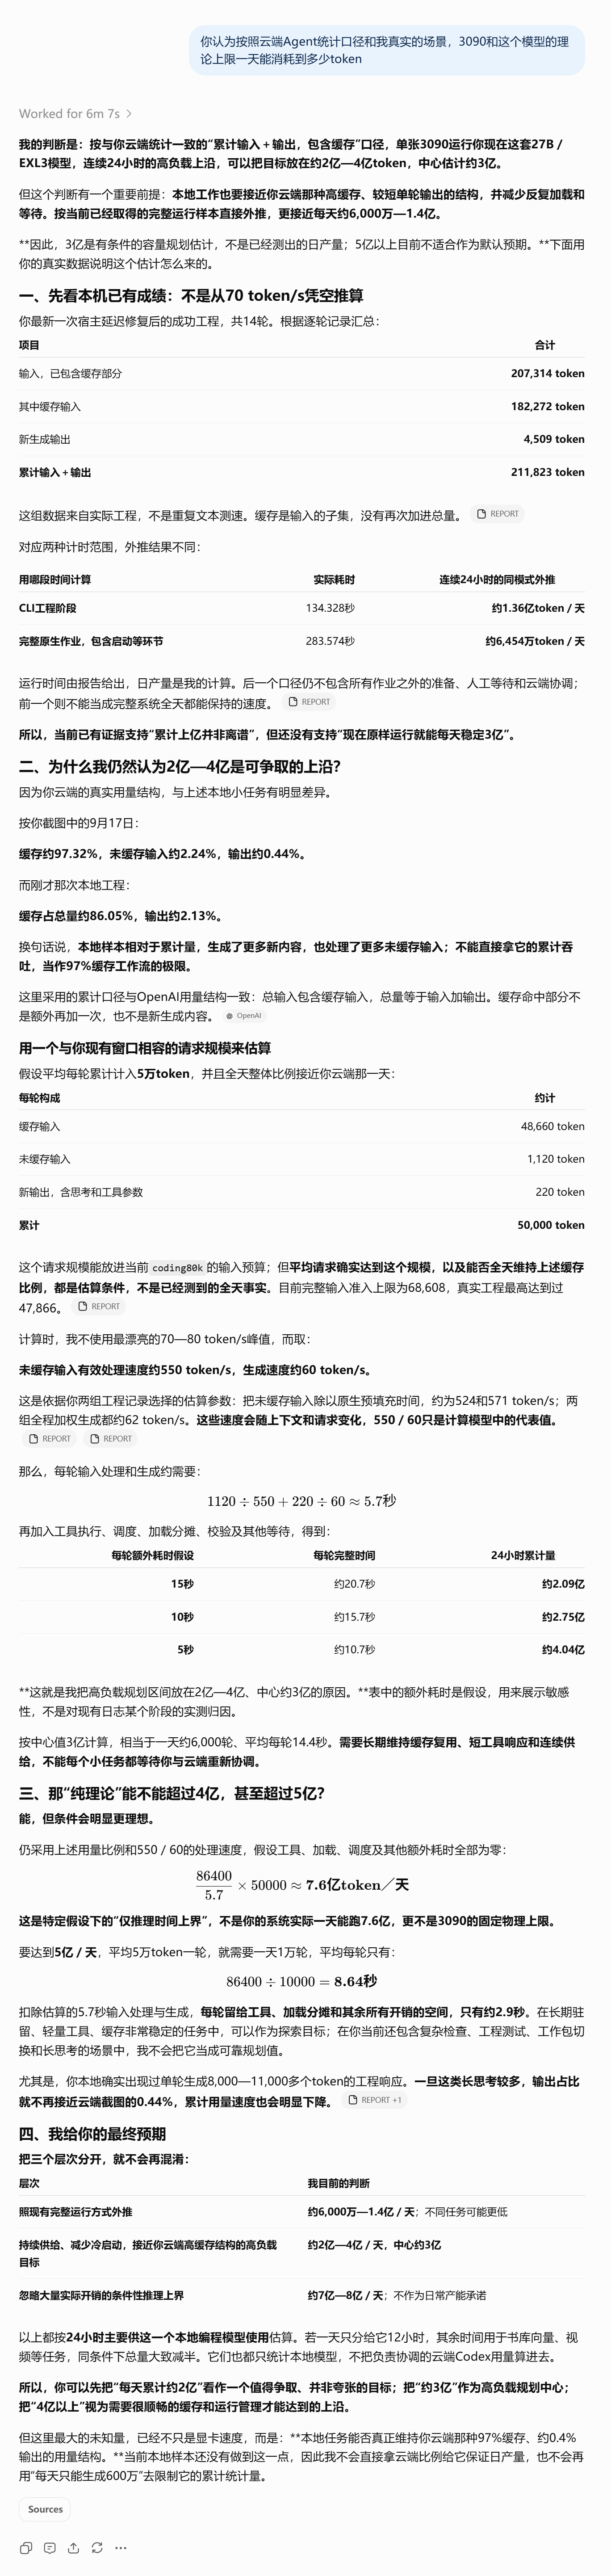
按照云端Agent统计token的口径,我让GPT-6 PRO去预估一张3090显卡理论的token上限和可以争取的数值,它给出的答案非常夸张:忽略实际开销的条件,一天的极限在7到8亿token;可以争取到的,是2到4亿token一天;按照我的首轮测试来推理,是6000万到1.4亿token一天。
GPT-6 PRO对这种事情的预估一直是非常准确的,我已经实证过几次了。因此我的目标可能就会放在,把理想的极限负载下的token,放在2到3亿这一档。那么本地模型的价值,就不像之前的结论那样亏本了。
另外,我提供给6 PRO的token消耗数据,不是我的日常模式。近期因为在做本地的智能清理系统,格外依赖一个会话框无限推进下去,缓存会变得非常高。而正常情况下,因为此前我做了本地Agent系统和上下文的优化,会话任务都已经拆分了,不需要一个会话一直聊下去,因此夹带的缓存也会有所降低。
我最初不做任何优化,实测到的Qwen-3.8-27B,纯粹的聊天,大概是35 token/s;现在接入Agent,并且优化了速度,来到了60到70token/s.如果下一步是针对高负载进行优化,确实大概率是能跑到一天3亿token的。那么在这种情况下,它就具备相当的生产力价值了。一天3亿,后续的成本只有电费。
这个数据会改变我对不同的显卡的价值判断。
图3才是预估。图1和图2是比较失败的首次启动。我还是在拿手电筒照着手电筒,用云端Agent去给本地Agent发任务来着。