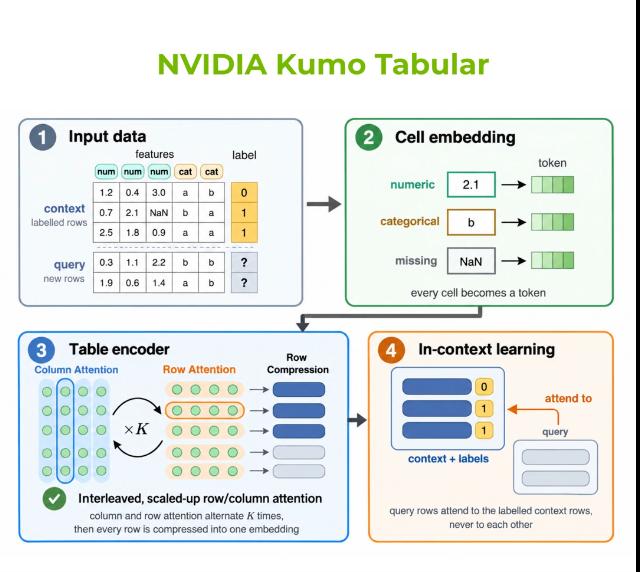
英伟达正式发布Kumo Tabular,一组面向表格数据的开源基础模型,参数量从约2800万到2.15亿不等。模型权重、配套软件全部公开,并采用允许商用的OpenMDW 1.1许可证。用户只需提供带标签的上下文行,即可在一次前向传播中完成分类或回归预测,无需针对具体任务训练、调参或特征工程。
真正值得细看的是它如何把“预训练+上下文学习”真正落到结构化数据上。整组模型完全在合成表格上训练,超过1.37亿张由结构因果模型随机生成的表。架构上采用表格专用Transformer:先用列注意力与行注意力把原始单元格压缩成固定维度的行表示,再通过上下文学习Transformer让查询行只关注已标注的上下文行。结果是,在TabArena、BeyondArena、TALENT、ScoringBench四项主流基准上全面排名第一;在TabArena上ELO达到1950,推理速度比LimiX-2快17倍,整体占据精度与推理时延的新帕累托前沿。这与过去二十年依赖梯度提升树、每张表单独建模的路径形成鲜明对比。
表格数据长期被大模型浪潮边缘化,Kumo Tabular把“一次预训练、多任务即用”的范式真正推进到了企业最核心的资产形态。真正的考验不在基准榜单,而在真实业务数据分布漂移与多表关联场景下,它能否持续替代传统流水线。