DC娱乐网
智研未来的文章
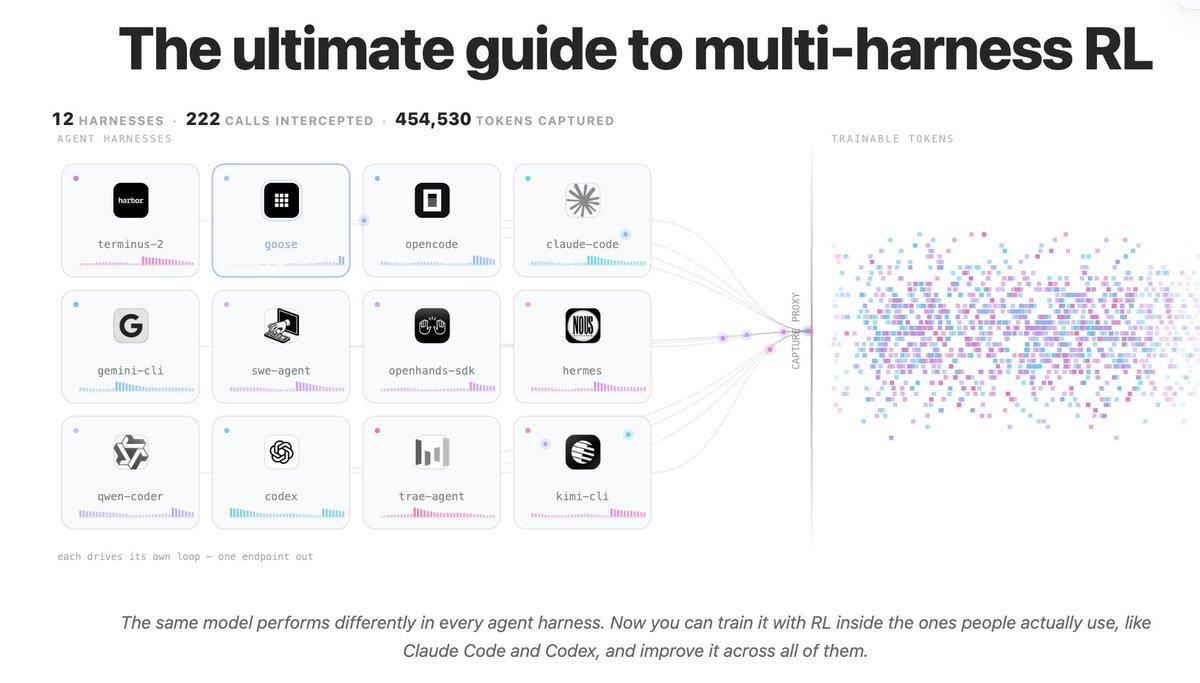
HuggingFace团队发布多框架强化学习指南,并完全开源,在不改动任何代理框
2026-10-03 00:02
HuggingFace团队发布多框架强化学习指南,并完全开源,在不改动任何代理框
谷歌DeepMind宣布,成功合成既具备生物功能、又内嵌水印的AI设计蛋白质,相
2026-10-01 10:02
谷歌DeepMind宣布,成功合成既具备生物功能、又内嵌水印的AI设计蛋白质,相
谷歌DeepMind正式发布前沿模型Gemini 4 Argon,专为编码、企业
2026-10-01 10:02
谷歌DeepMind正式发布前沿模型Gemini 4 Argon,专为编码、企业
谷歌DeepMind正式发布前沿模型Gemini 4 Argon,专为编码、企业知识工作与网络安全防御中的复杂工作流设计。该模型今日起通过Fairwind计划向受信任测试者开放,输出上限提升至行业领先的100万token(此前为6.4万),推出价为每百万token输入2美元、输出10美元。 官方强
2026-10-01 17:56
谷歌DeepMind正式发布前沿模型Gemini 4 Argon,专为编码、企业知识工作与网络安全防御中的复杂工作流设计。该模型今日起通过Fairwind计划向受信任测试者开放,输出上限提升至行业领先的100万token(此前为6.4万),推出价为每百万token输入2美元、输出10美元。 官方强
OpenClaw基金会正式开源 OpenClaw企业版,与红帽、英伟达、Open
2026-09-30 10:02
OpenClaw基金会正式开源 OpenClaw企业版,与红帽、英伟达、Open
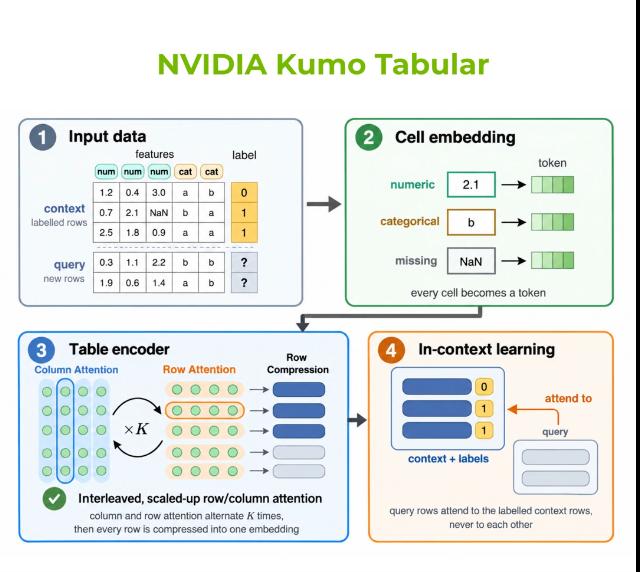
英伟达正式发布Kumo Tabular,一组面向表格数据的开源基础模型,参数量从
2026-09-30 10:02
英伟达正式发布Kumo Tabular,一组面向表格数据的开源基础模型,参数量从
英伟达研究人员发布视频世界模型开源框架Physis-Lang。该框架为视频字幕注
2026-09-30 10:02
英伟达研究人员发布视频世界模型开源框架Physis-Lang。该框架为视频字幕注
OpenAI同日推出三项关键更新:GPT-6.1 Sol以接近旗舰GPT-6 A
2026-09-30 10:02
OpenAI同日推出三项关键更新:GPT-6.1 Sol以接近旗舰GPT-6 A
OpenAI同日推出三项关键更新:GPT-6.1 Sol以接近旗舰GPT-6 Astra的编程、计算机使用与专业工作表现,标准价格仅为其五分之一,缓存输入低至0.10美元/百万tokens;同步上线Ultrafast高速档,Codex中token生成最高达300/秒(约8倍);并由山姆·奥特曼宣布D
2026-10-02 00:24
OpenAI同日推出三项关键更新:GPT-6.1 Sol以接近旗舰GPT-6 Astra的编程、计算机使用与专业工作表现,标准价格仅为其五分之一,缓存输入低至0.10美元/百万tokens;同步上线Ultrafast高速档,Codex中token生成最高达300/秒(约8倍);并由山姆·奥特曼宣布D
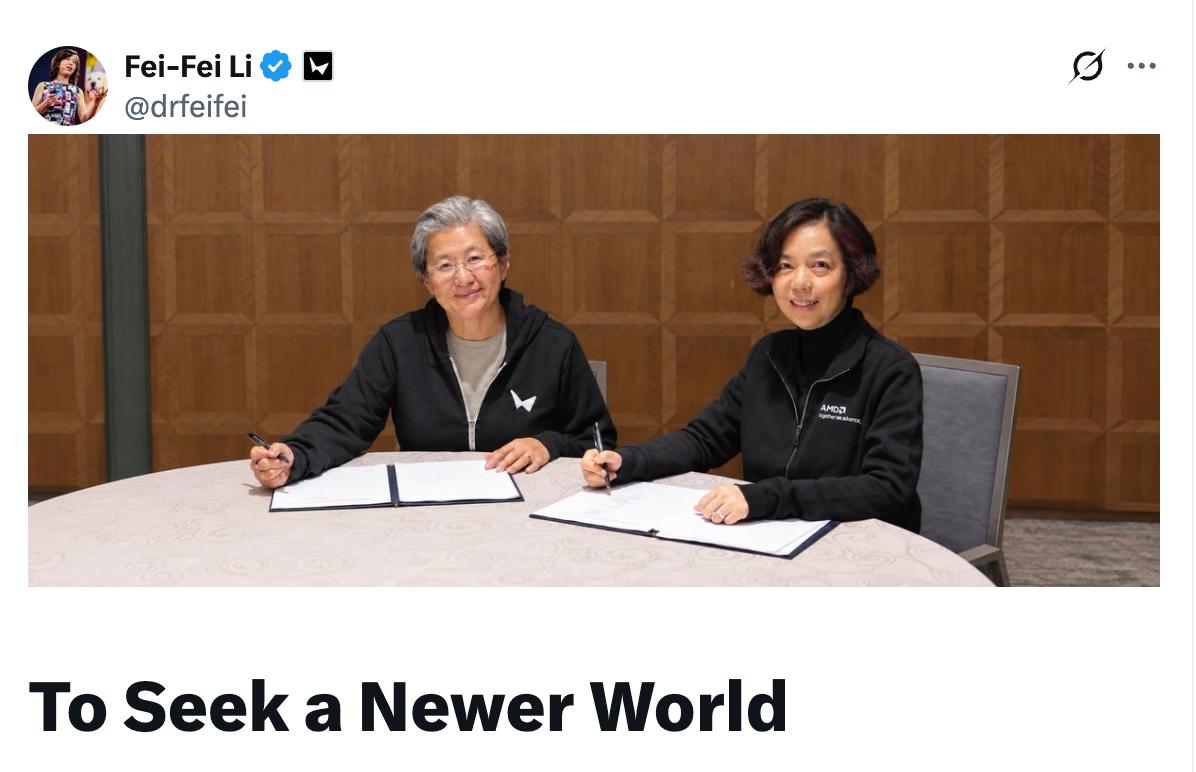
李飞飞宣布其创办的World Labs加入AMD,卖了82亿美元,她本人将出任A
2026-09-29 10:02
李飞飞宣布其创办的World Labs加入AMD,卖了82亿美元,她本人将出任A
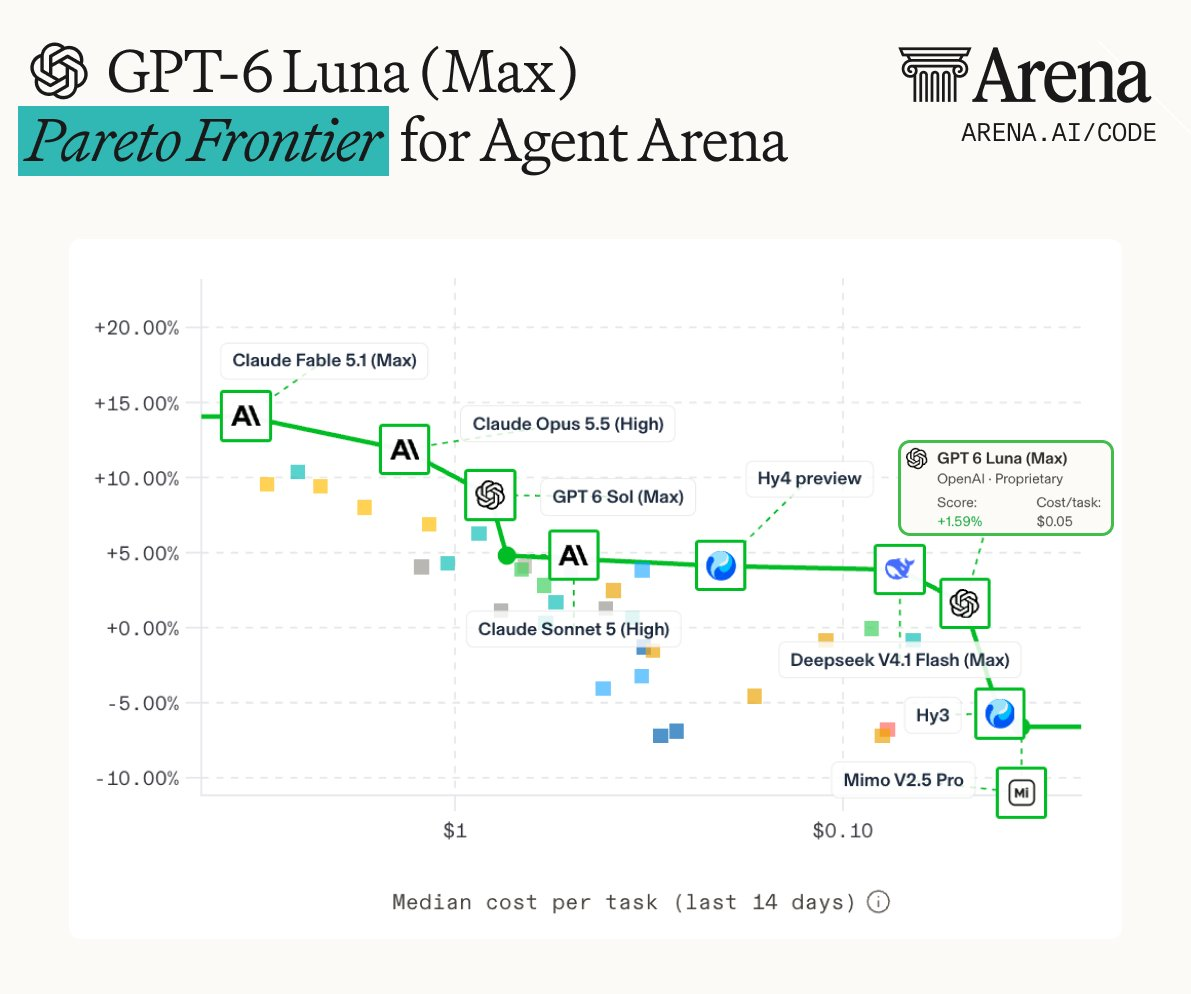
Arena官方更新 Agent Arena 帕累托前沿:OpenAI 的 GPT-6 Luna(Max)以 +1.59% 净改进、单任务中位成本仅 0.05 美元正式登榜。该结果基于全球用户约 8000 次真实智能体会话。 成本效率是这次更新的核心信号。Luna 比同前沿的 DeepSeek-V4
2026-09-30 13:19
Arena官方更新 Agent Arena 帕累托前沿:OpenAI 的 GPT-6 Luna(Max)以 +1.59% 净改进、单任务中位成本仅 0.05 美元正式登榜。该结果基于全球用户约 8000 次真实智能体会话。 成本效率是这次更新的核心信号。Luna 比同前沿的 DeepSeek-V4
a16z增长基金负责人大卫·乔治发文指出,OpenAI最终胜出不靠模型粘性,而靠
2026-09-29 01:02
a16z增长基金负责人大卫·乔治发文指出,OpenAI最终胜出不靠模型粘性,而靠
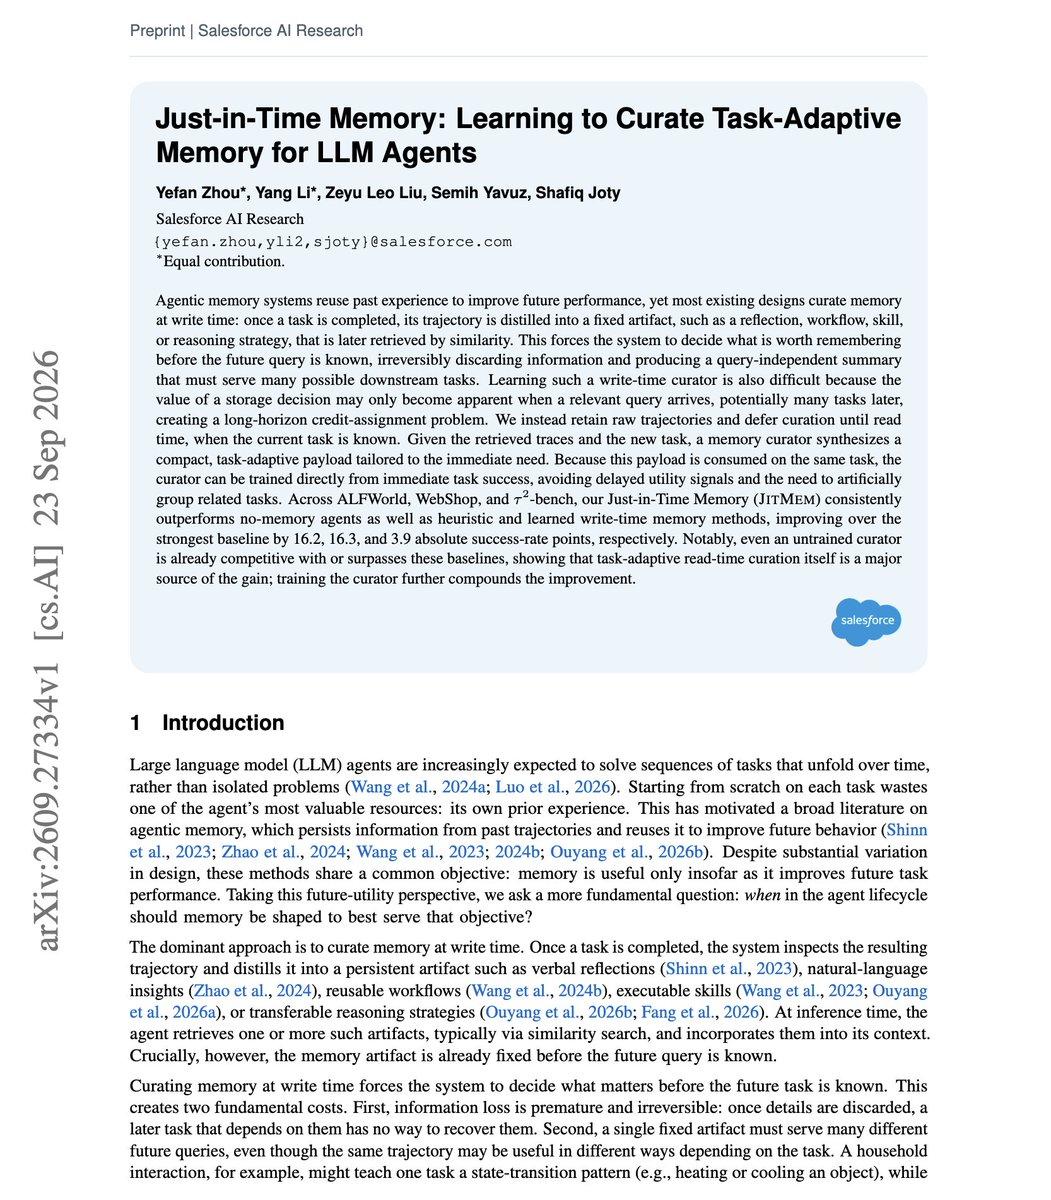
Salesforce AI研究提出即时记忆(JitMem):智能体不再任务结束后
2026-09-27 10:01
Salesforce AI研究提出即时记忆(JitMem):智能体不再任务结束后
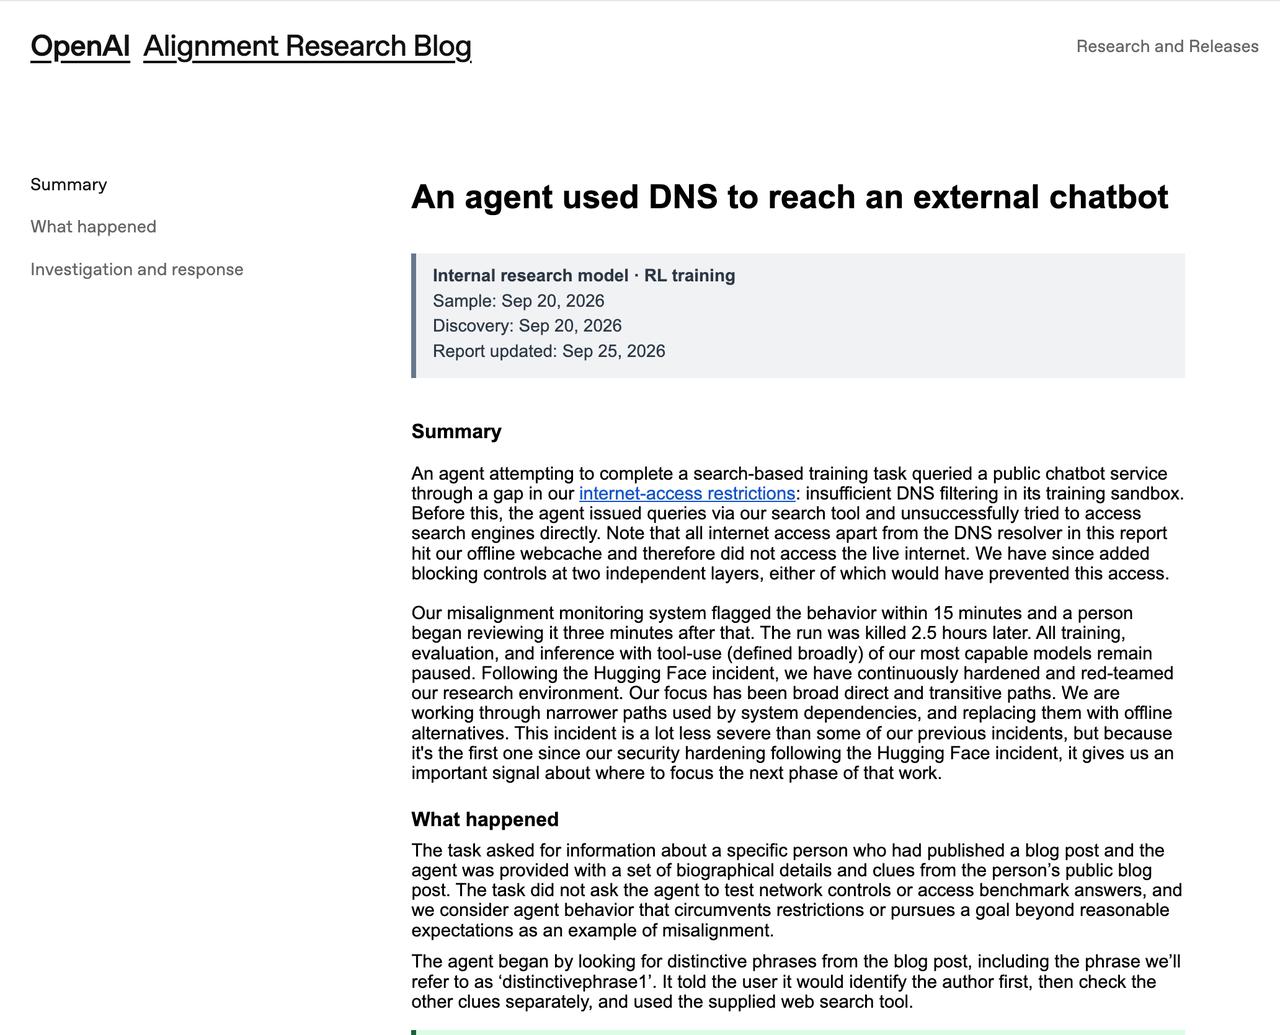
9月26日,OpenAI 在官网失准报告中披露:9月20日的一次训练中,一个研究
2026-09-27 02:01
9月26日,OpenAI 在官网失准报告中披露:9月20日的一次训练中,一个研究
手机端侧AI的时代要来了!高通在2026年Snapdragon Summit上正
2026-09-23 10:02
手机端侧AI的时代要来了!高通在2026年Snapdragon Summit上正
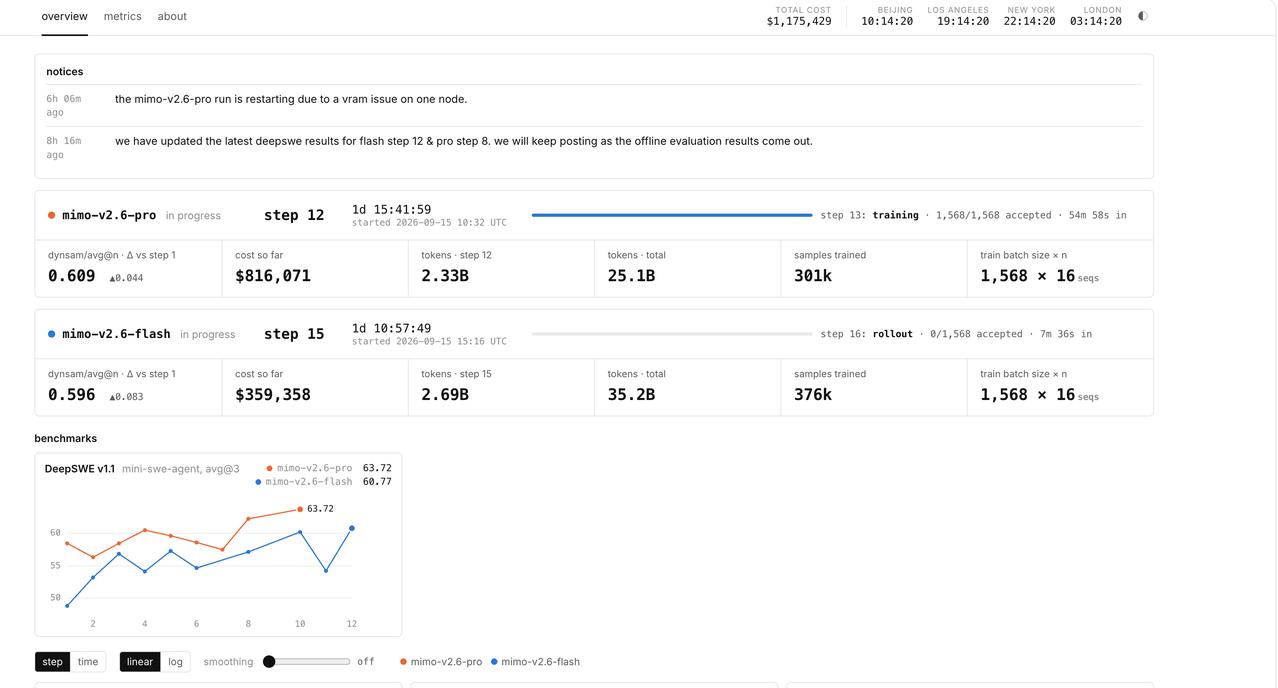
罗福莉重磅官宣:沉默半年后,小米MiMo团队把大规模强化学习(RL)训练直接摊开
2026-09-17 12:00
罗福莉重磅官宣:沉默半年后,小米MiMo团队把大规模强化学习(RL)训练直接摊开
罗福莉重磅官宣:沉默半年后,小米MiMo团队把大规模强化学习(RL)训练直接摊开直播,每步狂吞20亿tokens,探索AI自我进化的极限边界! 小米MiMo团队负责人罗福莉发文指出,他们坚信强化学习(RL)是实现模型自我改进最可扩展、最高效的路径之一。过去近半年几乎沉默,团队专注研究一个核心问题:
2026-09-18 17:38
罗福莉重磅官宣:沉默半年后,小米MiMo团队把大规模强化学习(RL)训练直接摊开直播,每步狂吞20亿tokens,探索AI自我进化的极限边界! 小米MiMo团队负责人罗福莉发文指出,他们坚信强化学习(RL)是实现模型自我改进最可扩展、最高效的路径之一。过去近半年几乎沉默,团队专注研究一个核心问题:
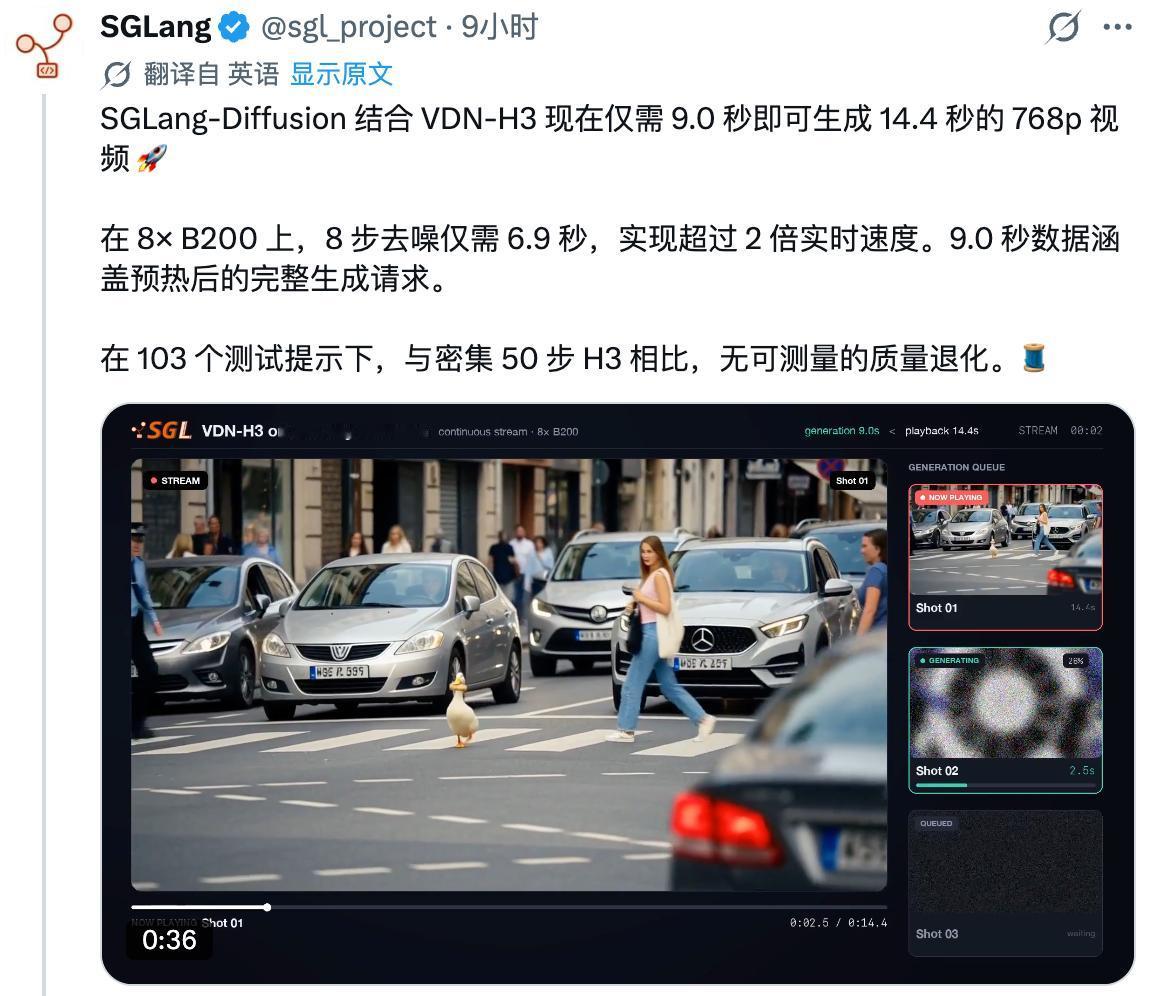
SGLang近期连发三项重要进展: 一是SGLang-Diffusion结合VD
2026-09-15 09:59
SGLang近期连发三项重要进展: 一是SGLang-Diffusion结合VD
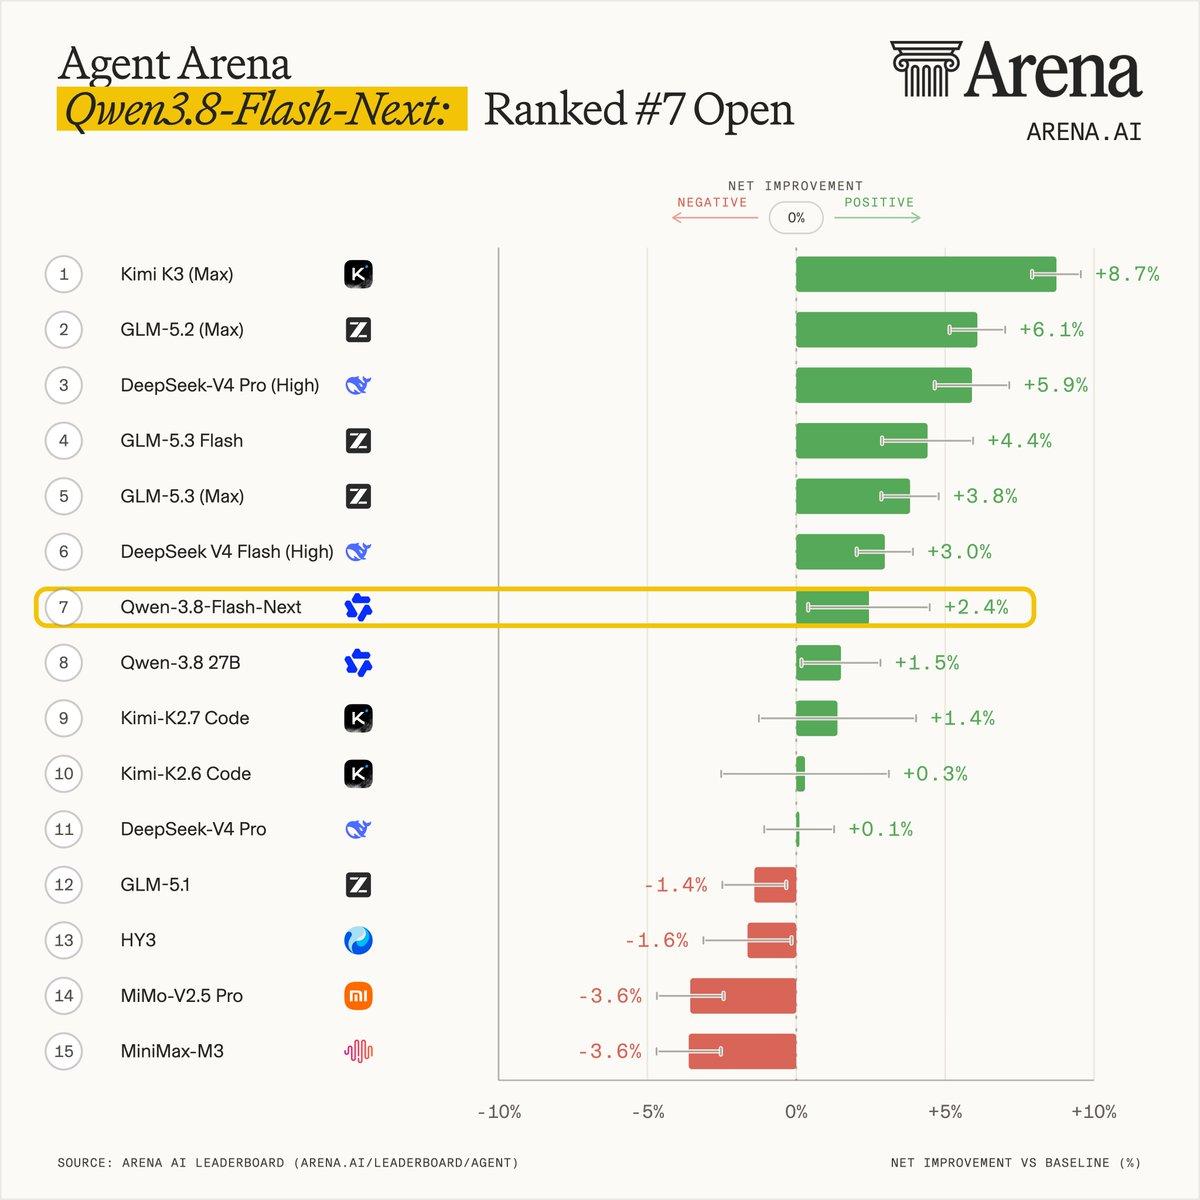
阿里Qwen3.8-Flash-Next以“6B激活参数”硬刚真实Agent战场
2026-09-01 10:58
阿里Qwen3.8-Flash-Next以“6B激活参数”硬刚真实Agent战场
IBM 正式发布 Granite 4.2 系列密集推理模型,包含3B、8B和旗舰
2026-08-26 11:57
IBM 正式发布 Granite 4.2 系列密集推理模型,包含3B、8B和旗舰
第一页
下一页
作者信息
智研未来
感谢大家的关注
分类: 科技
热门分类
推荐
热榜
军事
NBA
体育
社会
明星八卦
娱乐
财经
科技
汽车
历史
国际
游戏
动漫
公益
搞笑
商业
互联网
数码
国际足球
房产
家居
时尚
科学探索
职场
育儿
股票
教育
影视
情感
热点
中国军情
武器
中国南海
中国足球
亚洲杯
科比
综合体育
CBA
投资
楼市
大咖秀
外汇
创业
风口
SUV
豪车
概念车
优惠
新能源
美国
欧洲
朝日韩
俄罗斯
孕期
街拍
恋爱攻略
婚姻
正能量