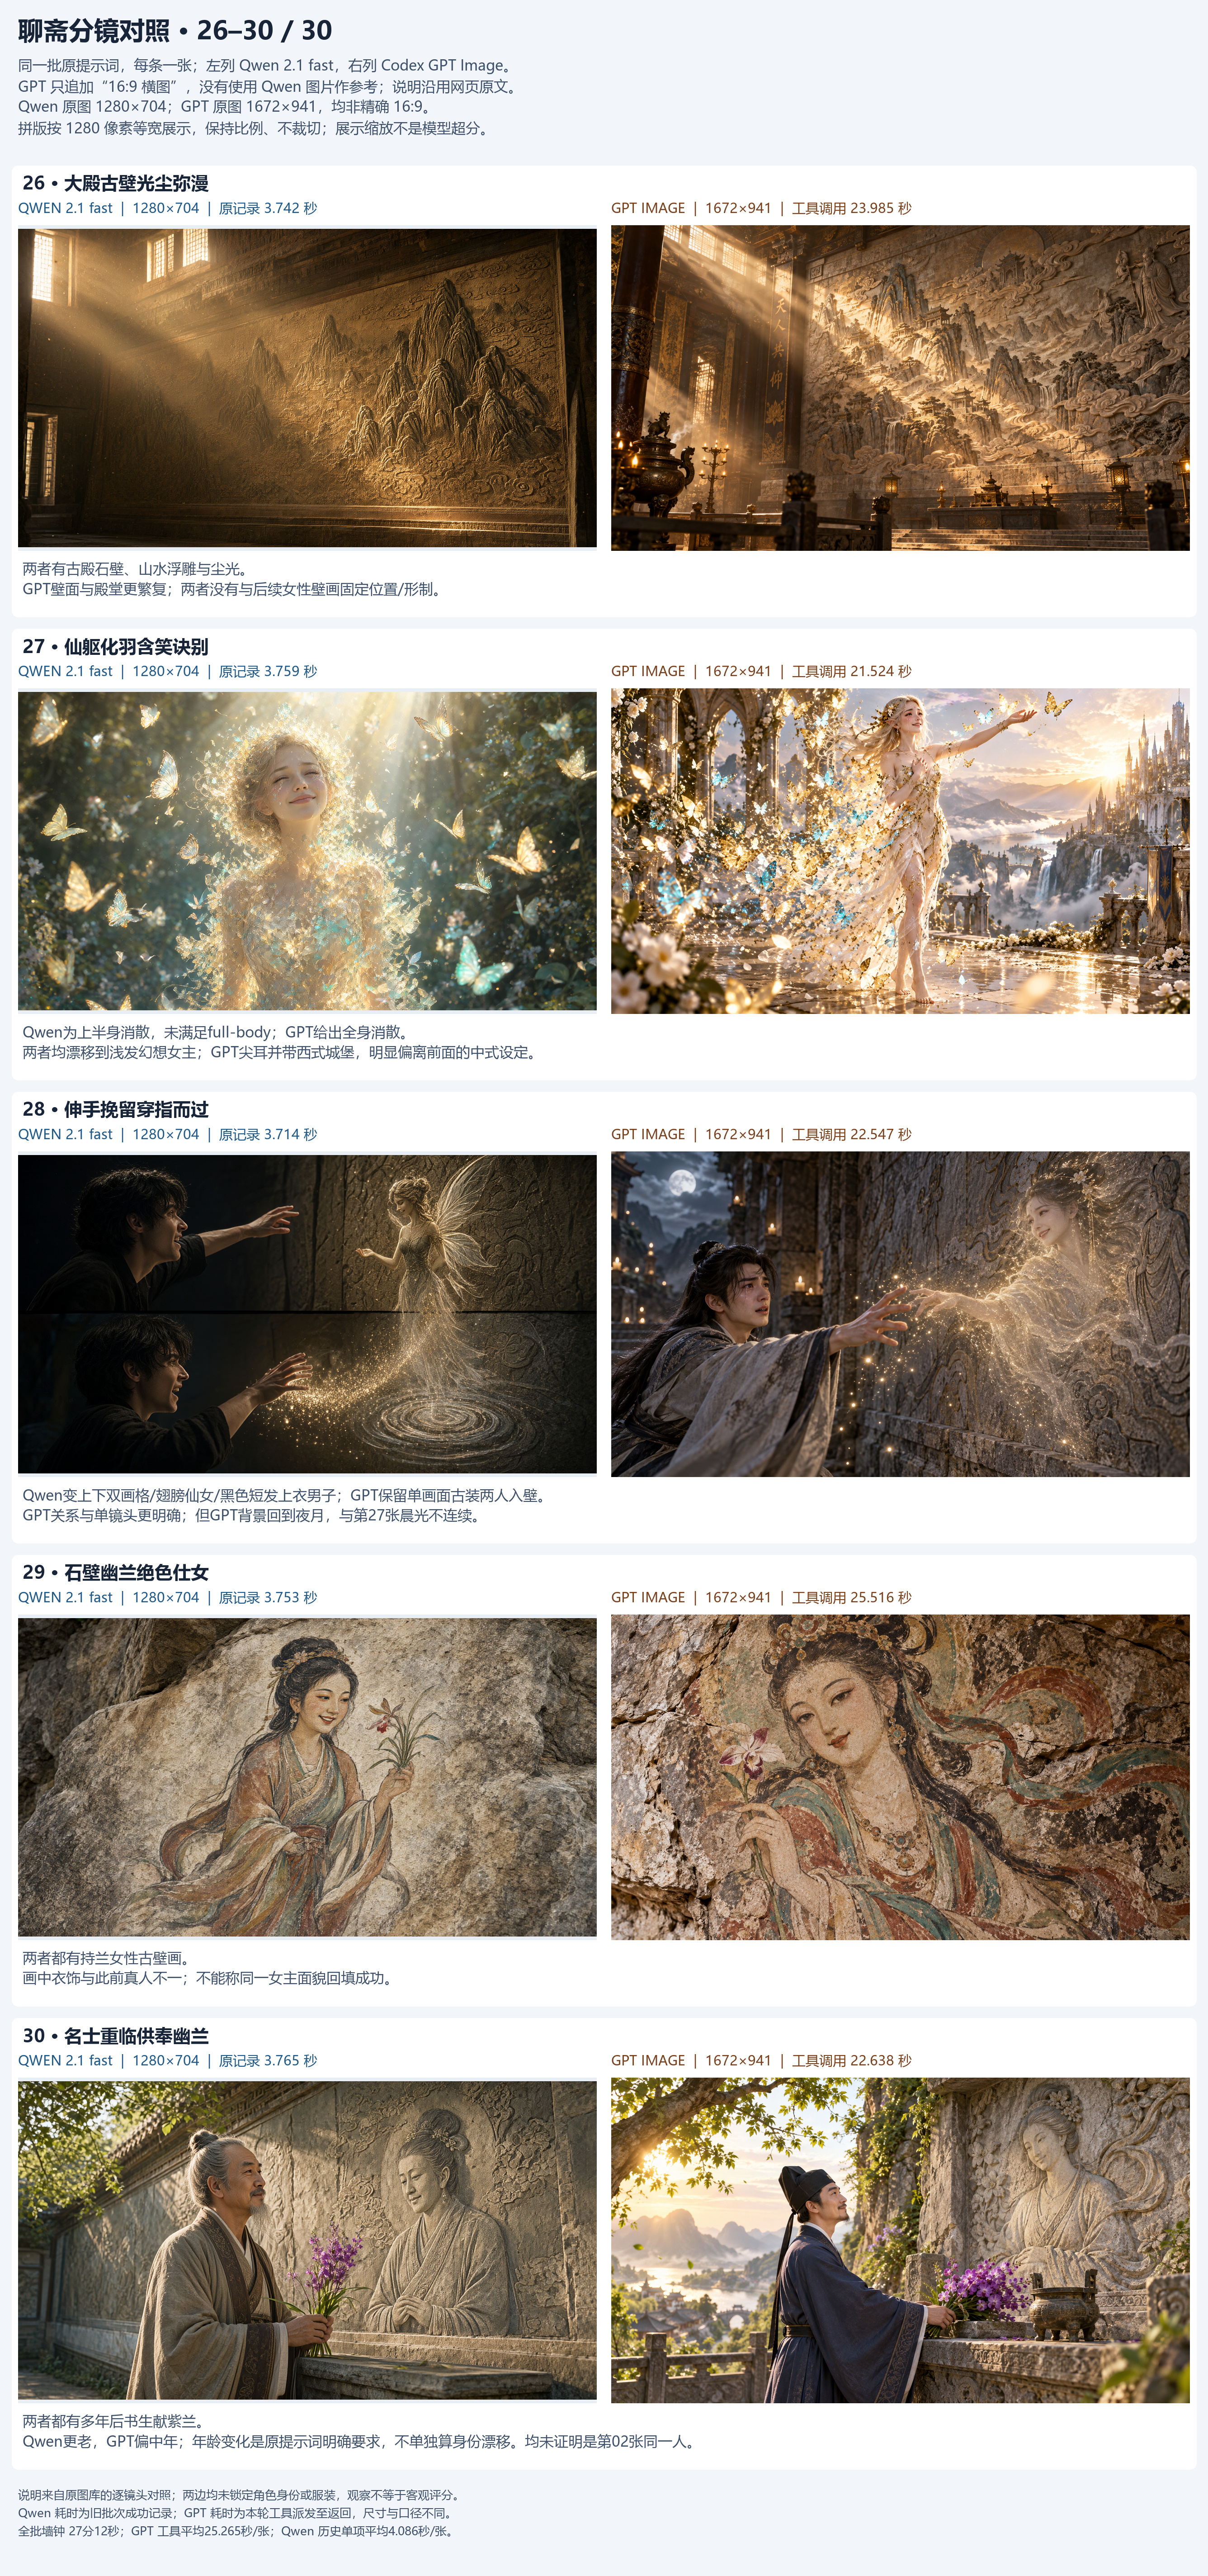
「AI」用Antigravity一次生成了30条聊斋分镜提示词,它把故事命名为《画壁幽兰》。然后把分镜提示词导入Qwen IMAGE 2.1用3090显卡批量生成,要求的是1280*720分辨率,最终得到的是1280×704分辨率,单张耗时4.09秒,30张耗时2分41秒。
随后把同样的提示词提交给Codex批量生成,它动用的是内置的GPT IMAGE 2.5,不设分辨率限制,只强调16:9的比例,得到的是1672×941分辨率,单张耗时25.27秒,30张总计耗时27分12秒。
GPT的时间包含了每一张、每一次的工具调用、云端工具开销、Agent调度、记录、保存,两者输出的像素量、模型参数、计时范围都不同。如果是用API的批量接口,则会显著不同。Qwen IMAGE 2.1在本地被我优化过了,它走的就是批量生成的高速路径。按照这种速度,一天能生成2.1万张。
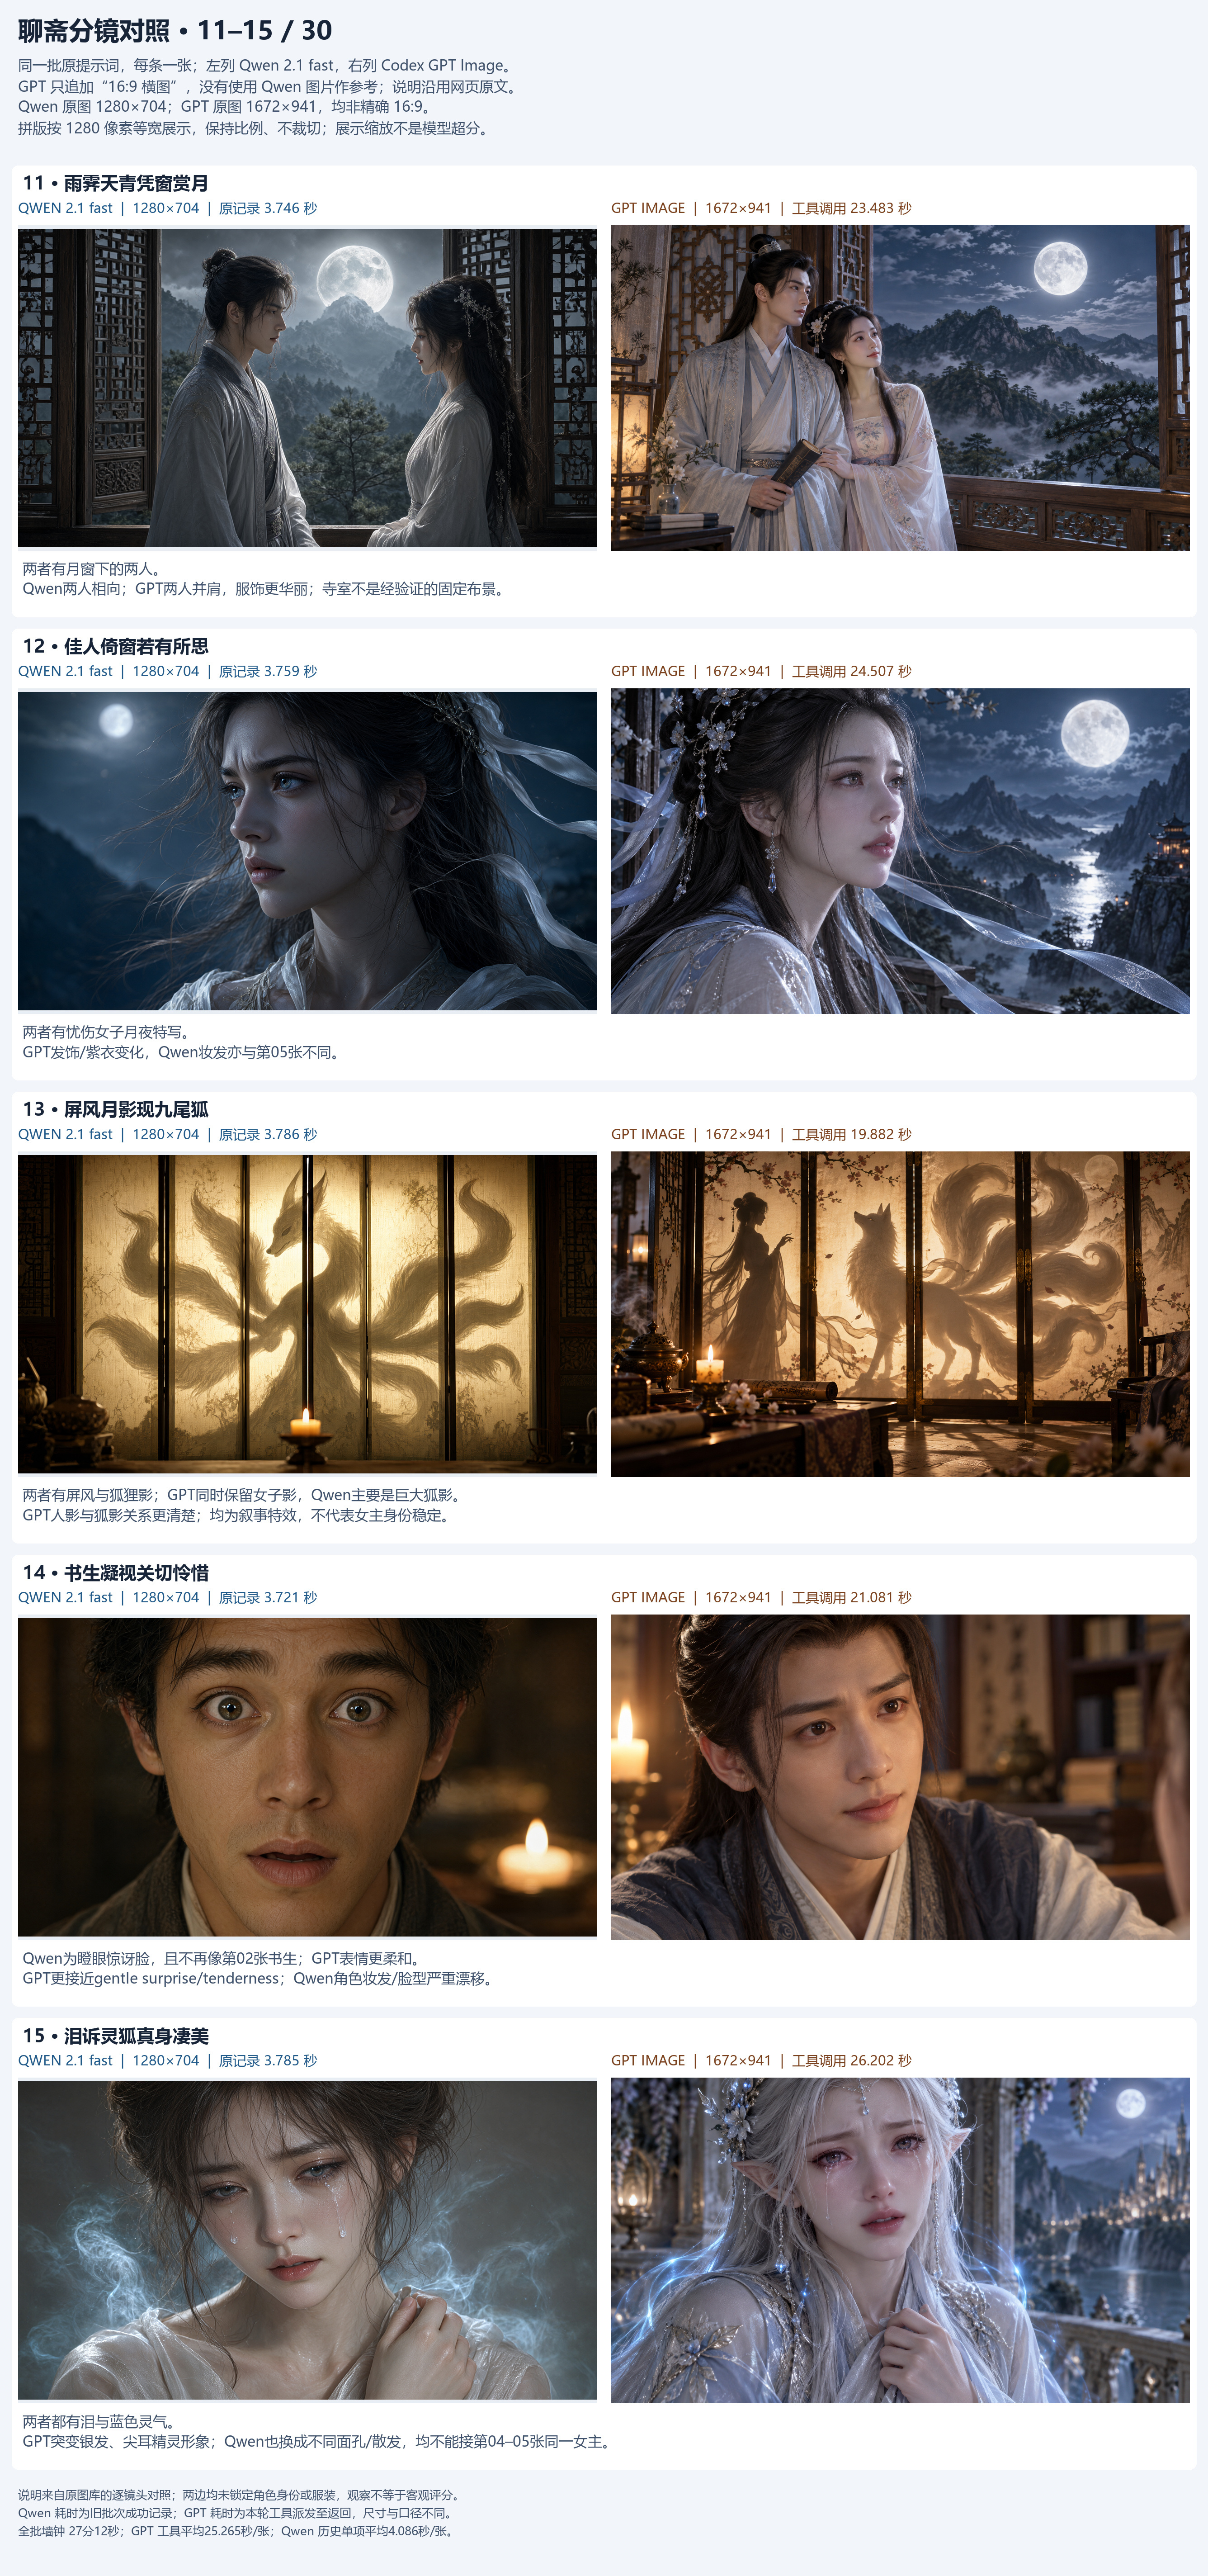
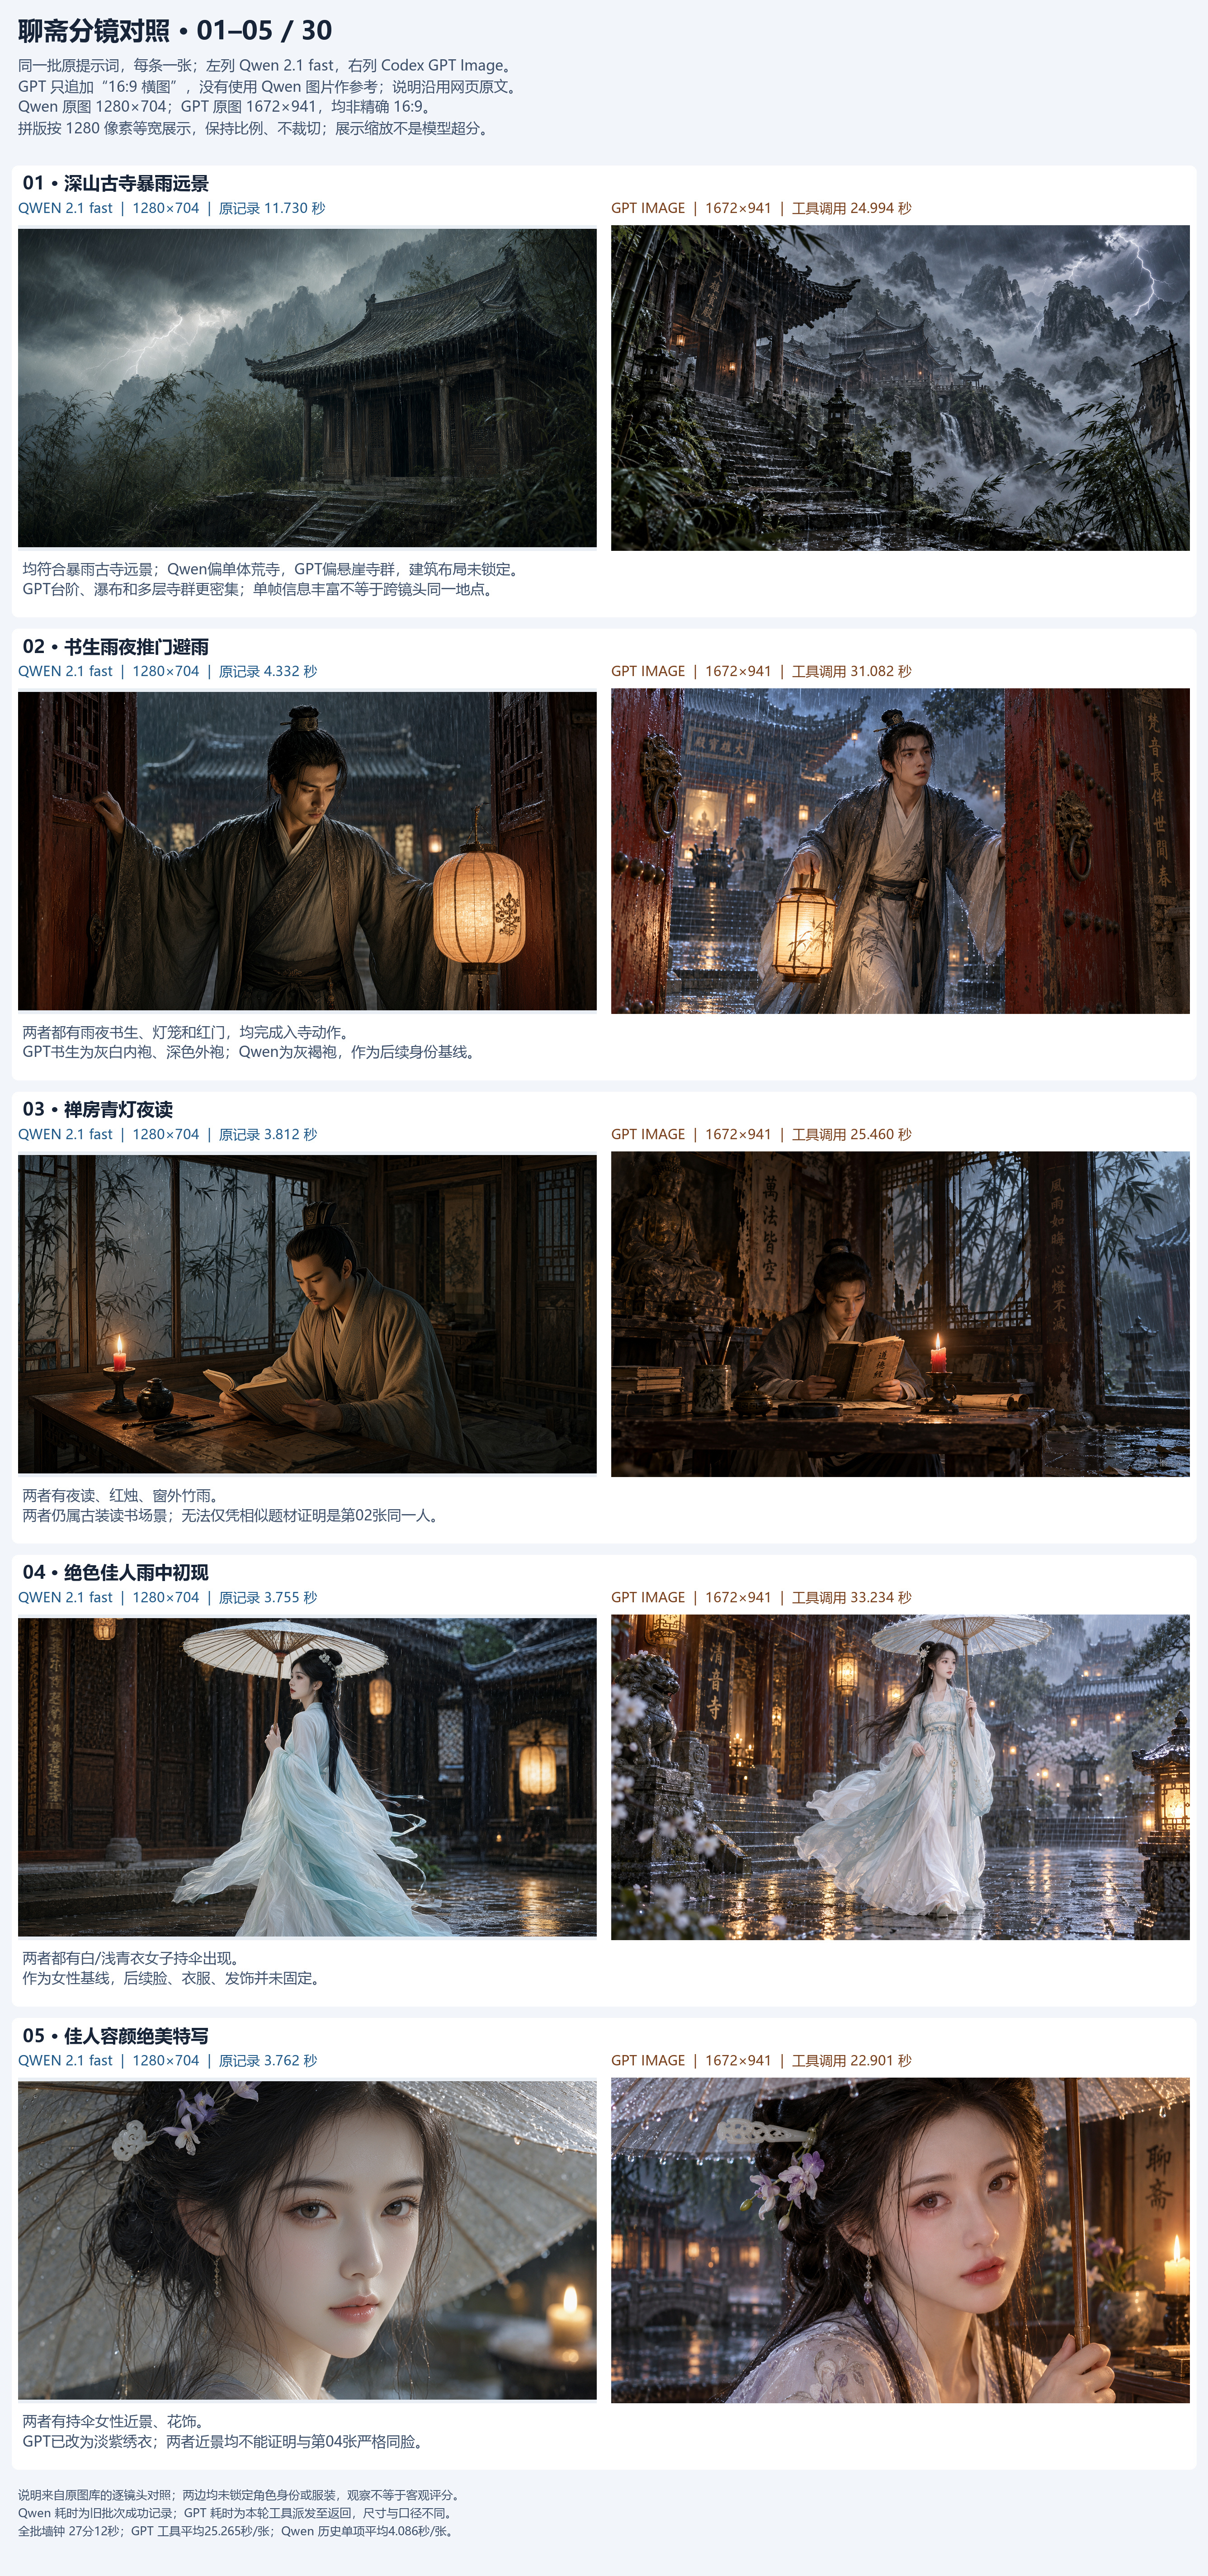
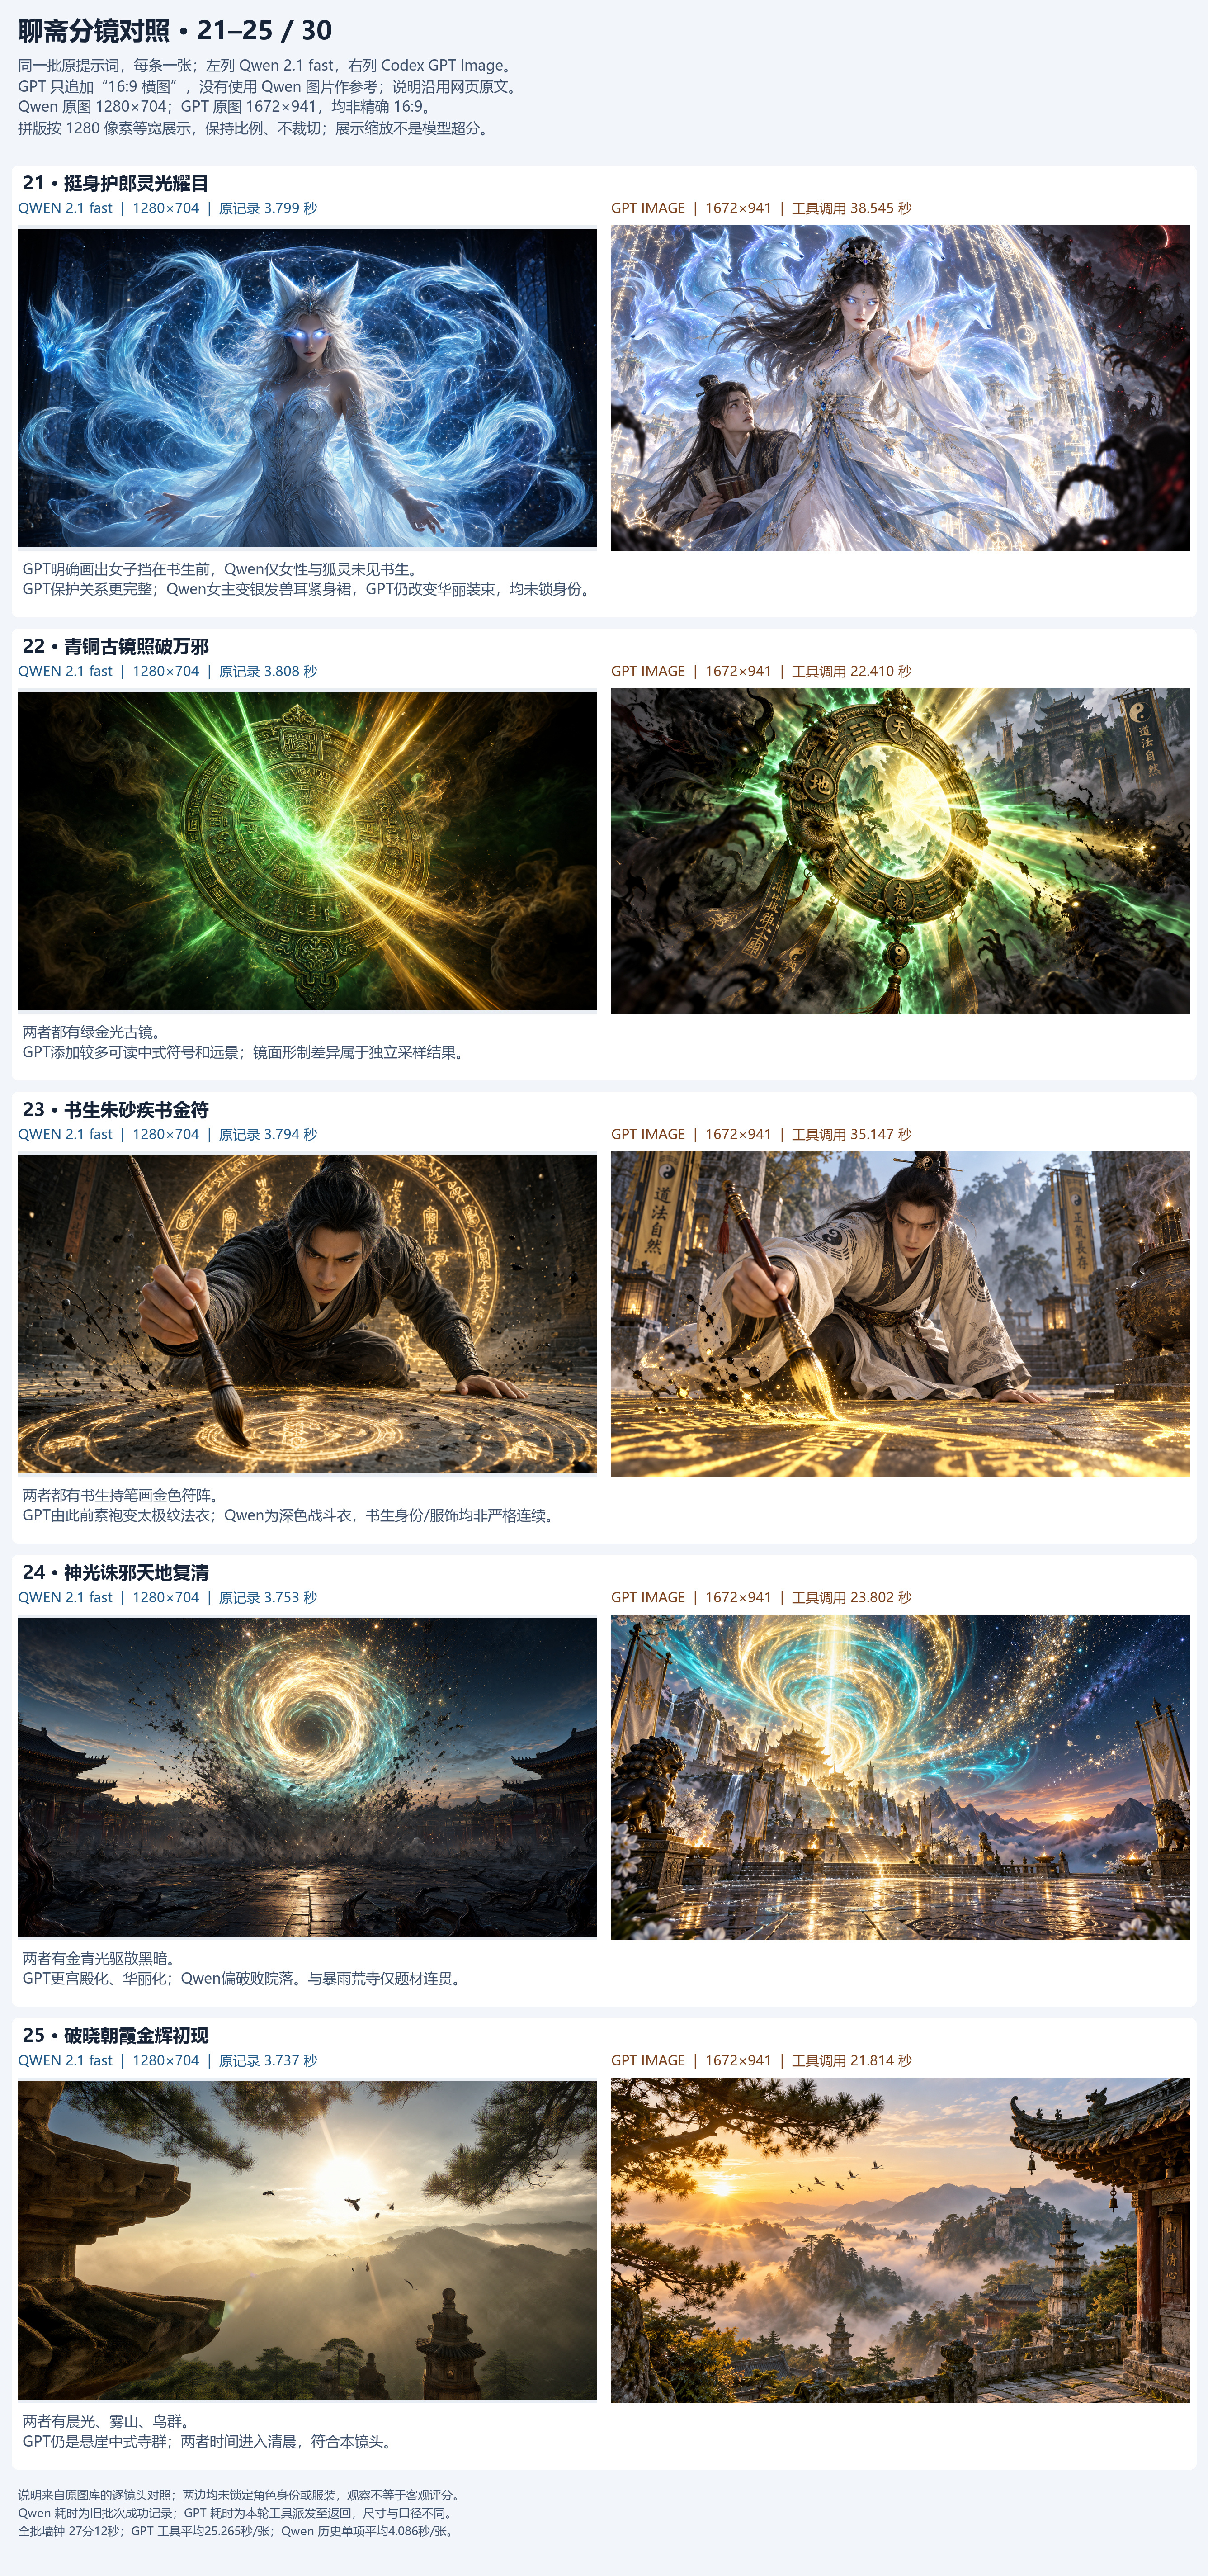
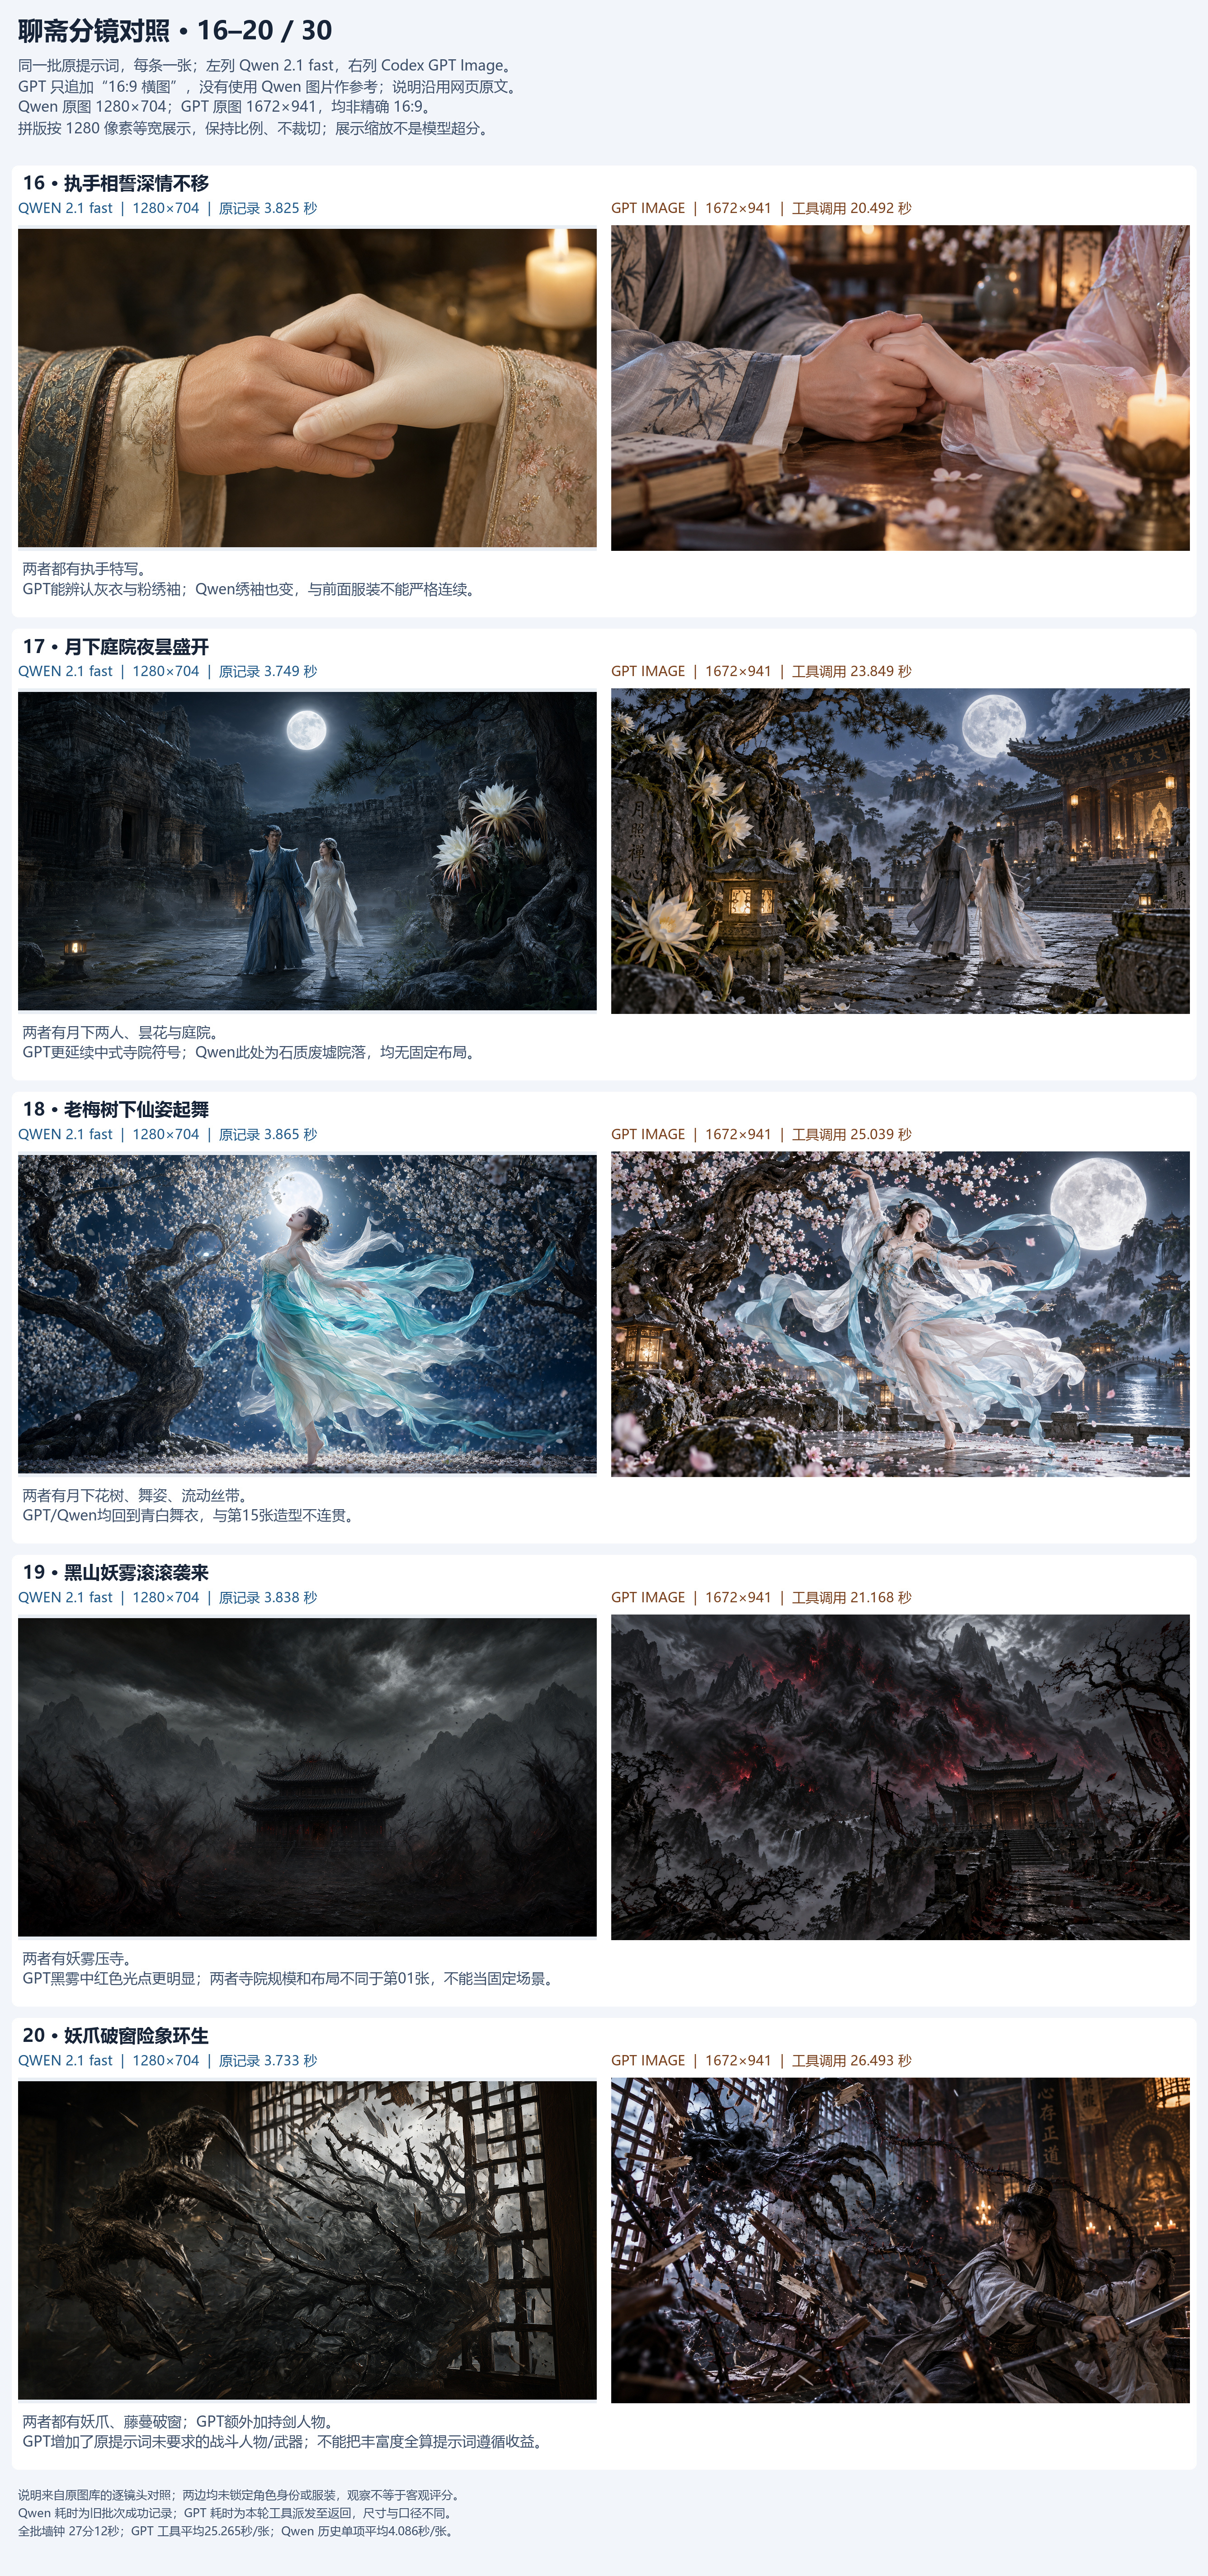
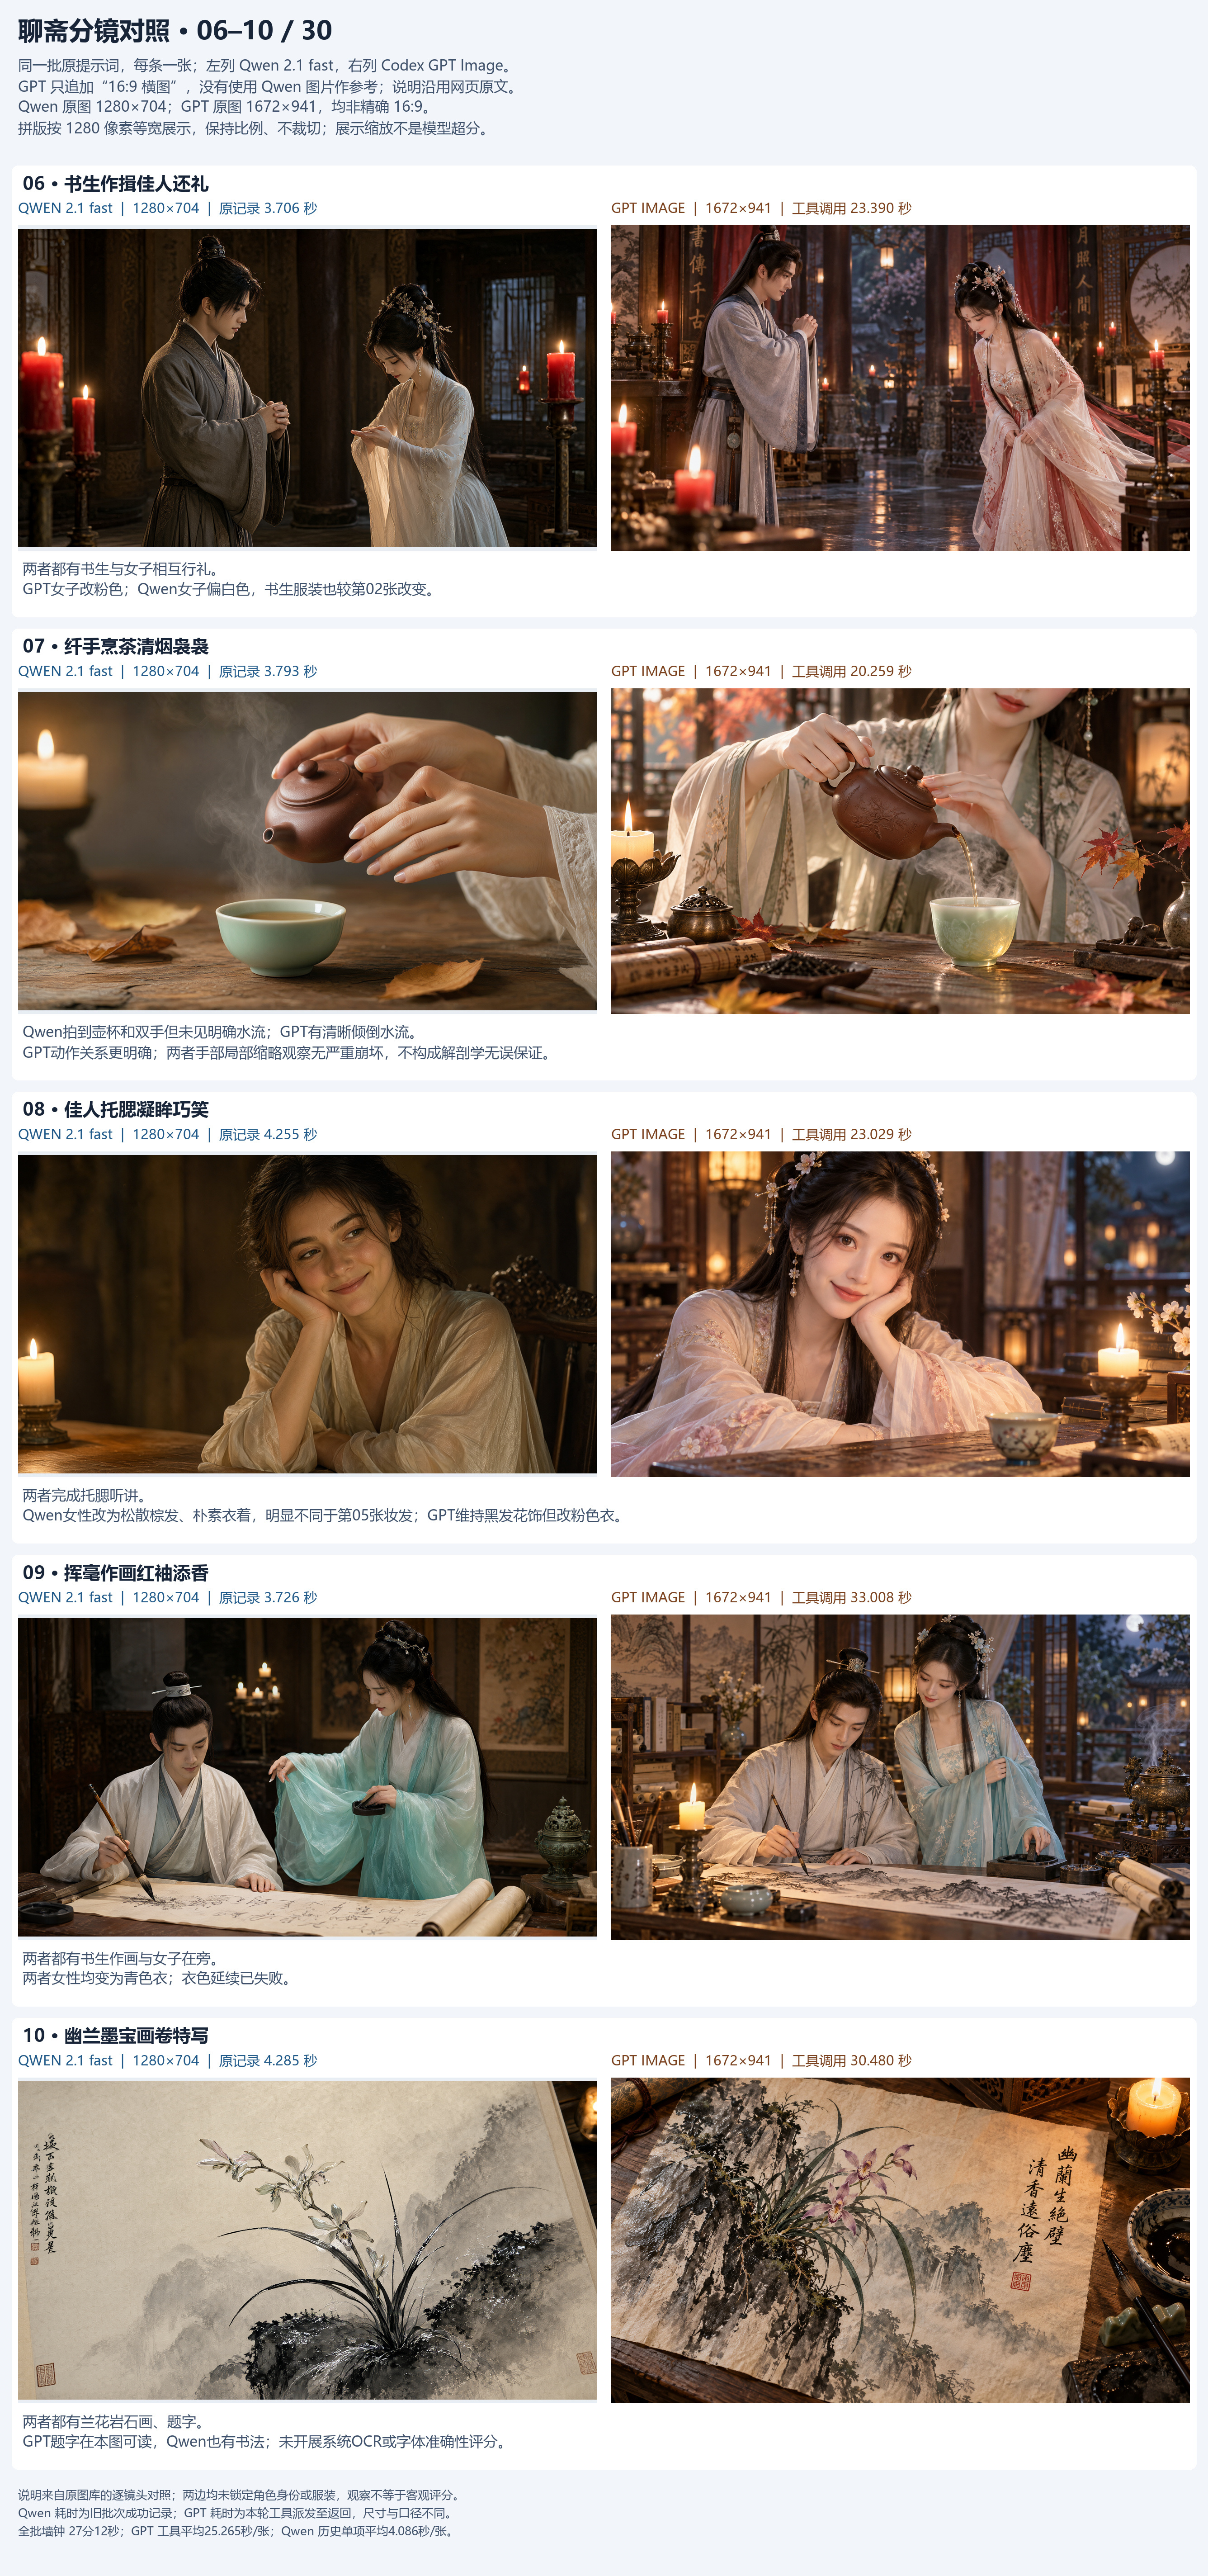
只是心血来潮,而不是严格对比。我想看的既是时间,又是场景和人物一致性,又是画质,又是产能。60张图片,被Codex做成了对比的网页,并进行直接评判。我自己的观感是,GPT的镜头理解更好,两者的人物一致性都不高,在于Antigravity的提示词写得不好。当然,这也不能怪它,我给的任务就是一句“写一个聊斋故事的30个分镜提示词”,别的都没说。
本地模型的产能效率“拉满”。第一次玩这种游戏,玩的就是批量,因为我刚刚把批量生成配置好,并且做成了可被云端Agent直接调用的技能。我感觉到,这真的有点像“抽卡”,如果要做图生视频,抽卡环节必不可少。GPT IMAGE 2.5在这里是大材小用了,它原生支持4K直出,本来一直都是图片生成的第一名。
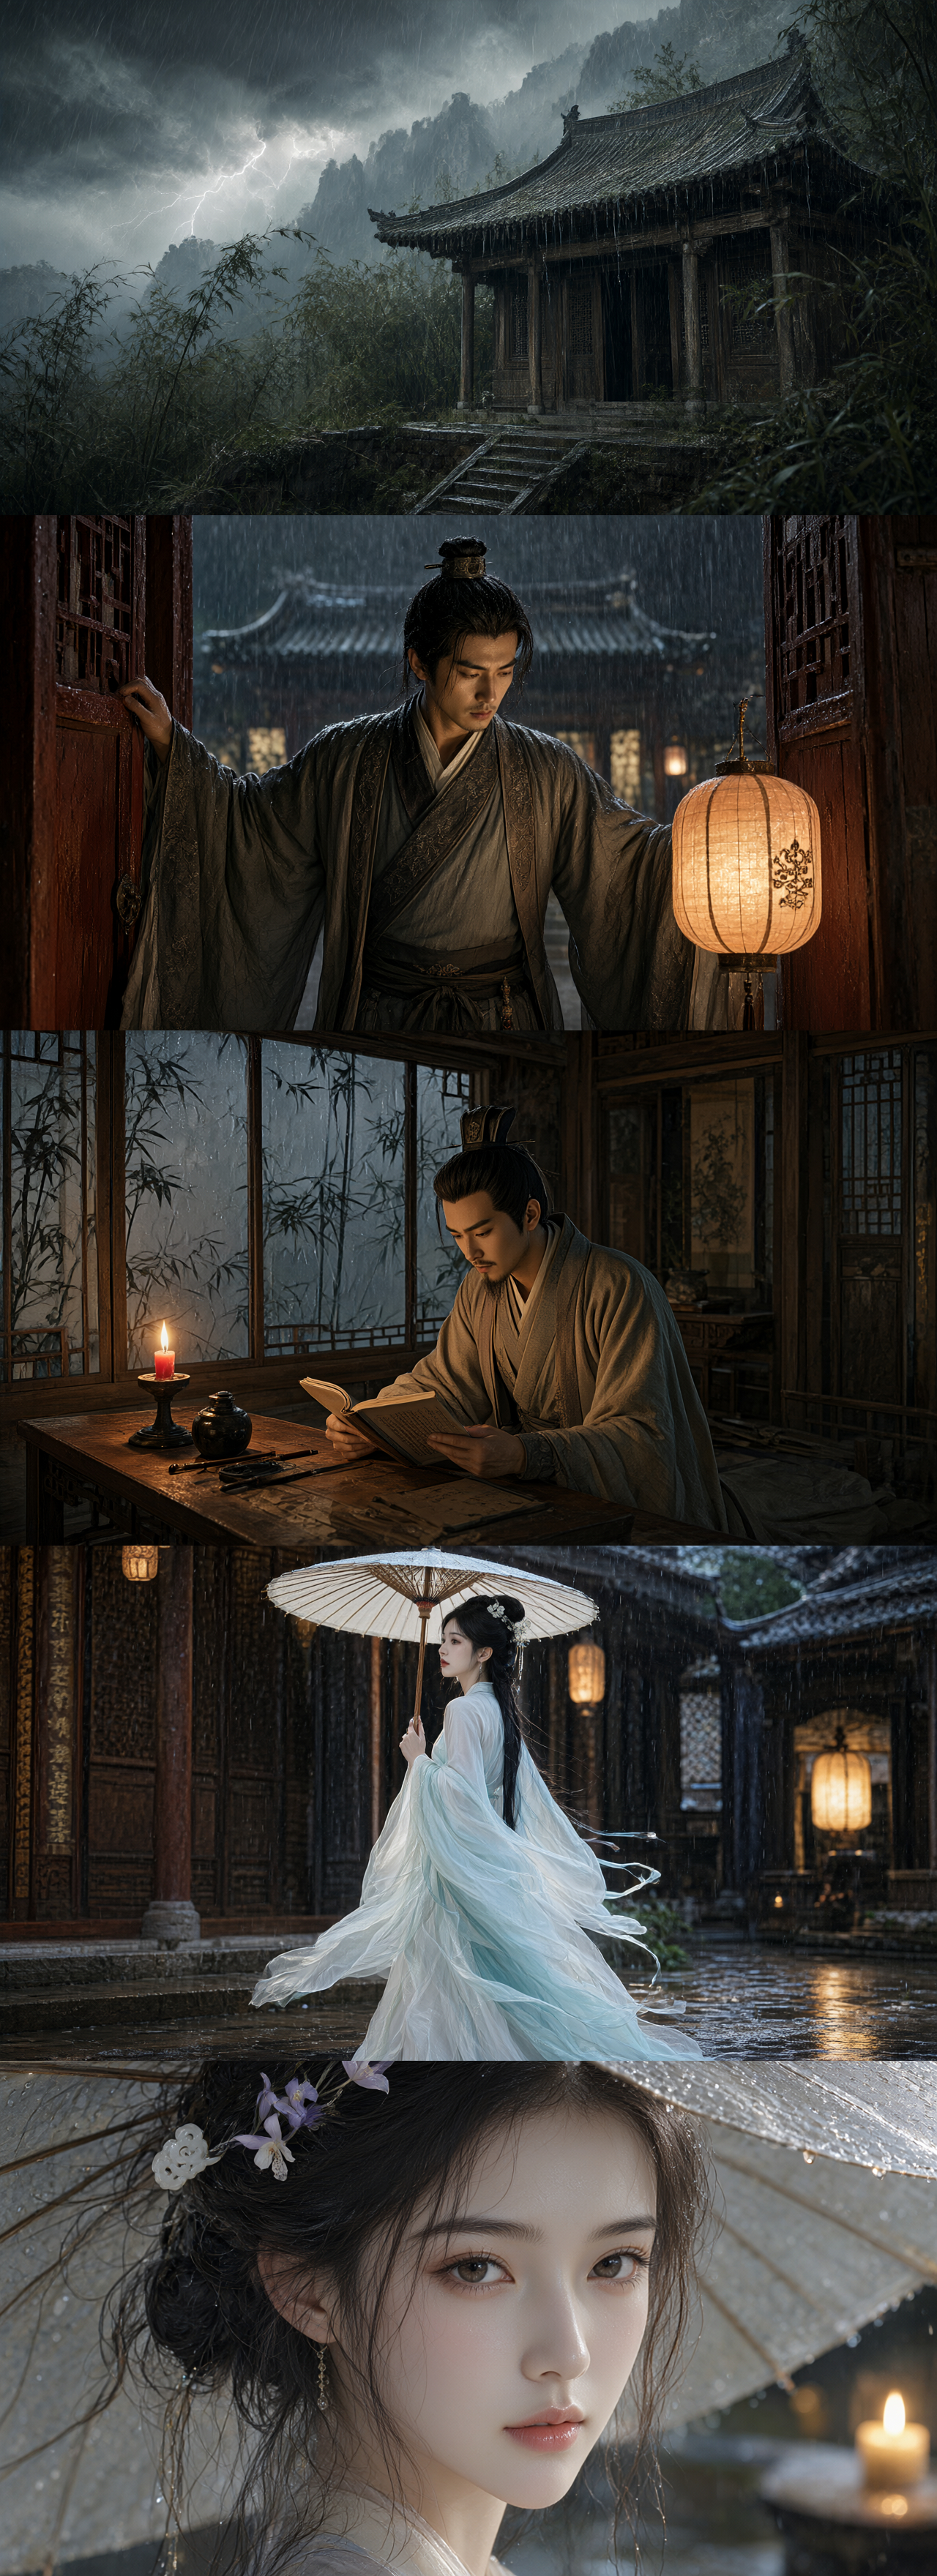
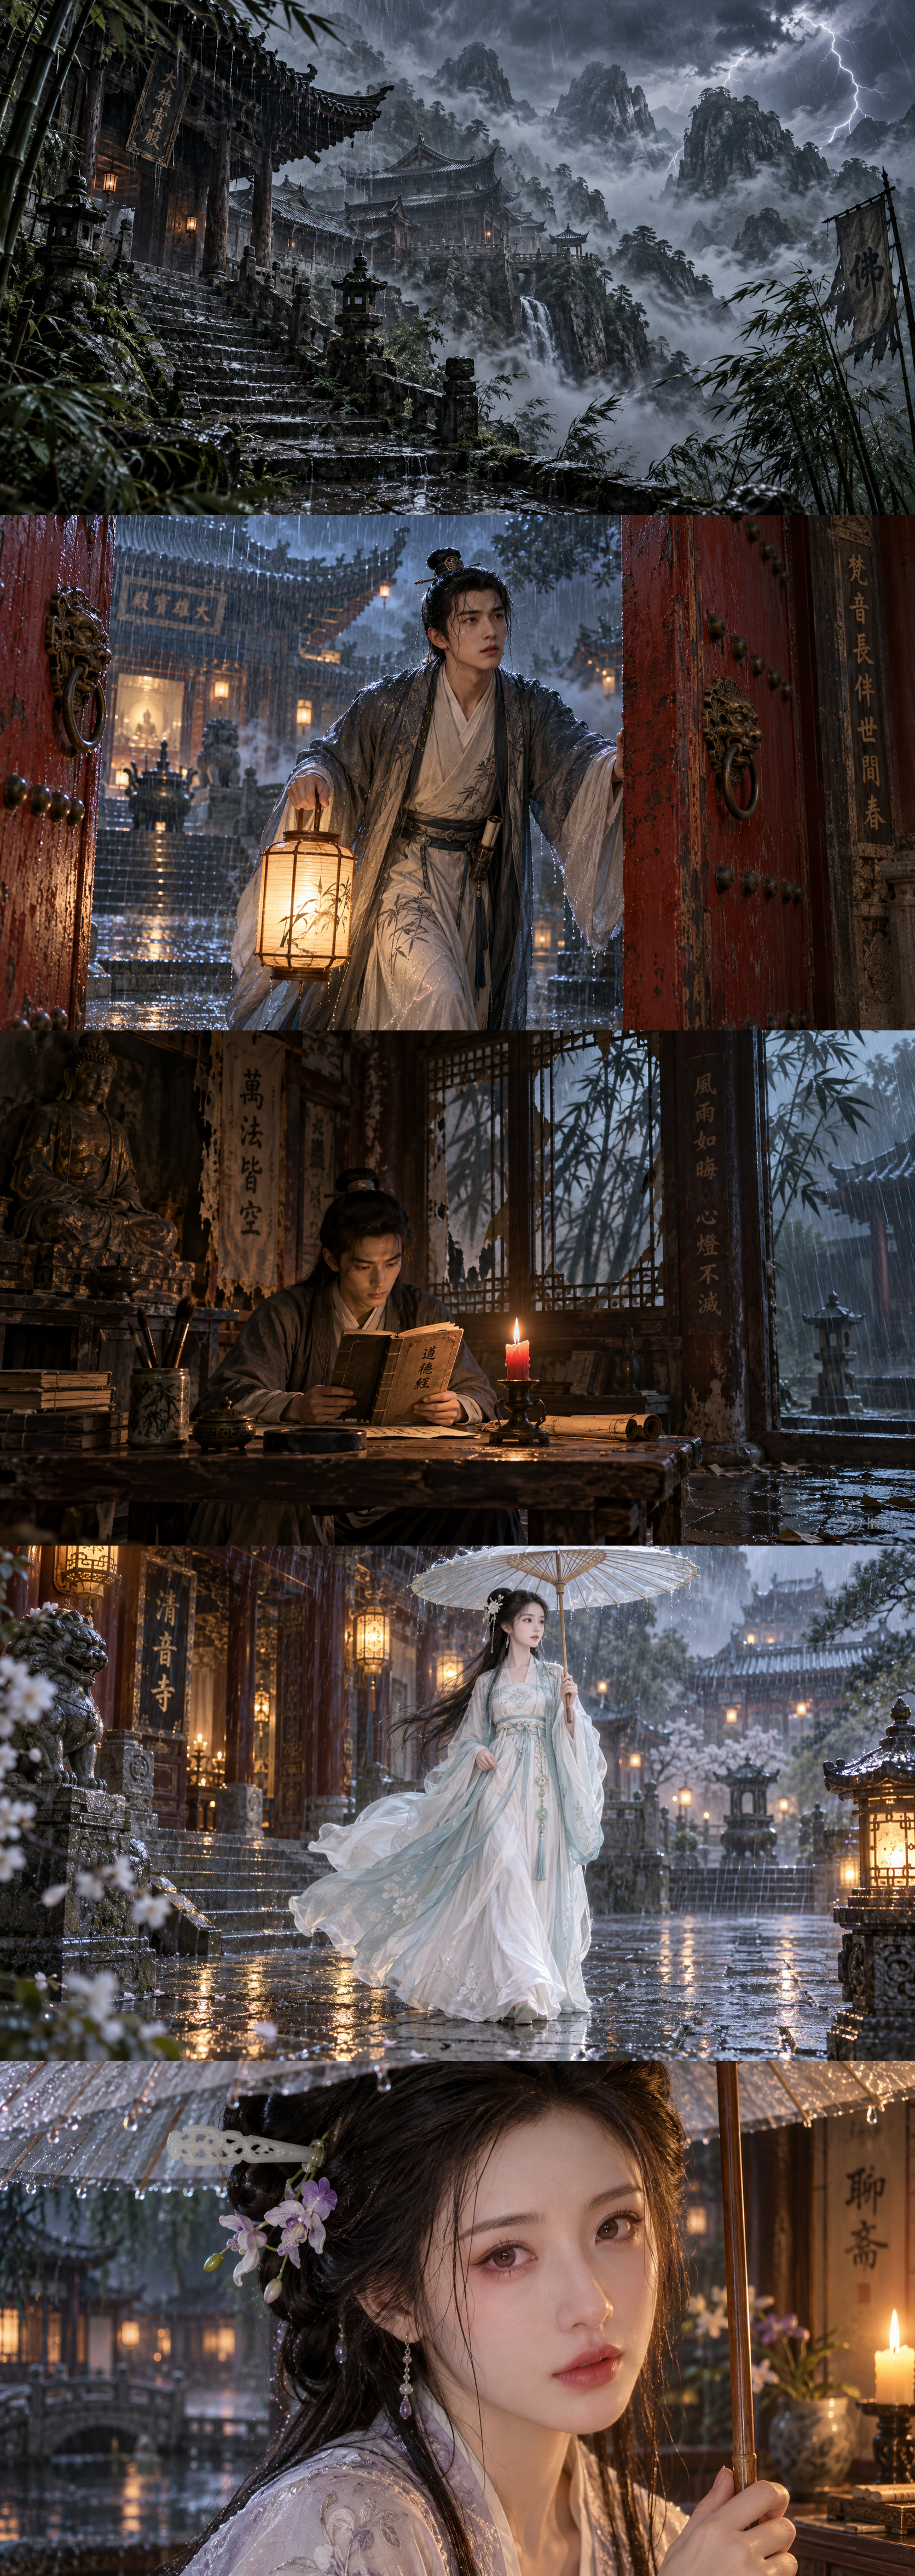
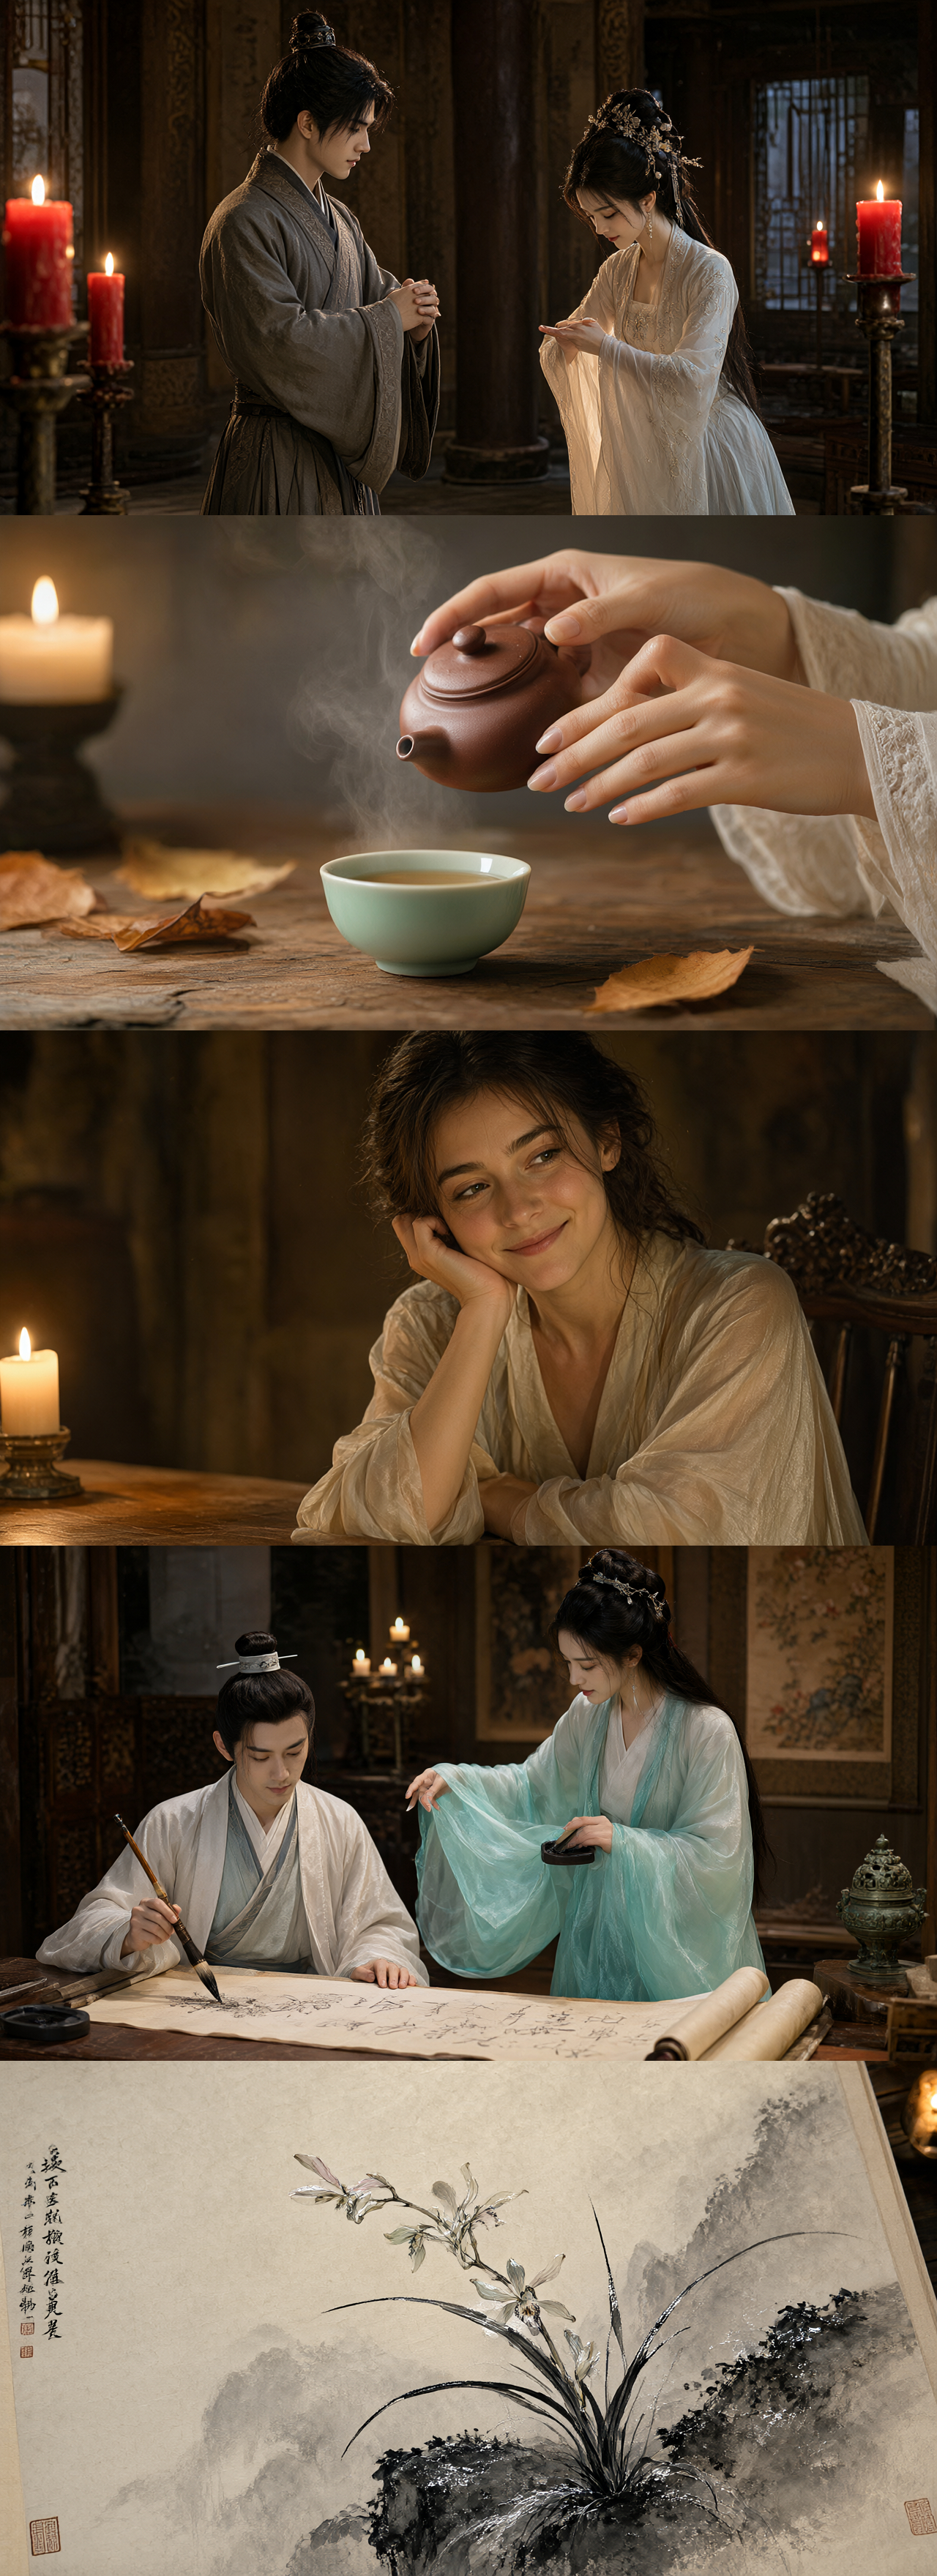
图1到图6是30张Qwen分镜和30张GPT分镜的对比。图7到图18,是60张图的原图拼接。例如图7是Qwen的前5张,图8是GPT的前5张;图9是Qwen的第6到第10张,图10是GPT的第6到第10张;以此类推。
微博能接受原图,也是人才啊。一条微博,直接上120张图片,我很凶。