请注意:会生成、会评审、会修改,是大模型三种完全不同的能力。
用 AI 生图,与其生成一张让它改十遍,不如一次生十张,挑出最好的那张 —— 因为GPT会生成,但未必会修改。
这有点像「文章本天成,妙手偶得之」。
想象一下,李白喝着酒写了首诗。第二天你拿着诗去找他:这两句挺好,能不能再改改,把昨晚那个劲儿给加深一些?
「划水的青蛙」讲 Fable 5.2,也聊起了“会生成、会评审、会修改”这个事情:
① 会生成,不一定会评审。
这就像既当运动员又当裁判,给自己打分容易手松。Anthropic 做前端实验时发现,AI 写完网页,再让它自己评,明明做得普通,也能给自己一通好评。
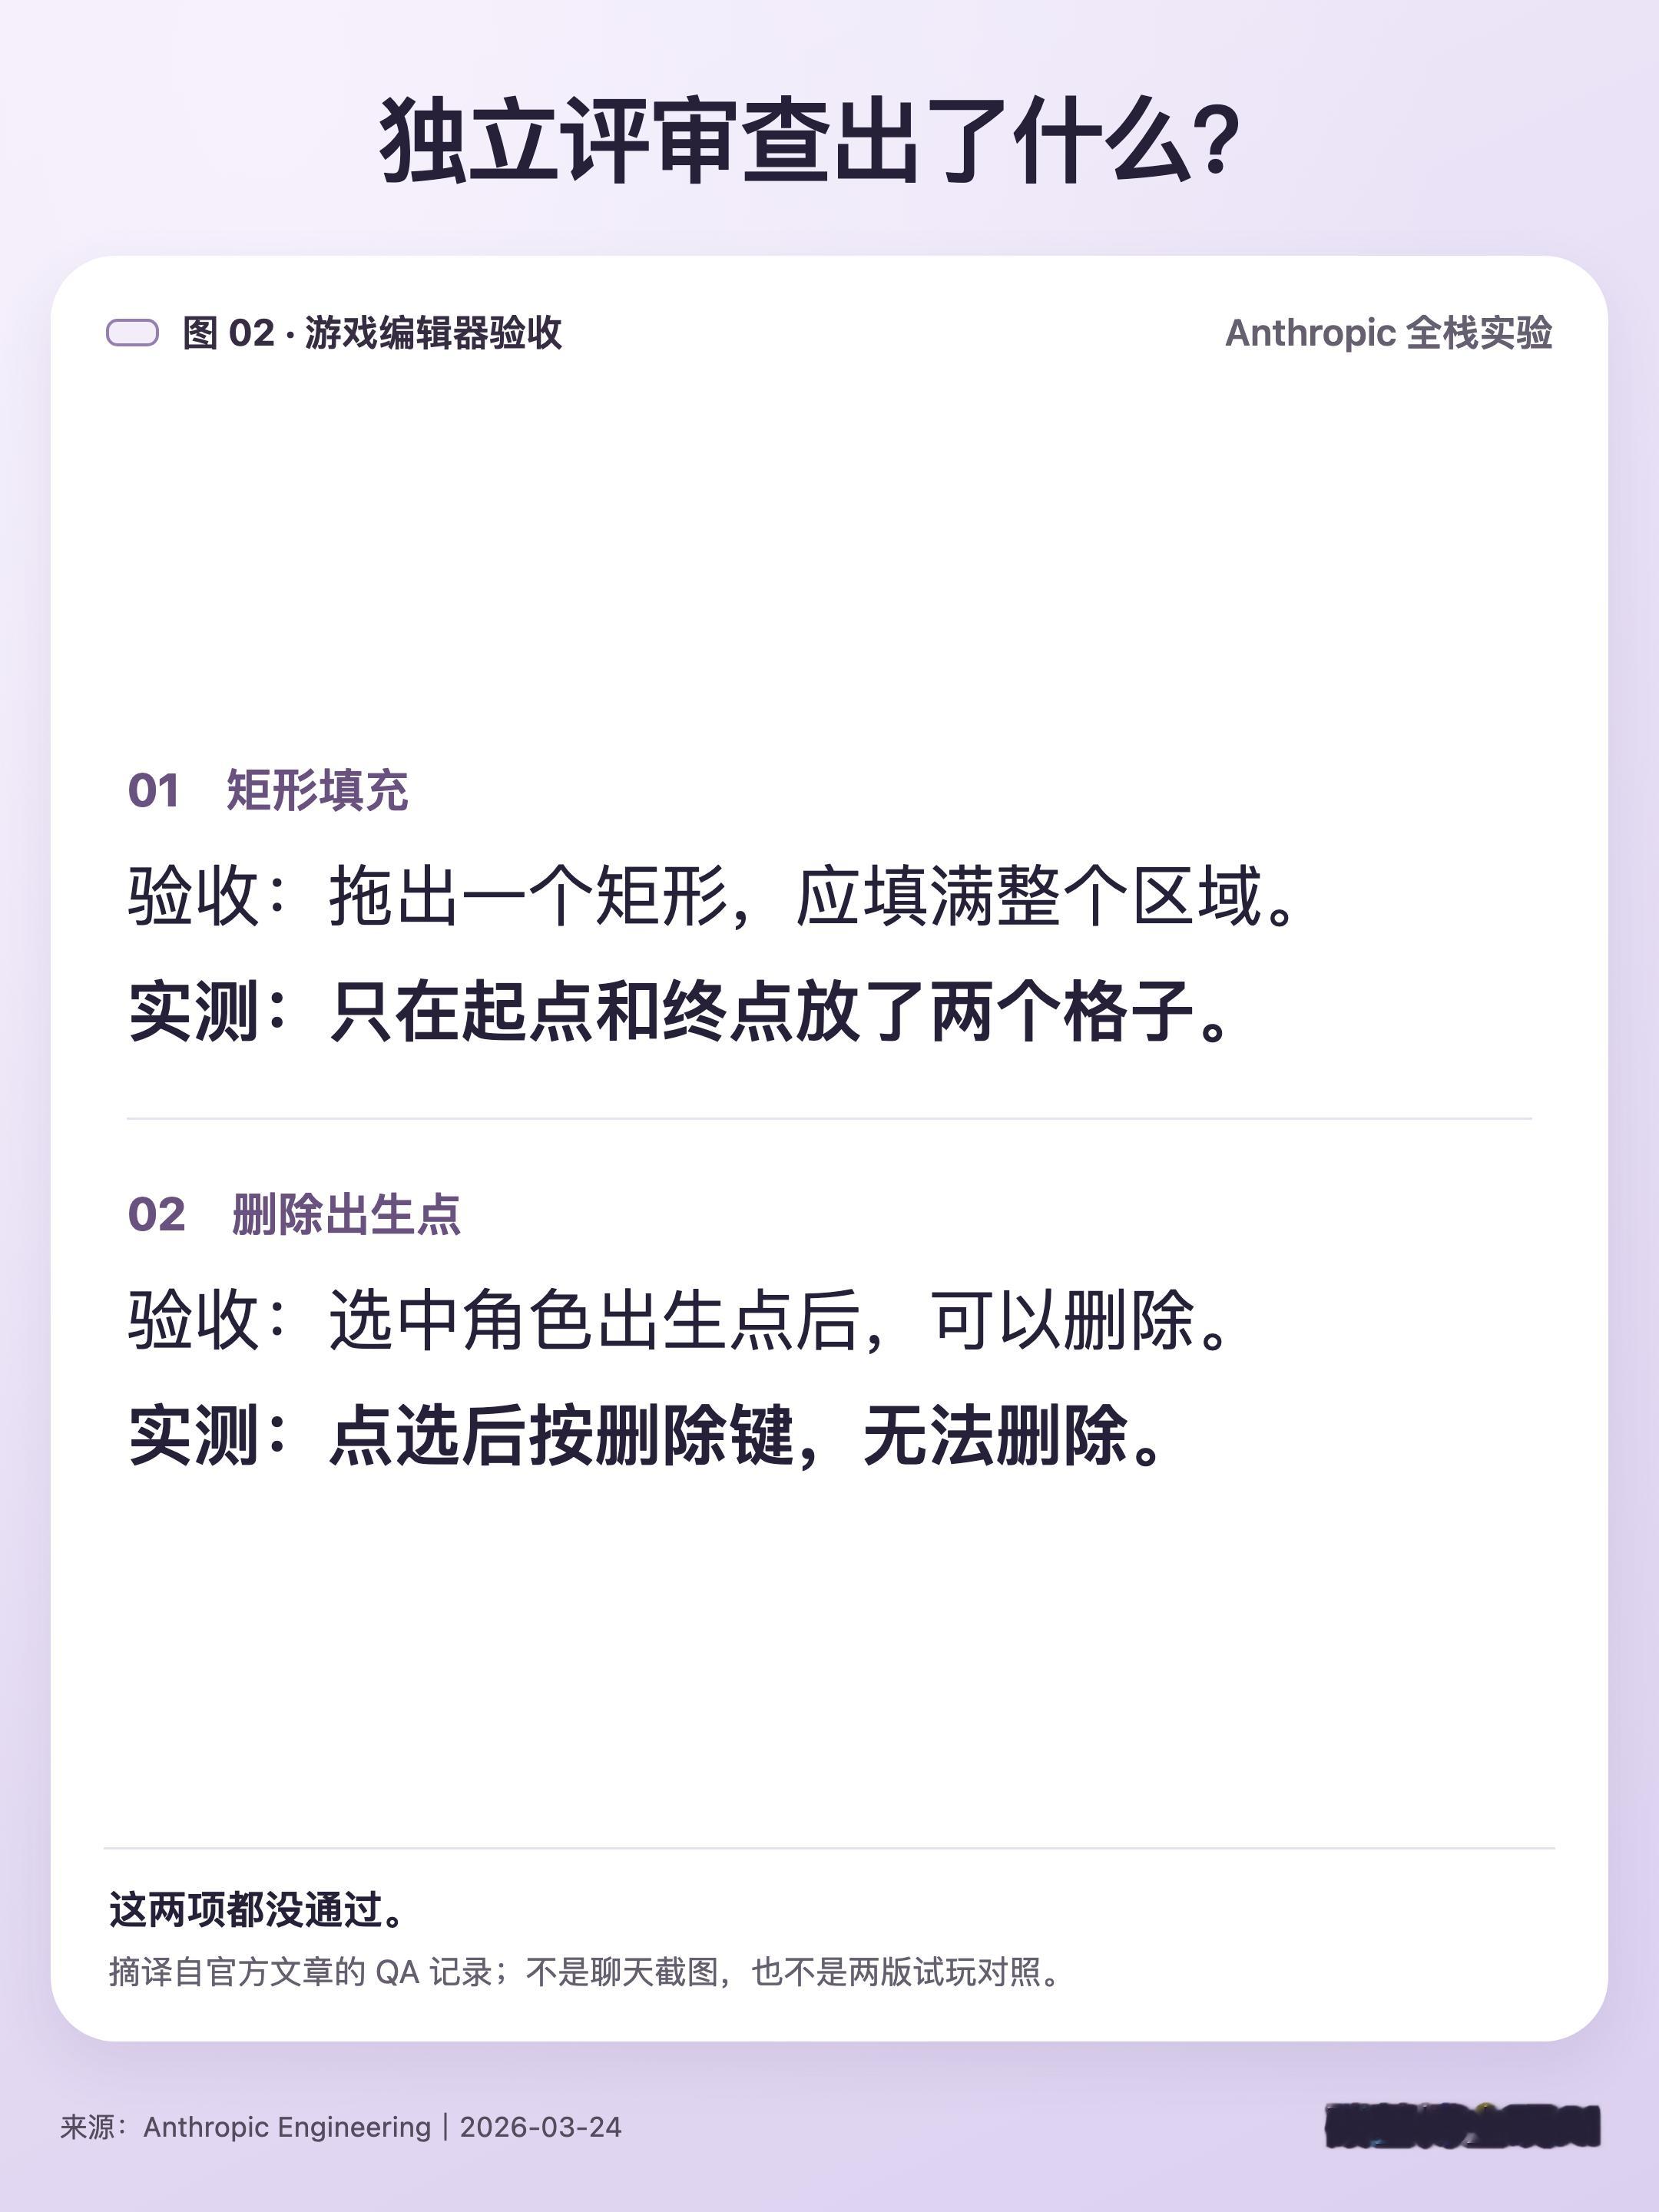
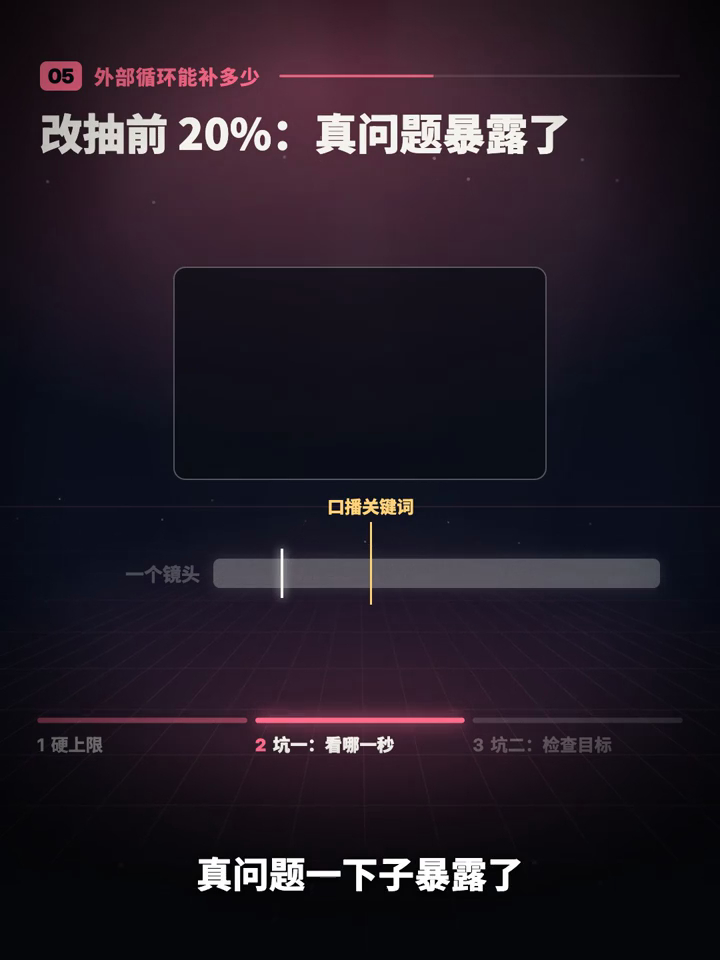
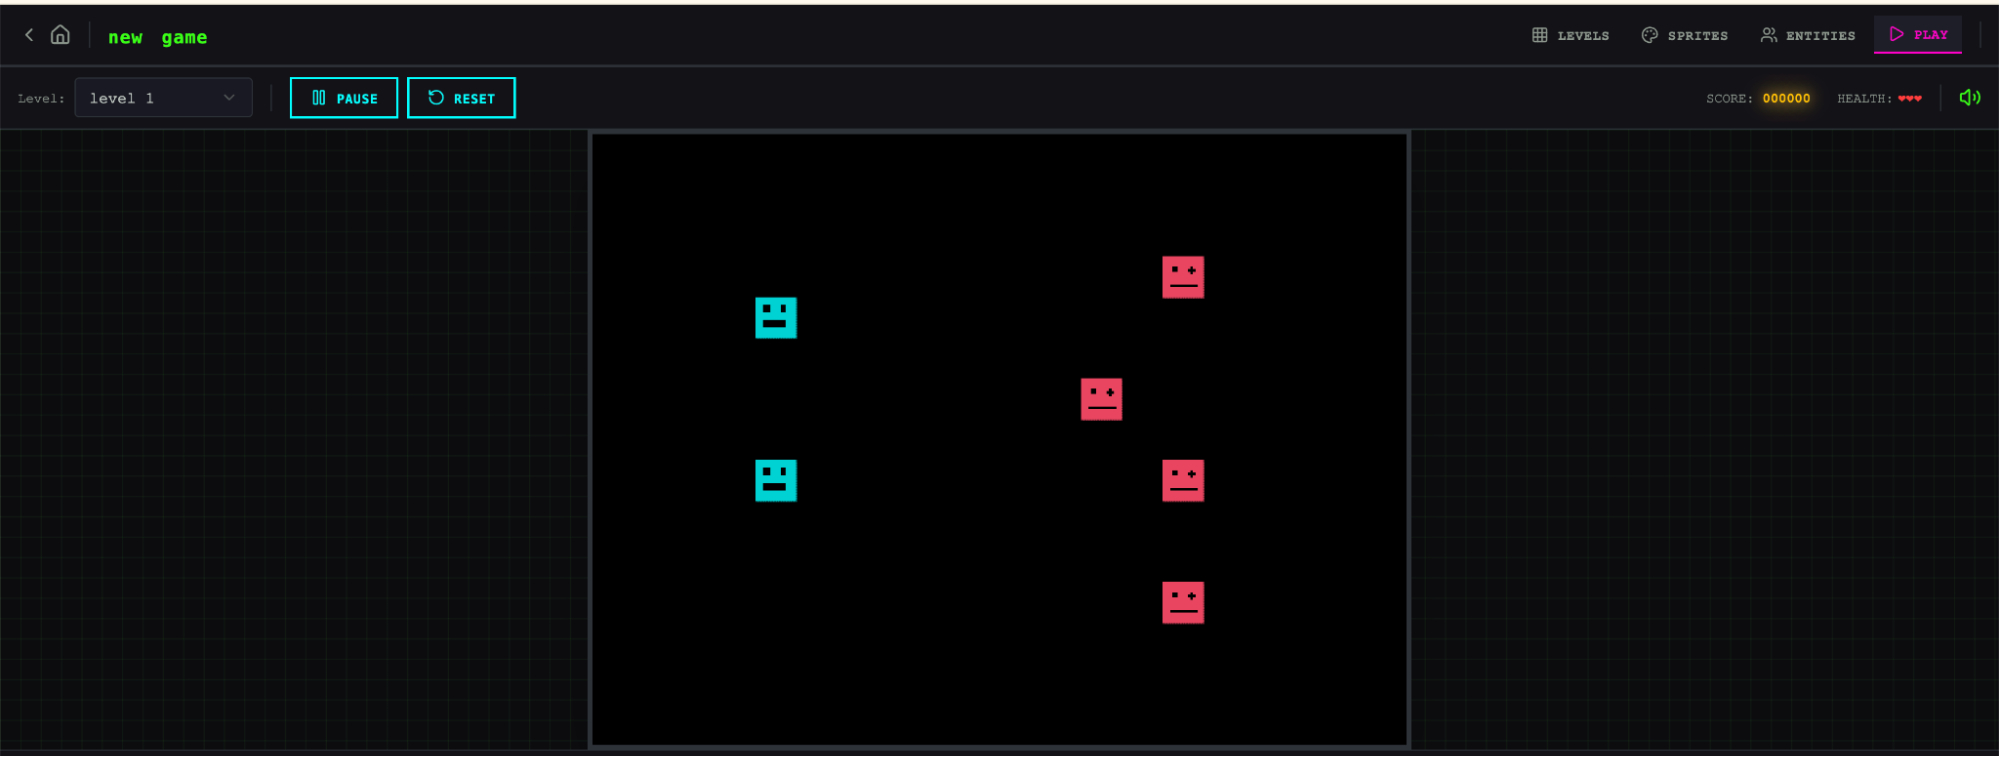
于是他们把两份活拆开。一个 Agent 写网页,另一个拿着单独的评分标准,进浏览器点一遍、滚一遍用,再把问题交回去。单Agent生成的游戏【图1】,看着还行,点击却不能操作;后来换了多agent,把干活和评审的分开,结果就好了【图2】。
② 会评审,不一定会修改。
改当然能改,随便加一笔也是改,但能保证变好吗?我让 GPT 改过几轮图,它最后自己跟我说:还是第一版好。
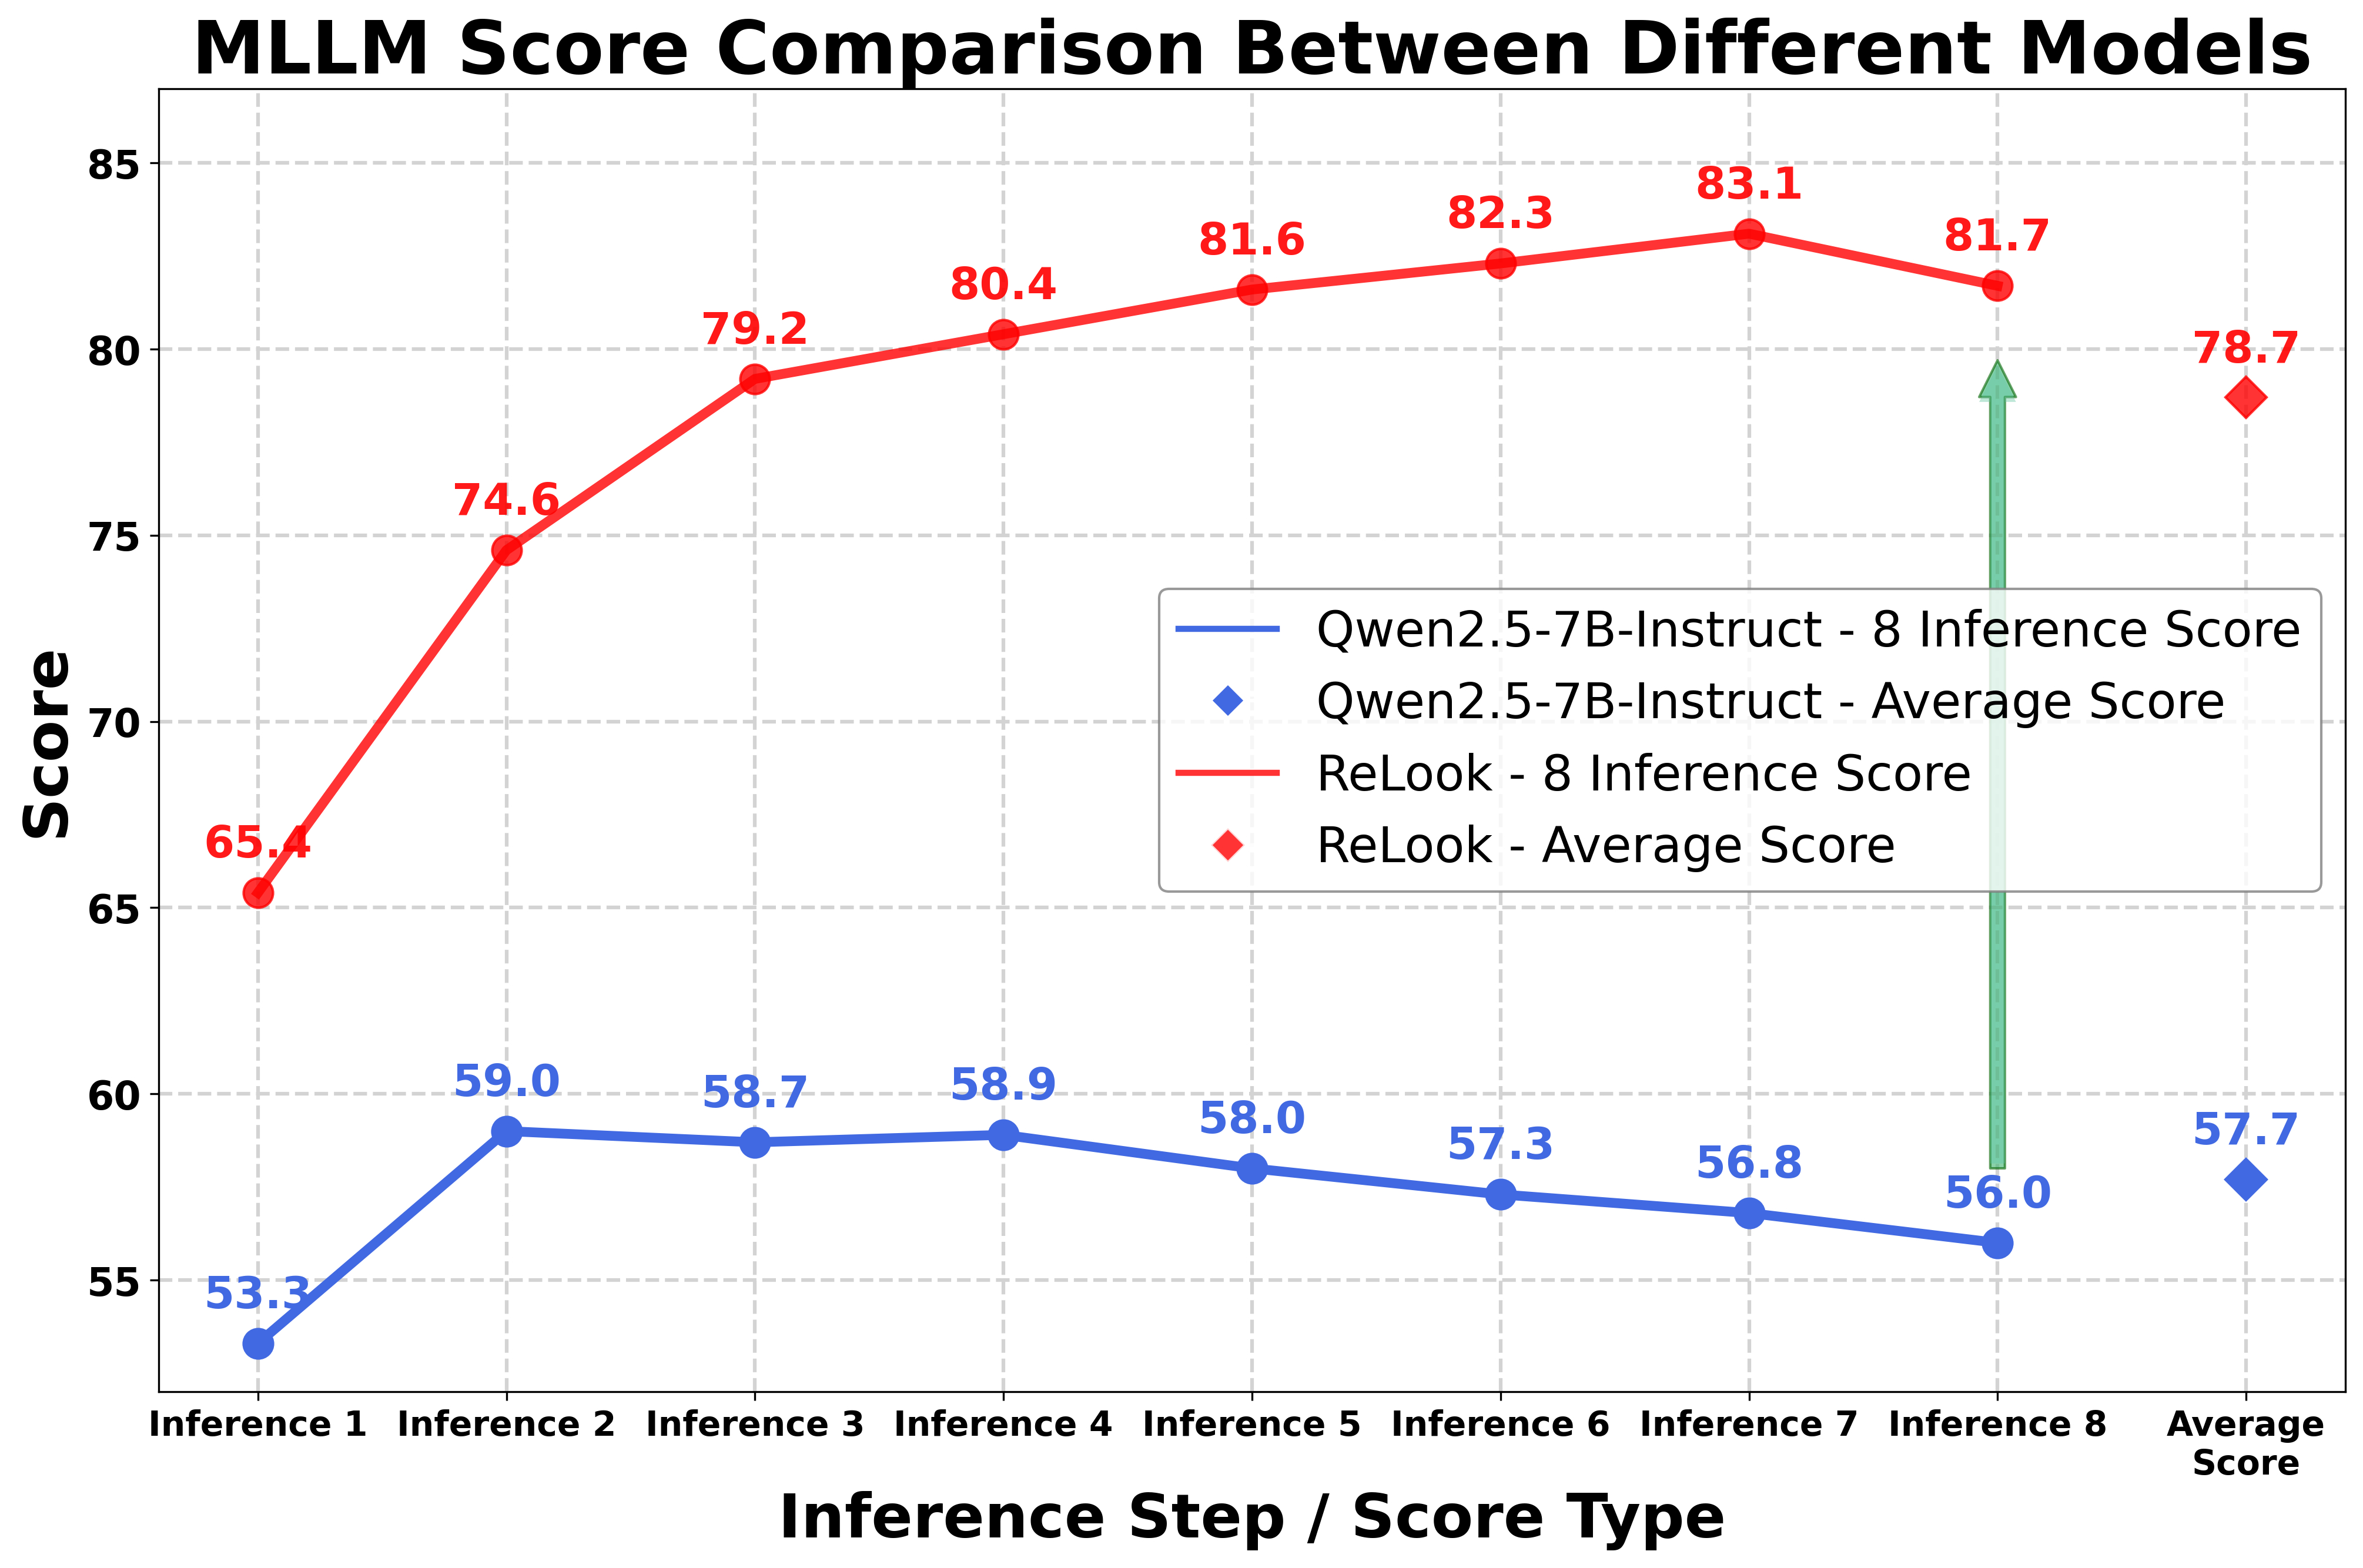
腾讯的 ReLook 实验把这事画成了曲线。基础模型拿到了视觉评审的反馈,还是可能改着改着往下掉【图3】。
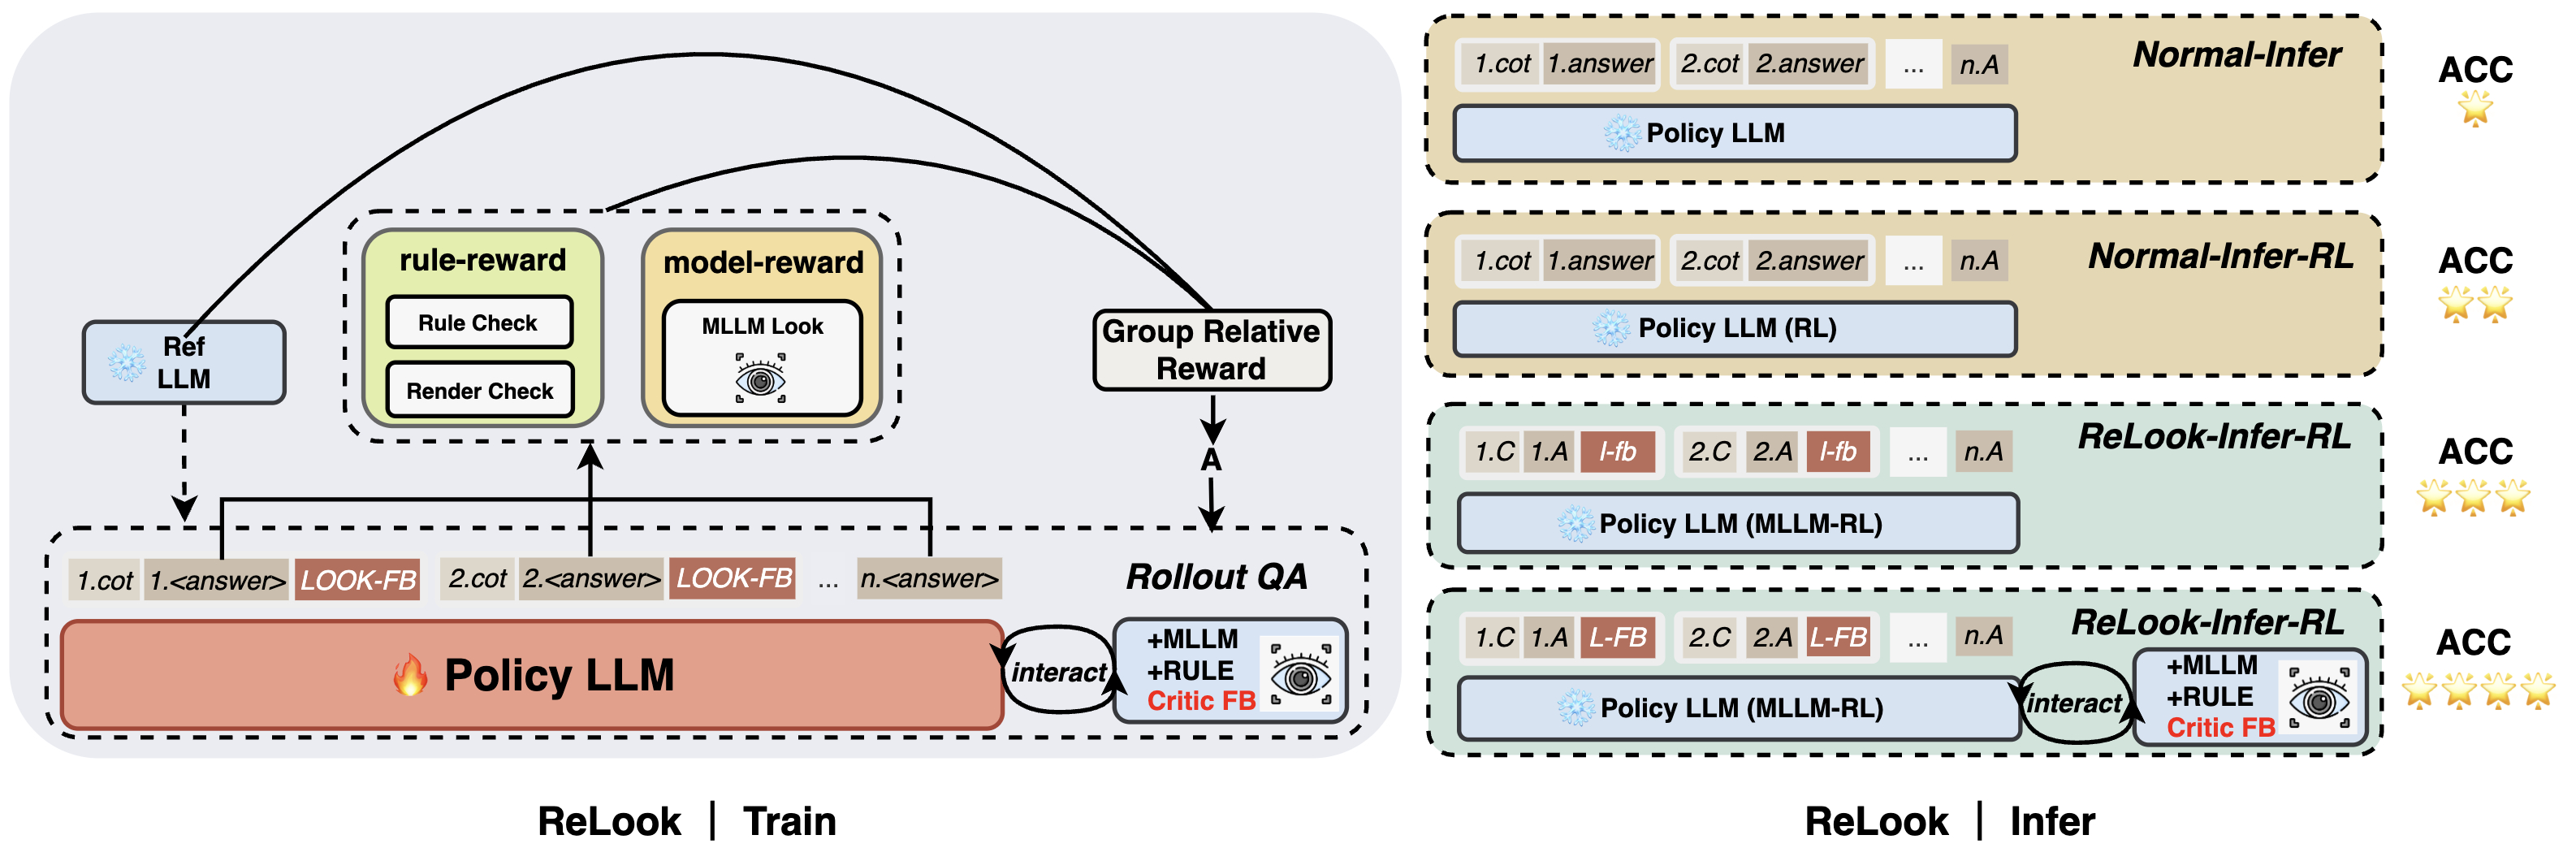
于是他们加了一道门槛:新版本得超过这次的历史最好成绩才收下;没超过就重试,试到上限也没进步,就保留最好的一版。
这肯定会变好,但速度呢?论文里同一组测试,保留外部视觉评审平均要 123 秒,拿掉之后是 18 秒【图4】。
③ 再看 Fable 5.2 怎么做。
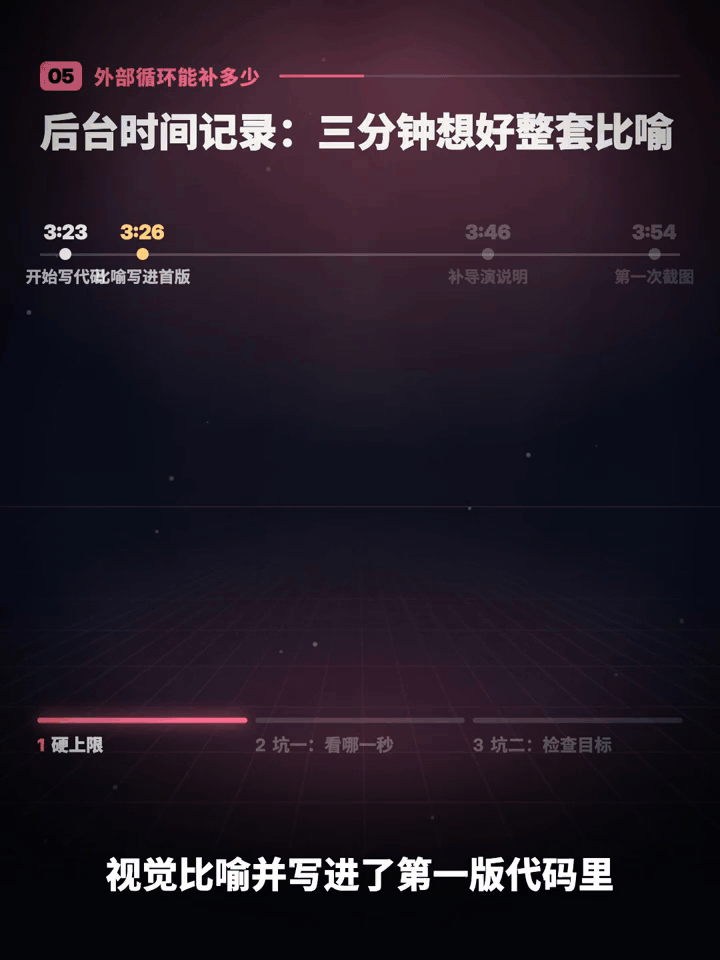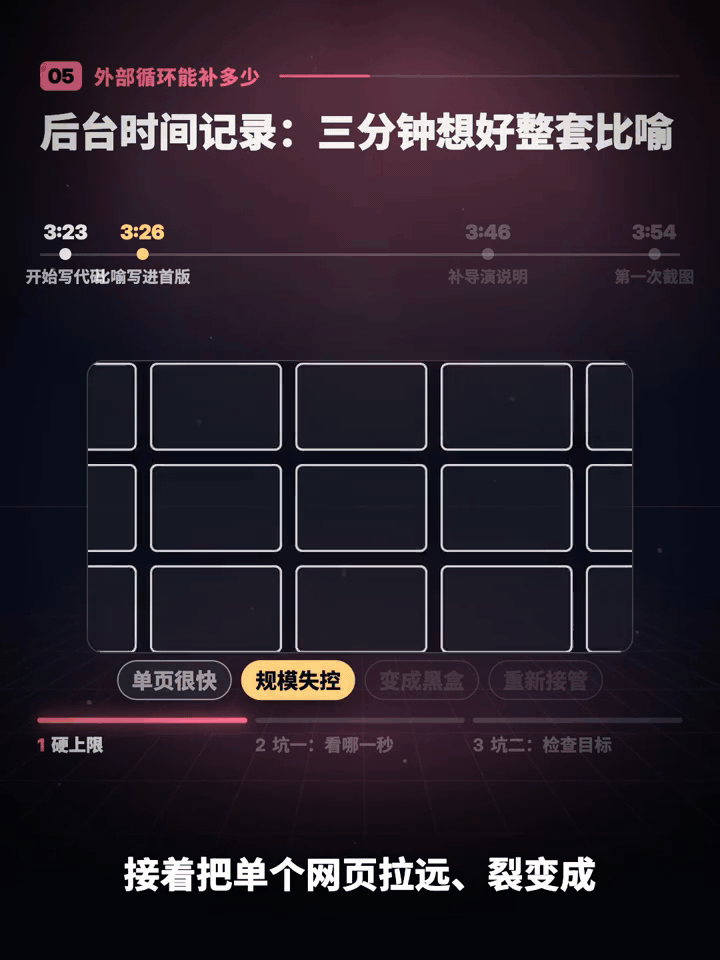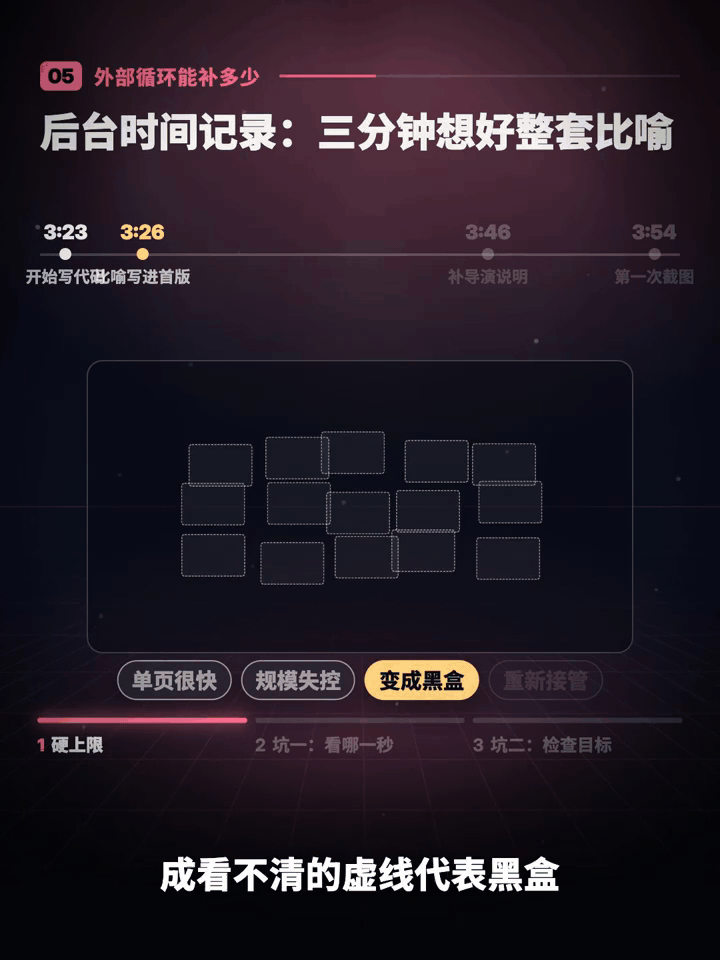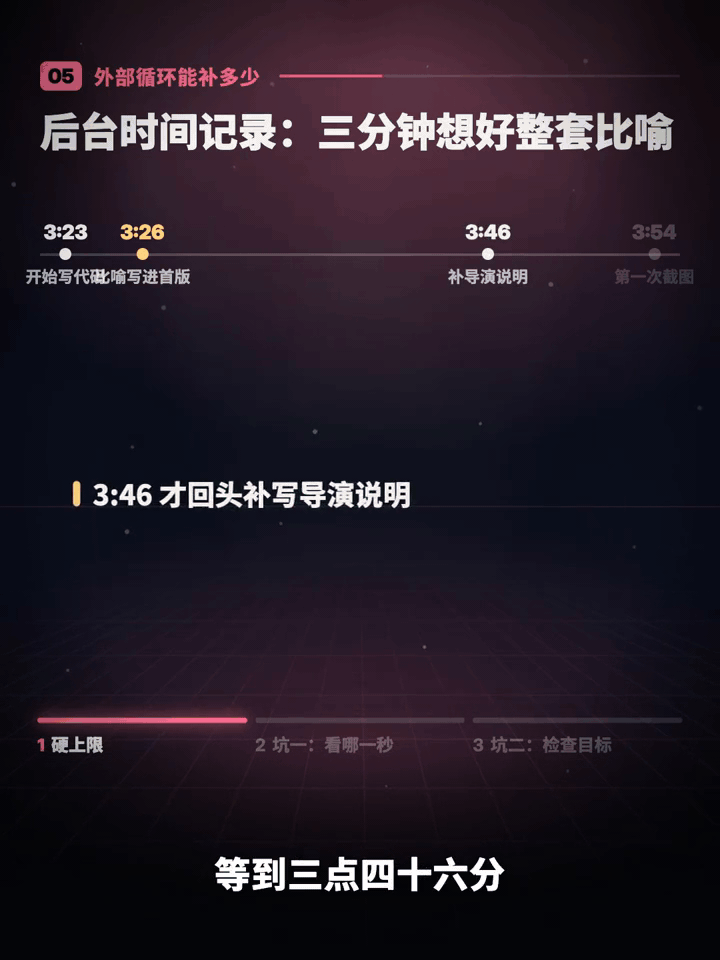
「划水的青蛙」做组件库视频时,Fable 第一版就想到了:让整整齐齐的网页开始错位,来表现「项目一大就失控」【图5】。后来有个敲命令的镜头,检查脚本只截中段,看起来什么都齐【图6】。改看开头才发现,观众还没认出终端,命令就快敲完了【图7】。
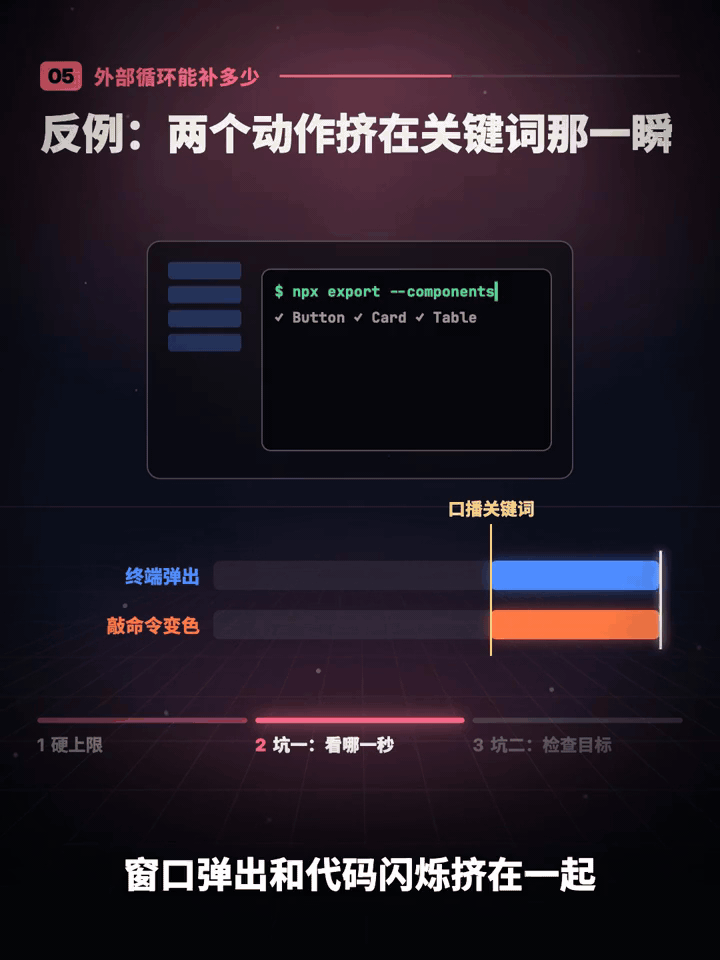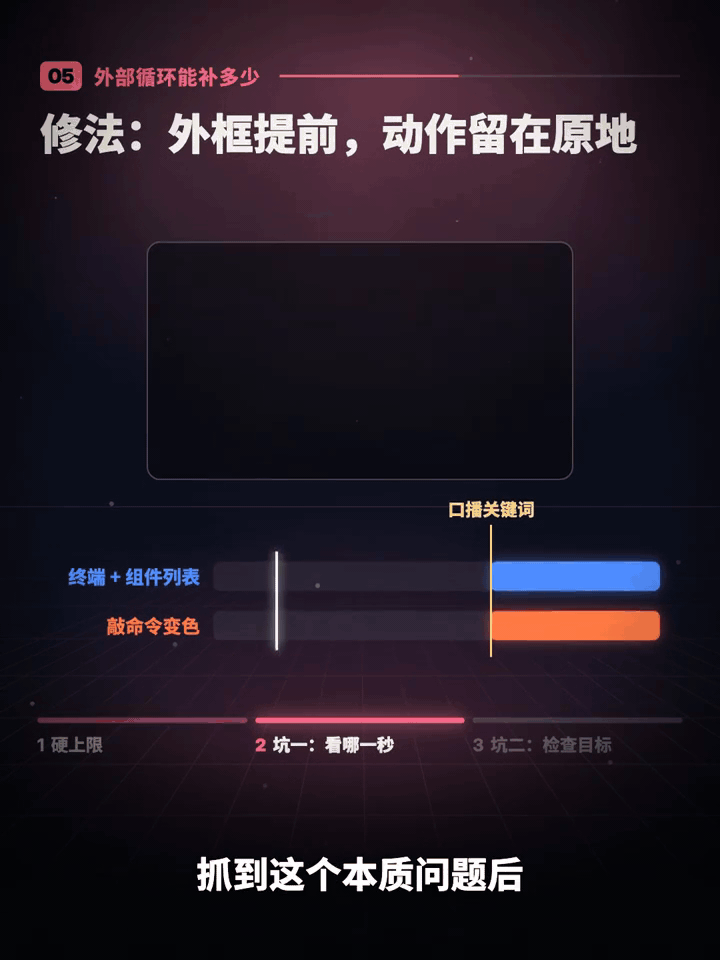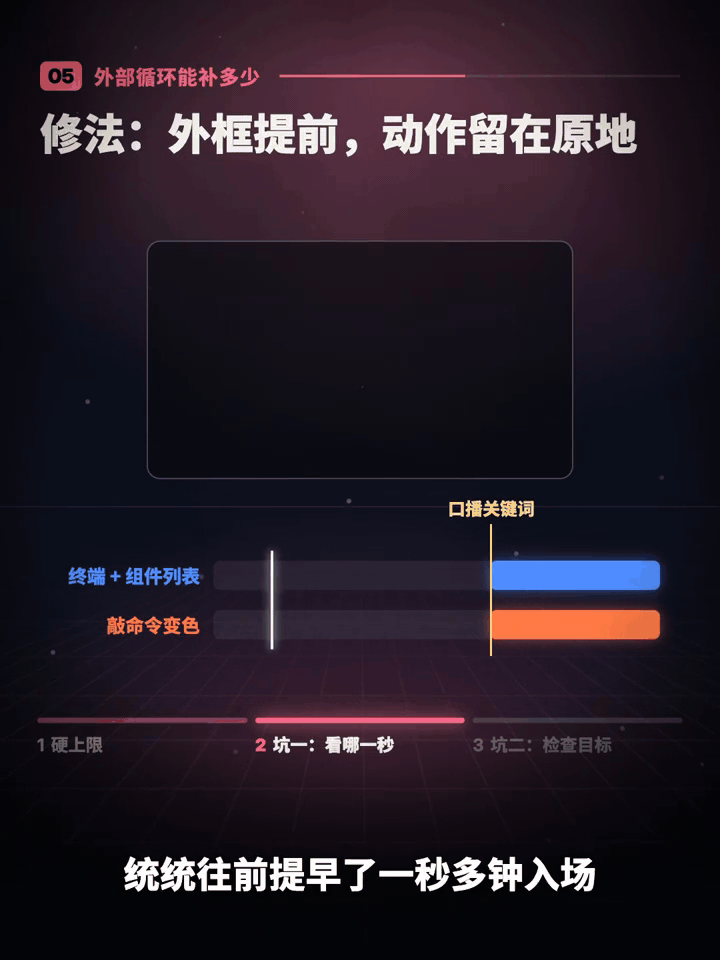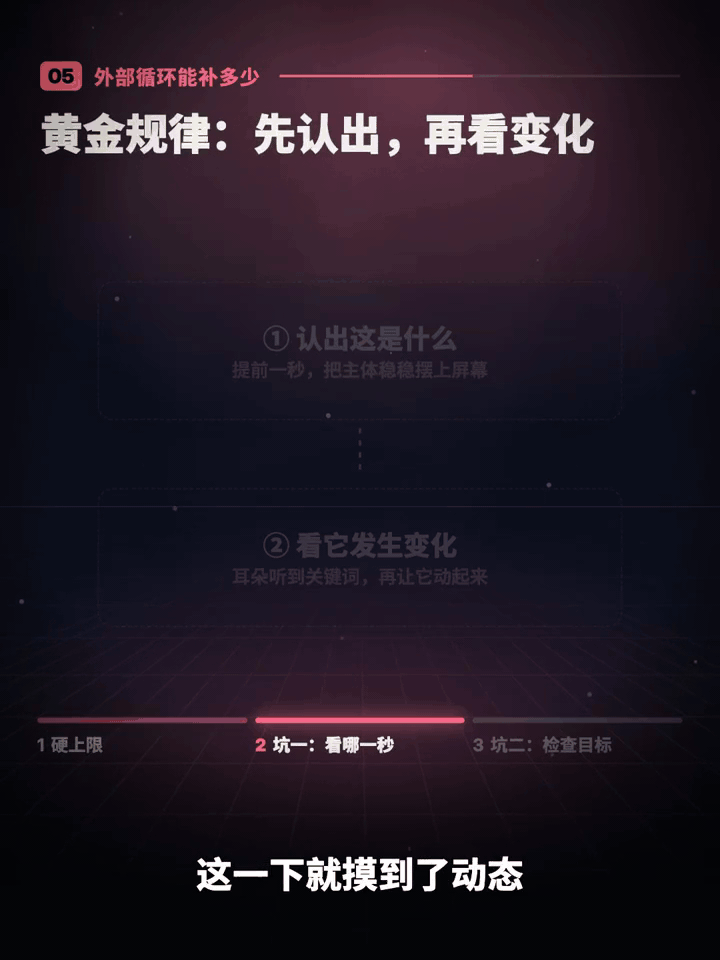
Fable 怎么改,思路非常清晰:终端窗口提前一秒多,敲命令和高亮留在原来那一拍,口播也不用动。它没把整个镜头推翻,只动了该动的地方【图8】。
同样一道动效题:▸ Opus 5.5 跑了 23 轮、12.6 分钟▸ Fable 5.2 跑了 11 轮、7.8 分钟
为什么Fable更复杂却更快?关键就在于Fable把会生成、会评审、会修改都内化到了模型里。思路很清晰,11轮就搞定了。Opus5.5也能改,但更像是无头苍蝇抽卡,所以23轮才达到效果。地球最强模型fable5.2发布DeepSeek碳基博士玩AI