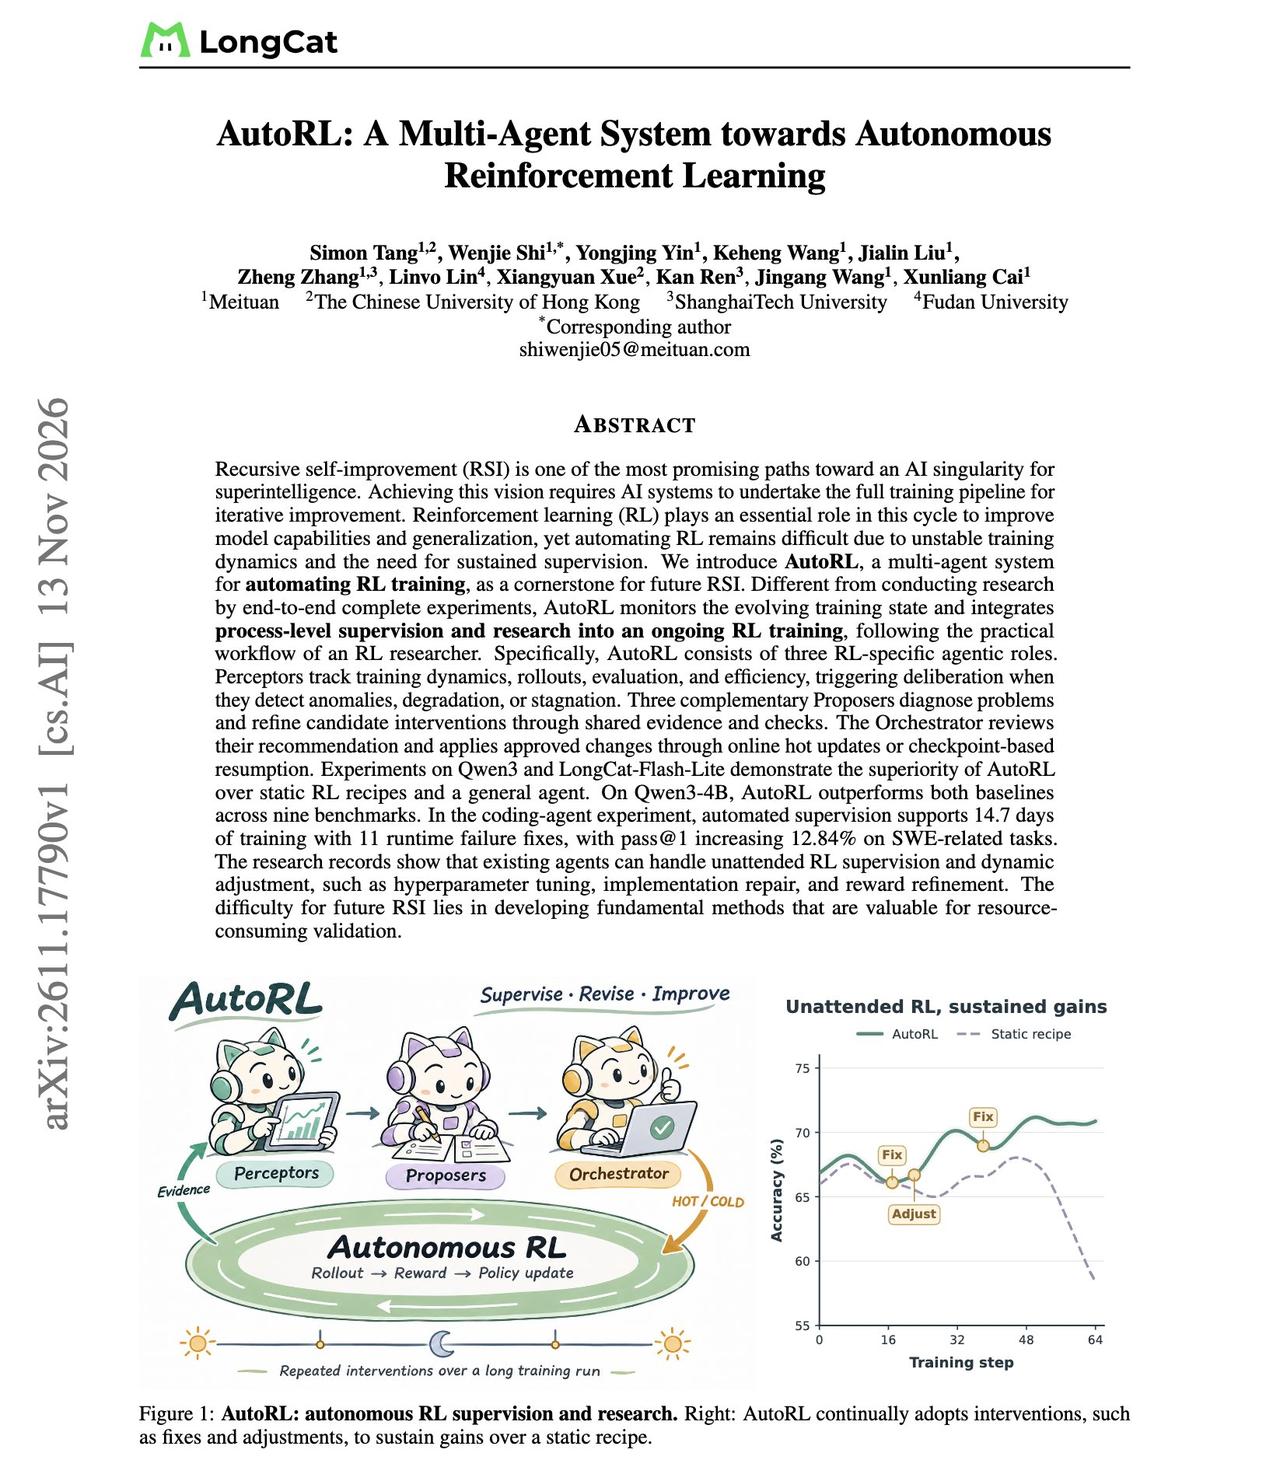
美团联合港中文、上科大、复旦的团队提出AutoRL多智能体系统,让智能体实时监督强化学习训练过程,而非固定配方。它将Qwen3在AIME 2024上的准确率从46.67%提升至66.67%,AIME 2025与HMMT 2025各提升11.67个百分点;在LongCat-Flash-Lite的智能体编程任务中,pass@1从52.29%升至65.13%。
系统核心是过程级介入:四类感知智能体持续监测训练曲线、生成轨迹、评估结果与运行效率,一旦发现异常、退化或停滞就触发研究;三类提议智能体(调参者、创新者、审查者)独立诊断并交叉验证,仅做CPU侧检查后提出干预;编排智能体决定是否批准,并通过热更新在线修改配方,或从检查点冷启动恢复。实验中它修复了故意损坏的奖励打分器、调整KL与熵系数,并在14.7天、224卡的无人值守编程训练中成功处理11次运行时故障。与普通通用智能体相比,它部署的干预更少被回滚,保留了更多已积累的训练进度。
这证明现有智能体已能承担日常RL监督与局部配方修正,真正卡在“提出并验证根本性新方法”这一步——验证成本仍高,且实验中所有成功干预都只是在原有配方上打补丁。从固定脚本到实时自治监督,距离完整递归自改进只差半步,但半步恰恰是最难跨的。