DC娱乐网

标签: npu

今年X500系列的「小屏版」又回归「Pro」了,应该是为了和配置更接近的「P

今年X500系列的「小屏版」又回归「Pro」了,应该是为了和配置更接近的「P

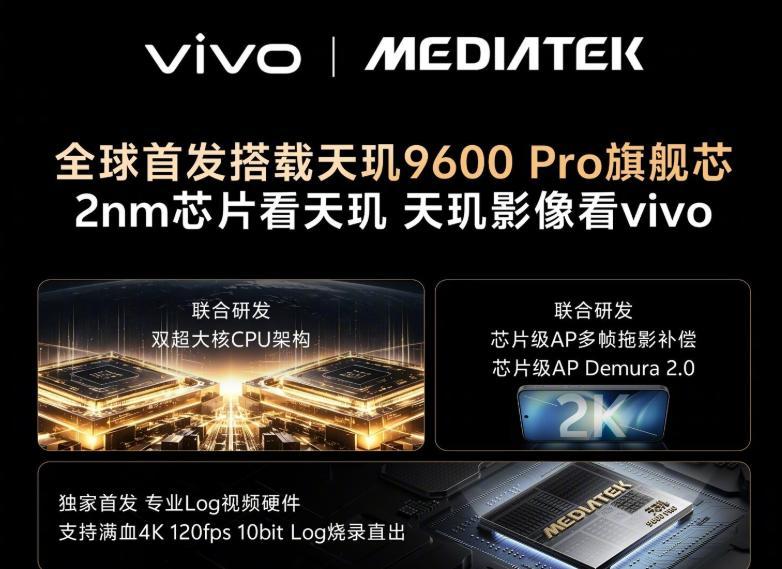
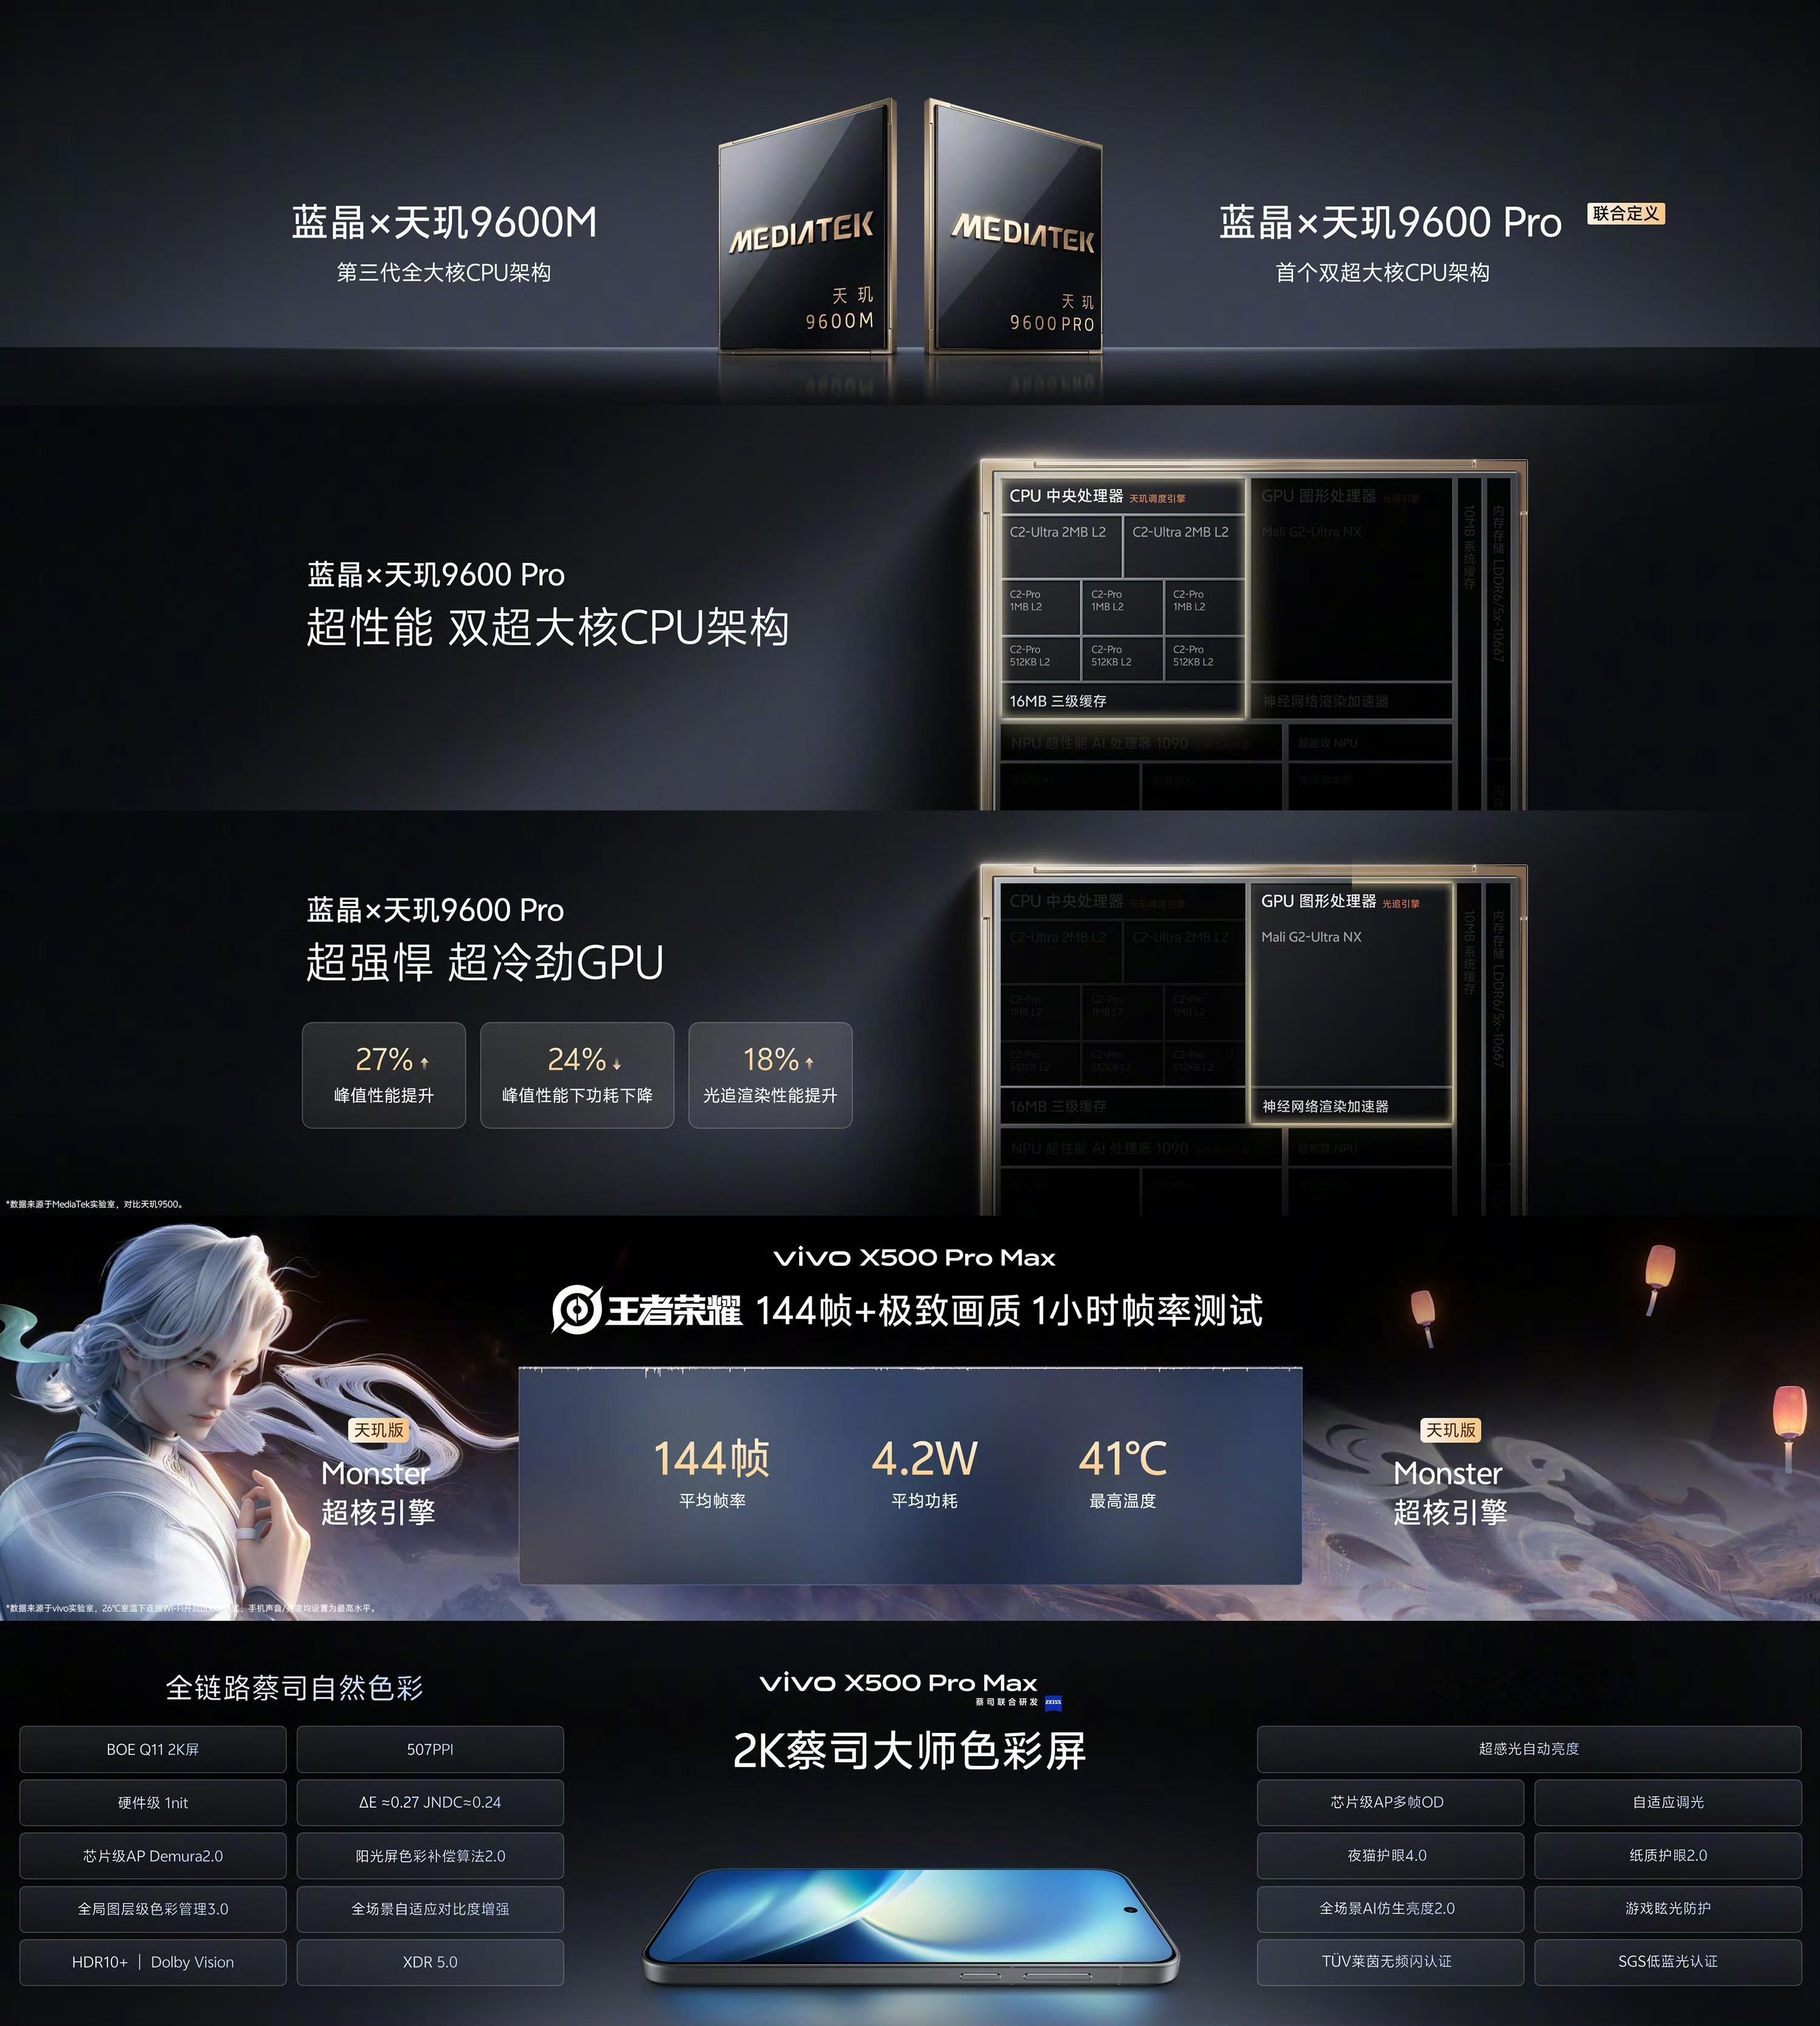
今年X500系列的「小屏版」又回归「Pro」了,应该是为了和配置更接近的「ProMax」组队。Pro系列外观及屏幕:外观|vivoX500Pro带来6.36黄金英寸,握持刚好;vivoX500ProMax带来6.85英寸沉浸大屏,观感更佳;摄夜机身薄至7.95mm,背面采用饼干头、滚花纹理与拼接设计,延续专业质感。四款配色,四个GoldenMoment:晴天、览霞、摄夜、大地回声,一日之时,尽在掌心。屏幕|与京东方联合,X500Pro系列均采用BOEQ11发光材料、包括硬件级1nit、8TLTPO、144Hz自适应刷新率;一整套完备的护眼技术;X500ProMax首发2K蔡司大师色彩屏,更高清的同时功耗显著降低,还定制了亮度调节策略,带来更贴合的亮度体验。Pro系列芯片:vivo与联发科技长期深度共研,今年带来蓝晶×天玑9600Pro系列,搭载2nm旗舰芯,以及GPU、NPU,性能和能效双双超强。旗舰芯片|X500Pro系列首发天玑「2nm旗舰芯」,采用双超大核CPU架构。搭载天玑超强GPU,性能、能效、图像渲染全面提升。Monster超核引擎天玑版加持下,重载游戏场景实现高画质的同时功耗更低。双NPU架构再升级,原生INT4算力翻倍提升。算力及视频规格|融合搭载V3+与VS1的影像能力,叠加超性能影像NPU2.0,带来60fps追焦和XDZ高倍率视频超分技术,显著提升了长焦视频清晰度;专业Log视频硬件,4K120fpsLog录制时长和能效都有大幅提升。灭霸500
AI算力超节点,一句话:用超高速互联,把几十到几百块GPU/NPU紧耦合,拼成一个逻辑上的“巨型芯片

AI算力超节点,一句话:用超高速互联,把几十到几百块GPU/NPU紧耦合,拼成一个逻辑上的“巨型芯片

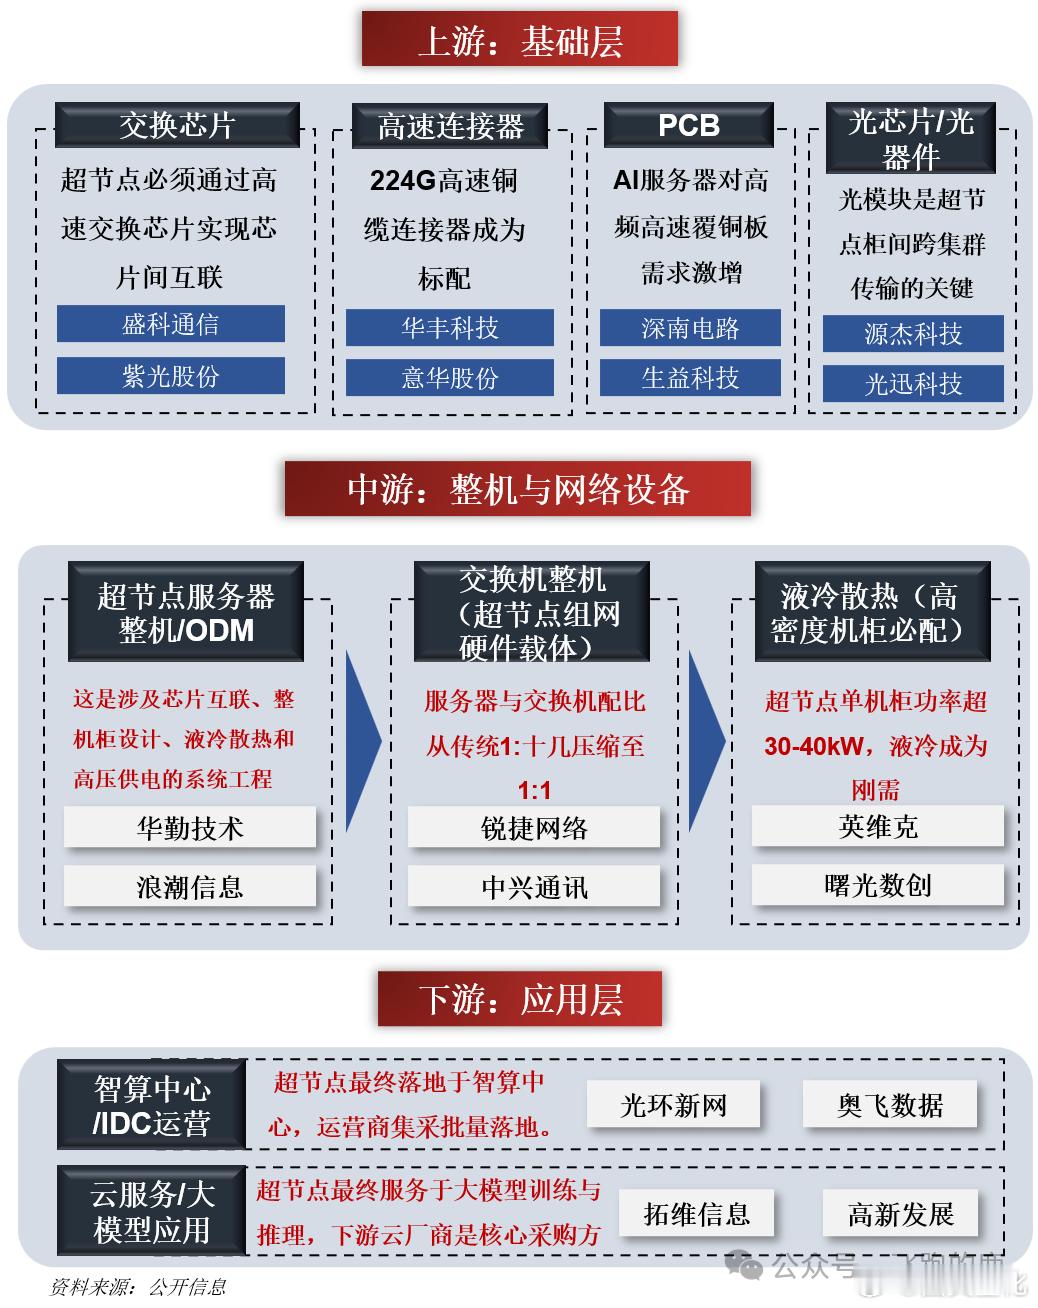
AI算力超节点,一句话:用超高速互联,把几十到几百块GPU/NPU紧耦合,拼成一个逻辑上的“巨型芯片”,打破单机算力瓶颈。大模型训练要成百上千块GPU协同,每步都频繁通信。跨服务器走以太网/IB,带宽低、延迟高,GPU只能等。超节点用NVLink/NVSwitch,把它们拉进同一个高速互联域,直接读写显存,带​AI算力超节点,一句话:用超高速互联,把几十到几百块GPU/NPU紧耦合,拼成一个逻辑上的“巨型芯片”,打破单机算力瓶颈。大模型训练要成百上千块GPU协同,每步都频繁通信。跨服务器走以太网/IB,带宽低、延迟高,GPU只能等。超节点用NVLink/NVSwitch,把它们拉进同一个高速互联域,直接读写显存,带宽几百GB/s到TB/s,延迟百纳秒级。不是几台机器联网,而是一块大芯片内部通信。简单类比一下:以前工人分散在不同房间打电话,容易卡顿;现在拉进同一个大车间,肩并肩用内部广播喊话,几乎像同一个人在思考。更深一层:通信瓶颈从网络搬进总线,并行切得更细,计算通信重叠,MFU更高。但堆卡不等于超节点,功耗、散热、拓扑、软件调度才是关键。

天玑9600Pro:2nm不卷性能,手机旗舰正式涨价9月15日,联发科发布天

2nm天玑9600Pro首发?vivo这次玩大了,但别急着上头vivoX5

2nm天玑9600Pro首发?vivo这次玩大了,但别急着上头vivoX5

2nm天玑9600 Pro, 把旗舰SoC竞争推向「融合计算」

2nm天玑9600 Pro, 把旗舰SoC竞争推向「融合计算」

麒麟9050Pro问世,让华为赢得了三样东西!为什么全世界只有华为在走逻辑折叠

麒麟9050Pro问世,让华为赢得了三样东西!为什么全世界只有华为在走逻辑折叠

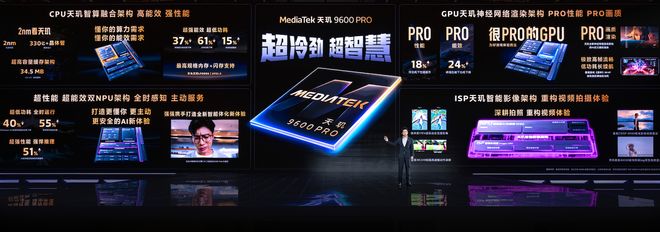
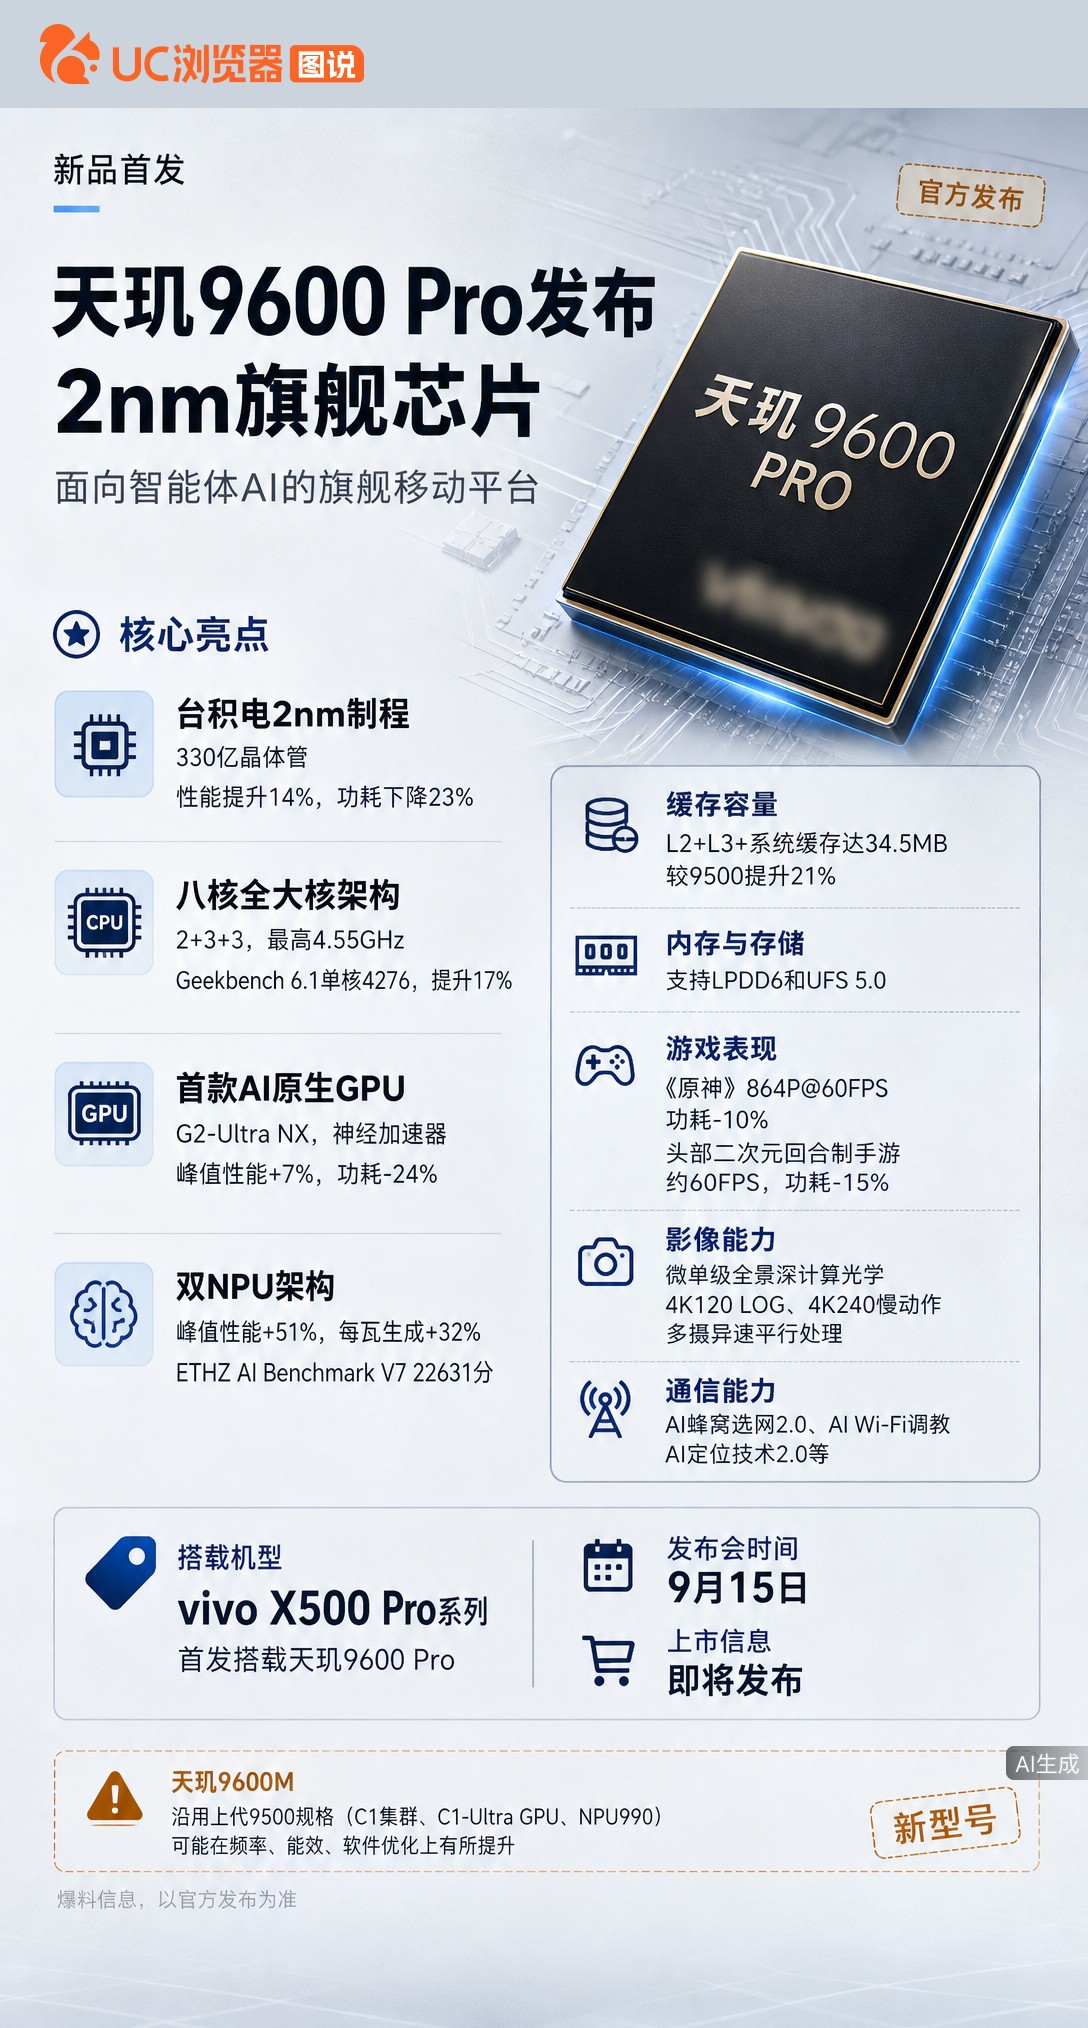
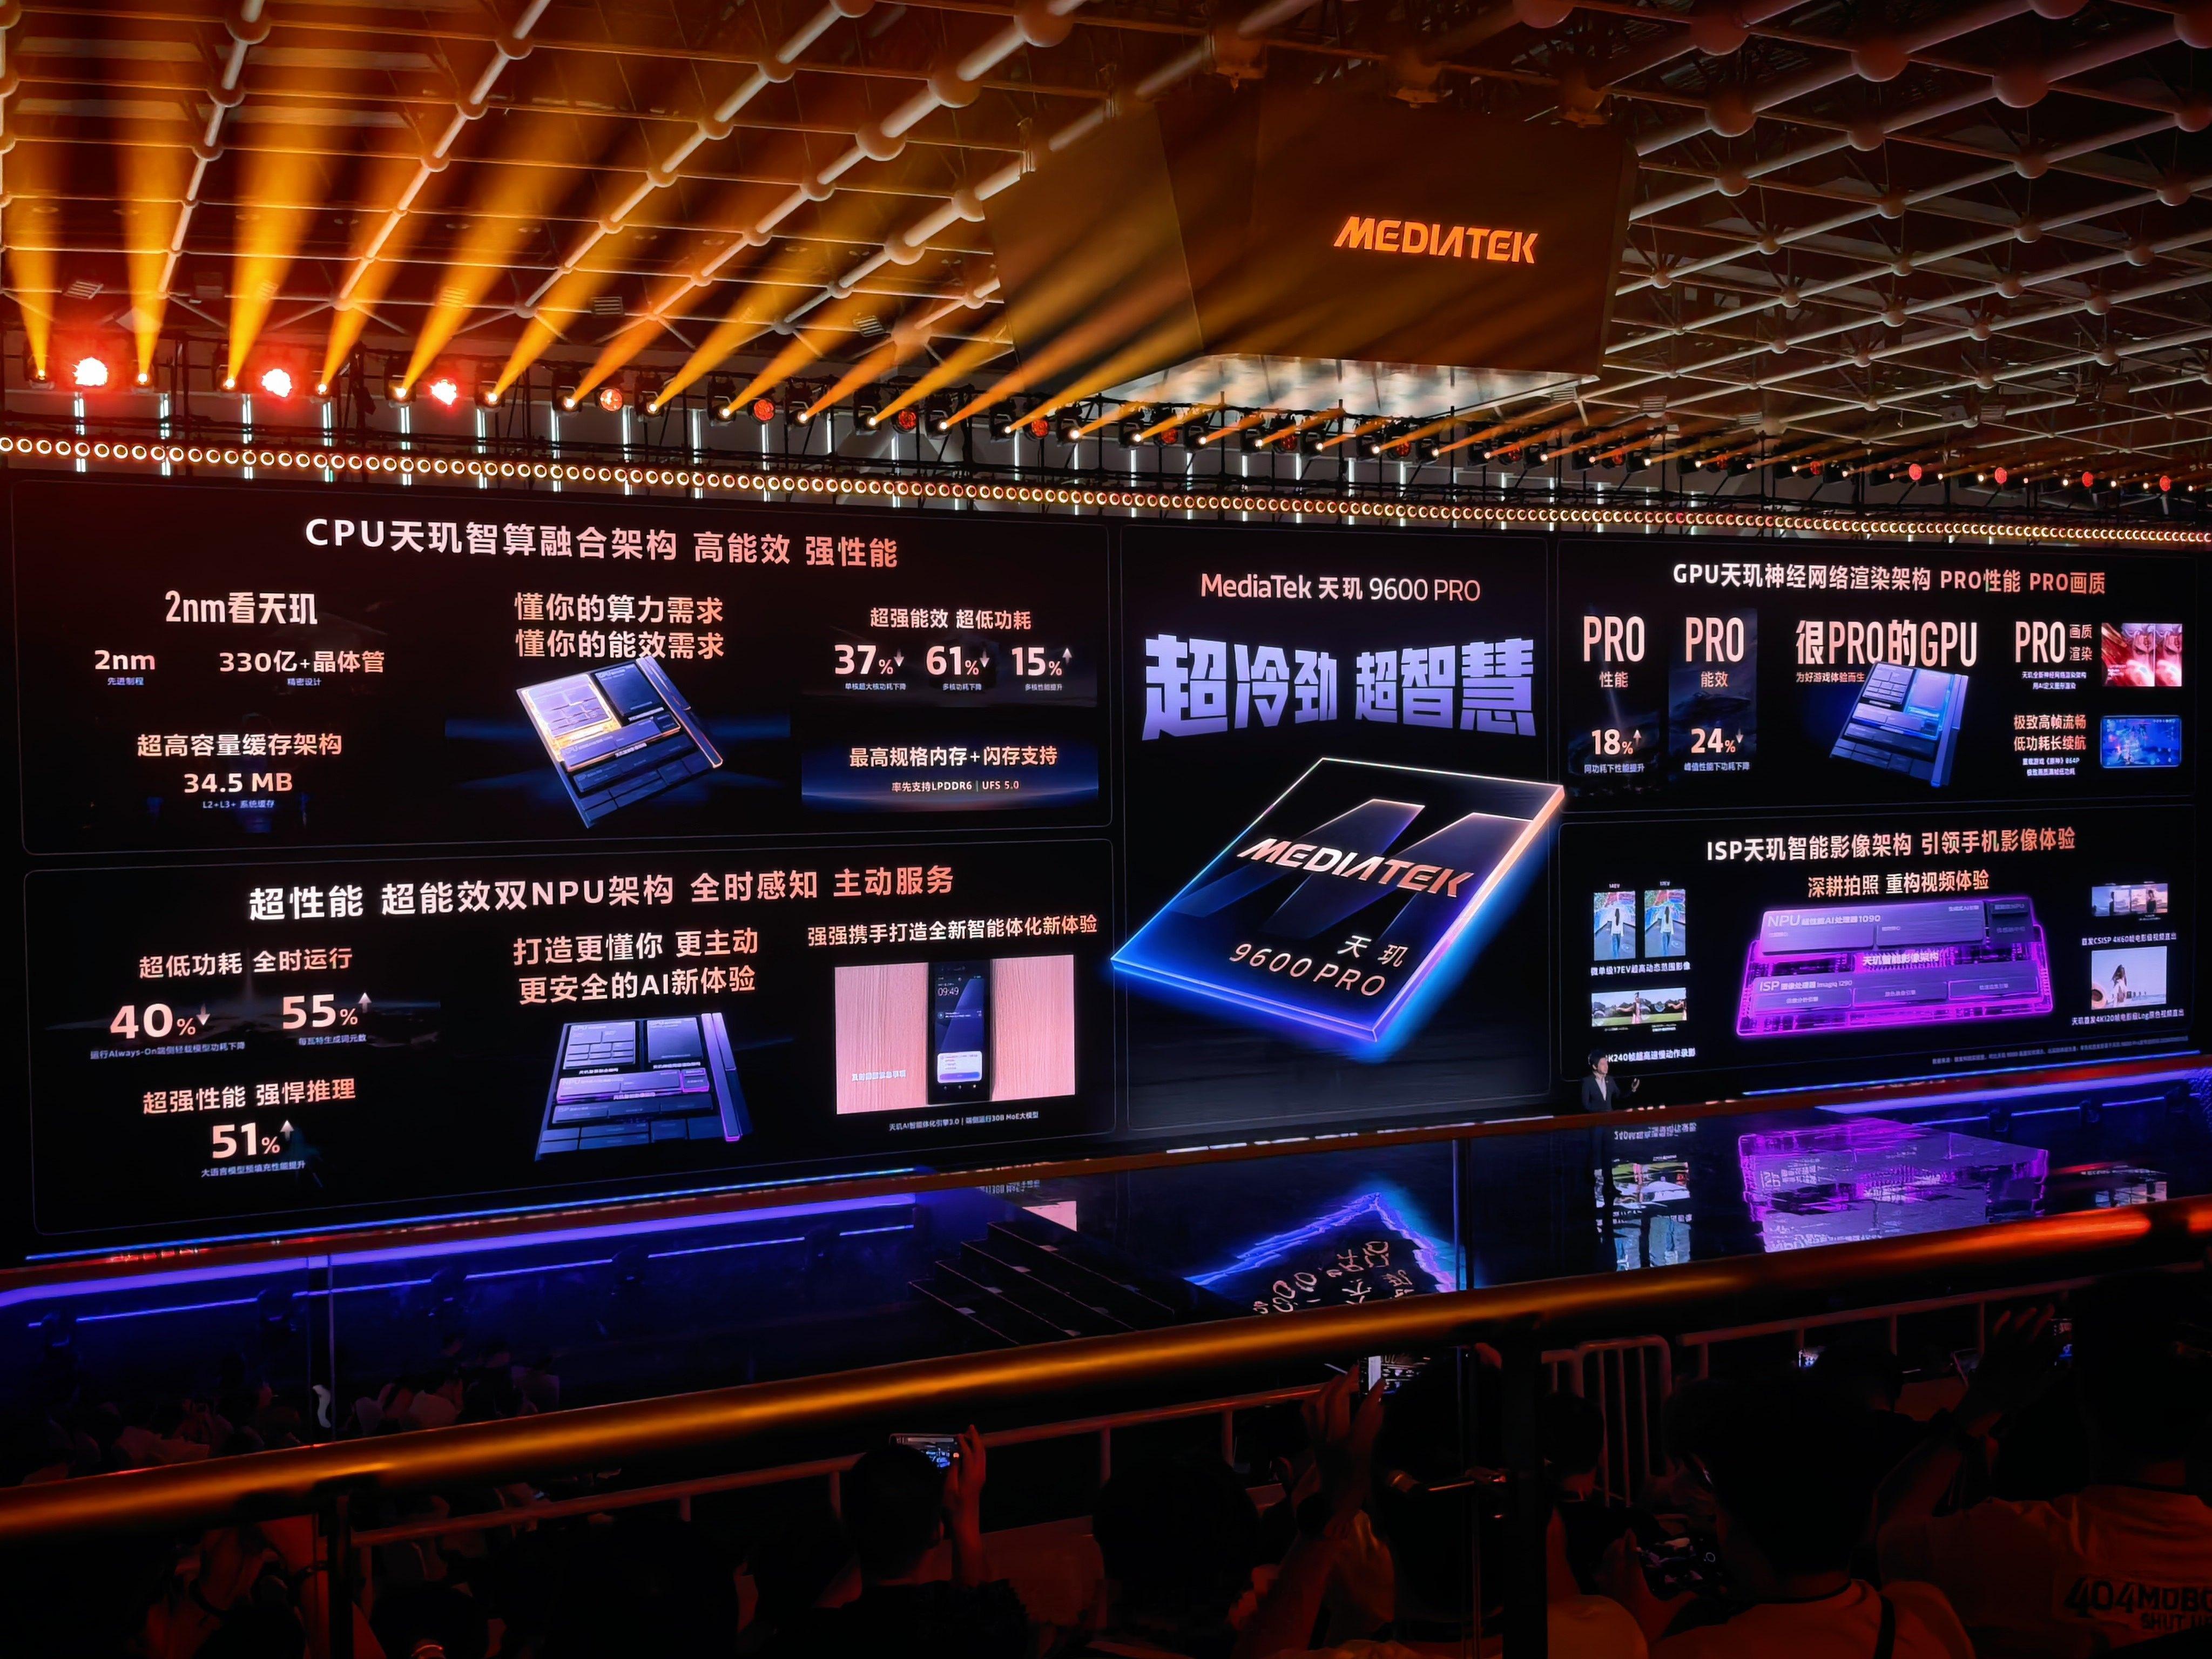
天玑9600Pro2nm工艺330亿+晶体管双超大核CPU架构超能效双核NPU架构,AI能力大幅提升

天玑9600Pro2nm工艺330亿+晶体管双超大核CPU架构超能效双核NPU架构,AI能力大幅提升

联发科天玑9600Pro亮相,台积电2nm加持,CPU多核功耗降61%,NPU跑分全球第一。vivo

联发科天玑9600Pro亮相,台积电2nm加持,CPU多核功耗降61%,NPU跑分全球第一。vivo

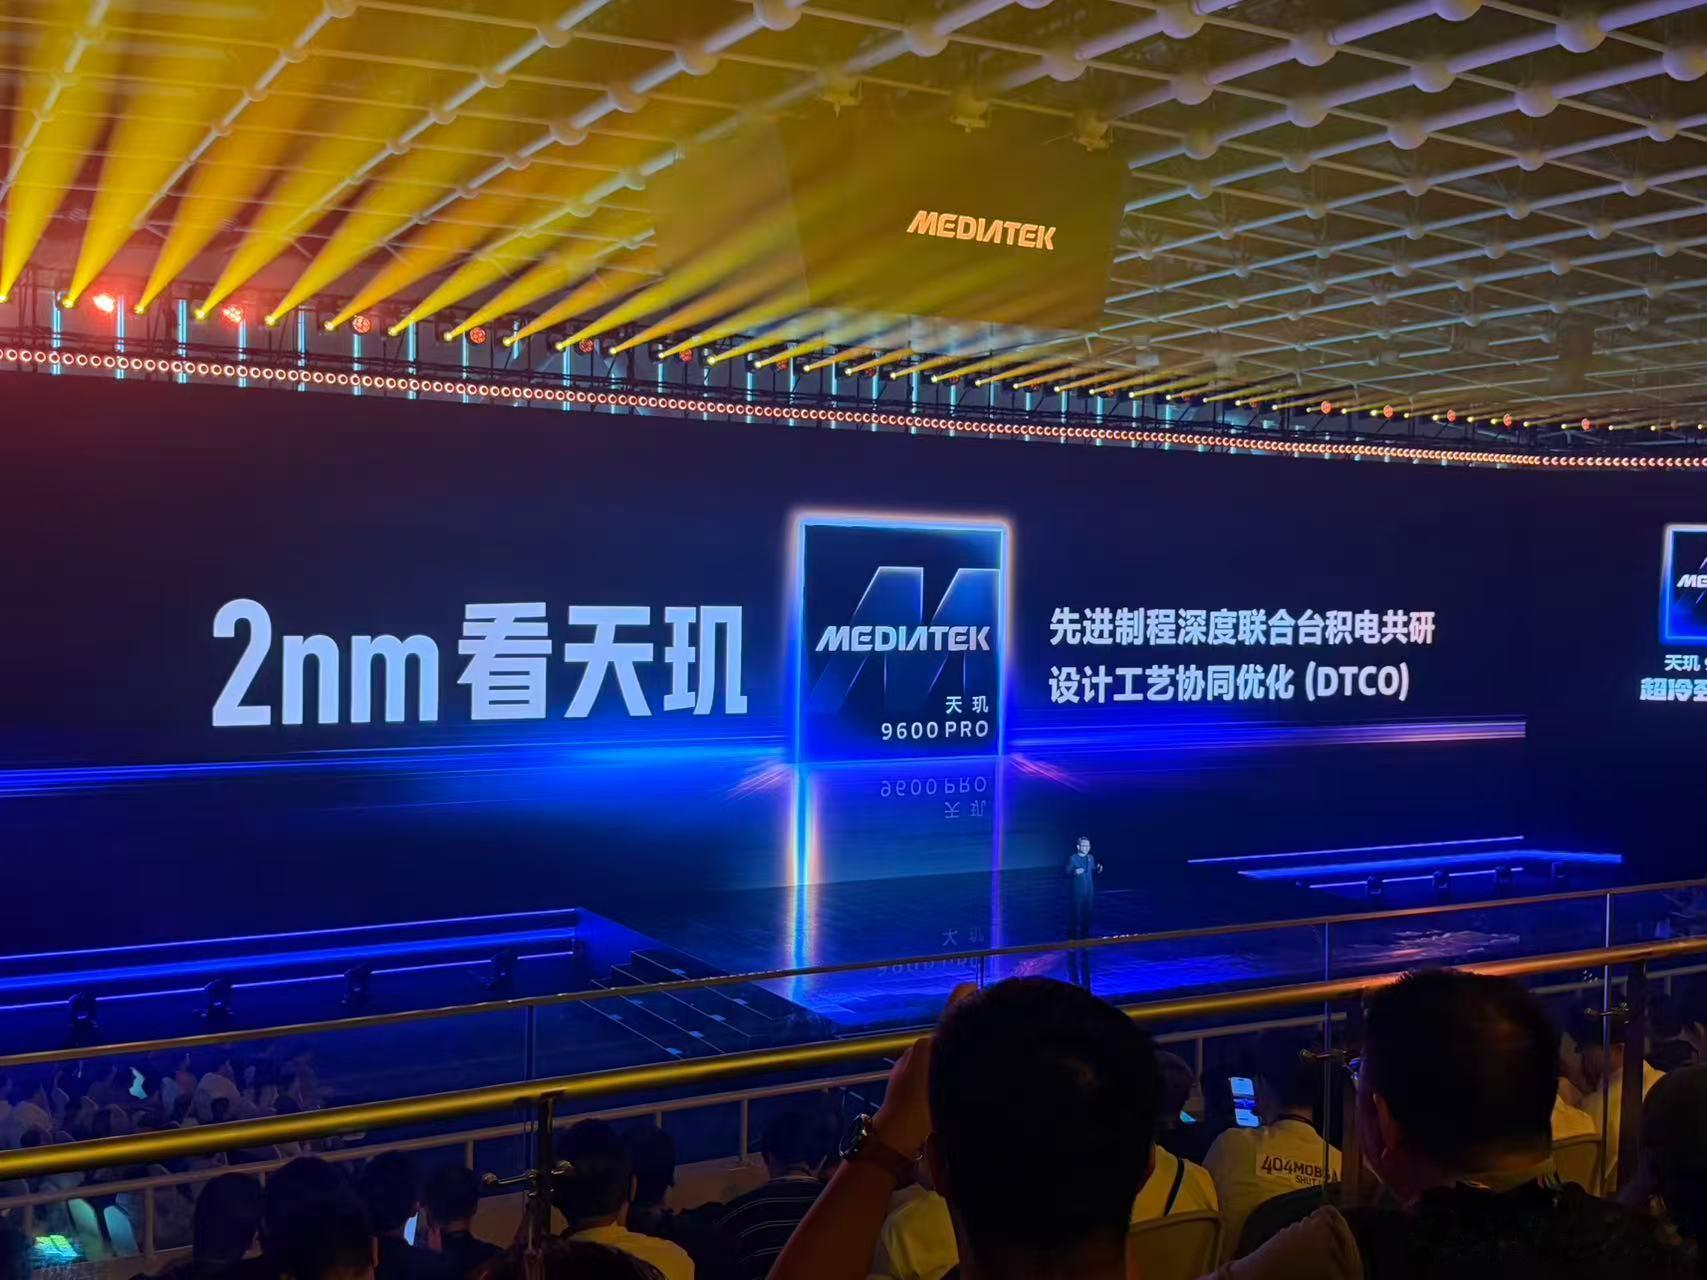
联发科天玑9600Pro正式发布,vivoX500Pro系列首发。-

联发科天玑9600Pro正式发布,vivoX500Pro系列首发。-

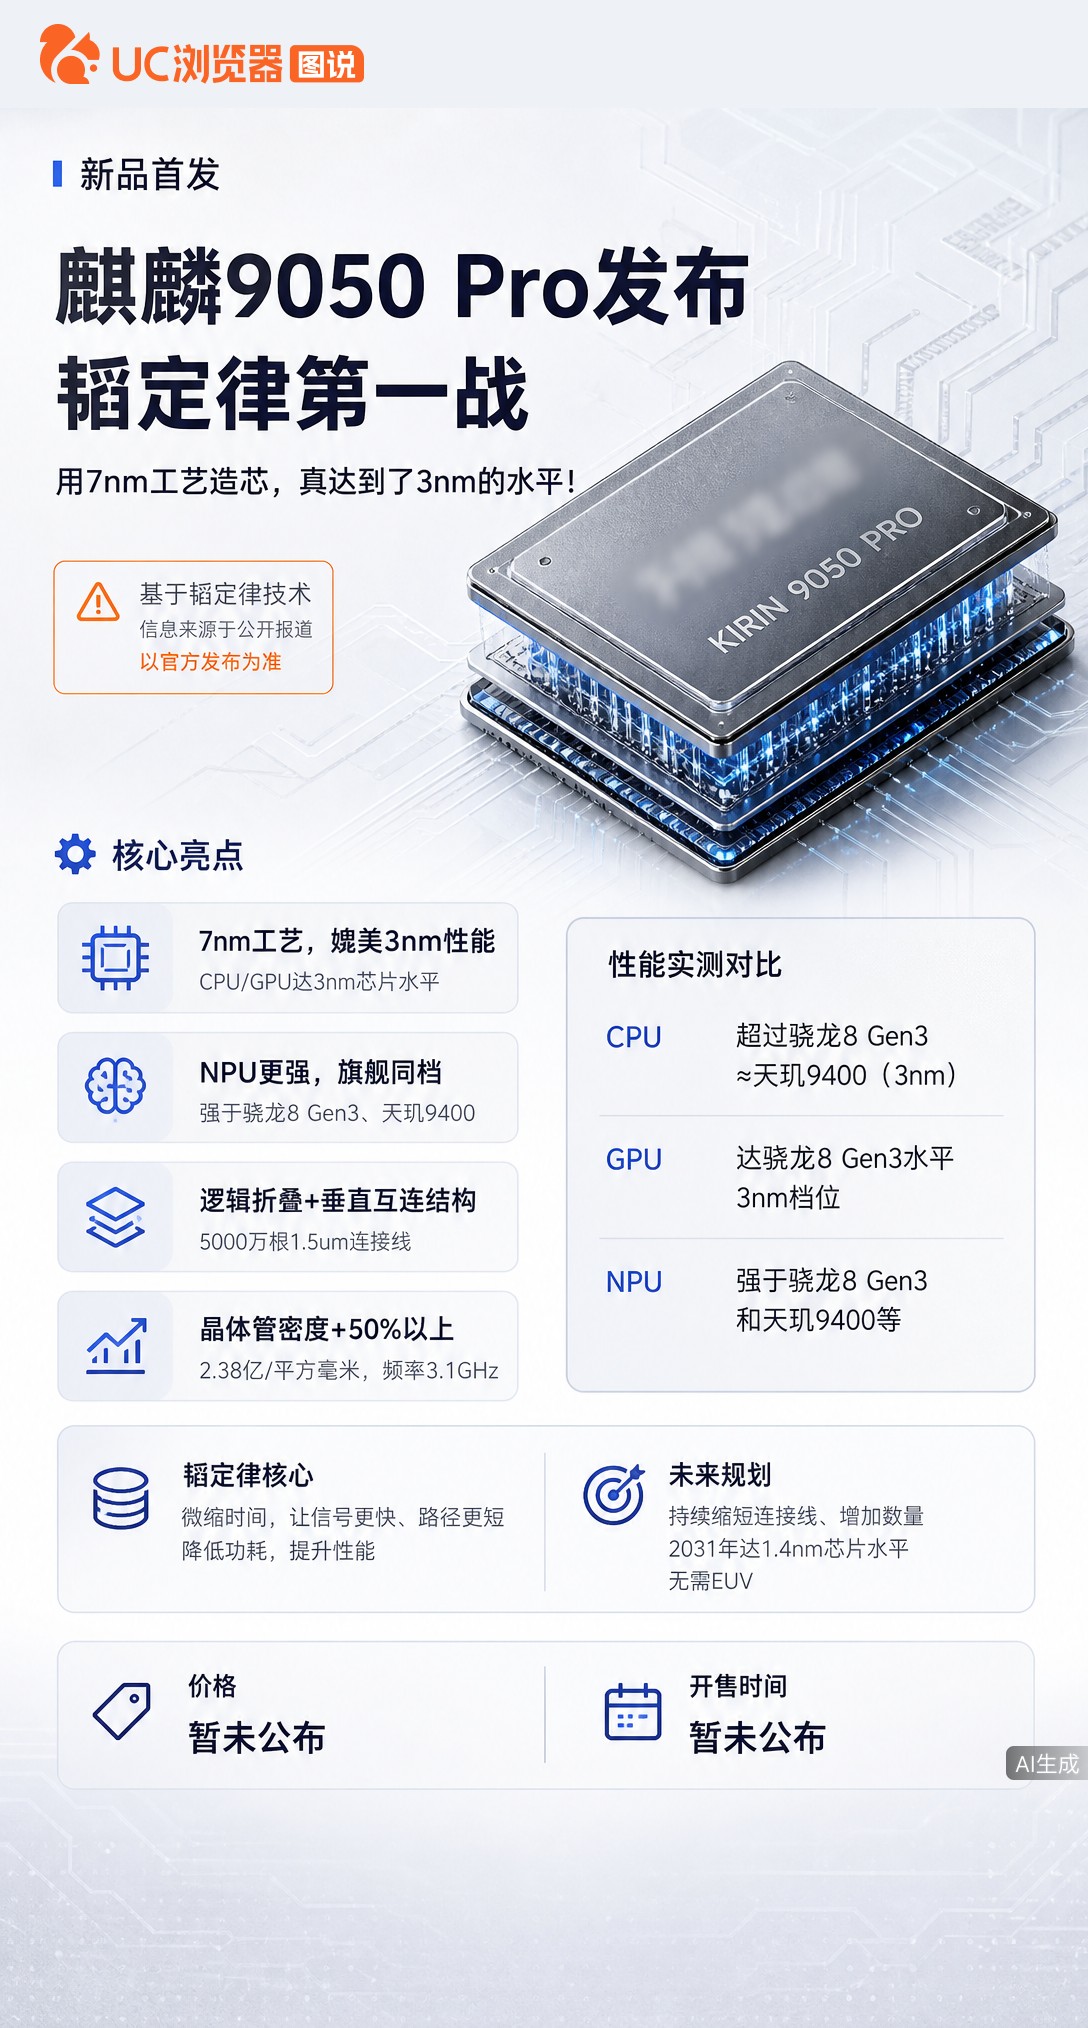
麒麟9050Pro用7nm工艺跑出3nm性能?实测CPU追平天玑9400,NPU甚至更强。靠韬定律把

麒麟9050Pro用7nm工艺跑出3nm性能?实测CPU追平天玑9400,NPU甚至更强。靠韬定律把

高通官方刚刚发布了NPU的升级爆料。这次HexagonNPU的升级,可以理

高通官方刚刚发布了NPU的升级爆料。这次HexagonNPU的升级,可以理

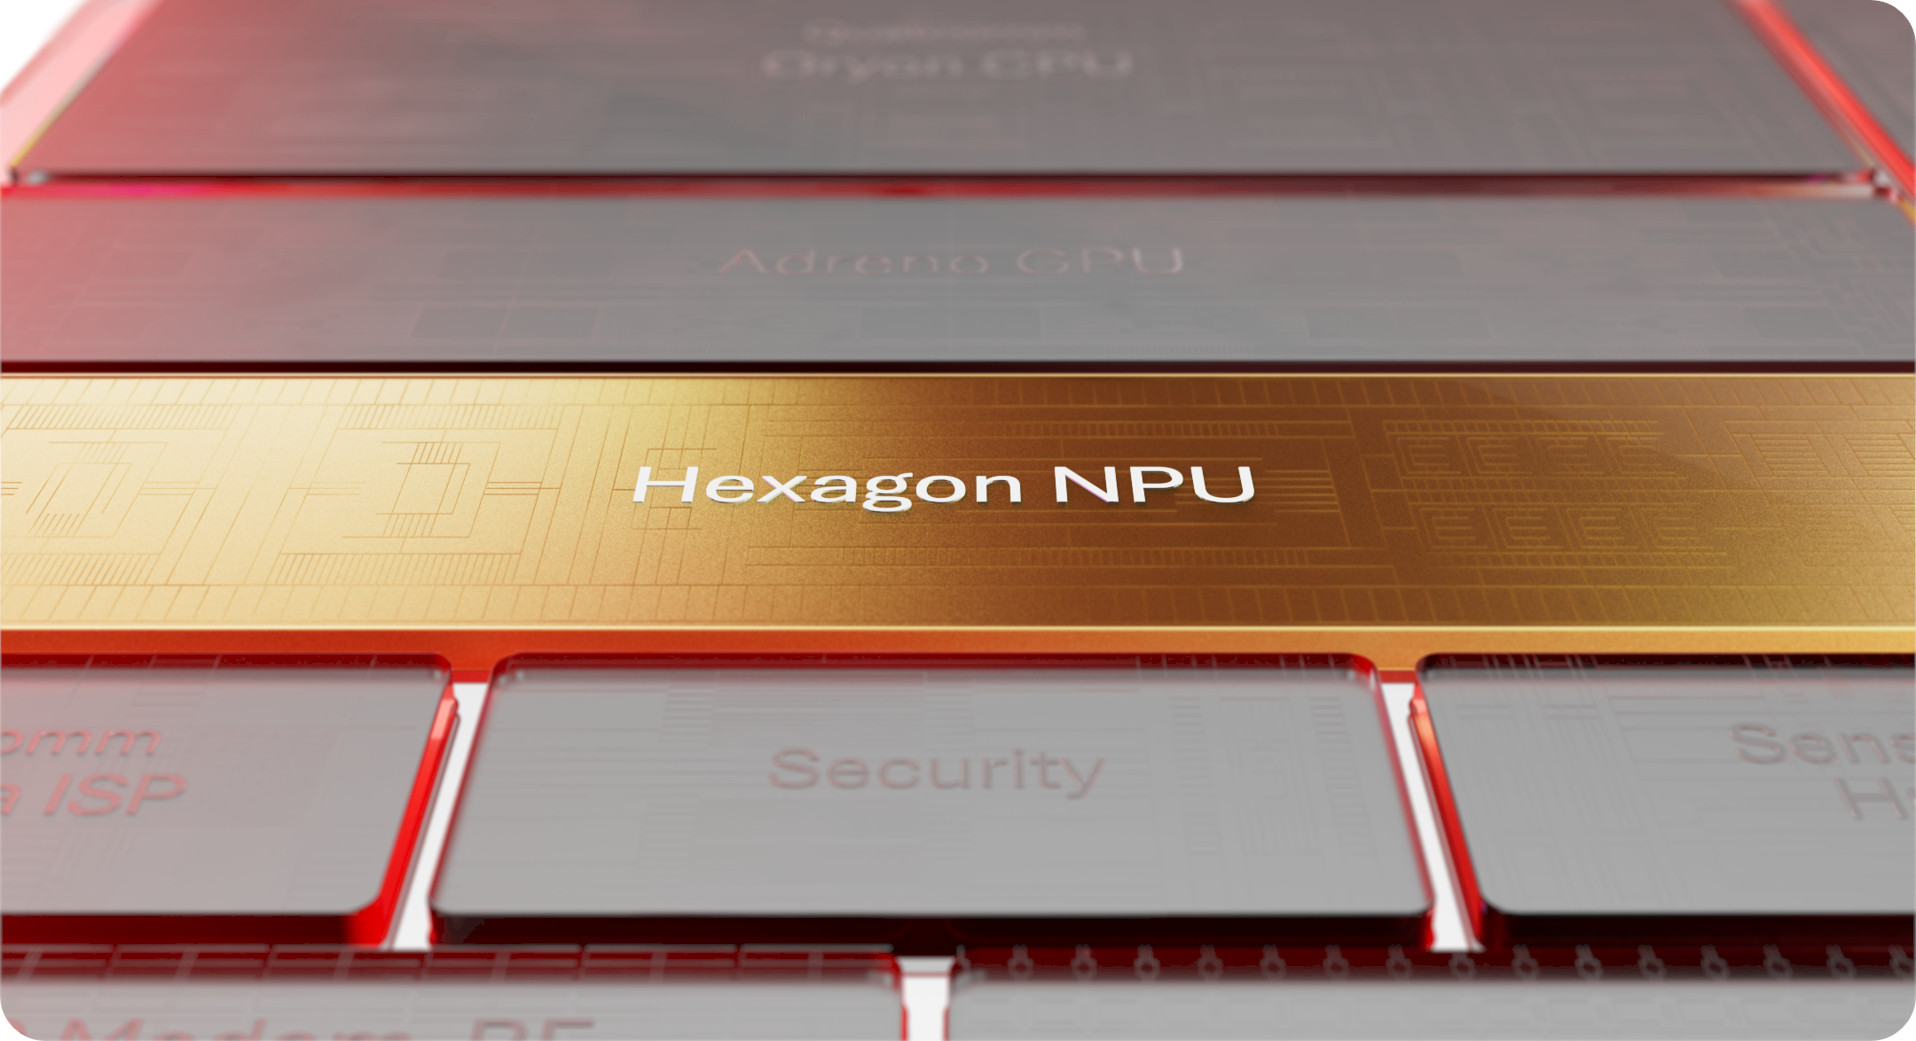
高通刚刚官宣新一代HexagonNPU,一句话总结就是:骁龙这次不只是想让

高通刚刚官宣新一代HexagonNPU,一句话总结就是:骁龙这次不只是想让

五层,高通苹果都是两层高通苹果是soc加运存,华为这个应该是把soc里面的gpu/npu/基带/cp

五层,高通苹果都是两层高通苹果是soc加运存,华为这个应该是把soc里面的gpu/npu/基带/cp

麒麟9050Pro芯片!太强了全面提升,CPU性能,GPU性能,还有NPU

麒麟9050Pro芯片!太强了全面提升,CPU性能,GPU性能,还有NPU

麒麟2026密度翻了55%,本该热炸,结果何庭波用一篇论文把「常识」拧回了自己的

麒麟2026密度翻了55%,本该热炸,结果何庭波用一篇论文把「常识」拧回了自己的

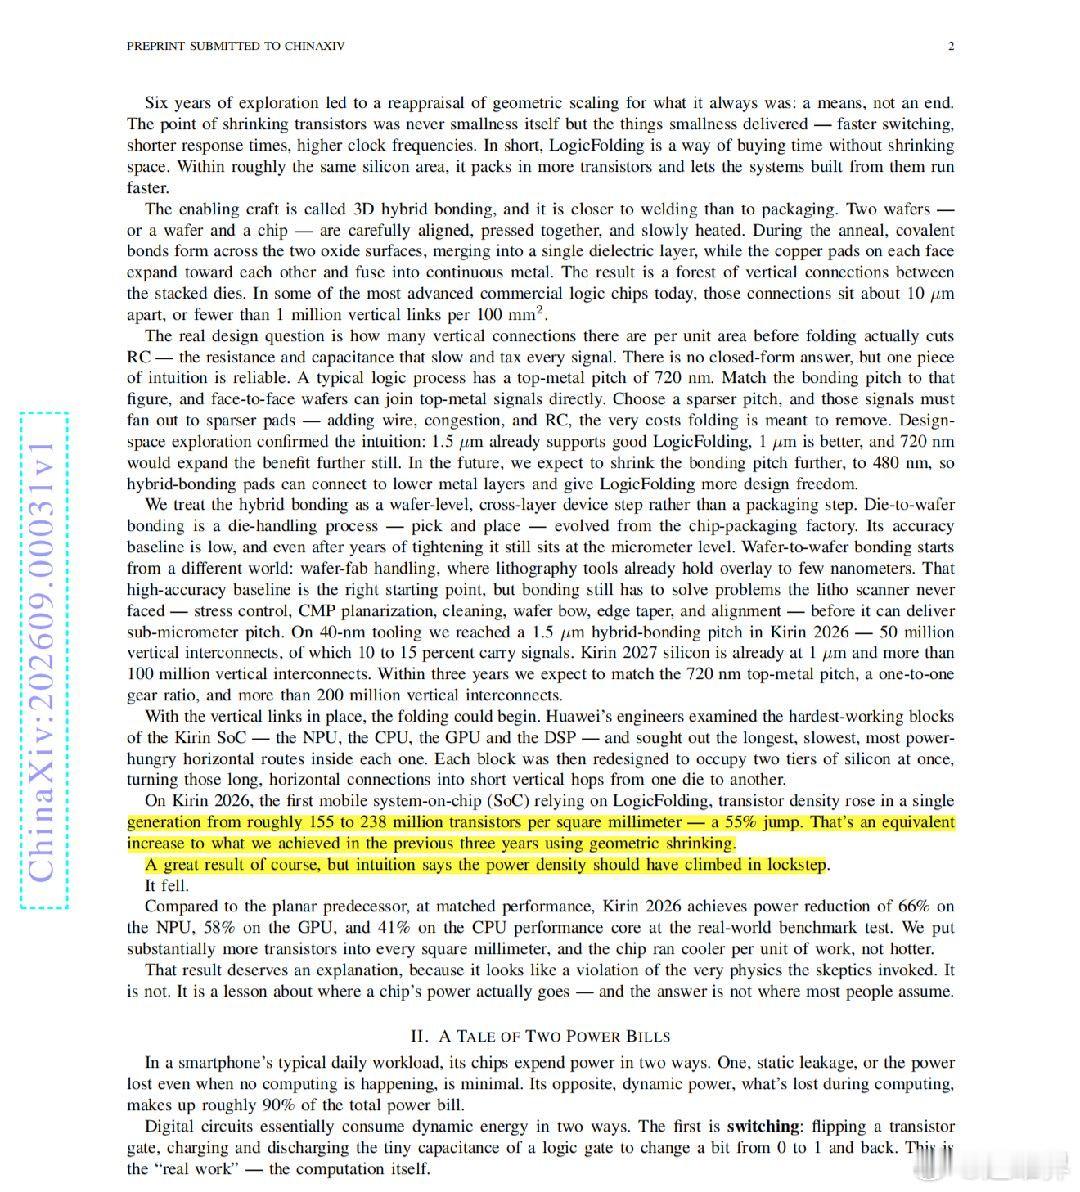
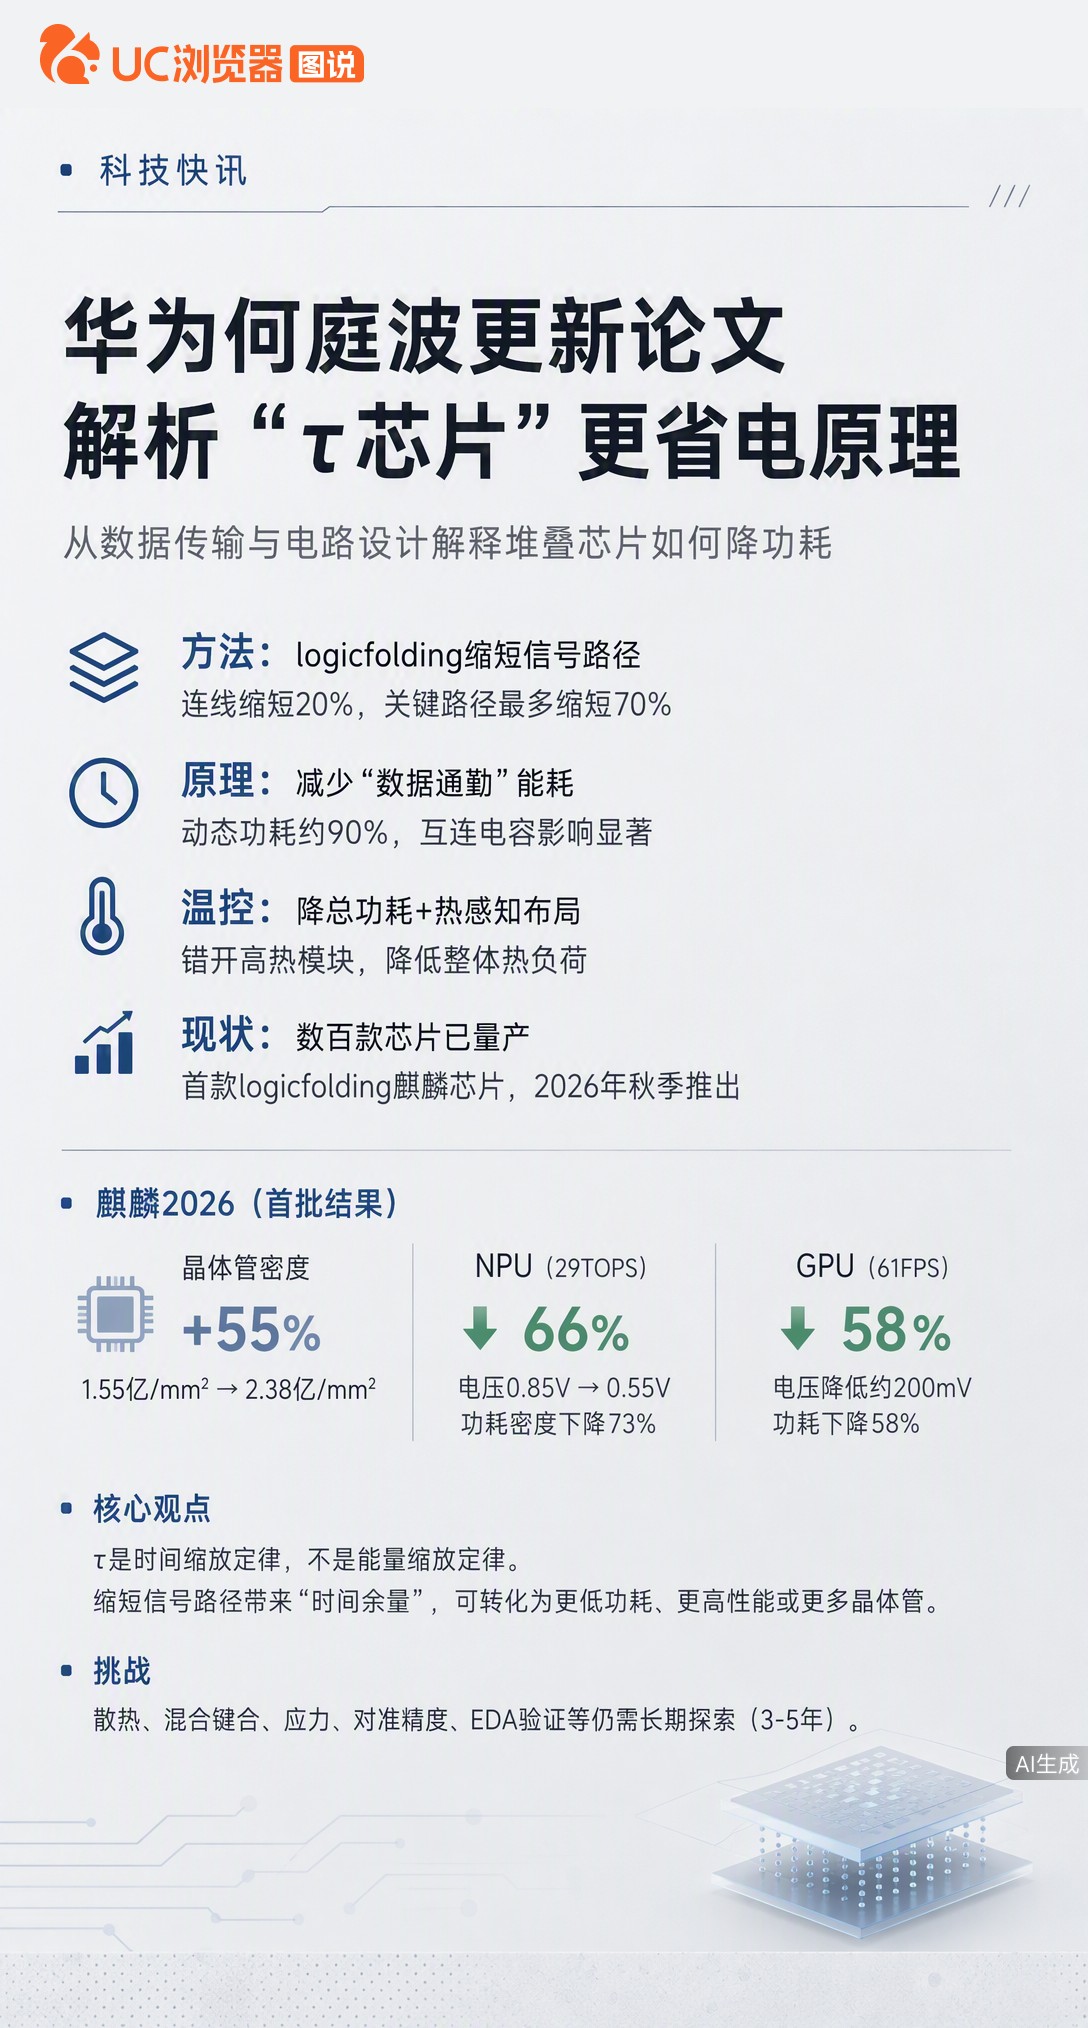
麒麟2026密度翻了55%,本该热炸,结果何庭波用一篇论文把「常识」拧回了自己的口袋麒麟2026芯片晶体管密度翻了55%,行业本来都认为这颗芯片会热炸,结果何庭波用一篇论文把行业共识拧回了符合华为技术成果的方向最近有声音质疑国际集成电路密度暴涨后芯片会热炸,这些质疑者还贴出一堆看似专业的解读。何庭波的回应直接把业界的认知掰了个方向。9月4号,ChinaSeventeen悄悄挂出一篇更新论文《华为的涛芯片本该过热烧毁吗?》,这篇论文出自何庭波团队。之前所有人都认为3D堆叠是发热大户,密度越高功率密度越高,温度必然飙升。但麒麟2026偏偏不走寻常路:它的晶体管密度从1.55亿涨到2.38亿每平方毫米,涨幅高达55%——这个涨幅相当于过去三年传统微缩的全部成果。按常识推算,这颗芯片本该热得宕机。但实测结果完全相反。同等性能下,对比前代麒麟9030Pro,麒麟2026的NPU功耗降了66%,GPU功耗降了58%,CPU大核功耗降了41%。晶体管多了55%,麒麟2026完成同样任务温度反而更低。凭什么能做到?何庭波点透了一个被所有人忽略的真相:芯片的能耗大头从来不在晶体管算力,而在金属走线搬数据。逻辑折叠把本来横着绕的走线改成竖着跳,走线变短了,电容功耗跟着降,还能实现降压。动态功耗和电压的平方成正比,走线降压带来的收益直接被放大。最夸张的是麒麟2026的NPU。29TOPS算力不变的前提下,NPU频率降了63%,电压从0.85伏砍到0.55伏,功率密度暴跌73%。NPU不仅没发热,总功耗还降了25%,技术迭代推进后功耗再降47%,功率密度比平面芯片还好看。这不是偶然的成果。华为的玩法是没盲目全堆叠,而是采用选择性折叠+热感知布局。华为让冷热模块交错排列,让热点不上下堆叠,热量由多层分摊横向扩散,研发人员硬生生把结温锁死在安全区。芯片在日常模式省电低温,在爆发模式直接开涡轮——NPU算力拉到70TOPS,比前代涨了141%,GPU帧率加42%。大家可以提出质疑,但请拿出实据。论文数据摆在这:55%密度涨上去,功耗反而降了。这颗芯片不是靠堆料硬上,而是华为在外部技术受限的阶段,给自己趟出了一条能走的路。技术没捷径,但探索从来都值得。
何庭波9月4日更新了论文麒麟9050Pro与麒麟9030Pro相比:NPU性能提

何庭波9月4日更新了论文麒麟9050Pro与麒麟9030Pro相比:NPU性能提

3D堆叠芯片注定高热?何庭波发论文回应:让数据少走弯路,麒麟2026在同等性能下NPU功耗降66%。

3D堆叠芯片注定高热?何庭波发论文回应:让数据少走弯路,麒麟2026在同等性能下NPU功耗降66%。