DC娱乐网

秀宁热谈科技的文章

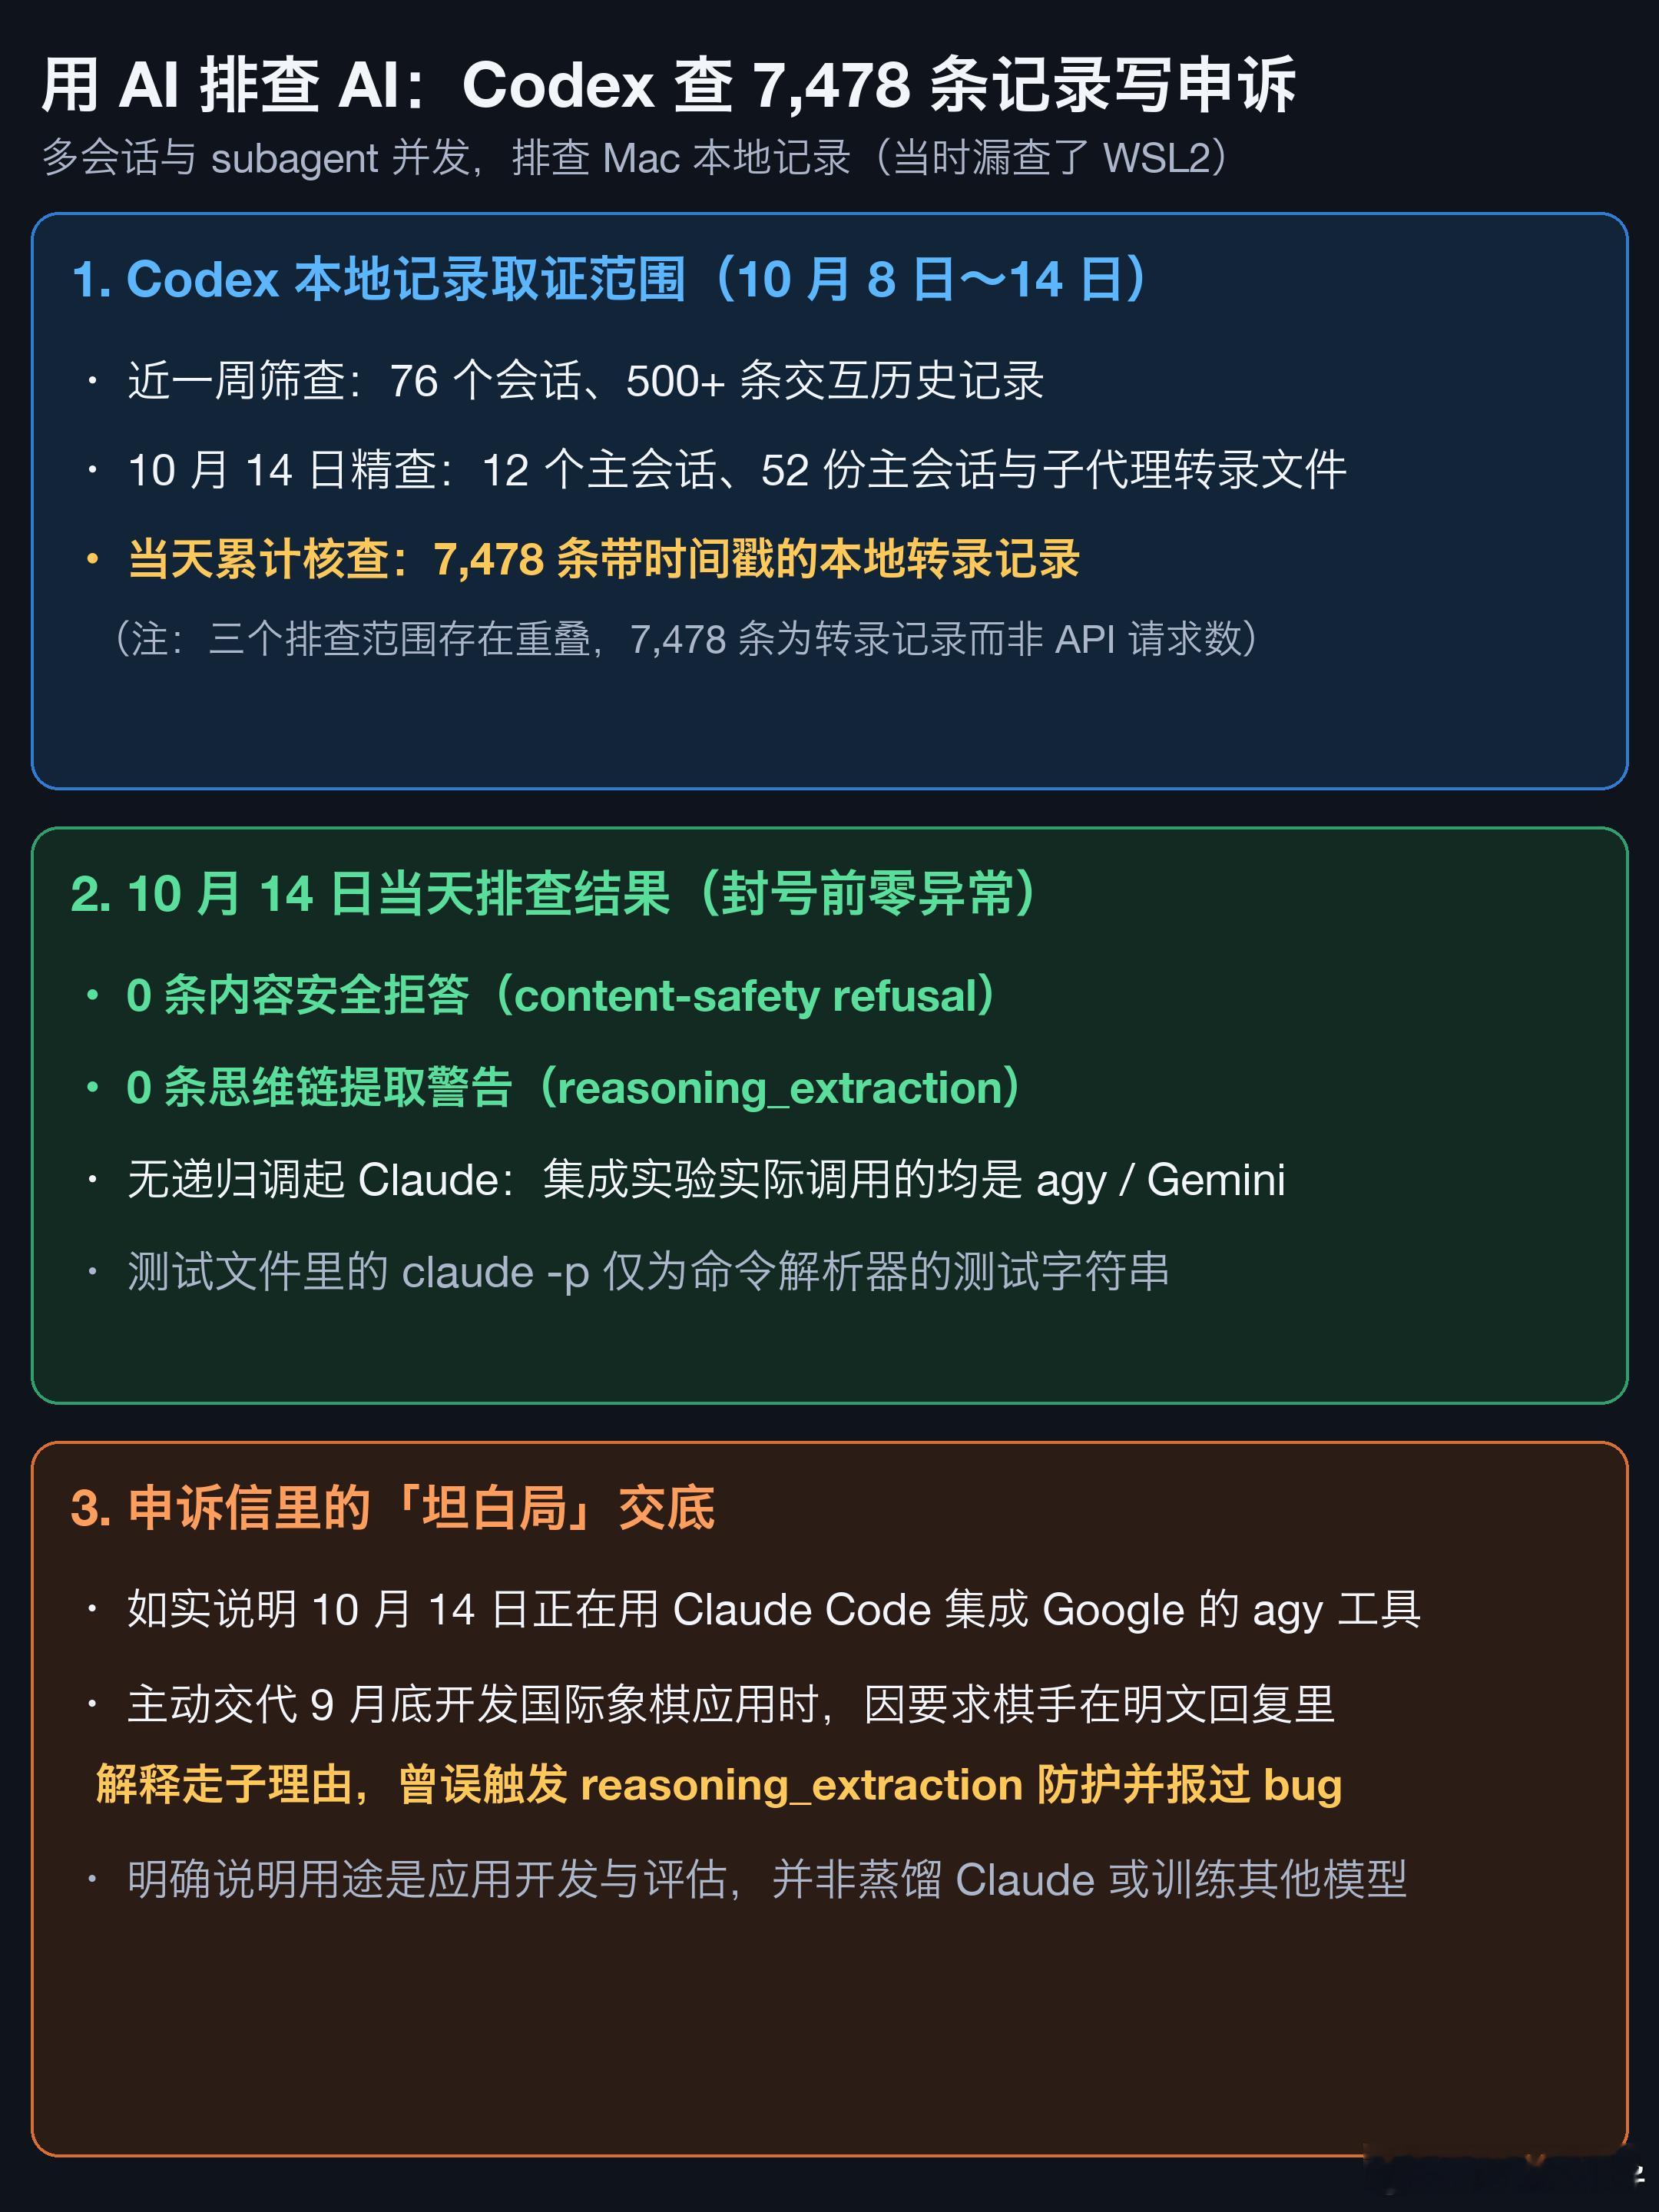
Google 憋了大半年大招,终于在 10 月 14 日发布主力模型 Gemini 4 Argon,我也准备恢复订阅。当天我用 Claude Code 在两台设备上接入新模型,结果半途账号被封,最后由 Codex 接力干完。

在 WSL2 上,Claude Code 把我们 AI 应用中的 Gemini 模型升级到 Argon,跑完修改、验证和上线,一切正常;然而 ​
Google 憋了大半年大招,终于在 10 月 14 日发布主力模型 Gemini 4 Argon,我也准备恢复订阅。当天我用 Claude Code 在两台设备上接入新模型,结果半途账号被封,最后由 Codex 接力干完。 在 WSL2 上,Claude Code 把我们 AI 应用中的 Gemini 模型升级到 Argon,跑完修改、验证和上线,一切正常;然而 ​
Google 憋了大半年大招,终于在 10 月 14 日发布主力模型 Gemini 4 Argon,我也准备恢复订阅。当天我用 Claude Code 在两台设备上接入新模型,结果半途账号被封,最后由 Codex 接力干完。 在 WSL2 上,Claude Code 把我们 AI 应用中的 Gemini 模型升级到 Argon,跑完修改、验证和上线,一切正常;然而 ​
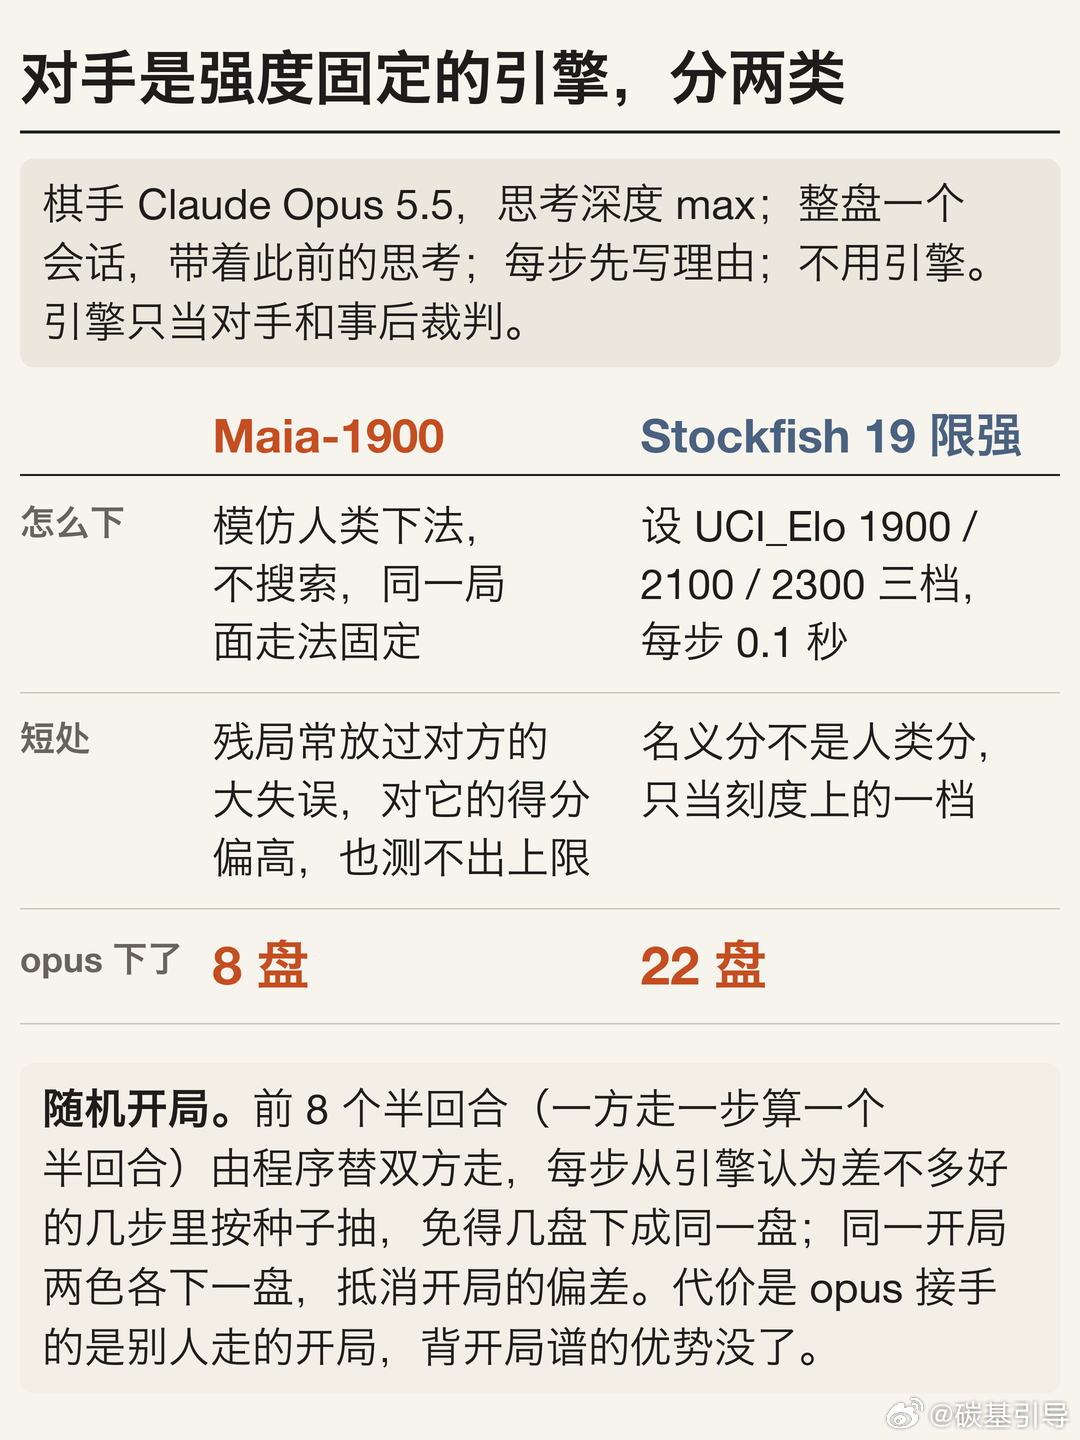
我和 agent 让 Claude Opus 5.5 思考深度开到 max,对引擎下了 30 盘国际象棋,点估计约为国际象棋网站 lichess 的超快棋 1800 分(95% 区间约 1630 到 1970),在当周活跃的约 70 万超快棋玩家里排前约 23%。

这群人的中位约 1490,前 25% 线约 1770,前 10% 线约 2000。opus 刚过前四分之一线,离前 ​

我和 agent 让 Claude Opus 5.5 思考深度开到 max,对引擎下了 30 盘国际象棋,点估计约为国际象棋网站 lichess 的超快棋 1800 分(95% 区间约 1630 到 1970),在当周活跃的约 70 万超快棋玩家里排前约 23%。 这群人的中位约 1490,前 25% 线约 1770,前 10% 线约 2000。opus 刚过前四分之一线,离前 ​

我和 agent 让 Claude Opus 5.5 思考深度开到 max,对引擎下了 30 盘国际象棋,点估计约为国际象棋网站 lichess 的超快棋 1800 分(95% 区间约 1630 到 1970),在当周活跃的约 70 万超快棋玩家里排前约 23%。 这群人的中位约 1490,前 25% 线约 1770,前 10% 线约 2000。opus 刚过前四分之一线,离前 ​
此前让 Claude Opus 5.5 和 GPT-6 Astra 下棋,两边思考深度都开到 max,opus 国际象棋 3 比 1、象棋 4 比 0 胜出,但两边都下得挺臭。

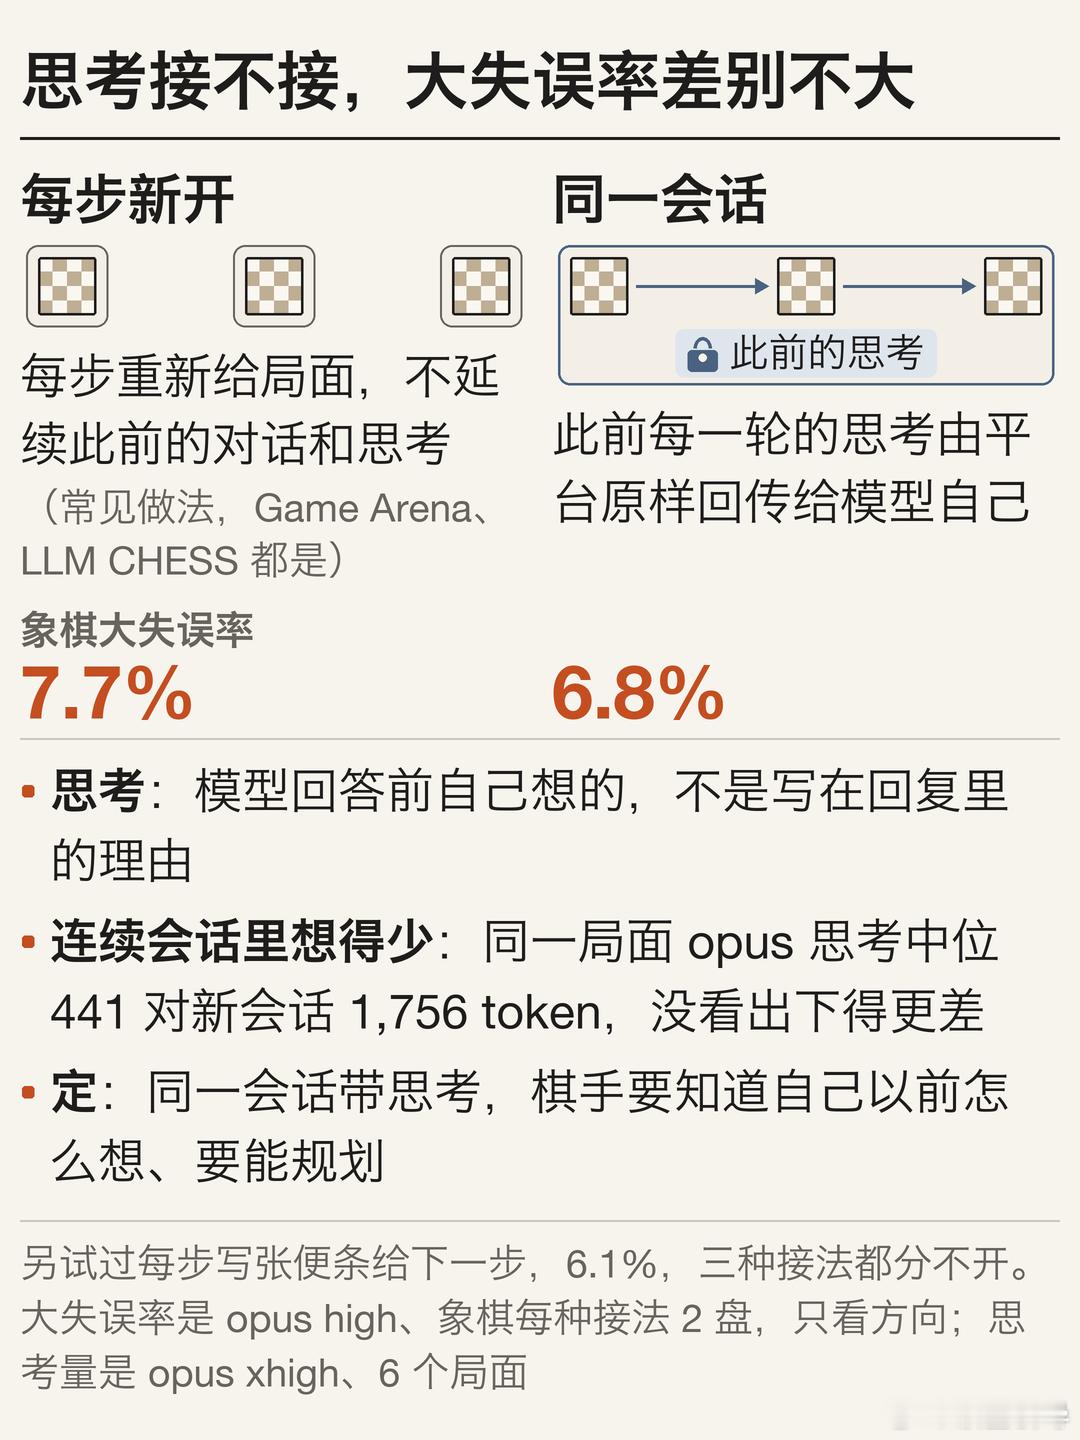
对弈环境是我和 agent 事先把近 20 个变量过了一遍定下的,多数实测过,毕竟环境搭得不对,测的就不全是模型的棋力。最管用的是思考深度;其余测过的影响都小。最 ​

此前让 Claude Opus 5.5 和 GPT-6 Astra 下棋,两边思考深度都开到 max,opus 国际象棋 3 比 1、象棋 4 比 0 胜出,但两边都下得挺臭。 对弈环境是我和 agent 事先把近 20 个变量过了一遍定下的,多数实测过,毕竟环境搭得不对,测的就不全是模型的棋力。最管用的是思考深度;其余测过的影响都小。最 ​

此前让 Claude Opus 5.5 和 GPT-6 Astra 下棋,两边思考深度都开到 max,opus 国际象棋 3 比 1、象棋 4 比 0 胜出,但两边都下得挺臭。 对弈环境是我和 agent 事先把近 20 个变量过了一遍定下的,多数实测过,毕竟环境搭得不对,测的就不全是模型的棋力。最管用的是思考深度;其余测过的影响都小。最 ​
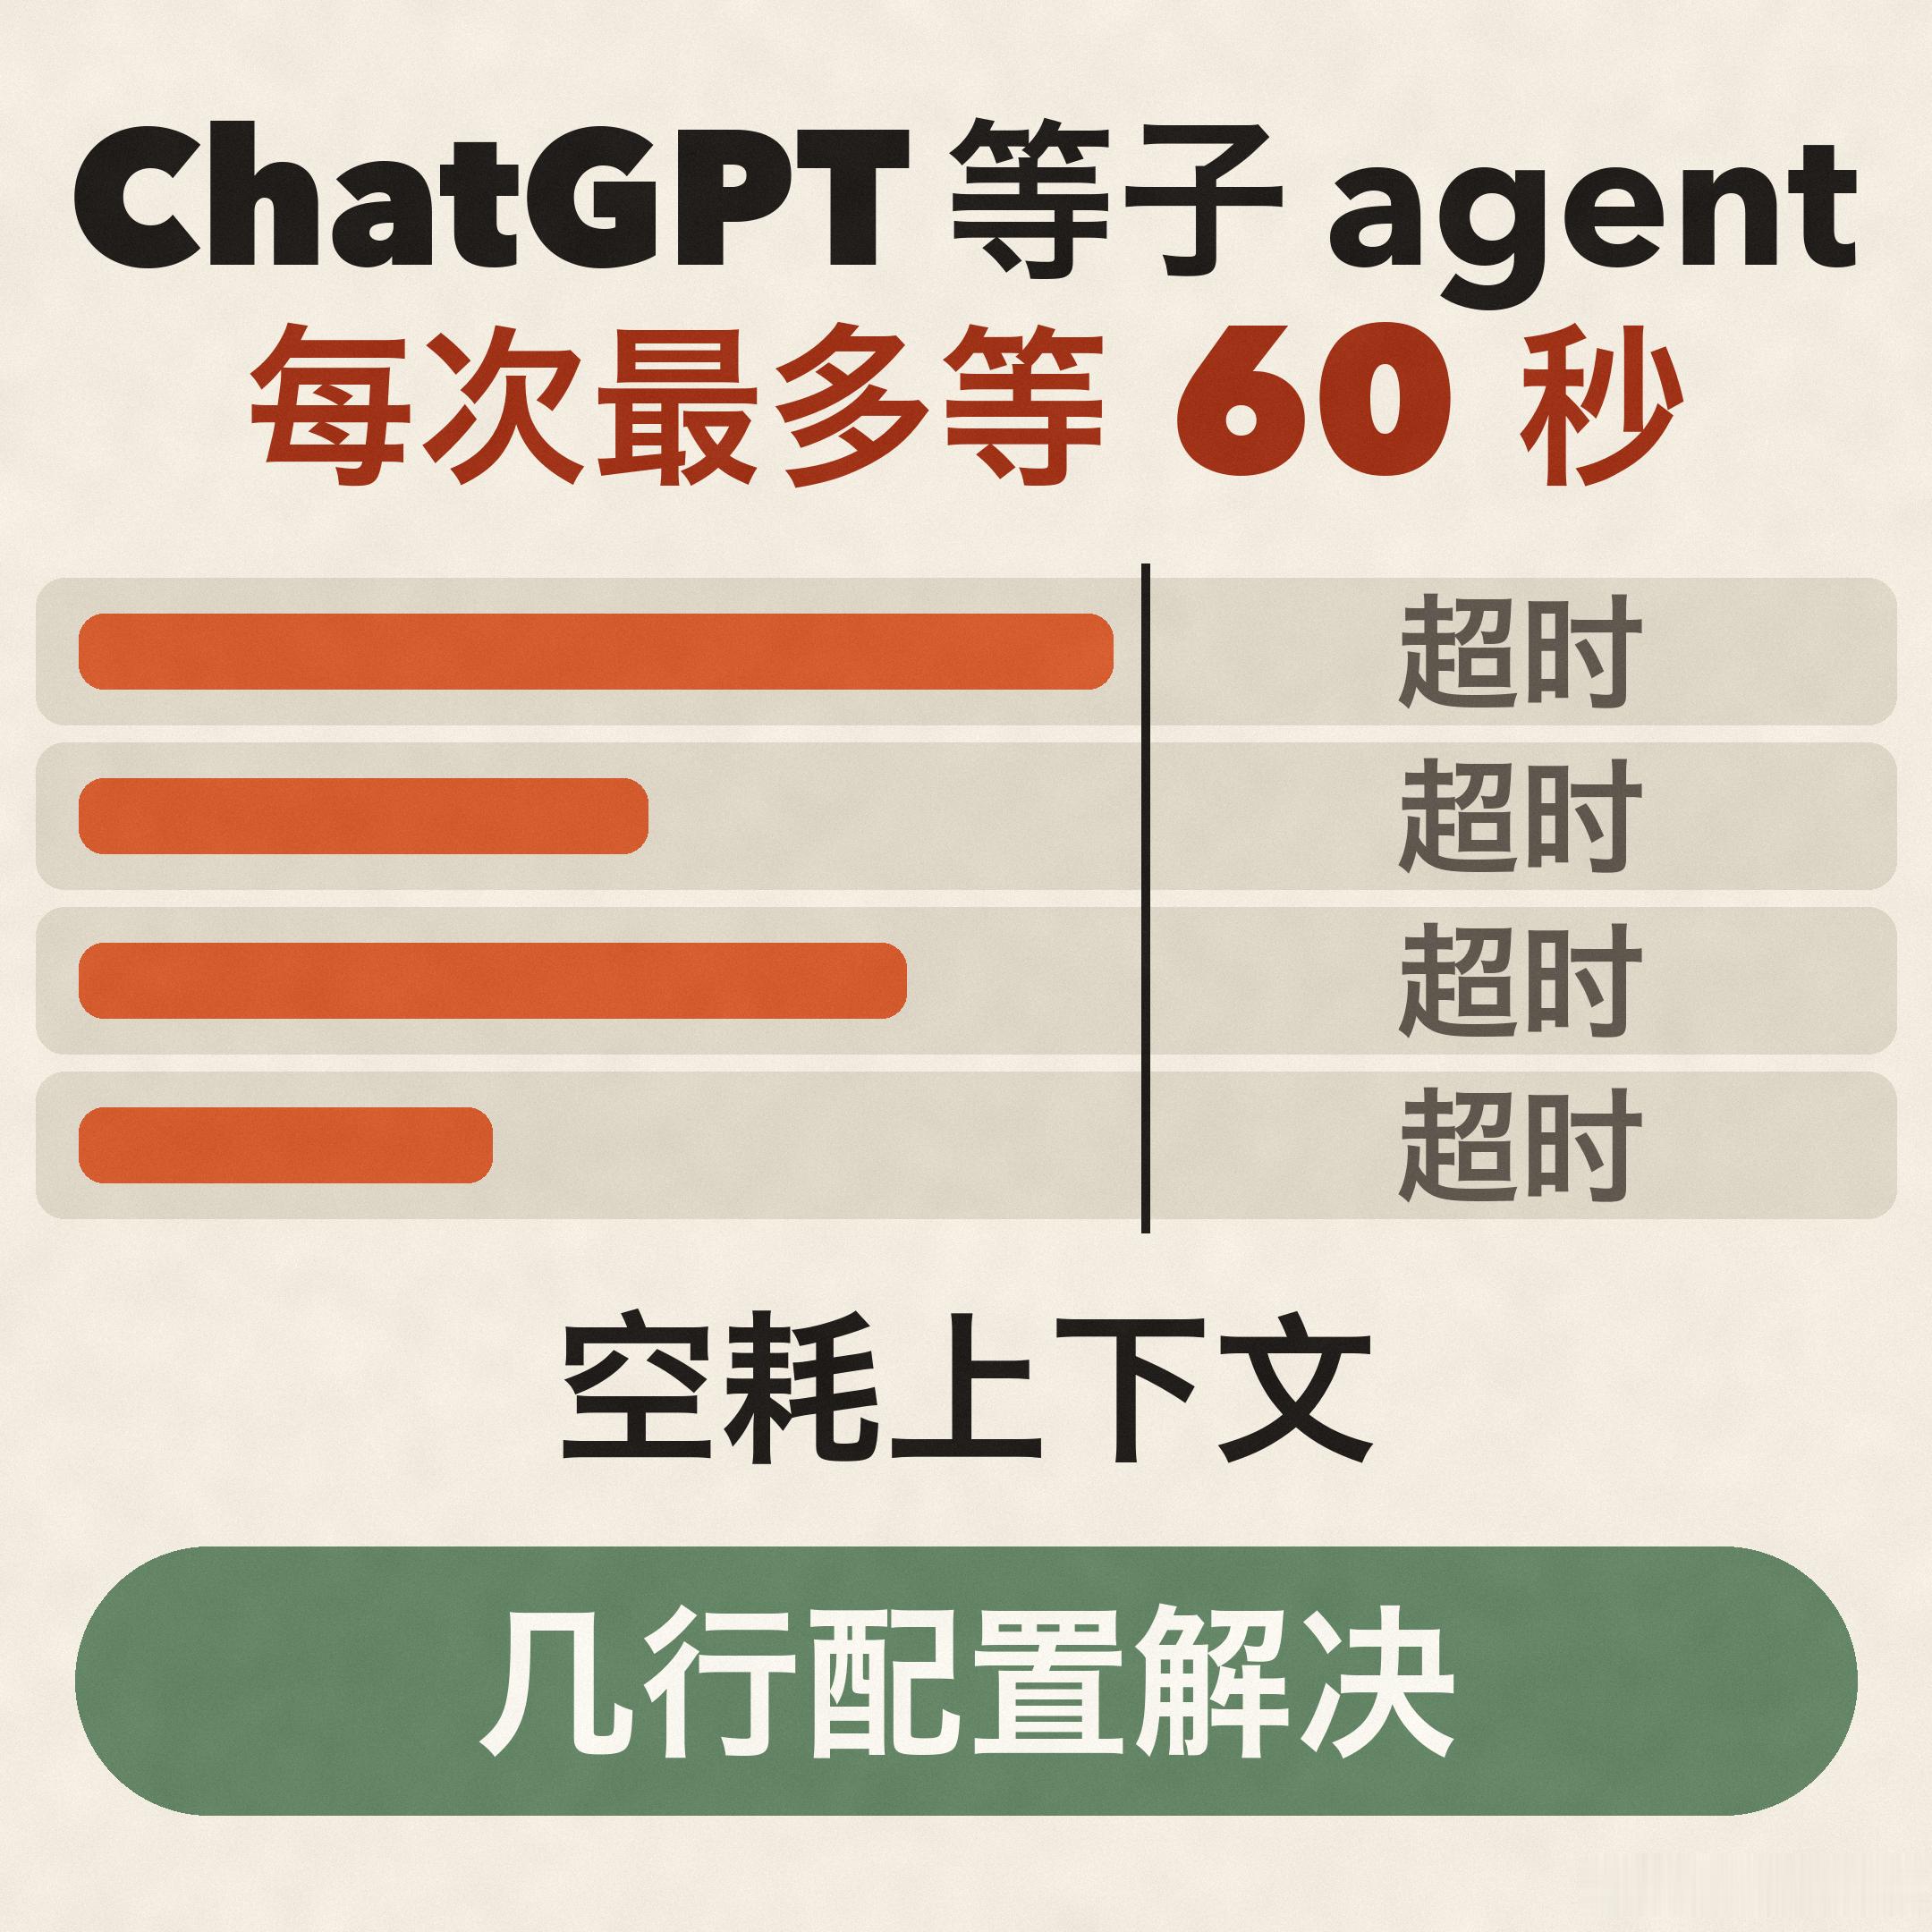
agent 层层派活已是常态,子孙 agent 的任务越跑越长,所以我在全局 AGENTS.md 里写明,等子 agent「通常 10m 起」。然而 ChatGPT Codex/Work 并未遵循,每次最多只等 60 秒。后果是,每次空醒,上下文就多一组调用和超时记录。子 agent 跑得越久,空耗的上下文就越多。

我让 Codex 查了一下,发现 60 ​

agent 层层派活已是常态,子孙 agent 的任务越跑越长,所以我在全局 AGENTS.md 里写明,等子 agent「通常 10m 起」。然而 ChatGPT Codex/Work 并未遵循,每次最多只等 60 秒。后果是,每次空醒,上下文就多一组调用和超时记录。子 agent 跑得越久,空耗的上下文就越多。 我让 Codex 查了一下,发现 60 ​

agent 层层派活已是常态,子孙 agent 的任务越跑越长,所以我在全局 AGENTS.md 里写明,等子 agent「通常 10m 起」。然而 ChatGPT Codex/Work 并未遵循,每次最多只等 60 秒。后果是,每次空醒,上下文就多一组调用和超时记录。子 agent 跑得越久,空耗的上下文就越多。 我让 Codex 查了一下,发现 60 ​
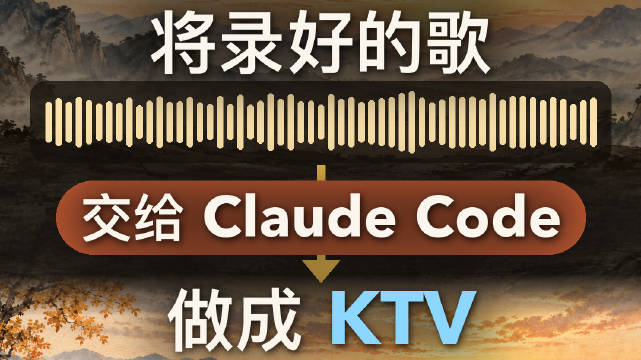
这是一个真实的需求,家里的老年人想把知青诗社的社歌《追逐太阳》(杨建成词,梁素华曲)做成 KTV 式

这是一个真实的需求,家里的老年人想把知青诗社的社歌《追逐太阳》(杨建成词,梁素华曲)做成 KTV 式...

这是一个真实的需求,家里的老年人想把知青诗社的社歌《追逐太阳》(杨建成词,梁素华曲)做成 KTV 式歌词视频,便于大家合唱。我把录音、手机拍的简谱和歌词交给 Claude Code Agent,只说了想要什么,没教它怎么做。用的是 Opus 5.5、思考深度 medium,很顺利
此前和 agent 实测发现,Jev 会上下文学习,给它例子和记录,它能把判断调准;但想让它越玩越强,还得有人帮一把。这次试了几种帮法。

我们的实验用到了「老虎机」,它是测 AI「边试边学」的经典小游戏。有几个按钮,每个中奖概率固定,但 AI 事先不知道,只能从按出来的结果里摸索出哪个最容易中。

 ​

此前和 agent 实测发现,Jev 会上下文学习,给它例子和记录,它能把判断调准;但想让它越玩越强,还得有人帮一把。这次试了几种帮法。 我们的实验用到了「老虎机」,它是测 AI「边试边学」的经典小游戏。有几个按钮,每个中奖概率固定,但 AI 事先不知道,只能从按出来的结果里摸索出哪个最容易中。 ​

此前和 agent 实测发现,Jev 会上下文学习,给它例子和记录,它能把判断调准;但想让它越玩越强,还得有人帮一把。这次试了几种帮法。 我们的实验用到了「老虎机」,它是测 AI「边试边学」的经典小游戏。有几个按钮,每个中奖概率固定,但 AI 事先不知道,只能从按出来的结果里摸索出哪个最容易中。 ​
上一篇拆了几个 Jev 打游戏的爆款,没找到 Jev 自己「越玩越强」的可靠证据。那它到底会不会学?我和我的 agent 拿分类题、老虎机、迷宫这几个简化任务做了大量对比实验,结论是会。

就像大模型照着范文写出相似文风,Jev 也能不改模型参数,只靠这次输入里的例子和记录调整判断,即上下文学习。但能 ​

上一篇拆了几个 Jev 打游戏的爆款,没找到 Jev 自己「越玩越强」的可靠证据。那它到底会不会学?我和我的 agent 拿分类题、老虎机、迷宫这几个简化任务做了大量对比实验,结论是会。 就像大模型照着范文写出相似文风,Jev 也能不改模型参数,只靠这次输入里的例子和记录调整判断,即上下文学习。但能 ​

上一篇拆了几个 Jev 打游戏的爆款,没找到 Jev 自己「越玩越强」的可靠证据。那它到底会不会学?我和我的 agent 拿分类题、老虎机、迷宫这几个简化任务做了大量对比实验,结论是会。 就像大模型照着范文写出相似文风,Jev 也能不改模型参数,只靠这次输入里的例子和记录调整判断,即上下文学习。但能 ​
之前我让 ChatGPT 和 Jev 下国际象棋,21 回合就把 Jev KO 了。可 Jev 打游戏的爆款一个比一个猛,我原来以为,这些项目会像使用大模型带上前面的历史那样,把玩过的经历也喂给 Jev,让它边玩边学,「越玩越强」。

于是我和我的 agent 把最火的 Minecraft 屠龙从源码到作者说明拆了一遍。

我们的结论 ​

之前我让 ChatGPT 和 Jev 下国际象棋,21 回合就把 Jev KO 了。可 Jev 打游戏的爆款一个比一个猛,我原来以为,这些项目会像使用大模型带上前面的历史那样,把玩过的经历也喂给 Jev,让它边玩边学,「越玩越强」。 于是我和我的 agent 把最火的 Minecraft 屠龙从源码到作者说明拆了一遍。 我们的结论 ​

之前我让 ChatGPT 和 Jev 下国际象棋,21 回合就把 Jev KO 了。可 Jev 打游戏的爆款一个比一个猛,我原来以为,这些项目会像使用大模型带上前面的历史那样,把玩过的经历也喂给 Jev,让它边玩边学,「越玩越强」。 于是我和我的 agent 把最火的 Minecraft 屠龙从源码到作者说明拆了一遍。 我们的结论 ​
之前我和我的 agent 实测发现,Jev 的上下文是两道墙:state(材料)加最长那道题不超过约 32K,整个请求不超过约 64K。为什么是两道,官方没解释,从 OpenAI 出来的 CEO 说架构先捂着,果然很 Open。

一位也在研究 Jev 的朋友分享的研究报告里提到一种解释。我们顺着找到原作者 Archer Hume,又用一 ​

之前我和我的 agent 实测发现,Jev 的上下文是两道墙:state(材料)加最长那道题不超过约 32K,整个请求不超过约 64K。为什么是两道,官方没解释,从 OpenAI 出来的 CEO 说架构先捂着,果然很 Open。 一位也在研究 Jev 的朋友分享的研究报告里提到一种解释。我们顺着找到原作者 Archer Hume,又用一 ​

之前我和我的 agent 实测发现,Jev 的上下文是两道墙:state(材料)加最长那道题不超过约 32K,整个请求不超过约 64K。为什么是两道,官方没解释,从 OpenAI 出来的 CEO 说架构先捂着,果然很 Open。 一位也在研究 Jev 的朋友分享的研究报告里提到一种解释。我们顺着找到原作者 Archer Hume,又用一 ​

Opus 5.5 的官方推荐思考深度降了一档。Opus 5 统一从 high 起步,5.5 统一从 medium 起步,编码也不例外。我改成 medium 后,速度快了很多,加上 5.5 还降了价,额度也更经用。除非跑大 loop,短期内总算不用天天盯着周额度了。 不过日常用 Opus 5.5 + medium,委派 Fable 5.1 subagent 时会比较尴尬 ​

Opus 5.5 的官方推荐思考深度降了一档。Opus 5 统一从 high 起步,5.5 统一从 medium 起步,编码也不例外。我改成 medium 后,速度快了很多,加上 5.5 还降了价,额度也更经用。除非跑大 loop,短期内总算不用天天盯着周额度了。 不过日常用 Opus 5.5 + medium,委派 Fable 5.1 subagent 时会比较尴尬 ​

Opus 5.5 终于恢复了一些人味,不用天天看它生成生成的天书,也不用整天和它掰扯,也不会时不时被甩一句「你认不认账」的质问。心情立刻好了不少。#claude[超话]##人工智能# ​

Opus 5.5 终于恢复了一些人味,不用天天看它生成生成的天书,也不用整天和它掰扯,也不会时不时被甩一句「你认不认账」的质问。心情立刻好了不少。#claude[超话]##人工智能# ​
Jev 打游戏刷屏,这究竟是怎么玩的?我拿迷宫和国际象棋实操了一下,看起来不是辣么难。

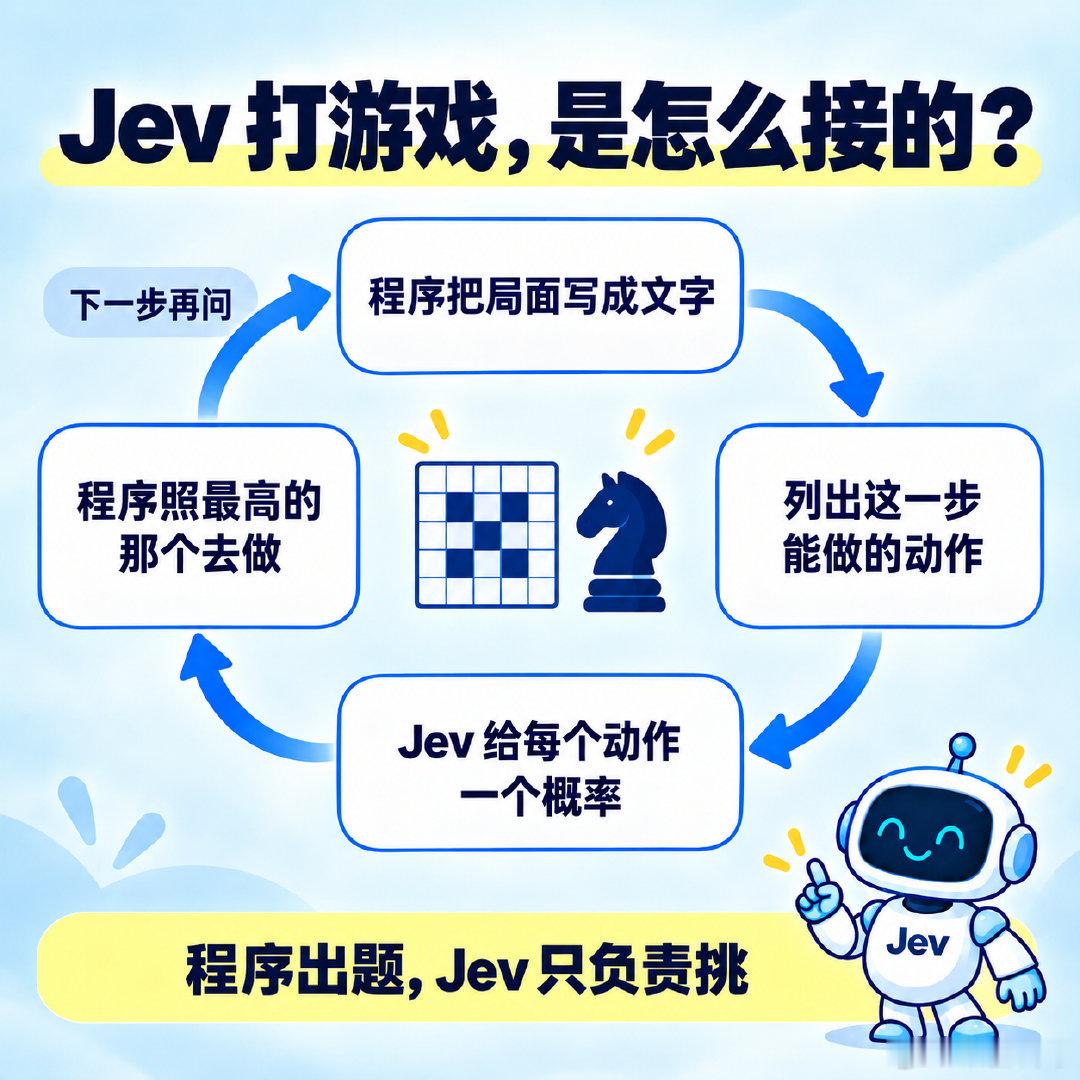
Jev 不看画面。程序先把眼前的局面组织为文字,再把这一步能做的动作列成选项。Jev 给每个选项一个概率,程序照概率最高的那个去执行,然后下一步再问。记下走过的路也归程序管,Jev 只负责决策下一步。TypeSafe 官方打 Doom 的演示,也差不多是这样处理的。

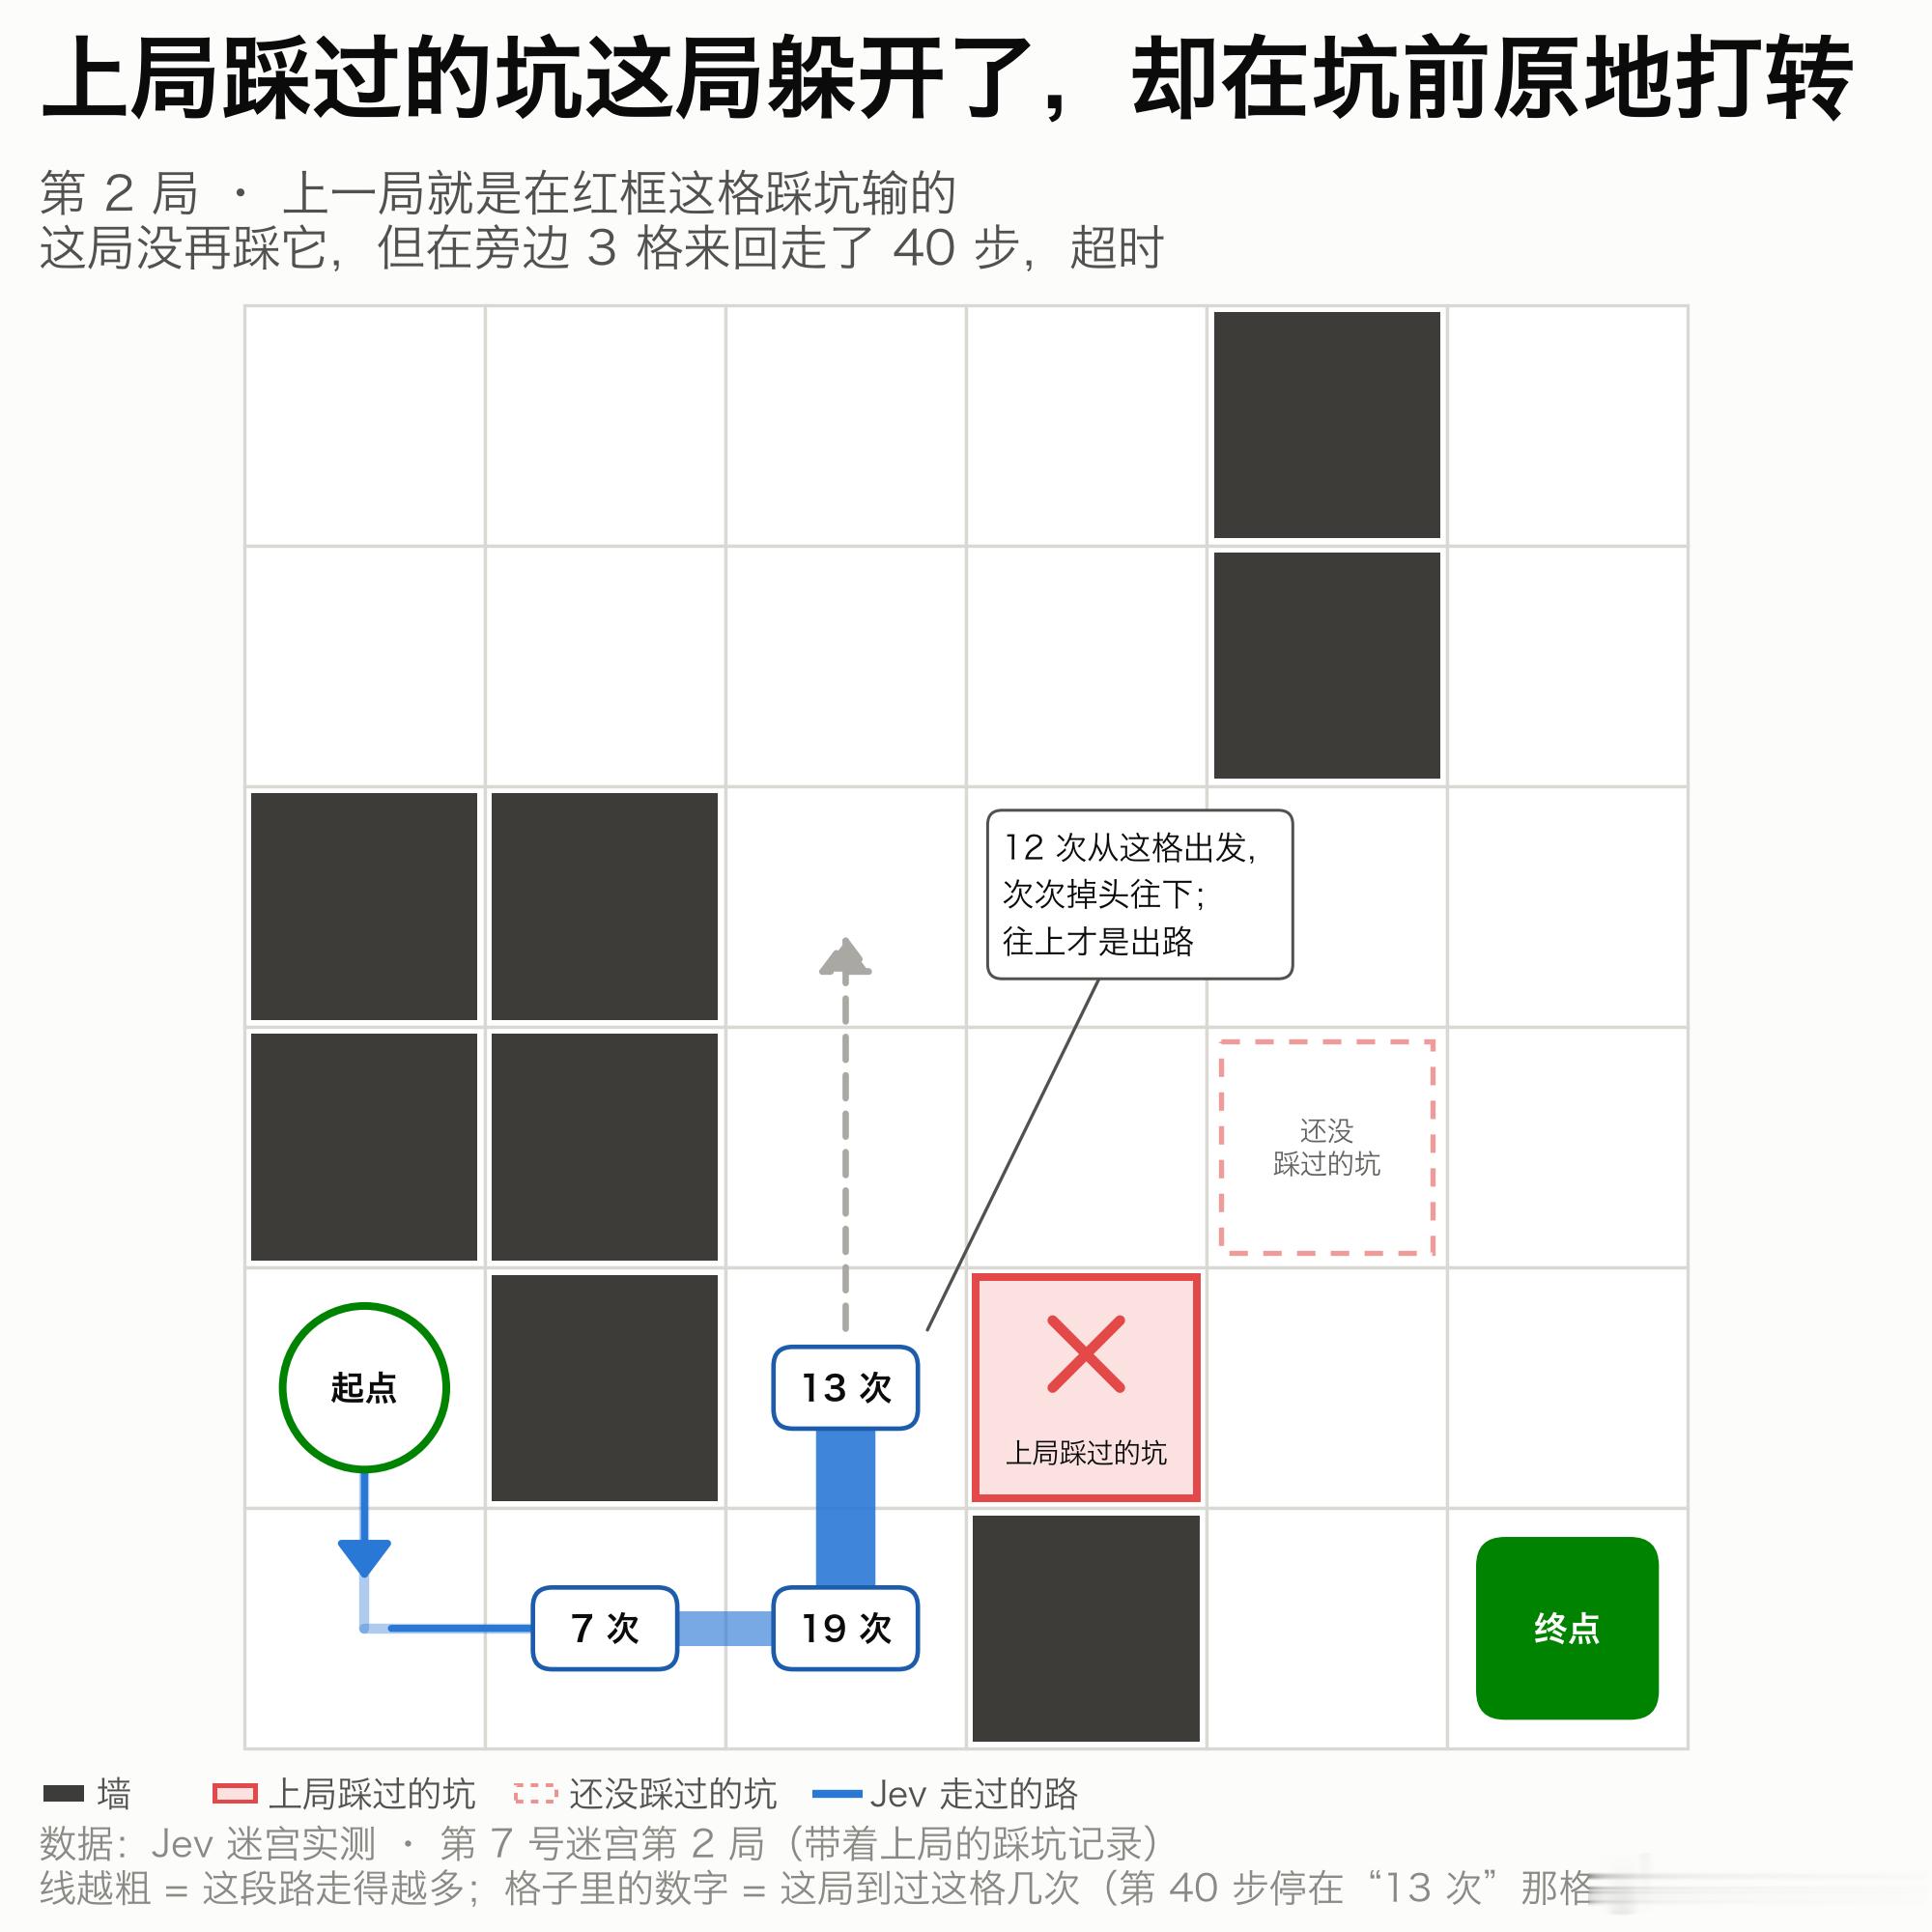
迷宫是 5×5 的格子地图,每一步发给 Jev 的是:角色、终点、敌人和墙各在哪,上下左右四格各是什么(比如空地、墙还是出界),再加一句目标:别踩敌人,尽快走到终点。选项是上、下、左、右、原地不动。撞墙和出界的方向我故意留着,好看它会不会选错。它回的是每个选项的概率,比如:上 0.78、左 0.22,其余都是 0,程序就往上走一格。

国际象棋也类似,轮到 Jev 走时,程序先算出所有合法走法(用现成的象棋库,别手搓)。比如开局第一步,白方有 20 种走法,选项就是这 20 个,用棋谱记法书写:e4(兵走到 e4)、Nf3(马跳...

Jev 打游戏刷屏,这究竟是怎么玩的?我拿迷宫和国际象棋实操了一下,看起来不是辣么难。 Jev 不看画面。程序先把眼前的局面组织为文字,再把这一步能做的动作列成选项。Jev 给每个选项一个概率,程序照概率最高的那个去执行,然后下一步再问。记下走过的路也归程序管,Jev 只负责决策下一步。TypeSafe 官方打 Doom 的演示,也差不多是这样处理的。 迷宫是 5×5 的格子地图,每一步发给 Jev 的是:角色、终点、敌人和墙各在哪,上下左右四格各是什么(比如空地、墙还是出界),再加一句目标:别踩敌人,尽快走到终点。选项是上、下、左、右、原地不动。撞墙和出界的方向我故意留着,好看它会不会选错。它回的是每个选项的概率,比如:上 0.78、左 0.22,其余都是 0,程序就往上走一格。 国际象棋也类似,轮到 Jev 走时,程序先算出所有合法走法(用现成的象棋库,别手搓)。比如开局第一步,白方有 20 种走法,选项就是这 20 个,用棋谱记法书写:e4(兵走到 e4)、Nf3(马跳...

Jev 打游戏刷屏,这究竟是怎么玩的?我拿迷宫和国际象棋实操了一下,看起来不是辣么难。 Jev 不看画面。程序先把眼前的局面组织为文字,再把这一步能做的动作列成选项。Jev 给每个选项一个概率,程序照概率最高的那个去执行,然后下一步再问。记下走过的路也归程序管,Jev 只负责决策下一步。TypeSafe 官方打 Doom 的演示,也差不多是这样处理的。 迷宫是 5×5 的格子地图,每一步发给 Jev 的是:角色、终点、敌人和墙各在哪,上下左右四格各是什么(比如空地、墙还是出界),再加一句目标:别踩敌人,尽快走到终点。选项是上、下、左、右、原地不动。撞墙和出界的方向我故意留着,好看它会不会选错。它回的是每个选项的概率,比如:上 0.78、左 0.22,其余都是 0,程序就往上走一格。 国际象棋也类似,轮到 Jev 走时,程序先算出所有合法走法(用现成的象棋库,别手搓)。比如开局第一步,白方有 20 种走法,选项就是这 20 个,用棋谱记法书写:e4(兵走到 e4)、Nf3(马跳...

Jev 看起来代表了不同于 GPT、DeepSeek 这类大语言模型的另一条路线。开发者 TypeSafe 将这类面向判断和决策的模型称为 System One Models,Jev 是其中首个公开模型。 Jev 没有公开其模型结构和完整的训练细节,只提到名为 RLCD 的强化学习方法,并将其放在预训练语言模型的后训练路线中讨论。 Jev ​

Jev 看起来代表了不同于 GPT、DeepSeek 这类大语言模型的另一条路线。开发者 TypeSafe 将这类面向判断和决策的模型称为 System One Models,Jev 是其中首个公开模型。 Jev 没有公开其模型结构和完整的训练细节,只提到名为 RLCD 的强化学习方法,并将其放在预训练语言模型的后训练路线中讨论。 Jev ​
#许凯[超话]#  许凯这个挑眉

一盏春瓯,半部浮沉。
世事如棋,人心难测,沈润于荆棘之中寻一条昭

#许凯[超话]# 许凯这个挑眉 一盏春瓯,半部浮沉。 世事如棋,人心难测,沈润于荆棘之中寻一条昭...

#许凯[超话]# 许凯这个挑眉 一盏春瓯,半部浮沉。 世事如棋,人心难测,沈润于荆棘之中寻一条昭雪之路。镜头之下,你褪去喧嚣,交付全部热忱,演绎一场跨越宿命的博弈。当光影落下,人物走来,那些隐忍、挣扎与坚守,都被妥帖呈现。祝《一瓯春》热播出圈,剧情渐入佳境。愿你始终保有对表演
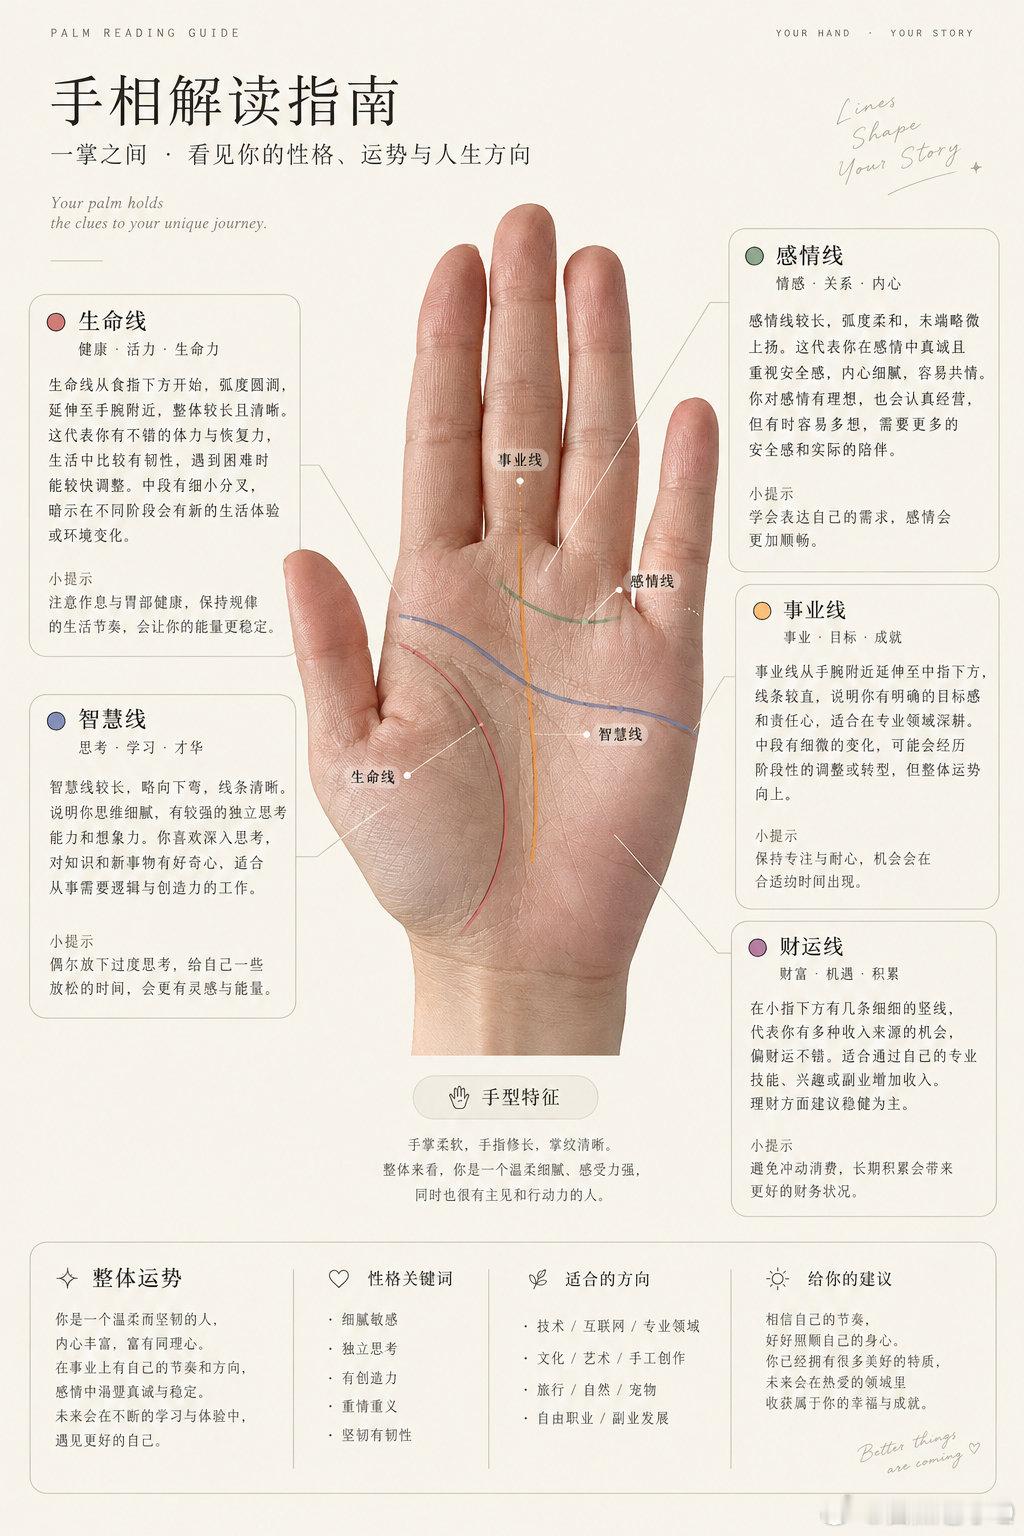
ChatGPT 给我看的手相,我觉得挺准[嘻嘻] ​

ChatGPT 给我看的手相,我觉得挺准[嘻嘻] ​

ChatGPT 给我看的手相,我觉得挺准[嘻嘻] ​
【南航亮相第四届CATA航空大会 AI赋能民航全场景引关注】
9 月 17 日,第四届中国航协(CATA)航空大会在北京国家会议中心二期开幕。南航集团总经理韩文胜出席开幕式并致辞。本届大会以 “人工智能与民航融合发展” 为主题,南航携多项 AI 创新成果与前沿科技产品精彩亮相,全面展现以 AI 驱动民航数字 ​

【南航亮相第四届CATA航空大会 AI赋能民航全场景引关注】 9 月 17 日,第四届中国航协(CATA)航空大会在北京国家会议中心二期开幕。南航集团总经理韩文胜出席开幕式并致辞。本届大会以 “人工智能与民航融合发展” 为主题,南航携多项 AI 创新成果与前沿科技产品精彩亮相,全面展现以 AI 驱动民航数字 ​

【南航亮相第四届CATA航空大会 AI赋能民航全场景引关注】 9 月 17 日,第四届中国航协(CATA)航空大会在北京国家会议中心二期开幕。南航集团总经理韩文胜出席开幕式并致辞。本届大会以 “人工智能与民航融合发展” 为主题,南航携多项 AI 创新成果与前沿科技产品精彩亮相,全面展现以 AI 驱动民航数字 ​
9/10 inclusion 外滩大会#外滩大会# 

📝:来外滩大会,最直观的震撼是云集的前沿 AI 与具身智能企业。
几年前参加 AIGC大会,行业还在探索大模型的内容生成能力与应用边界;短短几年间,AI 已实现从数字世界到物理世界的代际跃迁。如今,大模型已深度融入我们的日常工作,具身智能机器人也闯进我们 ​

9/10 inclusion 外滩大会#外滩大会# 📝:来外滩大会,最直观的震撼是云集的前沿 AI 与具身智能企业。 几年前参加 AIGC大会,行业还在探索大模型的内容生成能力与应用边界;短短几年间,AI 已实现从数字世界到物理世界的代际跃迁。如今,大模型已深度融入我们的日常工作,具身智能机器人也闯进我们 ​

9/10 inclusion 外滩大会#外滩大会# 📝:来外滩大会,最直观的震撼是云集的前沿 AI 与具身智能企业。 几年前参加 AIGC大会,行业还在探索大模型的内容生成能力与应用边界;短短几年间,AI 已实现从数字世界到物理世界的代际跃迁。如今,大模型已深度融入我们的日常工作,具身智能机器人也闯进我们 ​
谢谢你g老师 ​

谢谢你g老师 ​

谢谢你g老师 ​
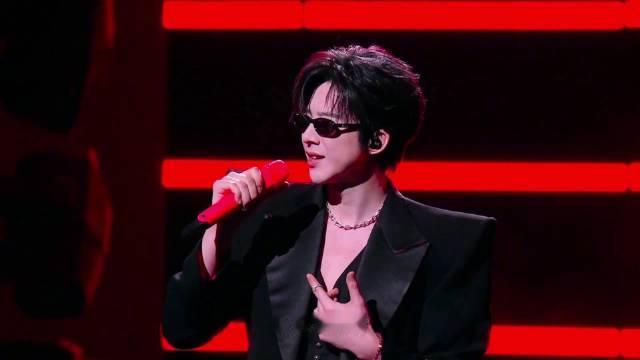
【#刘宇宁开到茶蘼超燃现场#】@摩登兄弟刘宇宁 超燃开唱《开到荼蘼》,气场全开。戳↓一起欣赏!

【#刘宇宁开到茶蘼超燃现场#】@摩登兄弟刘宇宁 超燃开唱《开到荼蘼》,气场全开。戳↓一起欣赏!

【#刘宇宁开到茶蘼超燃现场#】@摩登兄弟刘宇宁 超燃开唱《开到荼蘼》,气场全开。戳↓一起欣赏!

一周科技速览,带你领略前沿新知。 ​

一周科技速览,带你领略前沿新知。 ​