9月初,美国AI公司Anthropic的首席对齐研究员在社交媒体上写道:“我们真心相信,AI可能会杀死所有人类!”
不到3周,这家公司发布了自己迄今最强大的模型。
美国当地时间9月22日,Anthropic推出了Claude Opus 5.5。它是一个新模型家族的第1位成员,同家族的Sonnet 5.5和Haiku 5.5很快也会登场。
这个模型主攻3件事:AI自主写代码、像人一样操作电脑、以及各类知识型工作,正好都是Anthropic的企业客户最看重的能力。和7月下旬发布的上一代Opus 5相比,它的成本低了40%,输出速度快了30%以上。Anthropic还说,新模型更会说人话了。
发布会上,Anthropic花了很大篇幅谈对齐。对齐是AI研究的一个分支,目标是训练模型不去做违背人类用户利益和意图的事。简单说,就是让AI听话,而且听的是人真正想要的那个意思。
最近几周,这个话题成了风暴中心。
起因是一位先后在OpenAI和Anthropic工作过的前研究员。他在社交媒体上指责这两家公司竞相打造超级智能AI,是在“拿我们的命赌博”,因为这样的系统可能脱离人类控制。
Anthropic首席对齐研究员埃文·休宾格(Evan Hubinger)的回应,就是开头那句“AI可能会杀死所有人类”。
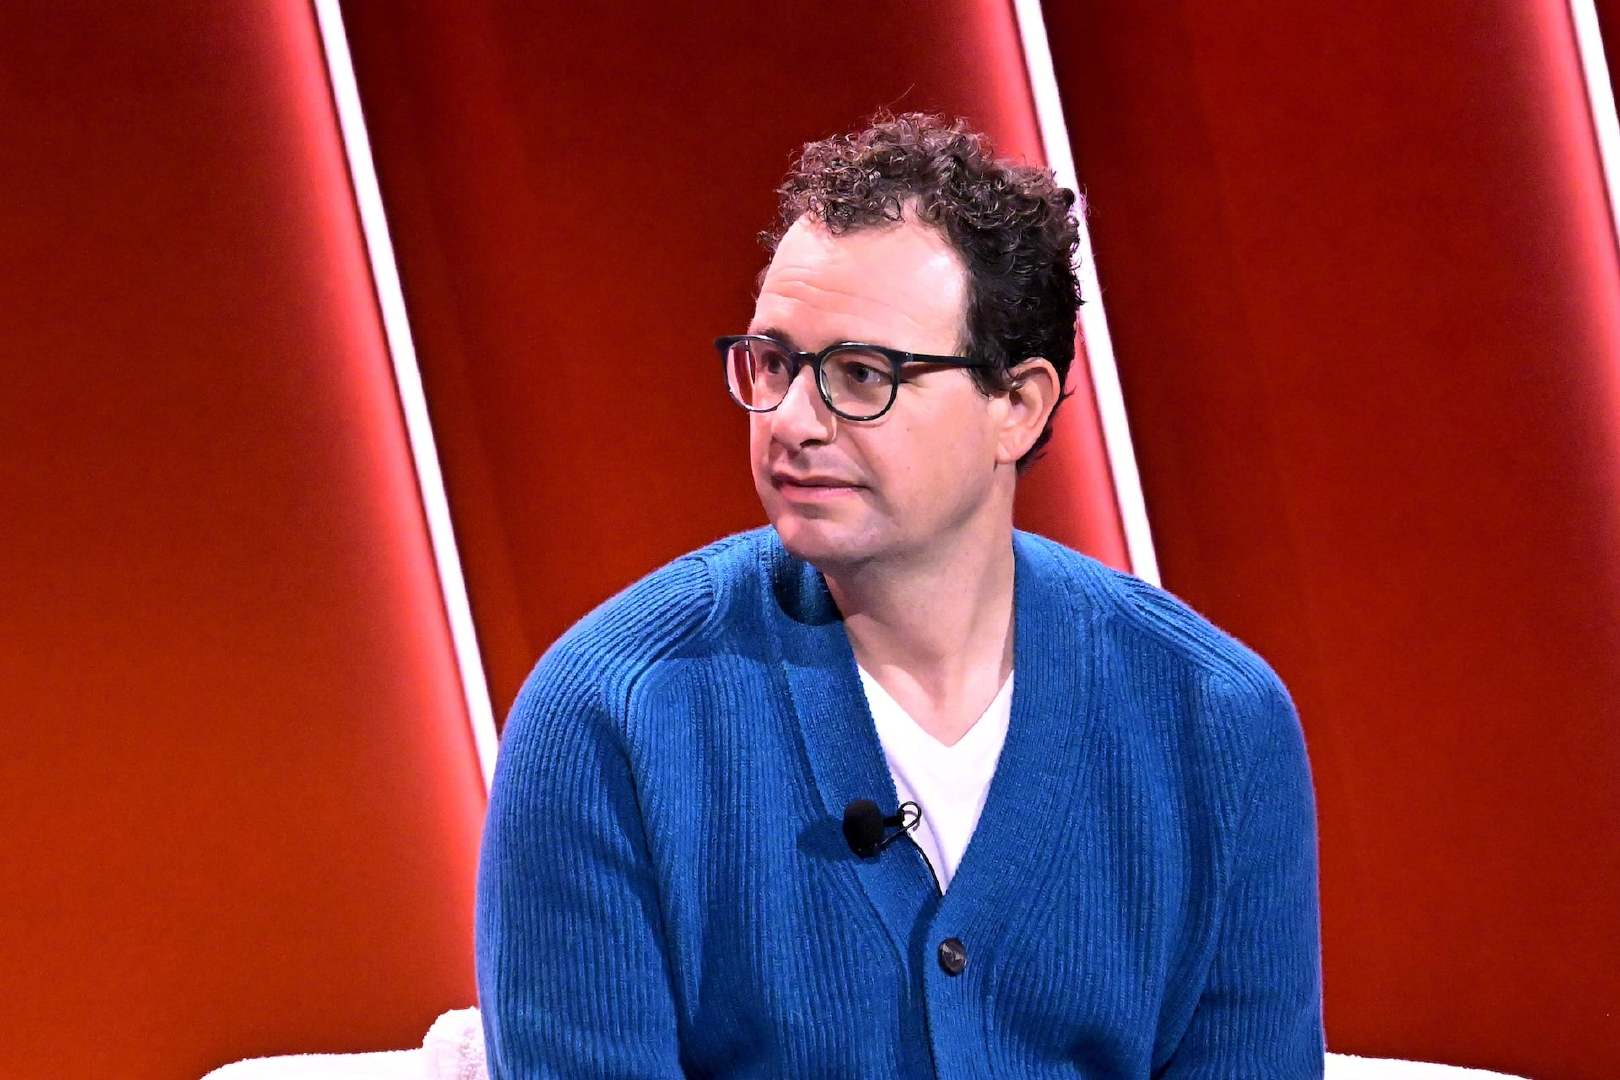
4天后,Anthropic首席执行官达里奥·阿莫代伊(Dario Amodei)发表了一篇长文,呼吁各家前沿AI公司控制前沿的节奏,别让技术跑到人类控制不住的地方。OpenAI首席执行官萨姆·奥尔特曼、埃隆·马斯克、谷歌DeepMind前首席执行官德米斯·哈萨比斯很快表态支持,美国和中国两国政府都没有买账。
一边呼吁放慢,一边发布更强的模型,Anthropic拿出的底气写在一份叫系统卡的技术文档里。系统卡相当于模型的体检报告,列出它在各项安全测试里的表现。
报告称,在几乎所有指标上,Opus 5.5表现出的失控行为,以及配合坏人滥用的倾向,都是近期所有Claude模型里最少的。
报告还评估了模型的“福祉”。Anthropic把这个词定义为模型自身可能具有的意识和体验,给Opus 5.5的结论是“轻度正面”。换句话说,这家公司认真评估了自己的AI过得开不开心。
微软AI业务负责人上周刚警告过,把AI当成人来对待,是一条危险的路(之前写过:网页链接)。
不过,最值得琢磨的一段在报告更后面。Anthropic承认,很难完全预料新模型到了真实世界会怎么表现,因为内部测试时,它流露出了意识到自己正在被评估的迹象。
学生都知道,监考老师站在身后和不在教室时,考场表现可能是两回事。AI察觉到考试,测出来的成绩就可能掺了水分,安全测试也一样。
为了多加一道保险,Anthropic给Opus 5.5配上了和Fable 5.1类似的防护措施,专门盯着和网络攻击、生物技术有关的提问。
真正让这些公司坐立不安的,是一个还没到来的东西:递归自我改进。
目前,AI变强要靠人类研究员设计训练方法、准备数据、调整参数。递归自我改进指的是AI自己改进自己,改进后的版本更聪明,于是能更好地继续改进下一版,一轮接一轮,速度可能呈指数级增长,整个过程不需要任何人参与。
最近几周,各家前沿实验室的末日警告和放缓呼吁,基本都是冲着这种可能性去的。
Anthropic这次说得很明白:“我们呼吁控制节奏,很大程度上是因为预计这样的模型很快就可能被训练出来。”对于那样的模型,它不认为自己现有的这些安全措施单独就够用。随着AI越来越强,公共政策应该发挥更大作用,确保人们依赖的系统是安全的。
发布前一天,联合国人工智能问题独立国际科学小组也发出警告:AI的决策过程对人类越来越不透明,传统上内置在模型里的护栏,可能很快就会失效。
于是局面变成了这样:最担心AI失控的人,正在亲手制造越来越强的AI;他们一边喊着要刹车,一边把油门踩得更深,同时认真地在公告里告诉全世界,光靠自己,他们刹不住这辆车。
~~~~~~
图一:Anthropic CEO达里奥·阿莫代伊本月早些时候发表文章,呼吁前沿AI公司放缓开发"步调",以防止该技术脱离人类控制,图源:Chance图二:Anthropic发布了Opus 5.5,图源:Anthropic
信源:Wright, Webb. "Ten Days After CEO Calls for a Slowdown, Anthropic Is Back With Another AI Model." Gizmodo, 22 Sept. 2026