DC娱乐网
互联不一般哥的文章
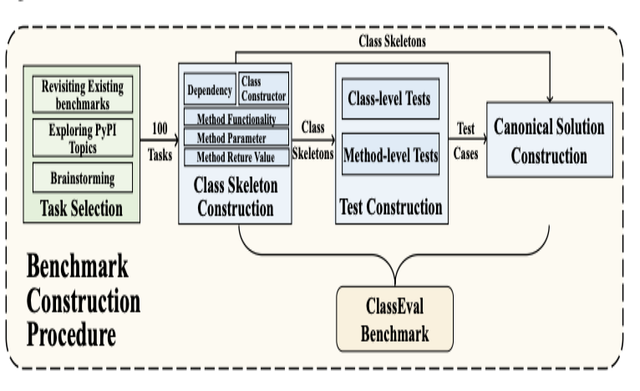
ClassEval:一个评估LLM在类级代码生成上的表现的手工基准
2024-06-30 09:10
ClassEval:一个评估LLM在类级代码生成上的表现的手工基准
源代码模型跨任务泛化的基准测试
2024-06-29 09:10
源代码模型跨任务泛化的基准测试
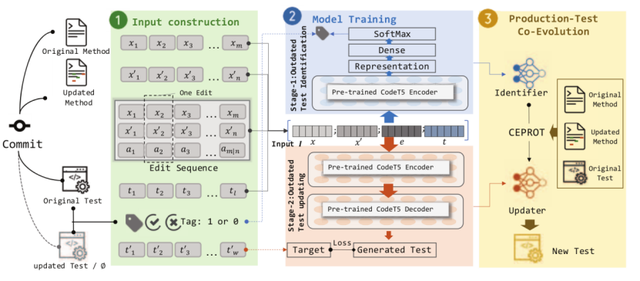
生产代码变化时识别和更新测试用例:一种基于Transformer的方法
2024-06-28 09:10
生产代码变化时识别和更新测试用例:一种基于Transformer的方法
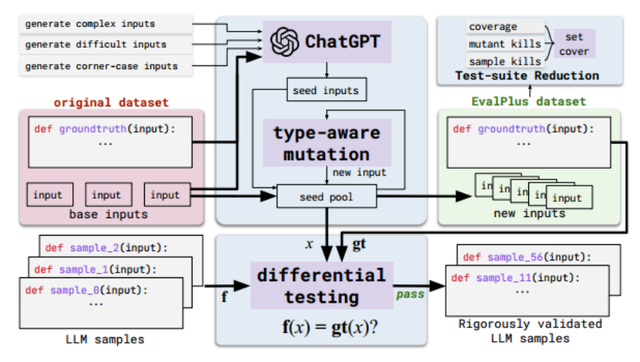
ChatGPT生成的代码真的正确吗?代码生成的大型语言模型的严格评估
2024-06-27 09:10
ChatGPT生成的代码真的正确吗?代码生成的大型语言模型的严格评估
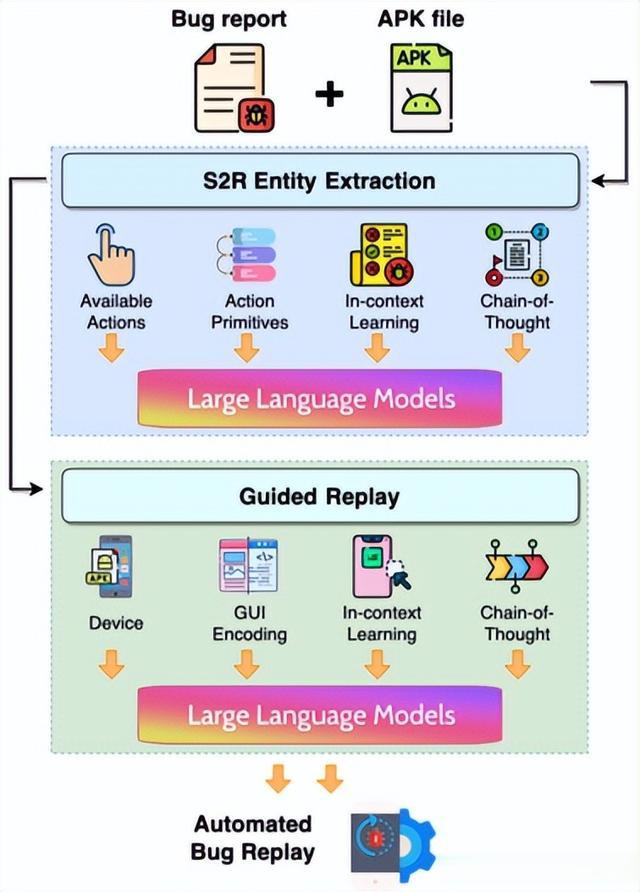
使用大型语言模型的自动化安卓错误重现
2024-06-26 09:10
使用大型语言模型的自动化安卓错误重现
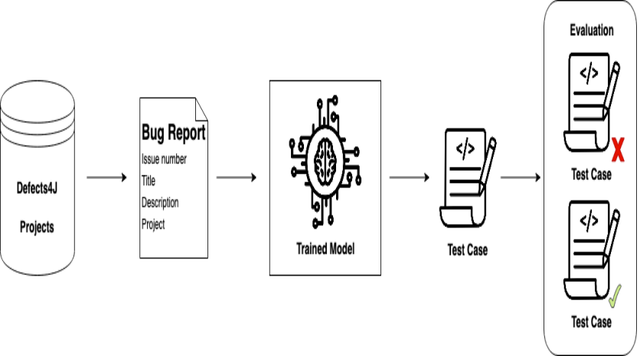
LLM可以解密Bug报告吗?
2024-06-25 09:10
LLM可以解密Bug报告吗?
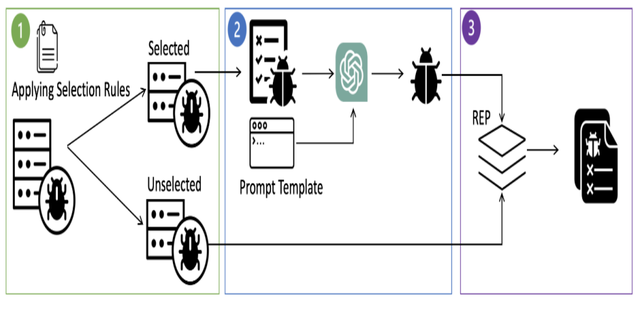
Cupid:利用ChatGPT进行更准确的重复错误报告检测
2024-06-24 09:10
Cupid:利用ChatGPT进行更准确的重复错误报告检测
使用预训练模型来增强代码自动化审查
2024-06-23 09:10
使用预训练模型来增强代码自动化审查
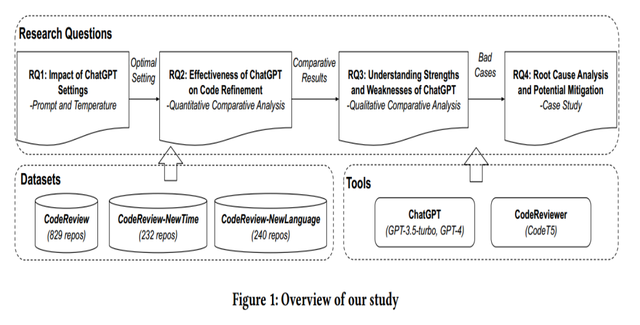
探索ChatGPT在自动代码优化中的潜力:一项实证研究
2024-06-22 09:10
探索ChatGPT在自动代码优化中的潜力:一项实证研究
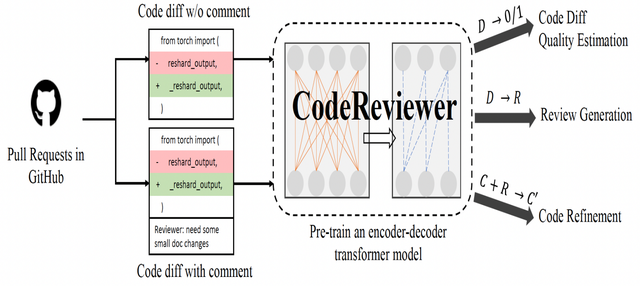
通过大规模预训练自动化代码审查活动
2024-06-21 09:10
通过大规模预训练自动化代码审查活动
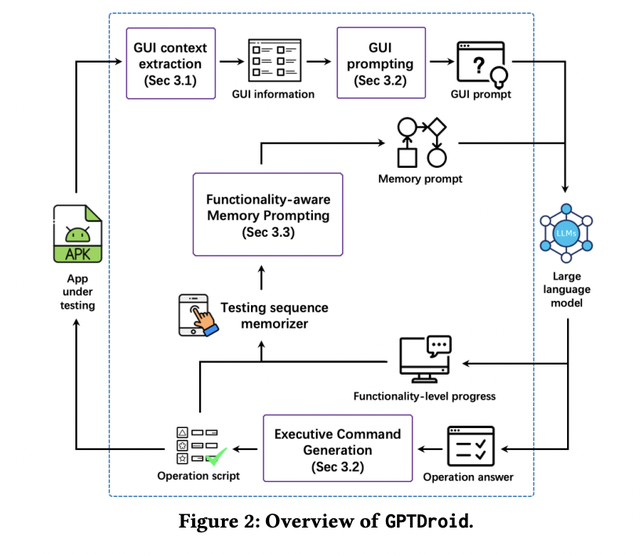
让LLM成为测试专家:通过功能感知决策将类人交互引入移动 GUI 测试
2024-06-20 09:10
让LLM成为测试专家:通过功能感知决策将类人交互引入移动 GUI 测试
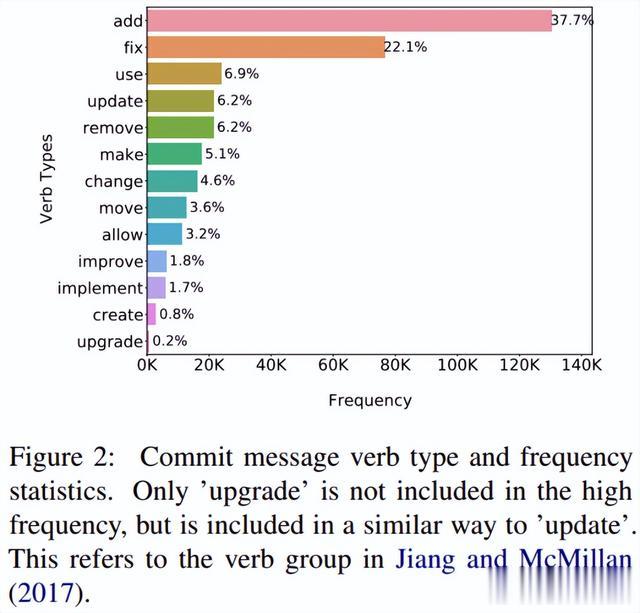
CommitBERT:使用预训练编程语言模型生成提交消息
2024-06-19 09:10
CommitBERT:使用预训练编程语言模型生成提交消息
使用大型语言模型的自动修补正确性评估
2024-06-18 09:10
使用大型语言模型的自动修补正确性评估
后门神经代码搜索
2024-06-16 09:10
后门神经代码搜索
通过关联缺陷描述和代码更改来评估补丁
2024-06-15 09:10
通过关联缺陷描述和代码更改来评估补丁
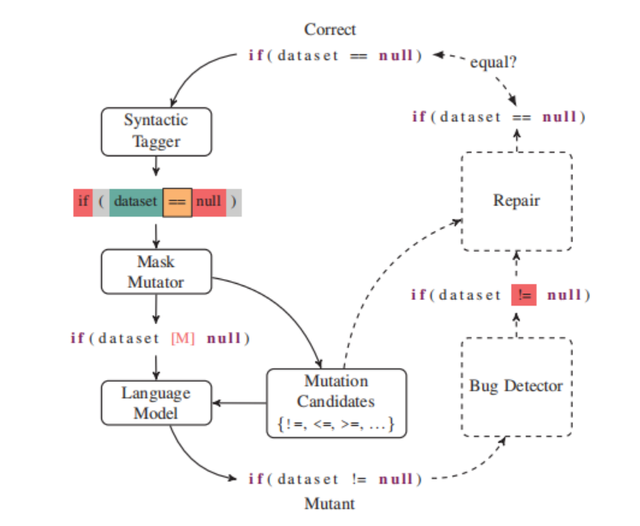
学习真实变异:神经漏洞检测器的漏洞创建
2024-06-14 09:10
学习真实变异:神经漏洞检测器的漏洞创建
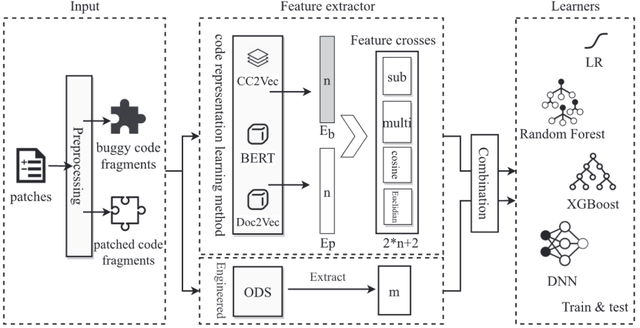
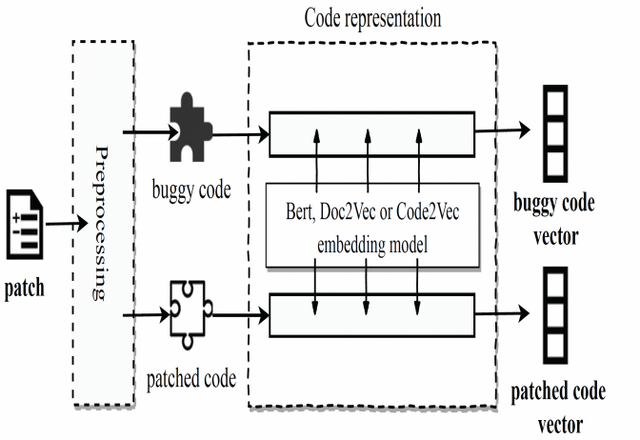
强强联合:将学习嵌入与工程特征相结合以预测正确补丁
2024-06-13 09:10
强强联合:将学习嵌入与工程特征相结合以预测正确补丁
评估代码变更的表示学习以预测程序修复中补丁的正确性
2024-06-12 09:10
评估代码变更的表示学习以预测程序修复中补丁的正确性
ZeroLeak:使用llm进行可扩展和低成本的旁路补丁
2024-06-11 09:10
ZeroLeak:使用llm进行可扩展和低成本的旁路补丁
神经网络修复安全漏洞的效果如何
2024-06-10 09:10
神经网络修复安全漏洞的效果如何
第一页
下一页
作者信息
互联不一般哥
感谢大家的关注
关注者: 2
热门分类
推荐
热榜
军事
NBA
体育
社会
明星八卦
娱乐
财经
科技
汽车
历史
国际
游戏
动漫
公益
搞笑
商业
互联网
数码
国际足球
房产
家居
时尚
科学探索
职场
育儿
股票
教育
影视
情感
热点
中国军情
武器
中国南海
中国足球
亚洲杯
科比
综合体育
CBA
投资
楼市
大咖秀
外汇
创业
风口
SUV
豪车
概念车
优惠
新能源
美国
欧洲
朝日韩
俄罗斯
孕期
街拍
恋爱攻略
婚姻
正能量