轮到中国主导制定行业新标准了。9 月 16 日,中国移动迈出关键一步,正式对外全球开源 Open-RAIL,这是业内首款能够打通 VLA/WAM 模型与机器人实体的通用工程底座。
很多人看到“开源”两个字,可能觉得无非又是放出一套代码。
但我觉得,这次真正值得盯的,根本不是代码本身,而是中国企业开始去抢机器人行业最底层的“通用接口”。
现在的具身智能,看起来热闹得不得了。模型越来越聪明,机器人本体也越做越多,可真到了落地环节,麻烦马上就来了。
同一个模型,换一台机器人,关节定义不一样,通信协议不一样,坐标系也不一样。原本在A机器人上跑得好好的程序,换到B机器人身上,工程师又得重新写适配层。
说白了,大脑很聪明,身体也不差,可两边说的不是一种“语言”。
Open-RAIL干的,就是把这层最麻烦、最费时间的“翻译工作”统一起来。
中国移动给出的数据很直接:目前已经适配4款异构机器人,过去接入一款新机型可能要按周算,现在可以压缩到几个小时;模型端已经支持10个主流VLA/WAM模型,新模型接入最低只需要50到100行代码。
这个变化有多大?
以前一家机器人公司想换模型,或者一家模型公司想换机器人,都得重新磨接口、调控制、测延迟。大量时间不是花在让机器人变聪明,而是耗在重复对接上。
现在如果底层接口被统一,模型和机器人就有机会像电脑上的软件和硬件一样自由组合。
这才是我觉得最有意思的地方。
谁把这套连接规则先做出来,谁让更多厂商愿意用,谁就可能逐渐掌握生态里的话语权。
标准从来不是靠喊出来的,而是靠越来越多人用出来的。
而且Open-RAIL解决的不只是“接得上”,还在解决“跑得稳”。
VLA/WAM模型一次推理可能需要上百毫秒,但机器人的电机控制要求毫秒级响应。模型稍微慢一点,机器人动作就容易卡顿、抖动。
Open-RAIL把观测、推理、控制拆成三条并行流水线,再加两级动作平滑。中国移动披露的数据是,关节加速度标准差从10+rad/s²降到0.1rad/s²,动作平滑度提升两个数量级。
这不是一个漂亮参数那么简单。
机器人以后真要进工厂、商场、养老院、家庭,动作抖不抖、响应稳不稳,直接决定它到底是“演示品”,还是能长期干活的工具。
更关键的是,它还把数据回流一起打通了。
机器人每一次真实运行,都能自动积累训练数据。哪里抓错了,哪里走偏了,哪些动作需要修正,都可以继续反哺模型。模型训练、真机执行、数据采集、再次迭代,被塞进同一个闭环里。
这意味着机器人不是出厂那天最聪明,而是有机会越干越熟。
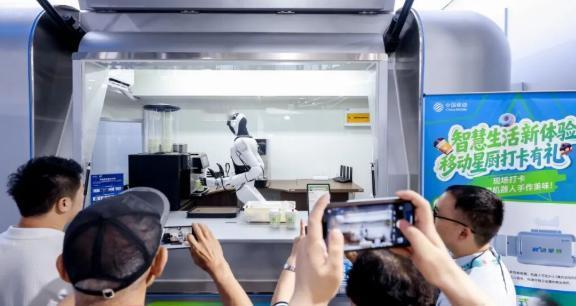
中国移动自己已经拿“移动星厨”做了验证。这套机器人跑在Open-RAIL之上,已经在杭州研究院园区常态化运行,能做咖啡、开微波炉、加热餐食,一杯拿铁从启动到出杯大约90秒,日均出杯超过百杯。
我更看重的还不是它会不会冲咖啡。
真正值得注意的是,中国移动没有把Open-RAIL关在自家体系里,而是直接面向全球开源。
这一步很像先修路,再让所有车上来跑。
路一旦铺开,使用的人越多,接口习惯、开发方式、数据格式就越容易沉淀成事实标准。以后别人再造机器人、做模型,可能首先考虑的就不是“我要自己重新搭一套”,而是“能不能直接接Open-RAIL”。
这才是开源最厉害的地方。
表面上免费,真正争的是生态入口。
过去机器人行业最受关注的是谁的本体更灵活、谁的模型参数更大。接下来竞争很可能会进入下一层:谁能把模型、本体、算力、数据和部署方式真正连成一套。
中国移动手里本来就有网络、云、边缘算力和物联网基础,如今再把机器人通用连接层补上,路线其实非常清楚。
我看这件事,最大的信号就是:中国企业已经不满足于只造一台好机器人、训练一个好模型,而是开始往“别人都要经过的那层基础设施”上走。
产品做得好,赚的是一代产品的钱。
底座一旦被广泛采用,影响的却可能是一整个产业的开发习惯。
这一次,中国移动抢的不是一台机器人的订单,而是未来具身智能生态里那张越来越重要的“接口座位”。
谁先坐稳,谁的话语权就会越来越大。