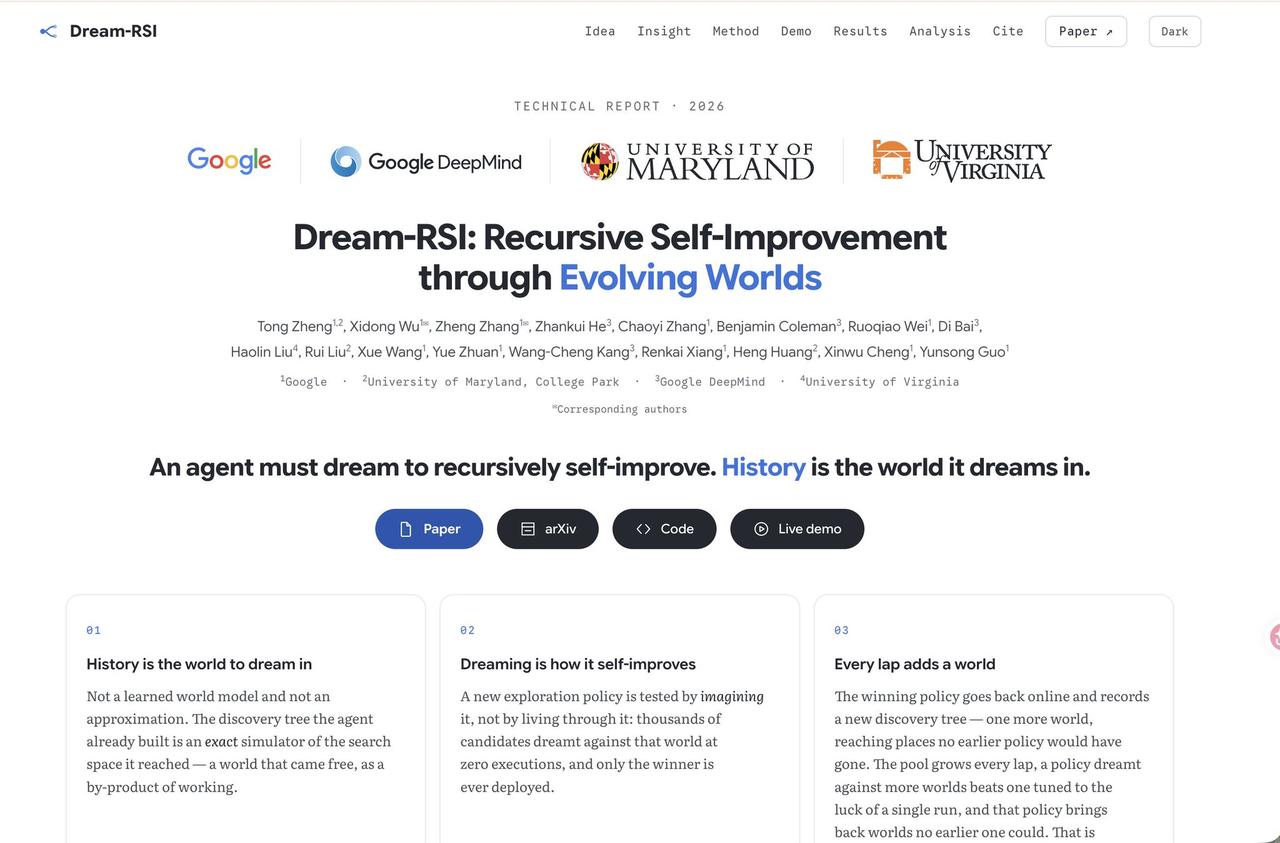
Google 和 Google DeepMind 最新放出的论文,搞了个大的:真正的递归自我改进(RSI),可能根本不需要动模型权重一毫一厘。
过去的 Agent 踩坑做实验,跑完一趟昂贵的计算,留下的尝试分支和失败日志就成了过期垃圾。但在 Dream-RSI 的世界里,这些完整的探索历史被直接打包成了一个零成本的“重播模拟器”(Replay Simulator)。
模型开始在自己的历史记录里疯狂“做梦”:如果当时先走分支 B 会怎样?如果提前把那个死胡同分支砍掉呢?如果给这个潜在爆款多分配两倍算力呢?
因为历史路径上的代码执行和评估结果全都是现成的,这种“做梦”实验的边际成本为零。一次昂贵的真实探索,可以支撑上万次零执行成本的策略演练。找到最优探索策略后再部署回真实世界,一个探索、积累、做梦、改进策略、再探索的自理闭环就这么完美转起来了。
数据表现相当毒辣:在 GPU Kernel 优化任务中,要达到类似性能,VGG16 和 LayerNorm 分别少用了 2.43 倍和 1.79 倍的生成代数;而在相同算力预算下,ConvDiv 和 ConvMax 的性能分别暴涨了 2.09 倍和 1.44 倍。
但整篇论文最讽刺、也最值得玩味的一个发现是:研究人员试过传统做法,把过去探索得到的经验“总结提炼”成 Prompt 塞回去指导下一轮,结果性能反而倒退了。
人类总觉得“吃一堑长一智”是美德,但对 AI 来说,这种文字总结的“经验”极易异化为认知偏见。它会让 Agent 过早收敛在几个看起来很美的局部最优解上,直接阉割了探索的多样性。越自以为吸取了教训,越容易走入思维死胡同。
这展示了一条完全不同的 AGI 进化路径:模型不需要先学会修改自己的代码,Agent 已经开始学会修改自己的 Harness(脚手架)。
怎么开并行、何时止损、算力怎么倾斜……这些过去全凭人类系统工程师拍脑袋决定的调度艺术,如今也进入了 AI 的自我迭代循环。底层还是那个模型,但它已经开始研究:到底怎么抽鞭子,才能让自己这匹马跑得更快。
人类工程师还在苦恼怎么给 AI 写提示词,AI 已经开始给自己搭建思维沙盒了。当大模型学会了掌控自己的认知调度权,游戏规则就已经变了。