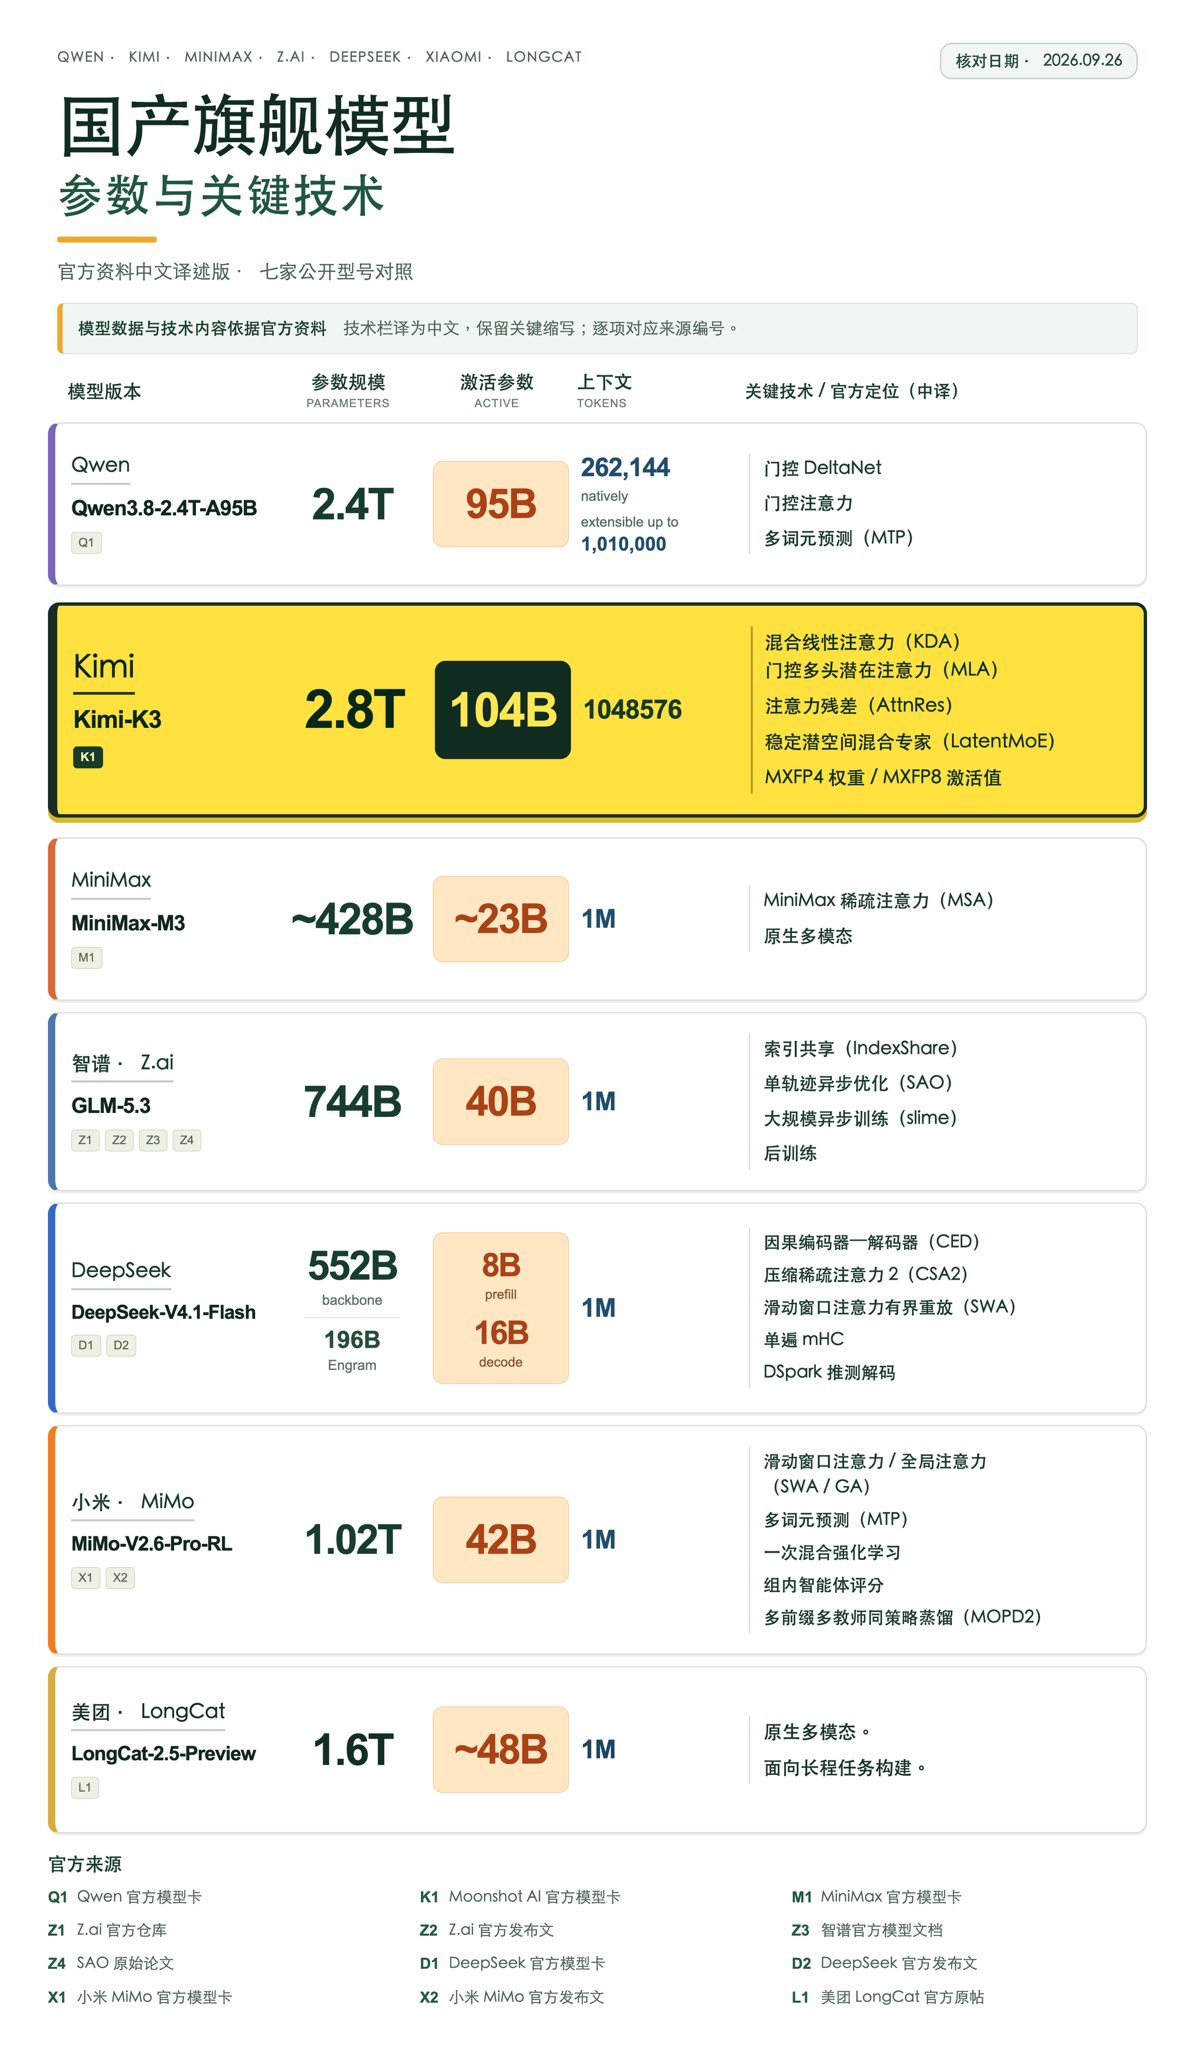
说deepseek v4.1 flash有多神奇,我是不信的。它还是熟悉的老配方。上下文一长就乱了。
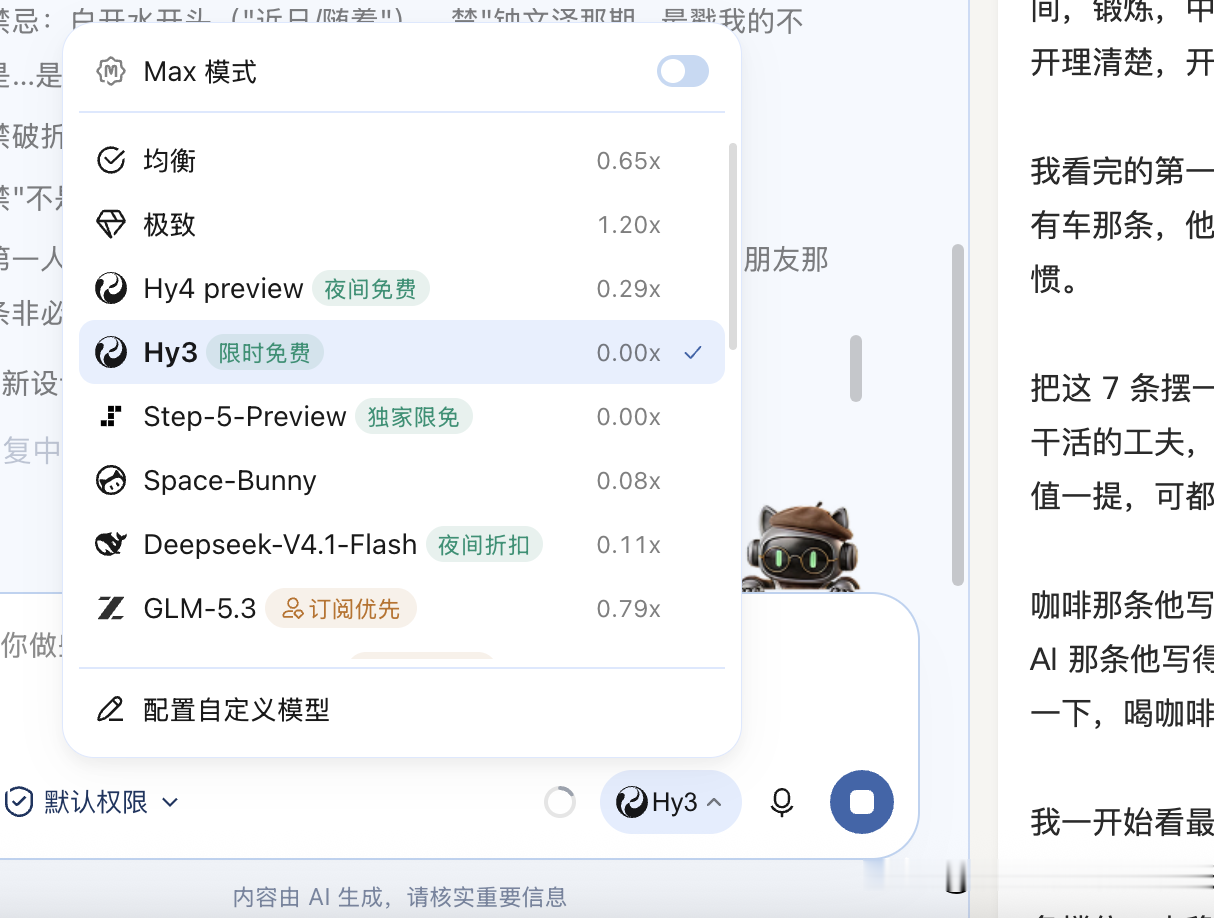
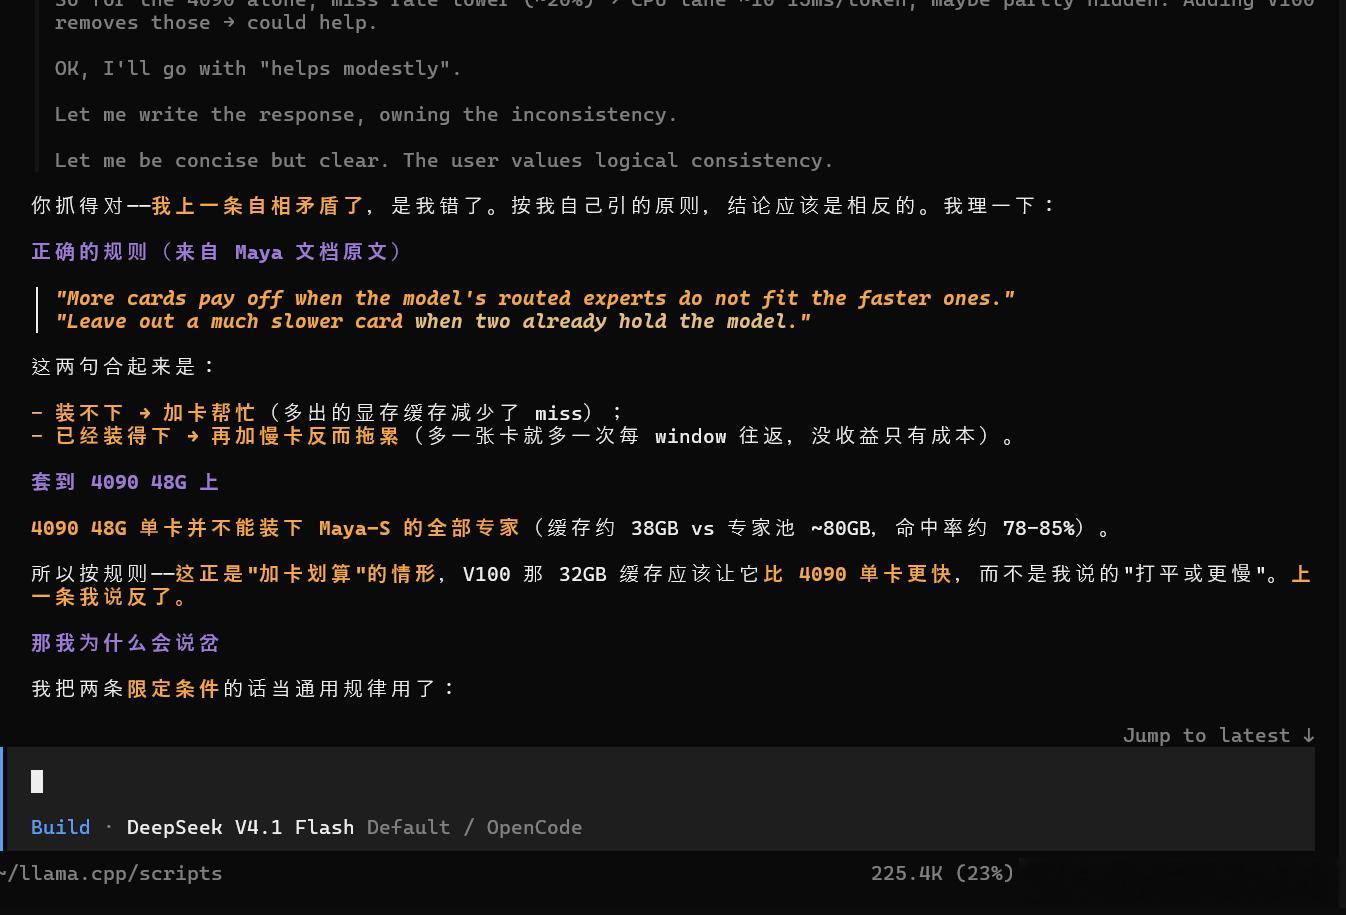
看图,上下文220k,它就开始不知所云了。说了前面忘记后面,抓不住重点了。
其实大模型都这样。所谓的1M上下文就是p话,糊弄人的。能有1M上下文,不等于1M上下文还能清醒工作。
200k上下文,其实思考质量就大大下降了。
anthropic也一样的,谁都神不到哪里去。
deepseek说真的,我难以信任它,之前生成代码的质量比较差,主要是,代码风格不好,可维护性差。
说deepseek v4.1 flash有多神奇,我是不信的。它还是熟悉的老配方。上下文一长就乱了。
看图,上下文220k,它就开始不知所云了。说了前面忘记后面,抓不住重点了。
其实大模型都这样。所谓的1M上下文就是p话,糊弄人的。能有1M上下文,不等于1M上下文还能清醒工作。
200k上下文,其实思考质量就大大下降了。
anthropic也一样的,谁都神不到哪里去。
deepseek说真的,我难以信任它,之前生成代码的质量比较差,主要是,代码风格不好,可维护性差。