别让“反幻觉”杀死AI创造力,最新实证研究来了!
很多人一听到AI“幻觉”,第一反应就是赶紧关掉,仿佛模型只要不胡说八道就算成功,可问题是,一个永远只敢说标准答案的模型,真的能帮科学家发现新东西吗?
2026年6月22日《中国能源报》报道,国内团队在降低大模型关键知识缺失和幻觉率方面取得进展,这场关于“既要可靠又要敢想”的讨论,已经从实验室走向真实应用。(信源:2026年6月22日《人民日报》)
南洋理工大学团队在论文中提出了一个很有意思的问题,模型产生幻觉当然不好,可科学创意有时候也来自“不按套路出牌”,如果把所有不确定、跳跃、离奇的想法都提前掐掉,留下来的可能只是四平八稳的答案,听起来很正确,却很难让人眼前一亮。
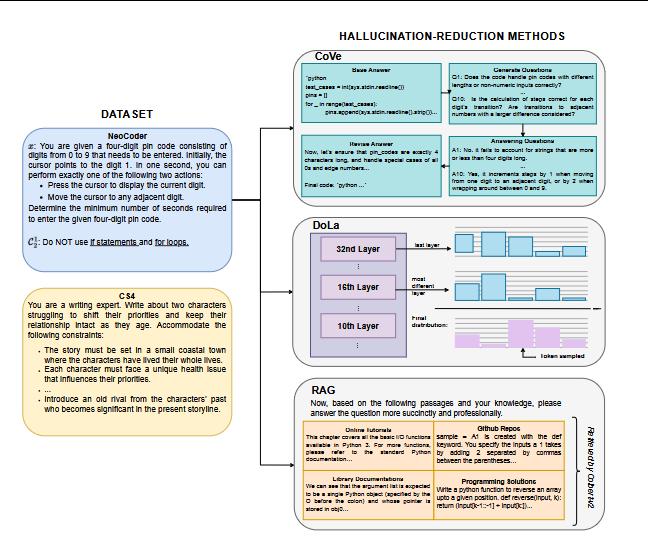
这项研究测试了三种常见的反幻觉办法,验证链CoVe、对比层解码DoLa和检索增强生成RAG,研究人员还用了NeoCoder和CS4两个创造力基准,一个偏向有规则的编程任务,一个偏向开放式故事生成,简单说,就是既看模型能不能在框架内想办法,也看它敢不敢把思路放远一点。
结果最让人意外的是,CoVe不但没有压住创造力,反而提升了模型的发散能力,它的做法有点像让模型先提出答案,再自己列出疑点,重新验证一遍,再从多个方向补充,这个过程不像考试,更像一个人拿着草稿纸反复琢磨,越问越容易冒出新点子。
这对科研特别重要,因为科学研究不是搜索引擎问答,不是把已有结论换个说法,而是从一个不起眼的异常现象里,猜出一条过去没人认真走过的路。
很多真正有价值的假设,最初看起来甚至有点“不靠谱”,只是它必须经过实验和证据筛选,而不是一出生就被判死刑。
RAG的表现则比较平淡,它给模型补充资料,主要作用是减少事实错误,但对发散创造力没有明显提升。
这其实不难理解,往模型桌上多放几本书,不代表它马上就能写出新理论,关键还要看检索到的内容是不是新鲜,来源是不是可靠,以及模型有没有把不同知识真正碰撞起来。
我一直觉得,RAG更像给模型装了一间资料室,资料室很重要,却不会自动替你灵感爆发,倘若检索结果全是重复信息,模型只会更熟练地复述旧观点,只有当资料之间存在差异、冲突甚至空白时,才可能真正刺激新的联想,这一点和人类做研究很像。
真正值得警惕的是DoLa,这种方法通过比较模型不同层级的预测来提高事实性,可实验显示,它在两个创造力测试中大多拉低了发散表现,研究团队推测,模型早期层可能保留了更多探索性信息,过度对比以后,连那些尚未成形的想法也一并被削弱了。
这就像一个编辑拿着红笔改稿,错别字、病句当然要删,可如果看到一句不够规整的话就直接划掉,文章最后可能没有错误,却也没有味道,科技创新尤其如此,太早追求整齐,往往会把真正珍贵的“不寻常”一起清理掉。
不过,这项研究并不是在替幻觉开脱,模型编造数据、捏造论文、虚构实验结果,依然必须严厉防范,尤其在医疗、工程、金融和公共决策中,事实错误可能带来真实损失,创造力不能成为胡编乱造的遮羞布,想象力也必须接受证据约束。
我更愿意把模型输出分成两个阶段,前面允许它大胆发散,哪怕提出几个看上去古怪的方向,后面再用检索、计算、实验和人工复核逐层收紧。
这比从开头就要求模型“绝对正确”更符合科研规律,人类科学史本来就是大胆猜想和严谨验证不断交替的过程。
研究还发现,创造力并不是一整块铁板,发散性创造力和趋同性创造力可以分开看,前者负责想出更多可能,后者负责从一堆可能里挑出最合理的答案,未来的大模型或许不该只有一个统一模式,而应该根据任务切换状态,写诗时放开一点,算药物时谨慎一点,做论文时边想边查。
这也提醒使用AI的人,别把“回答得像标准答案”误认为“真的聪明”,一个模型如果每句话都谨慎得像公文,当然不容易犯错,但也可能永远停留在整理资料的阶段,真正有用的科研助手,应该敢于提出假设,同时清楚标注哪些是事实,哪些只是推测。
南洋理工大学这项研究目前仍有局限,创造力基准毕竟不能完全代替真实科研,CoVe为什么有效也没有通过充分的消融实验解释清楚,RAG的效果还会受到检索质量影响,所以它更像一盏提示灯,而不是最终判决,别急着把结论喊成定论。
但它至少把一个常被忽略的问题摆到了台面上,反幻觉不是越强越好,关键要看用在什么地方,面对新闻事实和实验数据,模型需要像审计员一样谨慎,面对科学设想和创意策划,它又得保留一点敢想敢试的空间。
说到底,我们要解决的不是让AI变成一个永远不犯错的“乖学生”,而是让它学会在大胆想象之后主动检查,在事实不清时明确说明,在证据不足时留下余地,这样的模型才可能从会答题的工具,慢慢变成真正能参与科研、创作和发现的伙伴。